- @weixin_42608414


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
我们知道推荐系统可以大致分为三类:基于内容的推荐系统,协同过滤推荐系统和混合推荐系统(使用这两者方式组合)。基于协同过滤的推荐系统使用的是用户的行为数据(如用户的评分记录等),但是呢这就会遇到所谓的冷启动的问题,即它无法为一个新用户推荐商品(因为新用户没有评分记录),它也无法为一个新的商品做出推荐(因为新商品不存在评分记录),它也无法为一个新上线的网站做有效的推荐(没有注册用户,全部都是新商品),
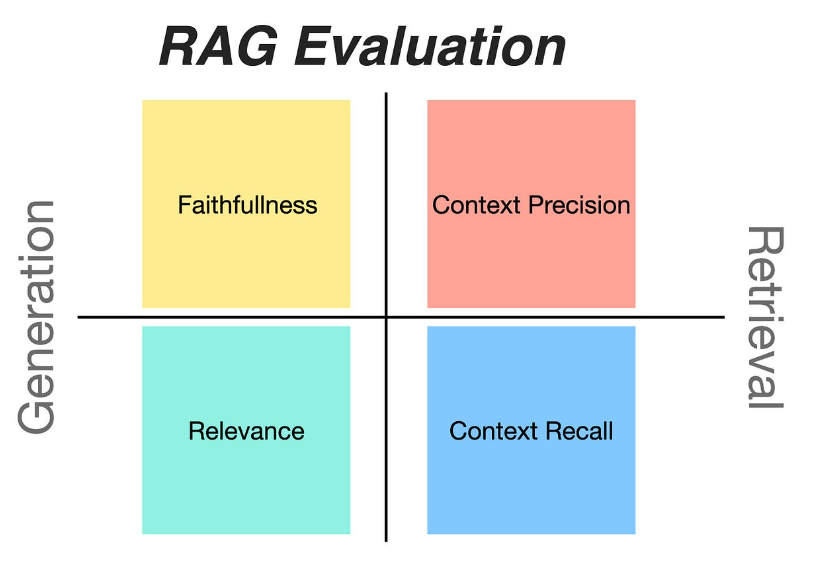
RAGAs (Retrieval-AugmentedGenerationAssessment) 它是一个框架(github官方文档question:用户输入的问题。answer:从 RAG 系统生成的答案(由LLM给出)。contexts:根据用户的问题从外部知识源检索的上下文即与问题相关的文档。: 人类提供的基于问题的真实(正确)答案。这是唯一的需要人类提供的信息。
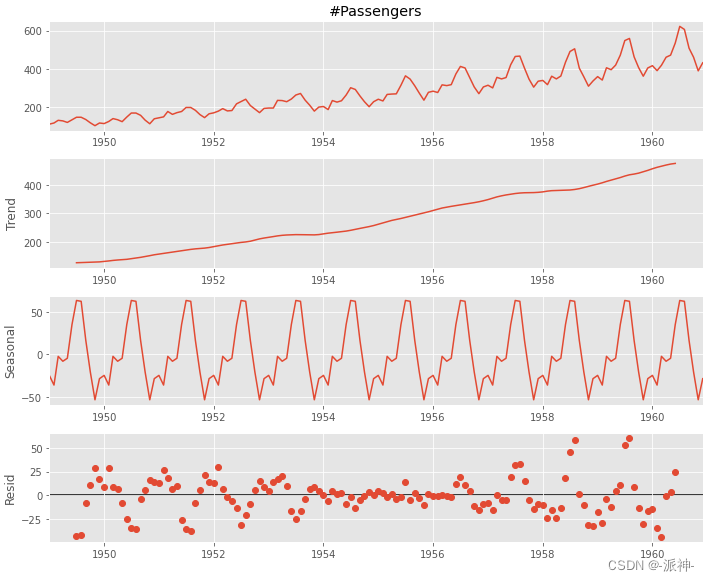
今天我们主要介绍了STL的分解的主要参数,和分解的过程,并观察了分解以后残差的分布和均值并确认了残差服从以0为均值的近似正太分布,这说明STL分解是正确的。其次我们还介绍了趋势程度、季节性程度以及季节性波峰的计算方法,这有助于确定数据是否具有良好的可预测性。...
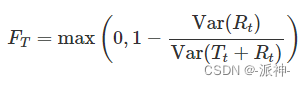
今天我们来介绍RAG 融合(rag fusion),它的主要思想是在Multi Query的基础上,对其检索结果进行重新排序(即reranking)后输出Top K个最相关文档,最后将这top k个文档喂给LLM并生成最终的答案(answer)。

今天我们介绍了如何通过答链RetrievalQA,来检索向量数据库并回答用户的问题。其中我们介绍了几种RetrievalQA检索向量数据库的工作方式,也就是chain type方式,其实默认方式是stuff,除此之外还有map_reduce,refine, map_rerank等几种方式,它们都有各自的优缺点。同时我们还介绍了通过使用prompt模板,可以让LLM返回格式化的结果。希望今天的内容对
聊天机器人(chatterbot)是一个用来模拟人类对话或聊天的程序。“Eliza”和 “Parry”是早期非常著名的聊天机器人。它试图建立这样的程序:至少暂时性地让一个真正的人类认为他们正在和另一个人聊天。聊天机器人是怎么工作的?大致上有两种类型的聊天机器人:基于规则的和自学习的。1. 基于规则的:根据训练的规则哎回答问题。定义的规则可以非常简单,也可以非常复杂。机器人可以处理简单...
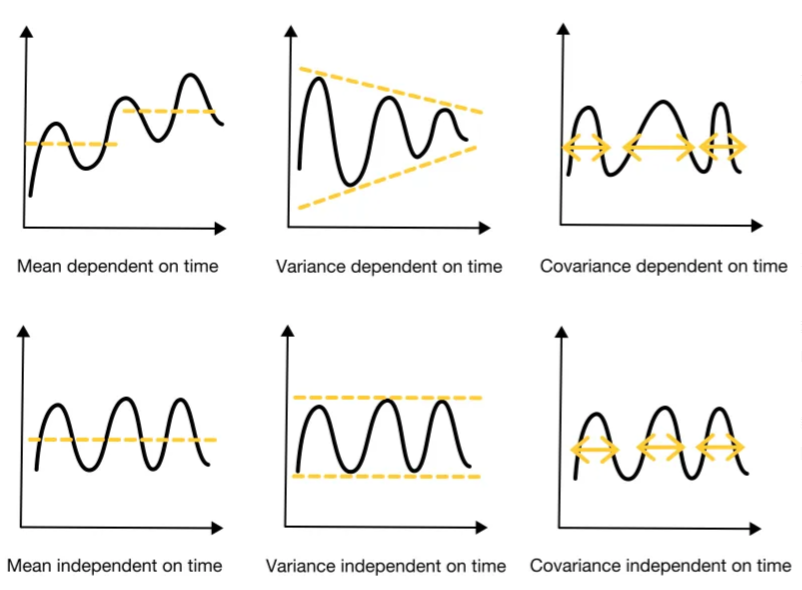
在时间序列预测中,当时间序列数据具有恒定统计特性(均值、方差和协方差)并且这些统计特性与时间无关时,则被称为数据是平稳的。由于恒定的统计特性,平稳时间序列比非平稳时间序列更容易建模。因此,许多时间序列预测模型都假设数据是平稳的。平稳性可以通过视觉评估或统计方法来检查。统计方法检查数据中是否存在单根(unit root)。两个最常用的单根检验是 ADF 和 KPSS。我们可以在Python的第三方库
今天我们主要介绍了STL的分解的主要参数,和分解的过程,并观察了分解以后残差的分布和均值并确认了残差服从以0为均值的近似正太分布,这说明STL分解是正确的。其次我们还介绍了趋势程度、季节性程度以及季节性波峰的计算方法,这有助于确定数据是否具有良好的可预测性。...
在本章中我们学习了时间序列数据的加法分解和乘法分解的基本步骤,我们一步步通过手动的方法计算了趋势、去趋势项、季节项、残差项等特征项,手动分解的目的是让读者能进一步了解各个特征项的计算逻辑,最后我们使用了statsmodels的seasonal_decompose方法来自动分解,并对比了手动分解与自动分解的结果,并确认他们是一致的。.........
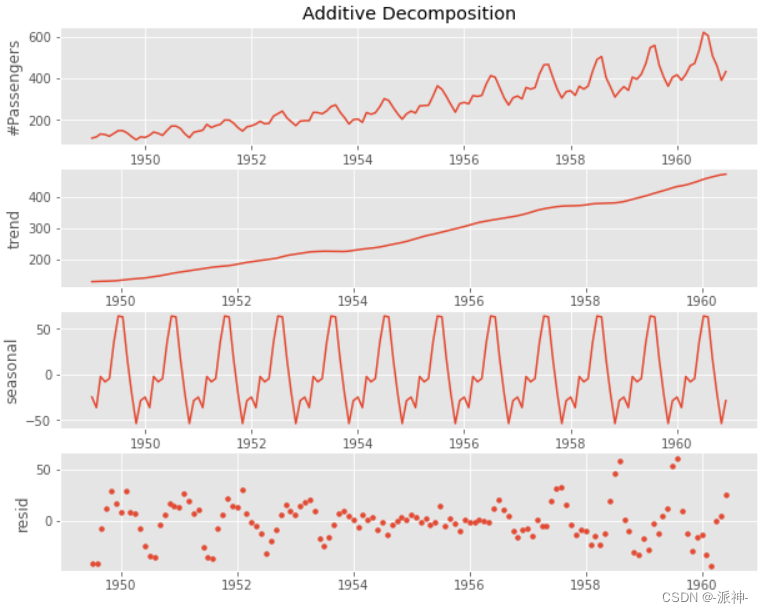
为了对时间序列数据进行准确预测必须了解时间序列数据的主要成分,如何找到数据中的主要成分,如何快速分解时间序列,本文会帮助读者了解时间序列数据预测的相关内容。