- @wangshuai6707


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
#拉取镜像docker pull fauria/vsftpd#启动容器docker run -d -v /data/ftp:/home/vsftpd -p 20:20 -p 21:21 -p 21100-21110:21100-21110 -e FTP_USER=dev -e FTP_PASS=admin -e PASV_ADDRESS=192.168.8.29 -e PASV_MIN...
安全风险:可能会劝说初级用户提供诸如用户名、密码、信用卡号、社会保险号等敏感信息可能会窃取或操纵客户会话和 cookie,它们可能用于模仿合法用户,从而使黑客能够以该用户身份查看或变更用户记录以及执行事务可能会在 Web 服务器上上载、修改或删除 Web 页面、脚本和文件可能原因未对用户输入正确执行危险字符清理技术描述“链接注入”是修
我们的服务和实例数比较多,有的时候部分实例可能资源竞争或者OOM问题导致服务已经假死,或者心跳已经停止,但是由于监控平台不完善,没有及时的通知到对应的应用负责人,导致服务异常,甚至导致连锁崩掉。为了解决这个问题,写了一个简易版本的,以及对简易版本进行了优化,服务上下线通知。本来想找个nacos客户端中现成的服务发现的监听类或者其他工具类进行,nacos所有服务的变化通知,发现没有找到 进行订阅。过
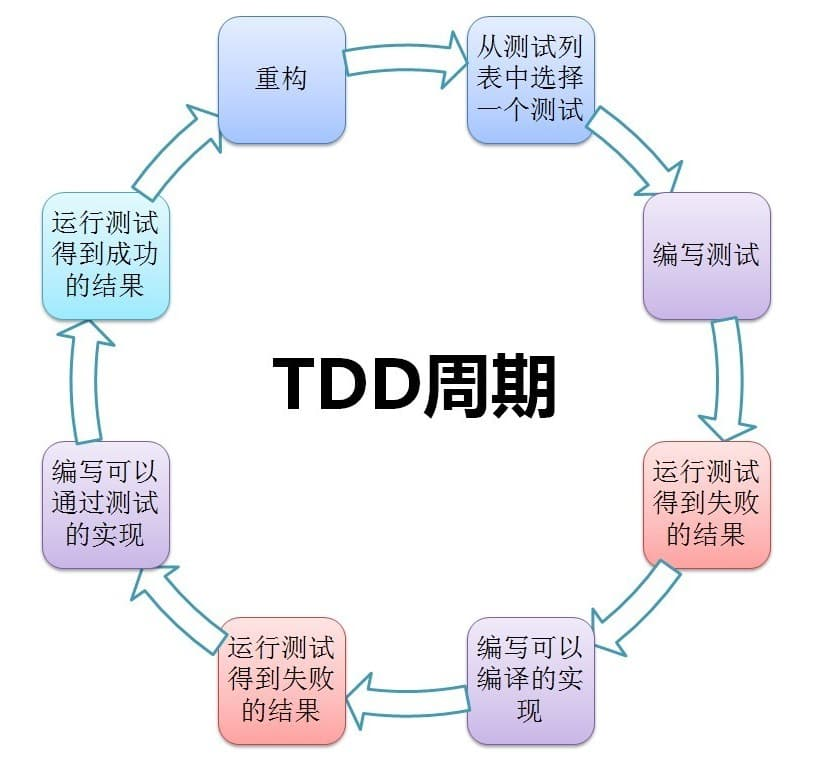
测试驱动开发(Test-Driven Development,简称TDD)是一种软件开发方法论,它强调在编写实现代码之前先编写测试代码。TDD是极限编程(XP)的一部分,但也可以单独作为一种开发方法使用。编写一个失败的测试:首先,开发者会针对一个新的功能或需求编写一个测试用例。此时,由于尚未编写实现代码,这个测试用例会失败。编写实现代码:然后,开发者会编写尽可能简单的代码,以使这个测试用例通过。重
📌 Ollama本地大模型部署指南 Ollama是一款开源工具,支持在本地快速部署Llama、Mistral等大模型,无需API Key,适合开发者和普通用户。 🔹 快速安装 macOS/Linux/Windows一键安装,默认端口11434 运行模型仅需 ollama run <模型名>,自动下载所需文件 🔹 常用模型推荐 Llama 3.2(通用对话)、Mistral(编程推
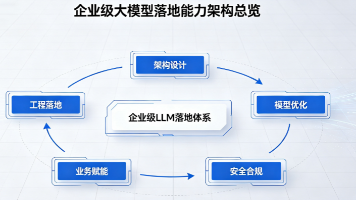
《企业大模型落地困境与突破路径》 本文基于作者两年AI转型经验和半年多企业大模型项目实践,深度剖析了当前企业级大模型落地的真实困境与认知误区。文章揭示了一个行业怪象:演示效果惊艳的模型在生产环境中往往全面失效,许多项目最终沦为内部演示工具。 核心观点包括: 完整的企业级大模型体系需要架构设计、工程落地、模型优化、业务赋能和安全合规五大模块闭环; 四大核心痛点:生产环境失效、成本收益失衡、难以规模化
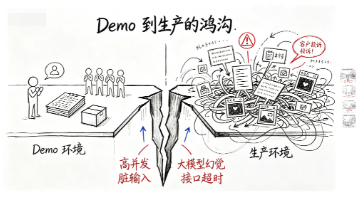
我先讲个真事。去年一家做城配的物流公司找到我,他们技术团队用开源框架搭了个智能客服 Demo:把运单查询、时效说明喂给大模型,内部演示的时候,老板问「我的货到哪了」,模型对答如流,全场鼓掌。老板当场拍板:下个月上线。结果上线第一周就崩了。
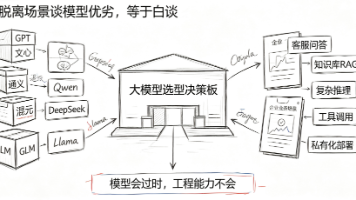
本文探讨了大模型选型的关键问题,强调脱离业务场景谈模型优劣毫无意义。作者将主流大模型分为闭源商用和开源两大阵营分析:闭源模型(如GPT、文心、通义、混元)开箱即用但存在数据合规和生态绑定风险,建议做好接口抽象;开源模型(如Qwen、DeepSeek、GLM、Llama)灵活但需承担部署优化等隐性成本。针对四大典型场景(客服对话、复杂推理、知识问答、工具调用)给出选型建议,指出知识库问答应侧重检索优
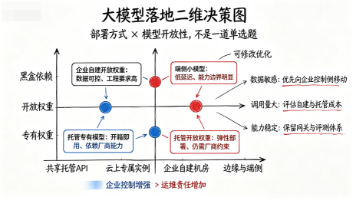
大家好,我是冰点,今天我们聊聊大模型落地里最容易吵架的一个决策:到底用公有云 API,还是私有化部署,还是开放权重自建。我参加过好几次这种选型会,场面都差不多:安全部门说数据不能出域,必须私有化;财务说私有化要买卡买机器,预算批不下来;业务说你们别吵了,下个月就要上线。三方说的都有道理,但也都只说了一半。这件事没有标准答案,得把数据、成本、团队和业务时限放在一起取舍。这一节我就把账掰开讲,最后给一
插图主题:以 “学习成本、扩展性、生态兼容性、维护保障、开发效率” 为维度,展示 Spring AI 与其他 Java AI 开发方案(如原生 SDK 封装、第三方小众框架)的对比,突出 Spring AI 的综合优势。插图主题:自上而下分层展示 “业务场景层 → 核心能力层 → 生态适配层”,每层标注核心组件 / 功能,用箭头表示层间依赖关系,补充场景组合示例(如 “智能客服” 的组件组合)插图