


- @sjyttkl


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
Hibernae 的延迟加载是一个非常常用的技术,实体的集合属性默认会被延迟加载,实体所关联的实体默认也会被延迟加载。Hibernate 通过这种延迟加载来降低系统的内存开销,从而保证 Hibernate 的运行性能。下面先来剖析 Hibernate 延迟加载的“秘密”。集合属性的延迟加载当 Hibernate 从数据库中初始化某个持久化实体时,该实体的集合属性是否随持久化
【1】什么是最小生成树?对于连通的带权图(连通网)G,其生成树也是带权的。生成树T各边的权值总和称为该树的权。权最小的生成树称为G的最小生成树(Minimum SpannirngTree)。简记为MST。注意:最小是指权值最小一个连通图的生成树是一个极小的连通子图,它包含全部的顶点,但只有足以构成一棵树的n-1条边。求最小生成树有两种算法:普里姆算法
知识蒸馏是一种模型压缩方法,是一种基于“教师-学生网络思想”的训练方法,由于其简单,有效,在工业界被广泛应用。这一技术的理论来自于2015年Hinton发表的一篇神作:论文链接arxiv.orgKnowledge Distillation,简称KD,顾名思义,就是将已经训练好的模型包含的知识(”Knowledge”),蒸馏("Distill")提取到另一个模型里面去。今天,我们就来简单读一下这篇
【1】关键路径在我的经验意识深处,“关键”二字一般都是指临界点。凡事万物都遵循一个度的问题,那么存在度就会自然有临界点。关键路径也正是研究这个临界点的问题。在学习关键路径前,先了解一个AOV网和AOE网的概念:用顶点表示活动,用弧表示活动间的优先关系的有向图:称为顶点表示活动的网(Activity On Vertex Network),简称为
前言一个人坚持自己的兴趣是比较难的,因为太多的人太容易为外界所动了,而尤其当你无法从中得到多少实际性的回报时,所幸,我能一直坚持下来。毕达哥拉斯学派有句名言:“万物皆数”,最近读完「微积分概念发展史」后也感受到了这一点。同时,从算法到数据挖掘、机器学习,再到数学,其中每一个领域任何一个细节都值得探索终生,或许,这就是“终生为学”的意思。本文各部分内容分布如下
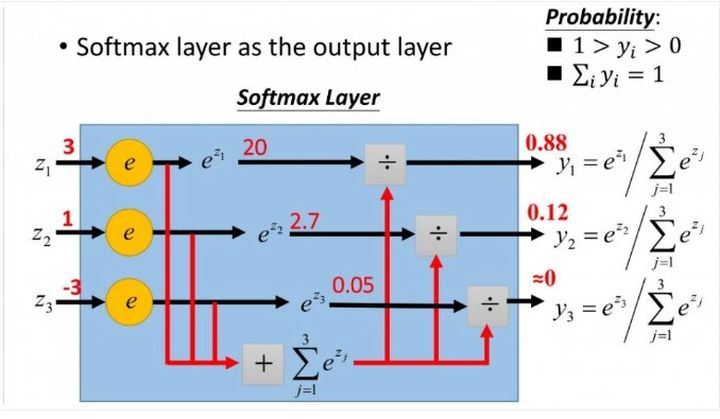
多分类任务损失函数:多分类问题一般用softmax作为神经网络的最后一层,然后计算交叉熵损失。TensorFlow中的tf.nn.softmax_cross_entropy_with_logits函数可以直接计算多分类损失。
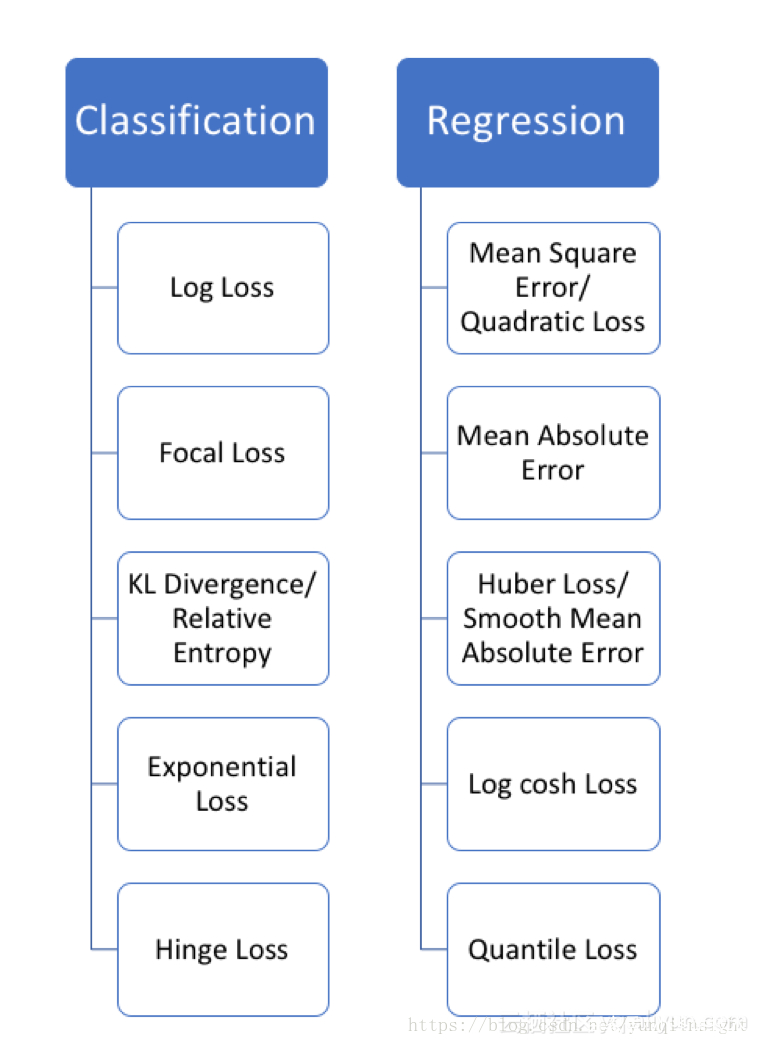
深度学习(tensorflow)中的所有学习算法都必须 有一个 最小化或最大化一个函数,称之为损失函数(loss function),或“目标函数”、“代价函数”。损失函数是衡量模型的效果评估。损失函数严格上可分为两类:分类损失和回归损失,其中分类损失根据类别数量又可分为二分类损失和多分类损失。在使用的时候需要注意的是:回归函数预测数量,分类函数预测标签。
深度学习1. 视觉计算任务有哪些,你怎么分类 ?我把任务分为像素级别、目标级别、理解级别。像素级别的任务一般是传统的图像处理任务,他们不需要用到图像的语义信息,或者最多用到底层特征(比如图像的边缘、纹理),这些任务有图像增强、传统的图像复原(如去噪、去模糊)、传统的图像分割(比如基于种子生长的方法)、图像加密等。目标级别的任务需要用到语义信息,所以提取的特征是高层特征,CNN作为...
多分类任务损失函数:多分类问题一般用softmax作为神经网络的最后一层,然后计算交叉熵损失。TensorFlow中的tf.nn.softmax_cross_entropy_with_logits函数可以直接计算多分类损失。
在很多机器学习和深度学习的应用中,我们发现用的最多的优化器是 Adam,为什么呢?下面是 TensorFlow 中的优化器https://www.tensorflow.org/api_guides/python/train在 keras 中也有 SGD,RMSprop,Adagrad,Adadelta,Adam等:https://keras.io/optimizers/我...