- @shayuchaor


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
最近写爬虫的时候遇到了一个用HTTP 2.0协议的网站,requests那套老经验在它身上不好用了,得专门针对HTTP 2.0进行开发。因为与HTTP 1.x的爬虫颇有区别,所以写篇文章记录一下。考虑到大多数读者应该更关心实践操作,所以本文会采取倒金字塔结构,首先介绍HTTP 2.0的爬虫代码该怎么写,然后在慢慢讲解HTTP 2.0的基础理论知识。
本文会介绍加速乐cookie中的__jsl_clearance的生成方式。纯粹技术讨论,如果侵害到任何人的利益,请联系本人邮箱yu_haojia@foxmail.com,会立刻删除。
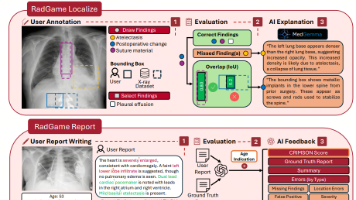
训练数据:SynGen-Vision提出合成数据生成方法,通过视觉语言模型和3D引擎生成工业锈蚀检测数据,提升模型性能。 Agent应用: WebProber框架通过AI Agent自动化检测网站问题,发现传统工具未识别的29个可用性问题。 TalkToAgent用多Agent框架为强化学习提供自然语言解释,增强可解释性。 V-Droid通过验证器优化移动GUI任务决策,显著提高任务成功率。 研究
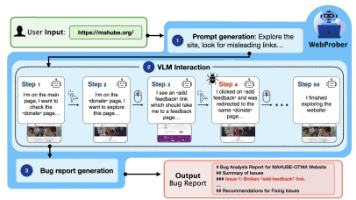
在Agent系统方面,Preacher实现了论文到视频的自动转换,ChatCFD构建了OpenFOAM仿真的自动化流程,CAFA开发了助听器个性化调整方案,MESHAgents则用于心脏表型分析。大模型行业应用方面,Curia构建了130TB的放射学基础模型,MM-DINOv2优化了医学图像分析。文生图/视频领域,IRG框架通过交错推理提升生成质量,Zo3T实现零样本视频生成。

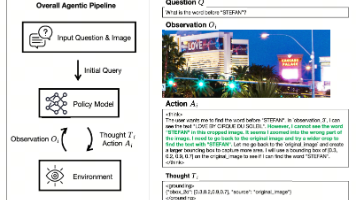
在数据集方面,Visual-TableQA和EgoGazeVQA分别针对表格图像推理和注视引导视频问答提出新基准;在智能体领域,Mini-o3、TA-VLA等研究探索了视觉搜索、力矩感知和视频推理的新方法;行业应用方面,医疗、教育等领域涌现出数据高效微调、联邦学习等创新方案;文生图/视频技术结合神经隐式表示实现矢量动画。此外,HiPhO物理竞赛基准、TextlessRAG无文本问答框架等突破性工作
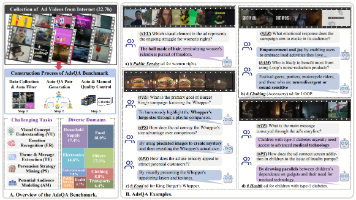
在数据方面,GeneVA数据集系统标注文生视频伪影,AdsQA构建广告视频理解基准,VR语音转录增强提升共指消解性能;模型应用上,FinZero实现金融时序预测,VLM成功用于中微子检测和皮肤病诊断,CLAPS实现视网膜图像统一分割;生成技术中,RewardDance创新奖励机制提升视觉生成质量,HuMo框架实现多模态人体视频生成。
在数据集方面,FLUX-Reason-6M(600万图像)和MMOral(牙科X光指令数据集)等填补了文生图推理、医疗多模态任务的数据空白;PRISM-Bench等评测基准推动模型优化。智能体领域提出非侵入式AR交互框架Sensible Agent,结合LMM实现情境感知。大模型应用扩展至医疗(DRiFt特征解耦框架)、无线通信(LLM驱动网络优化)及文生视频(Kling-Avatar级联动画生成

研究精选摘要 TASC框架提出任务感知共享控制方案,通过视觉语言模型辅助远程操作,提升任务效率并减少用户输入。 MagicMirror发布34万标注图像的文生图伪影评估数据集MagicData340K,并开发VLM模型MagicAssessor进行细粒度质量分析。 LaV-CoT创新多语言视觉问答框架,结合边界框识别与多阶段推理,在真实场景任务中表现优异。 SignClip通过融合手势与唇动特征改
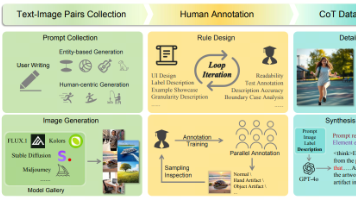
医疗AI方面,提出了基于Agent的时序图推理框架和X射线基础模型XR-0,并构建了百年医学病例数据集CPC-Bench。多模态生成领域,开发了布局到图像生成框架SMARLI和LiDAR序列生成系统LiDARCrafter。隐私保护方面,设计了Web Agent隐私插件PrivWeb。评估方法上,提出了语音模型测试基准C3T和视频质量数据集MVQA-68K。这些研究展现了AI在医疗、多模态生成、隐
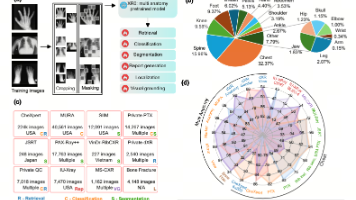
在工具使用方面,Tool-R1强化学习框架显著提升了LLM的工具操作能力。多模态数据集如WHU-STree和ChartGaze推动了视觉任务的发展,而合成数据生成方法解决了医疗领域数据稀缺问题。行业应用中,AI在放射学教育、糖尿病视网膜病变检测和语音治疗等方面展现出潜力。3D内容生成技术如Dream3DAvatar和Hunyuan3D Studio简化了游戏资产创作流程。