


- @qq_42458954


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
当想利用Python在网页上发表评论的时候,需要一些账号密码登录的信息,这个时候用requests.get()请求的话,账号密码全部会显示在网址上,这显然不科学!这个时候需要用post请求,可以这么理解,get是明文显示,post是非明文显示。通常,get请求会应用于获取网页数据,比如我们之前学的requests.get()。post请求则应用于向网页提交数据,比如提交表单类型数据(像账号密码..
使用make命令时发现报错: “ld cannot find lOpenCL" ,详细信息如下所示。的共享库文件,但是在默认情况下,它无法在共享库搜索路径中找到该文件。这些默认搜索路径包括。,那么该变量中列出的目录也将成为搜索路径。,那么它实际上是在寻找名为。来实现这一目的,或者编辑。或者,可以使用环境变量。找到之后便可以安装了。

编码风格是开发人员的偏好,因此没有“正确”的编码样式,但在团队合作中,需要行成统一的编码风格,以便团队中的其他人理解。尽管没有官方的样式指南,R仍然可以有一个“非正式”的约定俗成的编码规范。在本文中,您将学习这些“非正式”规则,它们的偏差以及最常见的样式。目录一、命名1.命名文件2.命名变量3.命名函数二、句法1. 页面长度2.空格3.大括号4.缩进5.新行6.注释其他References一、命名
UK Biobank(英国生物样本数据库),简称为UKB,UKB生物数据库是由维康信托基金和英国政府(医学研究委员会、卫生部和苏格兰行政院)资助,并注册成为一家慈善公司。该生物数据库是一个试点项目,目的是将英国电子医疗记录中的数据与遗传数据联系起来,从而建立一个更全的英国国民健康保险制度(National Health Service)生物库。它是目前世界上已建成人类遗传队列生物样本库中规模最大的
1.数据合并1)利用set语句进行纵向合并,用法格式为:data 数据集;set 数据集1(数据集选项)数据集2(数据集选项)…;run;数据集选项:set 数据集1(in=临时变量1)set数据集2(in=临时变量2)…;set数据集1(rename=(原名1=新名1…)) 数据集2(rename=(原名1=新名1…))…;...
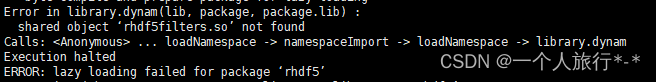
安装lighdf5-dev,并将安装路径链接至usr/lib/文件。先安装rhdf5filters,然后安装rhdf5。之后安装glmGamPoi包成功!
原文链接:https://www.jianshu.com/p/066d90b556ad1、微生物β多样性利用宏基因组、16s rRNA测序等高通量测序技术分析微生物群体结构的时候,常见到有α和β多样性两个指标。α多样性主要反映样本内多样性,而β多样性指的是样本间多样性(Between-sample diversity),它的本质是一个量化的数值,其值的大小反映每个组内各个样本间的群落物种组...
UK Biobank(英国生物样本数据库),简称为UKB,UKB生物数据库是由维康信托基金和英国政府(医学研究委员会、卫生部和苏格兰行政院)资助,并注册成为一家慈善公司。该生物数据库是一个试点项目,目的是将英国电子医疗记录中的数据与遗传数据联系起来,从而建立一个更全的英国国民健康保险制度(National Health Service)生物库。它是目前世界上已建成人类遗传队列生物样本库中规模最大的
学习预测函数的参数,并在相同数据集上进行测试是一种错误的做法: 一个仅给出测试用例标签的模型将会获得极高的分数,但对于尚未出现过的数据它则无法预测出任何有用的信息。例如,如果数据是从不同的 subjects 获得的,每个 subject 有多个样本,并且如果模型足够灵活以高度人物指定的特征中学习,则可能无法推广到新的 subject。StratifiedShuffleSplit 是 Shuffle
UK Biobank(英国生物样本数据库),简称为UKB,UKB生物数据库是由维康信托基金和英国政府(医学研究委员会、卫生部和苏格兰行政院)资助,并注册成为一家慈善公司。该生物数据库是一个试点项目,目的是将英国电子医疗记录中的数据与遗传数据联系起来,从而建立一个更全的英国国民健康保险制度(National Health Service)生物库。它是目前世界上已建成人类遗传队列生物样本库中规模最大的