- @qq_40767468


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
语言模型技术十年演进:从Siri到ChatGPT的智能跃迁 过去十年,人机交互经历了从简单问答到深度对话的变革。早期基于规则和统计的方法(2011-2016)受限于语义理解和上下文处理。2017年Transformer架构的诞生开启新纪元,2018年后BERT和GPT分道扬镳,模型规模呈指数增长。2020年后的对齐技术(如RLHF)使ChatGPT能更好理解人类意图,当前正向多模态和专业化发展。技

本文系统介绍了GPU服务器的硬件结构与核心模块。主要内容包括:1)GPU服务器整体外观及典型示例;2)核心模块组成(GPU模组和CPU计算节点);3)GPU模组的核心部件(UBB板、OAM模块、NVSwitch芯片等);4)CPU计算节点的详细部件及功能;5)销售重点掌握的模块化设计、高速互联、可靠供电等核心价值主张。文章旨在帮助读者全面了解GPU服务器硬件架构,为销售人员在产品介绍和客户沟通中提

GPU服务器CPU选型分析:Intel至强与AMD霄龙是主流选择,前者以稳定性和成熟生态见长,后者在多核密度和PCIe通道上占优。CPU作为系统控制核心,需平衡单核性能与多核并行能力,同时确保充足的PCIe通道和内存带宽以避免瓶颈。选型需基于工作负载特征,AI训练推荐高核心配置,推理服务侧重单核性能。当前技术趋势聚焦PCIe5.0/6.0和Chiplet架构,建议在性能需求、成本控制和扩展性间取得

摘要:本文对比分析了传统硬件管理标准IPMI与现代Redfish的技术特性及适用场景。IPMI作为独立于操作系统的硬件级管理规范,通过BMC芯片实现基础监控功能,但存在扩展性不足、安全性弱等局限。Redfish采用RESTful架构和JSON数据格式,支持精细化的GPU设备管理、精准散热控制和多节点统一管理,特别是在AI服务器场景下优势显著。NVIDIA已深度集成Redfish实现GPU全生命周期
NVLink:NVIDIA 突破数据传输瓶颈的核心,以高带宽、低延迟提升多芯片协同性能,支持统一内存访问,借 NVSwitch 实现灵活拓扑,NVLink Fusion 开放后向异构计算生态延伸。NVSwitch:基于 NVLink 构建,解决大规模 GPU 集群的高带宽、低延迟通信需求,Blackwell 架构下性能升级,适配更复杂 AI 模型。SXM:为数据中心 GPU(如 H100)提供超

摘要:NVIDIA DGX系列AI服务器采用创新的"机头+模组"模块化架构设计。机头作为系统核心,集成CPU、内存、网络等控制单元,负责整体调度;模组则专为GPU计算优化,支持4-8块高性能GPU及高速NVLink互联。该架构通过分离计算控制与GPU运算,实现了卓越的热管理、电源分配和维护性。完整系统还包含先进的散热方案、高可靠供电、高速存储网络等子系统,支持10-15kW功率
微通道液冷板(MLCP)技术通过在芯片内部集成微米级冷却流道(≤100μm),实现直接接触式高效散热,可应对2000W以上AI芯片的极端热负荷。该技术突破传统散热瓶颈,热阻值低于0.015℃·cm/W,效率提升3-5倍。核心创新在于微尺度流体动力学设计、高导热材料(纯铜/纳米涂层)应用及精密制造工艺(3D打印/激光雕刻)。当前面临制造精度、良率成本和系统集成等挑战,但已在NVIDIA Rubin等
本文分析了RTX4090魔改48GB显存的技术路线,并探讨了RTX5090魔改128GB显存的可行性。RTX4090通过PCB背面加装12颗GDDR6X显存颗粒和VBIOS固件改造实现48GB容量,其成功验证了英伟达显卡的硬件复用设计。而RTX5090要实现128GB需突破32Gb GDDR7颗粒量产和显存控制器兼容性两大技术壁垒,目前仅理论可行。文章还预测了魔改技术对产业链的影响,包括加速GDD
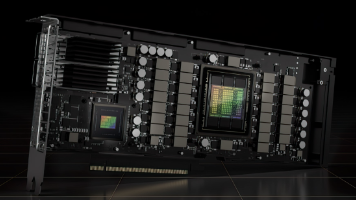
本文全面介绍了搭建多GPU工作站的完整流程。首先从硬件选型入手,详细分析了GPU、主板、CPU等关键组件的选择标准,并提供了电源与散热系统的规划建议。随后分步骤讲解了物理安装流程,包括防静电措施、GPU安装顺序等注意事项,并提供了驱动安装脚本和验证方法。最后介绍了CUDA环境配置和深度学习框架中的多GPU编程实现,为研究人员构建高效计算平台提供了实用指导。通过合理配置多GPU系统,可显著提升大规模
AI时代GPU选择指南 随着AI技术的快速发展,选择合适的GPU成为开发者面临的重要决策。本文系统分析了不同AI任务对GPU的需求特征,提供了实用的选择框架: 任务与模型匹配:从学习实验到企业级训练,不同规模的模型对显存和计算性能有明确需求,建议根据具体任务选择4GB到48GB+显存的GPU。 关键参数考量:显存容量是最重要约束,计算性能、专业特性(如ECC显存)和能效比也需要综合评估。 预算场景