- @qq_34941290


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
MVC 模式是一种软件架构模式,用于将应用程序分为三个主要部分:模型(Model)、视图(View)和控制器(Controller)。这种分离使得应用程序的结构更加清晰,便于管理和扩展。
组合模式(Composite Pattern)是一种结构型设计模式,它允许将对象组合成树形结构以表示“部分-整体”的层次关系。组合模式使得客户端对单个对象和组合对象的使用具有一致性。换句话说,组合模式可以让客户端以相同的方式对待单个对象和对象的集合。在组合模式中,组件(Component)是一个抽象类或接口,定义了所有具体组件和组合的接口。叶子(Leaf)是组合中的基本元素,不能再包含其他子元素。
抽象工厂模式提供一个接口,用于创建一系列相关或相互依赖的对象,而无需指定它们的具体类。抽象工厂模式通常用于需要创建多个相关对象的场景。# 产品接口passpass# 具体产品类# 抽象工厂接口passpass# 具体工厂类# 客户端代码print(product_a1.operation_a()) # 输出: Result of ConcreteProductA1。
我们将创建一个Logger类,使用单例模式确保只有一个日志记录器实例。该类将提供记录日志的功能,并将日志输出到文件中。import os# 使用示例print(logger1 is logger2) # 输出: True,两个变量指向同一个实例。

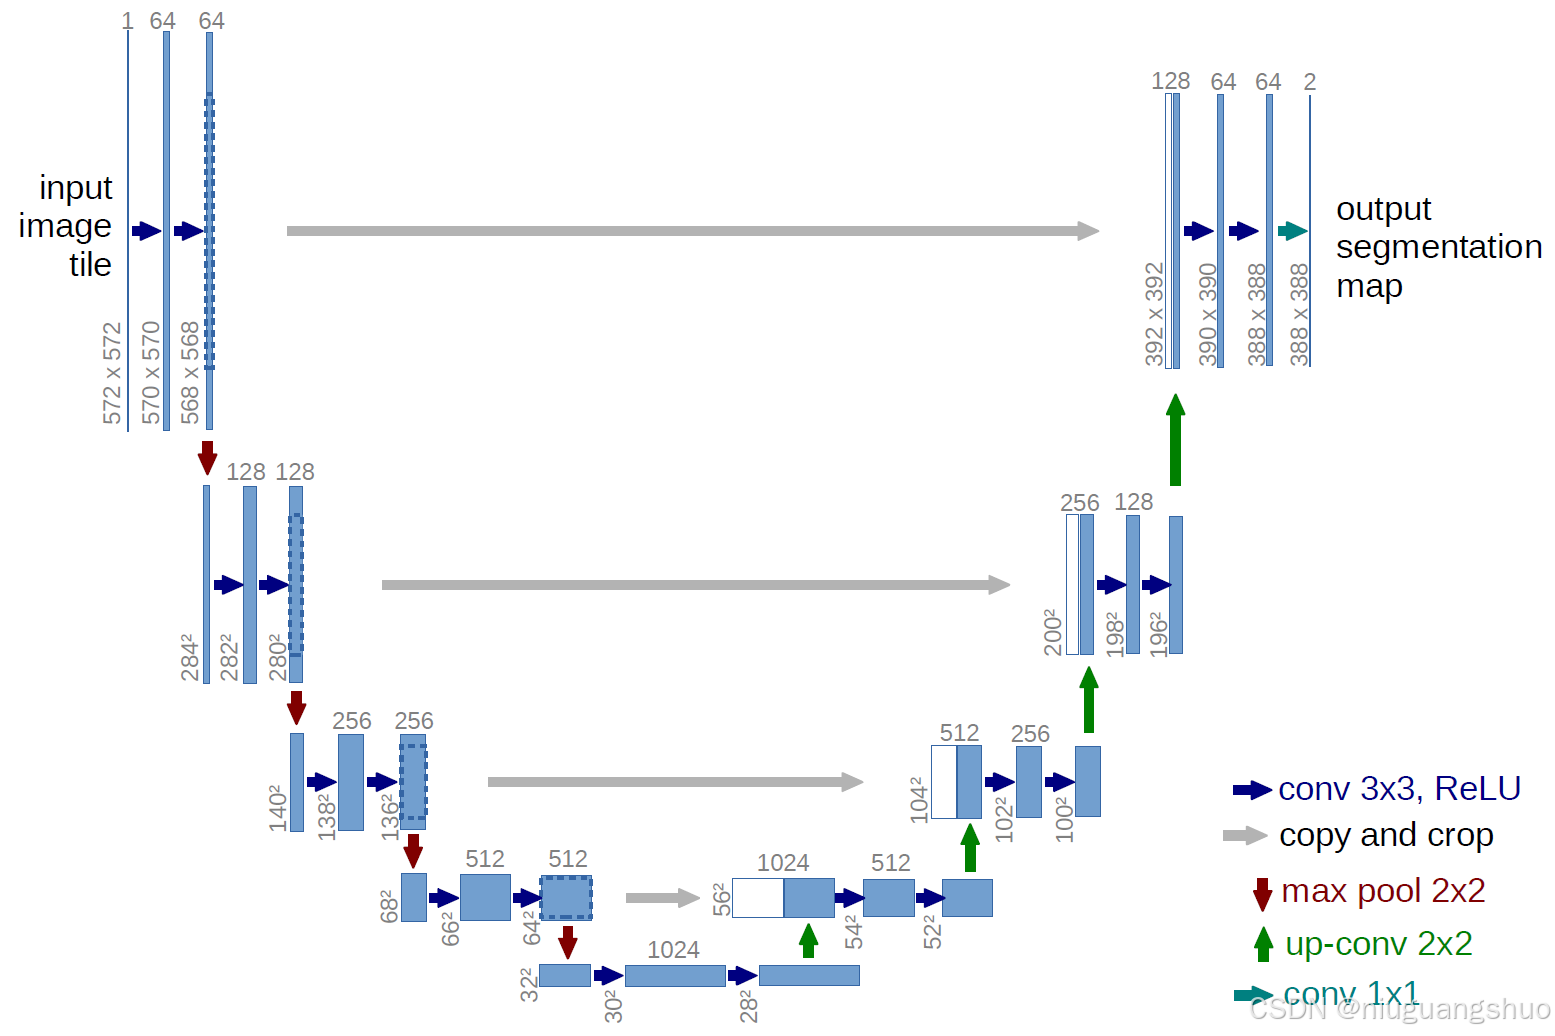
U-Net 是一种用于图像分割的卷积神经网络架构,其设计旨在处理生物医学图像分割任务。U-Net 的网络结构具有对称性,包含编码器和解码器两个主要部分,并通过跳跃连接(skip connections)将两者连接起来。U-Net 网络结构因其对称性而得名,形似英文字母 “U”。整个网络架构由蓝色和白色框表示特征图(feature map),不同颜色的箭头则代表了不同的操作和连接方式。
在这篇博客中,我们将深入探讨 ICASSP 2022 会议上提出的 AEC 基线模型的实现。该模型旨在通过深度学习技术改善音频信号的质量,特别是在回声消除和噪声抑制方面。

在 AEC 算法中,我们使用了几个关键变量。远端信号fnf[n]fn:表示远端讲话者的声音信号,通常是通过远端麦克风捕获的信号。回声路径hnh[n]hn:描述扬声器到麦克风的传递特性,通常用冲激响应表示。近端语音信号sns[n]sn:近端说话人的语音信号(包括环境噪声)的组合。近端麦克风接收信号dnd[n]dn:表示近端麦克风接收到的信号,包含了远端回声、近端说话人的声音以及环境噪声。dnfn∗h
通过将图像形成过程分解为去噪自编码器的顺序应用,扩散模型(DMs)在图像数据及其他领域实现了最先进的合成结果。此外,它们的公式允许一种引导机制来控制图像生成过程而无需重新训练。然而,由于这些模型通常直接在像素空间操作,强大DMs的优化往往消耗数百个GPU天,且推理因顺序评估而昂贵。为了在有限计算资源上实现DM训练,同时保持其质量和灵活性,我们将其应用于强大预训练自编码器的潜在空间。与先前工作相比,
技术维度自回归模型(VQGAN+Transformer)核心公式/表示生成方式非自回归(扩散)非自回归(扩散)自回归(序列建模)pz∝Nz;μσ2pz∝Nz;μσ2UNet架构8.6亿参数,固定Transformer块数26亿参数,异构Transformer块分布无UNet,采用Transformer序列建模nln_lnl固定/nl∈0210nl∈0210/$p(z_i文本编码单一CLIP编码
想象一下,你要教一个刚来地球的外星人学中文。你直接扔给他一整本《红楼梦》,他肯定会崩溃。更合理的方法是,先教他认识单个的汉字、词语,再理解句子。对于计算机而言,我们就是那个“外星人”。它只认识数字(0和1)。分词器的核心任务,就是完成例如:句子。