


- @oracle8090


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
一、物理存储方面hive数据存储的格式有文本格式(TextFile)、二进制序列化文件(sequenceFile)、行列式文件(RCFile)、Apache Parquent 和 优化的行列式文件(ORCFile)ORCFile 和 Parquent,高效的数据存储和数据处理性能得以在实际的生产环境中大量运用。同时 ORCfile对于索引的处理进行了优化Bloom Filter Index 和 R
Impala推荐使用parquet格式,不支持ORC,Rcfile- Hive 0.x版本推荐使用rcfile- PrestoDB推荐使用ORC- Spark支持ORC,Parquet,RcfileParquet与ORC对比orc.compress:表示ORC文件的压缩类型,「可选的类型有NONE、ZLB和SNAPPY,默认值是ZLIB(Snappy不支持切片)parquet. compressi
数据仓库数仓架构基础架构Kimball、Inmon数仓是一种规范数仓是一种思想解决方案元数据管理数据质量数据安全生命周期数据模型、数据字典血缘关系 DAG技术元数据、业务元数据权限命名规范开发规范流程规范设计规范
spark 读取文件 产生分区原理
package com.tableApiTestimport org.apache.flink.streaming.api.scala._import org.apache.flink.table.api.{DataTypes, Table}import org.apache.flink.table.api.scala._import org.apache.flink.table.descript
场景,代码没有执行git add 也没有执行git commit ,执行了 git reset --hard的命令,导致本地新修改的代码都没有了如果你恰巧用的是idea 开发工具就可以很快的找回来点击你的java类文件,右键----> Local History---> Show History 就可以找到之前修改的代码...
一、idstype1A1C1E2B2D2FidsABCDEF11010102010101将第一个表格的数据变成第二种两种...
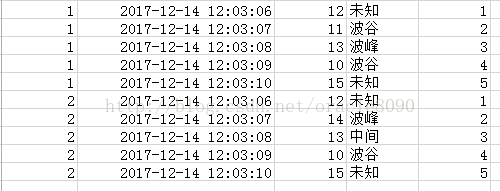
需求 对与统一类别的股票在连续时间的三个价格中 如果中间的价格比旁边的高为波峰 比方便的低为波谷比如下图11,10为波谷 13为波峰1513121110
一、动态分区参考http://lxw1234.com/archives/2015/06/286.htmhive.exec.dynamic.partition默认值:false是否开启动态分区功能,默认false关闭。使用动态分区时候,该参数必须设置成true;hive.exec.dynamic.partition.mode默认值:strict动态分区的模式,默认strict,表示...
sparkSQL 实现wordcount