


- @m0_66899341


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
摘要:本研究提出LLMSynthor框架,利用大型语言模型(LLMs)作为非参数Copula模拟器生成统计对齐的合成数据。传统方法受限于参数假设和高维数据处理,而LLMSynthor通过迭代合成循环和LLMProposalSampling技术,有效捕捉高阶依赖关系并提升采样效率。实验表明,该框架在电子商务、人口统计和流动性分析等隐私敏感领域,生成的数据具有高度统计保真度和实用性。尽管存在行为偏差和

我们介绍了一种新颖的高质量基准,即PHYBench,旨在评估大型语言模型(LLMs)在物理环境中的推理能力。PHYBench由500个精心策划的物理问题组成,这些问题基于现实世界的物理场景,旨在评估模型理解和推理现实物理过程的能力。该基准涵盖了力学、电磁学、热力学、光学、现代物理学和高等物理学,难度范围从高中练习到本科问题和物理奥林匹克竞赛挑战。

近年来,大型语言模型(LLMs)取得了显著进展,展现出了强大的通用推理能力,然而它们在金融推理方面的有效性仍有待深入探索。在本研究中,我们全面评估了16款功能强大的推理型和通用型大型语言模型在三项复杂金融任务上的表现,这些任务涉及金融文本、表格数据和方程式,评估内容涵盖数值推理、表格解读、金融术语理解、长上下文处理以及基于方程式的问题解决。
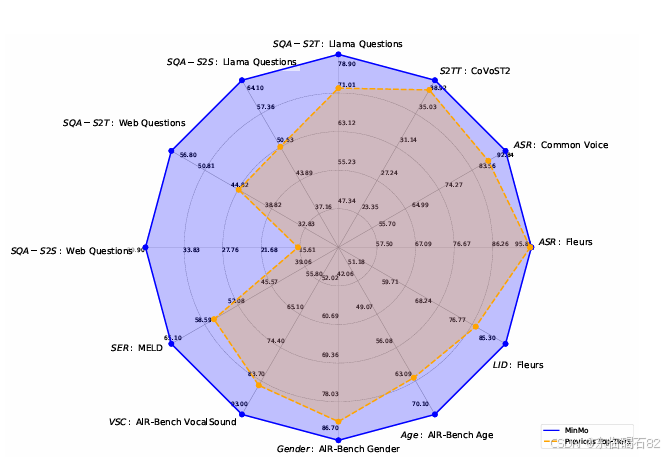
MinMo的模型架构如图3所示,主要包括语音编码器、输入投影器、大型语言模型(LLM)、语音令牌语言模型(Voice Token LM)、输出投影器、令牌到波形(Token2Wav)合成器以及全双工预测器。语音编码器:采用预训练的SenseVoice-large编码器模块,提供强大的语音理解能力,支持多语种语音识别、情感识别和音频事件检测。输入投影器:由两层Transformer和一个CNN层组成
最开始以为是网络环境的问题(但其实那个pypi.org网址直接可以访问,也不需要代理)或者conda配置环境的问题,中间各种AI问文心一言、问豆包、百度、Google,各种尝试包括重建环境,修改配置文件,AI还告诉说不要使用pip使用conda来安装等等都不灵。3. 后来尝试pip install numpy这个很基本的包也不行,才意识到是这个环境下安装的问题。里面建议的是用conda来配置Pyt
近年来,基于视频的多模态大型语言模型(Video-LLMs)通过将视频处理为图像帧序列,显著提升了视频理解能力。然而,许多现有方法在视觉主干网络中独立处理各帧,缺乏显式的时序建模,这限制了它们捕捉动态模式并高效处理长视频的能力。为了解决这些局限,我们提出了STORM(多模态大型语言模型的时空令牌缩减方法),这是一种在图像编码器和大型语言模型之间集成专用时序编码器的新颖架构。我们的时序编码器利用Ma

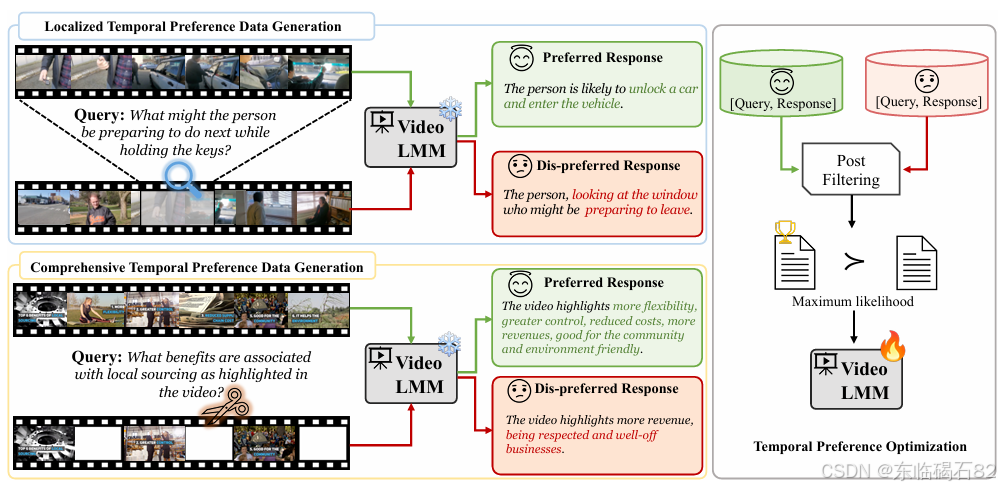
TPO是一种通过偏好学习增强视频大型多模态模型时间定位能力的后训练框架。它采用自训练方法,利用在两个粒度上精心策划的偏好数据集来优化模型。这些偏好数据集包括局部时间定位和全面时间定位两种类型,分别关注视频中的特定片段和整个视频序列中的扩展时间依赖关系。
《QuickVideo:长视频理解的高效协同设计》 摘要:针对VideoLLMs处理长视频时面临的计算瓶颈,本研究提出QuickVideo框架,通过系统算法协同设计显著提升了处理效率。该方案包含三大创新:1)QuickDecoder实现2-3倍并行解码加速;2)QuickPrefill采用KV缓存修剪技术减少内存占用;3)CPU-GPU重叠执行方案。实验表明,在30分钟视频处理中,端到端延迟从69

本文介绍了ARC-Hunyuan-Video多模态模型,该模型专为解决短视频理解难题而设计。研究针对当前大模型在时间结构化、深度视频理解方面的不足,开发了一个能端到端处理视觉、音频和文本信号的70亿参数模型。通过自动化标注流程生成高质量数据,采用多阶段训练策略(包括预训练、指令微调、强化学习等),模型实现了多粒度视频摘要、开放式问答、时序定位等功能。在ShortVid-Bench基准测试中展现出优

摘要:本文提出Diffuman4D方法,通过滑动迭代去噪机制增强4D扩散模型的时空一致性,实现稀疏视角视频的高质量视图合成。该方法定义4D潜在网格编码图像、位姿和姿态信息,采用滑动窗口在时空维度交替去噪,使信息充分流动。实验证明,在DNA-Rendering和ActorsHQ数据集上,该方法生成的视频在PSNR、SSIM等指标上显著优于现有技术,保持更好的时空连贯性,同时控制GPU内存消耗。研究还
