- @m0_63552826


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
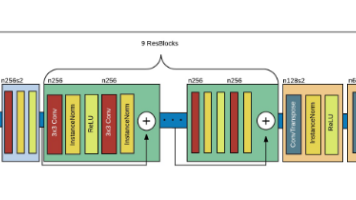
一般的内容损失是MAE(L1)和MSE(L2),这些会为了平均而导致一些模糊,作者采用了感知损失(Perceptual loss),他本质是一个简单的L2损失,但基于基于生成的CNN特征图与目标图像的差异,也就是只关注真实图和生成图的特征差异。D(x)是判断器对真实图片的判断,我们希望越大越好,同样对于D(G(x))能越准确的判断假图片,他的值越小,那么1-D(G(x))越接近1,所以最大化D就是
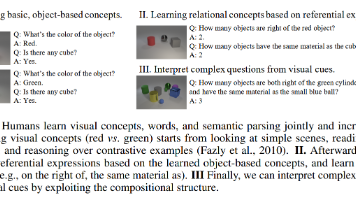
神经符号概念学习机(NS-CL),该模型学习视觉概念、单词和句子的语义解析,而不需要对其中任何一个进行明确的监督;作者的模型通过简单看图像和阅读成对的问题和答案来学习。其模型构建了一个基于对象的场景表示,将句子翻译成可执行的、符号化的程序。使用一个神经符号推理模块来连接两个模块的学习。类比于人类的概念学习,感知模块基于所指对象的语言描述来学习视觉概念。同时,学习到的视觉概念有助于学习新单词和解析新
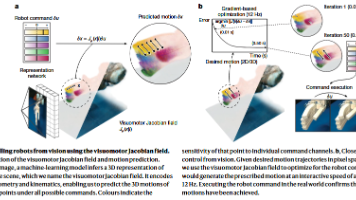
机器人是由多个“关节”或“执行器”(比如电机、气阀)控制的。我们把在某一时刻给所有这些执行器的。
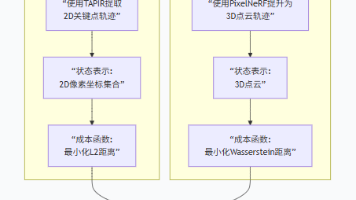
视觉运动雅可比场直接将任意三维点映射到其对应的系统雅可比,通过深度学习直接从输入图像中重构雅可比场而不是在专家设计的状态表示上进行条件化,这种做法绕过了传统流程中间复杂步骤(定义状态、建立动力学模型、计算雅可比);在传统的系统雅可比描述的是抽象状态。而本文的雅可比场是物理空间中具体的3D点的运动,这样使得我们可以查询机器人身上或周围。
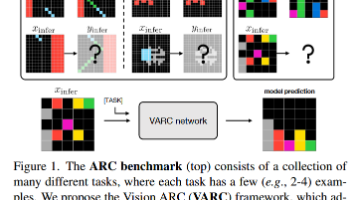
ARC(Abstraction and Reasoning Corpus)被设计以促进抽象推理的研究,而抽象推理是人类智能的一方面,常用的ARC方法是将其视为一个面向语言的问题,通过LLMs或者递归推理模型。但是尽管ARC中的拼图任务本质上是视觉的,但是目前的研究很少以视觉为中心来处理这个问题,在这项工作中,作者在视觉范式中建立了ARC,并将其框架作为图像到图像的翻译任务。为了合并视觉先验,作者把
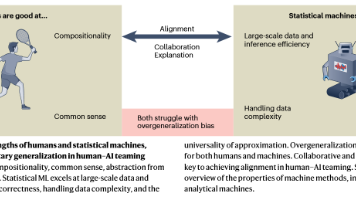
最后总结这篇论文,以下是我总结的思考为什么要实现人与AI的泛化能力对齐?如果不对齐有多大影响?A:从自动驾驶的方向入手,一个接受正常路况训练的AI,如果无法像人类一样泛化理解“孩子可能会突然跑上马路”这一常识,那么当它遇到训练数据中未曾出现的、一个皮球滚到路上的情况时,它可能不会像人类司机一样预见到风险而提前减速,从而酿成事故。可见泛化的对齐是保证AI可信任的前提。
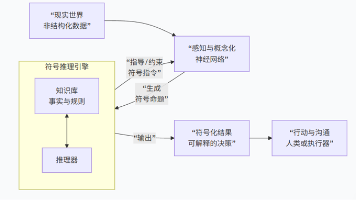
本文探讨人机协作中泛化方式的对齐问题。研究发现人类和AI的泛化机制存在本质差异:人类基于抽象概念和因果推理实现稳定泛化,而AI主要依赖数据统计相关性。作者从概念、方法和评估三个维度分析这些差异,指出当前AI的局限性在于缺乏语义理解和因果推理能力。为解决这一问题,论文提出神经符号AI的整合框架,将神经网络的感知能力与符号系统的推理能力相结合,以实现更符合人类认知的AI系统。研究强调,有效的人机协作需