
【论文阅读|2019】The Neuro-Symbolic Concept Learner: Interpreting Scenes, Words, and Sentences From Natura
论文来源:https://arxiv.org/abs/1904.12584
概述
神经符号概念学习机(NS-CL),该模型学习视觉概念、单词和句子的语义解析,而不需要对其中任何一个进行明确的监督;作者的模型通过简单看图像和阅读成对的问题和答案来学习。其模型构建了一个基于对象的场景表示,将句子翻译成可执行的、符号化的程序。使用一个神经符号推理模块来连接两个模块的学习。类比于人类的概念学习,感知模块基于所指对象的语言描述来学习视觉概念。同时,学习到的视觉概念有助于学习新单词和解析新句子。用课程学习来引导对图像和语言的大构成空间的搜素。实验证明该模型在学习视觉概念、单词表示和句子语义解析方面的准确性和高效性。除此之外,该方法可以推广到新的对象属性、成分、语言概念、场景和问题,甚至是新的程序领域。它还包括视觉问答和双向图像-文本检索在内的应用。
介绍
人类能通过结合视觉和语言来学习视觉概念。如下图所示:
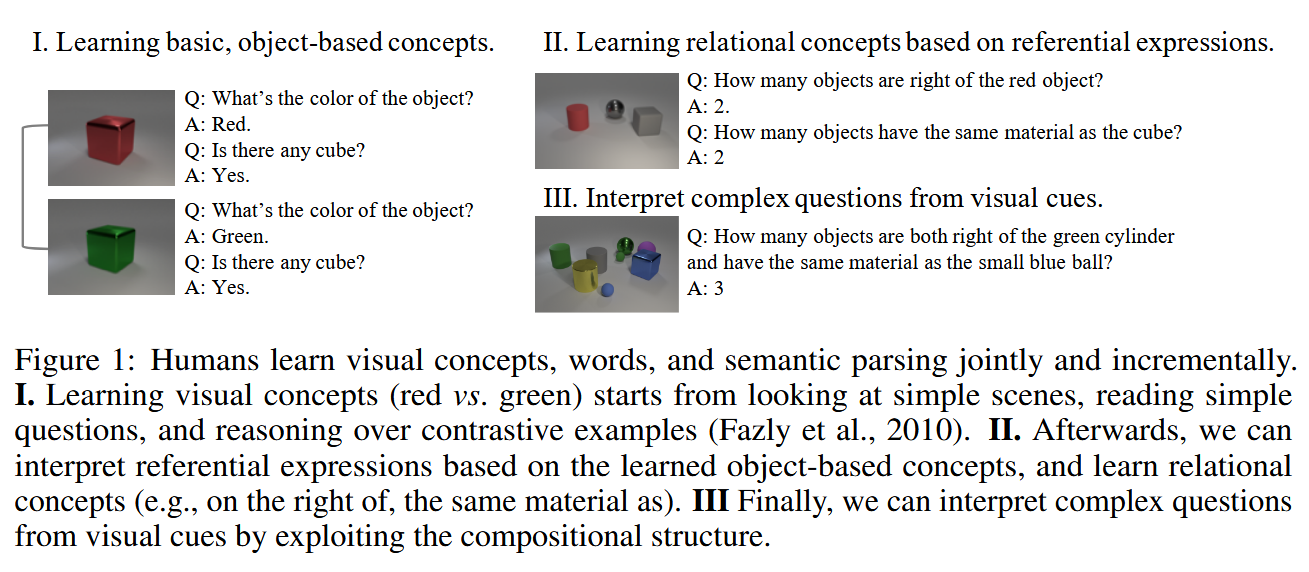
人类通过语言描述和视觉来学习概念,例如,通过学习红色和绿色两种颜色,通过看到红色和绿色的立方体和对应的问答来学习红色和绿色的差异,这种方式不仅能识别对象属性还能识别物体与物体之间的关系,最后还能将学习的到概念进行组合分析。而NS-CL就尝试这种方式去学习,从理解简单的场景到复杂的概念学习。
主要目标
-
无需任何显式监督(如物体标签、程序标注),仅通过图像 + 问答对进行学习。
-
学习可解释、可组合、可泛化的视觉和语言表示。
-
在视觉问答(VQA)、图像检索等任务上实现高性能和强泛化能力。
模型架构
基于神经的感知模块:从场景中提取对象级的表示
基于视觉背景的语义解析器:将问题翻译成可执行的程序
符号化的程序执行器:读取对象的感知,对其属性/关系进行分类,并执行程序得到答案。
模型优势
根据以上模型架构:视觉感知、语义解析、程序执行。这种设计使得可视化推理具有可解释性、鲁棒性和准确性。
更重要的是,它的视觉概念和语言概念被分开,但是互相对齐,从而实现了视觉场景和语义程序的组合泛化,学到的概念就像乐高积木一样组合,应对新的视觉场景或新的语言问题。
作者介绍了以下四种泛化能力:
对更多物体和更复杂程序的泛化:训练时虽然物体少,程序短,但是测试时可以处理更多物体和更长的程序,这体现了模型的通用推理规则组合泛化能力。
对新属性的泛化:使用CLEVR-CoGenT数据集上测试,该数据集中某些颜色和形状组合虽然在训练时没见过(训练时“红色”只出现在“立方体”上,测试时“红色”出现在“圆柱体”上),但是NS-CL仍能正确理解。
快速适应新概念:对于已经学会了7种颜色,现在要学习第8种颜色只需要少量样本就可以学会。
跨任务迁移:对学到的视觉概念可以直接用于新任务,无需微调视觉模块,只需要学习新任务对的语义解析部分就可以,这说明模型学到的概念是通用、可重复的。
总的来说,NS-CL不仅是一个高性能的视觉问答模型,还是一个具备强大泛化能力、可解释性、可扩展性的概念学习系统,它能应对更复杂的场景和问题、理解新的属性组合、快速学习新概念、无缝迁移到新任务。
神经符号概念学习
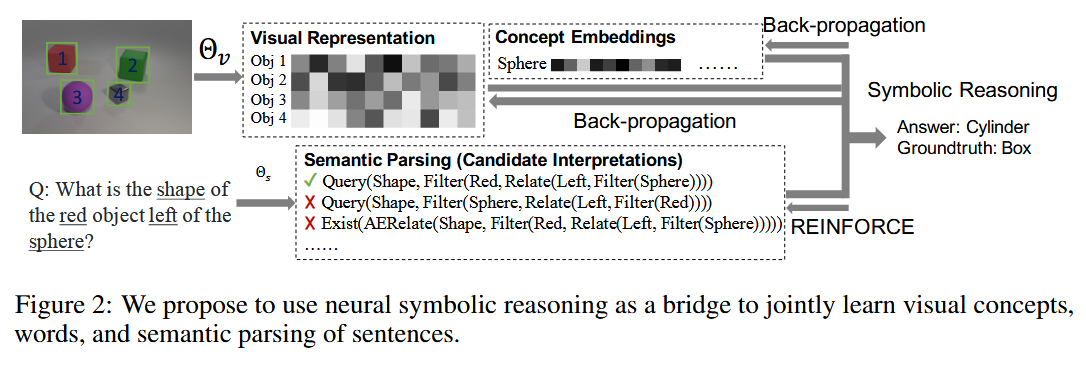
如上图所示
输入一张图片,视觉感知模块(Visual Perception Module)检测场景中的物体,并为每个物体提取深层的隐式表示(向量)
输入一个自然语言问题,使用DSL(领域特定语言)将问题翻译成DSL中的一个可执行程序。DSL里面定义了一组基本操作(如 Filter、Query、Relate 等)。
输出一个层次化的符号程序树,例:Query(Shape, Filter(Red, Relate(Left, Filter(Cube, Scene))))
通过视觉模块输出的物体表示和语义模块输出的程序,在物体上逐条执行程序指令,这个执行过程是符号化、确定性的,像运行一段代码,最后给出问题的答案。
Query(Shape, Filter(Red, Relate(Left, Filter(Cube, Scene)))),执行上述程序 → 先找“立方体”,再找“左边的物体”,再筛选“红色物体”,最后查询“形状” → 输出“圆柱体”。
关键设计
透明可追溯的执行过程:程序的执行是符号化的,所以执行路径完全可追溯。
完全可微分的执行器:虽然是符号执行,但是所有操作都是可推理的,梯度可以从答案反向传播到视觉表示和概念表示,支持端到端。
联合训练:使用图像-问题-答案三元组进行训练,让视觉模块和语义模块同时优化,提升问答准确率。
模型细节
视觉感知
步骤 1:物体检测
-
使用模型:预训练的 Mask R-CNN
-
输出:一系列物体候选框(bounding boxes),每个框对应一个物体。
步骤 2:特征提取
对每个物体执行以下操作:
a) 提取两种特征
-
基于区域的特征(Region-based features)
-
方法:使用 RoI Align 从原图中裁剪出该物体的区域。
-
提取网络:ResNet-34。
-
意义:捕捉该物体自身的外观信息(如颜色、纹理、形状)。
-
-
基于图像的特征(Image-based features)
-
方法:将整个原图输入同一个 ResNet-34。
-
提取方式:通常取某个中间层的特征图,或全局池化后的特征。
-
意义:捕捉该物体所处的全局上下文信息(如场景背景、光照、其他物体的相对位置)。
-
b) 拼接特征
将上述两种特征拼接(concatenate) 成一个向量。这个向量就是该物体的最终表示。
基于区域只知道物体长什么样,不知道物体在哪、多大、旁边是什么,而加入图像特征后模型能理解上下文关系,相对大小、空间位置和相对关系。从而支持关系推理。
概念量化
概念量化就是模型如何将视觉特征映射到具体的概念(如颜色、形状、关系等)并进行推理判断。
在NS-CL中,视觉属性(颜色、形状、材质)对应一个神经算子,算子将对象表示映射到一个视觉-语义空间。使用相似性的度量来对图像进行分类。
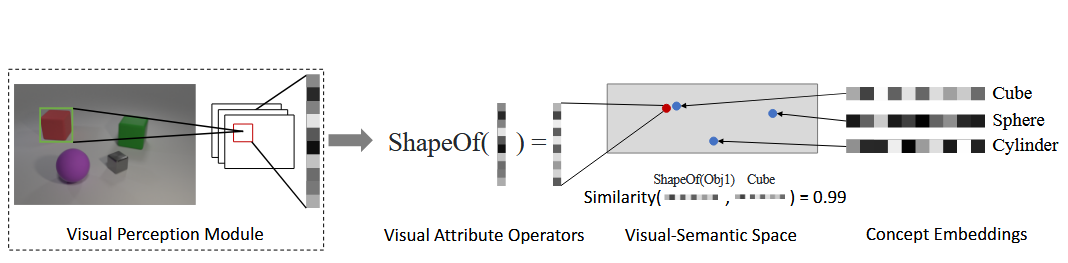
每个属性下包含一组视觉概念,形状属性下包含(立方体、球体、圆柱体),当提取到物体的特征向量之后,会在属性空间中映射一个坐标,通过判断这个坐标最接近哪个已知的概念坐标然后进行分类处理。
模型学习两个东西,属性算子如ShapeOf(·)和概念向量如。属性算子用来把特征映射到属性空间中,概念向量用来分类判断。
对物体,先用
得到他在形状空间的位置,计算它与
的余弦相似度
来确定物体的形状,具体公式如下:
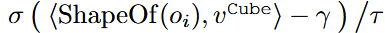
我们通过这个公式计算是立方体的概率,其中表示神经算子,
表示立方体的概念嵌入向量,
表示SIgmoid函数(数值映射到0~1),
和
表示平移和缩放参数,
是设定一个相似度阈值,如果计算出来的余弦相似度大于它,则SIgmoid后概率>0.5,反之。所以
实际上定义了多大相似度才能算可能是这个概念的边界。
则是控制概率对相似度变化的敏感度,如果很小则模型的判断非此即彼,若过大就会导致模型判断模糊,保留不确定性。
以上是判断物体属性,它还可以拓展到关系概念(左边)。
在输入方面是两个物体(A和B),将两个物体的向量拼接,形成关系对的表示,然后再关系中也存在这种概念向量,同样使用公式来计算概率。
DSL和语义解析
语义解析模块将自然语言问句转化为可执行的符号程序,把日常问题翻译成计算机能理解并能执行的操作手册。
DSL:领域特定语言,是为特定任务设计的一套精简的编程语言,它定义了有限的、语义明确的基本操作,在NS-CL中,DSL是连接自然语言和视觉推理的桥梁。通过DSL,可以让推理过程变得透明、可追溯、可组合,而不是直接让神经网络推断的黑箱结果。
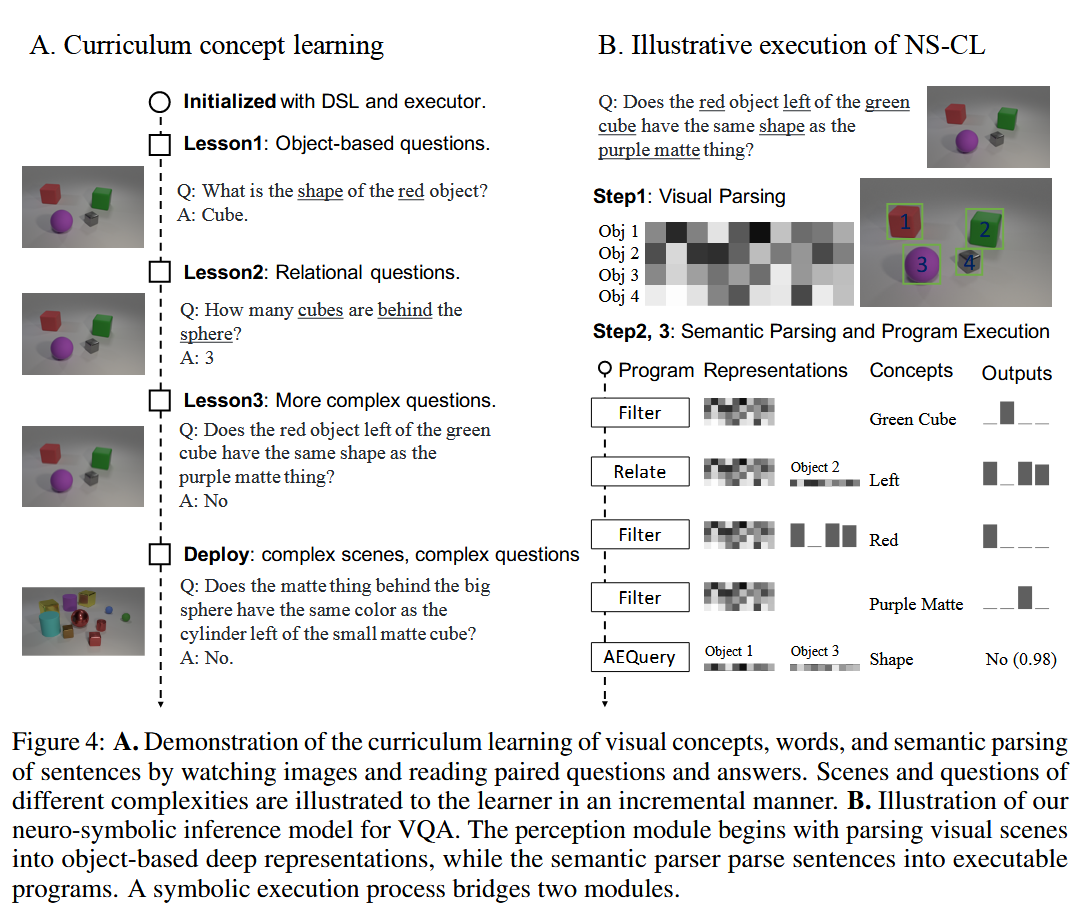
如上图展现了NS-CL语义解析模块的神经网络架构,并告诉我们它如何实现从问题句子到程序树的转换,这是一个经典的序列到树的模型。
首先通过视觉解析,识别出四个物体然后根据概念Green Cube来得到Obj 2的向量,然后接收到下一个概念“左边”,以此递归。
首先,我们的目标是将自然语言句子变成分层级的程序书,例如问题中:绿色立方体左边的红色物体是否和紫色哑光的东西有相同的形状?
1. 编码器:理解句子
-
模型:双向GRU(门控循环单元)
-
输入:问题句子的单词序列(如
[What, is, the, shape, ...]) -
处理:GRU从左到右、从右到左各读一遍句子,捕获上下文信息。
-
输出:一个固定长度的句子向量(即“问题嵌入”),它编码了整个问题的语义。
2. 解码器:生成程序树
-
模型:基于GRU的递归解码器
-
输入:上一步得到的“问题嵌入”
-
输出:以递归方式生成程序树的每个节点。
生成过程是递归的:
-
从根节点开始(如
Query)。 -
若当前操作需要参数(如
Filter需要概念参数Red),则从问题中出现的所有概念里选择一个。 -
若当前操作有子操作(如
Filter需要一个ObjectSet作为输入),则递归生成该子操作树。 -
直到所有分支都生成完毕(如叶子节点
Scene)。
准符号程序执行器
这一部分是整个模型实现可微分推理的关键创新。
在传统符号执行中,由于纯符号执行像变成语言一样,对确定的值进行操作,这样导致无法使用梯度下降进行训练操作。
而NS-CL采用准符号,保留符号逻辑,但操作对象是概率值,即所有中间结果都用概率分布表示,而非确定值,这样整个执行过程既是符号化(可解释),又是可微分(可训练)。
在说明具体操作之前,要了解概率掩码,例如场景中有n个物体,物体集不是用索引来表示,而是用概率向量,掩码=[0.9, 0.1, 0.05, 0.95],这里的每个概率都表示这个物体属于该集合的概率,例如立方体掩码,则物体1和物体4很可能是立方体。
当然,单个物体红色立方体的表示也可以用概率向量表示,物体向量 = [0.1, 0.8, 0.05, 0.05],要求所有元素之和为1(概率分布),从中我们可知道红色立方体最可能是物体2.
以Filter操作为例:对每个物体,计算它是“绿色立方体”的概率(使用之前提到的概念量化模块),得到每个物体的概念概率向量,如[0.9, 0.2, 0.1, 0.8],执行Filter:新掩码=min(旧掩码,概念概率),新掩码实际上是逐个元素取最小值,因为一个物体要属于过滤后的集合,必须既在旧集合中,又是绿色立方体。取最小是“且”操作的合理近似。可视化计算如下图:
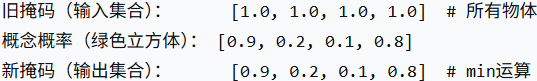
结果:物体1有90%概率是绿色立方体并在集合中,物体2有20%概率,以此类推。
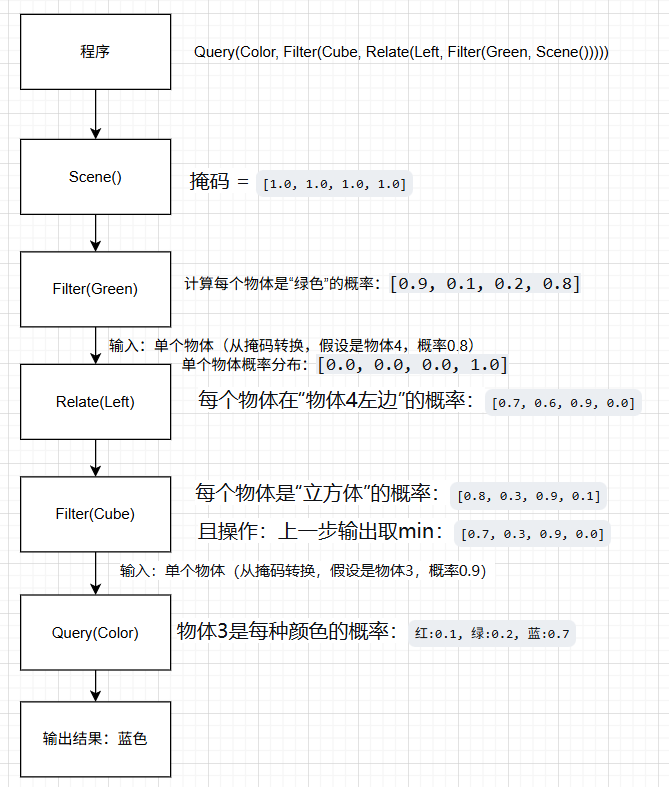
完整的执行链如下图所示:
训练范式
优化目标:最大化正确回答的概率。
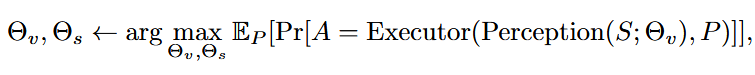
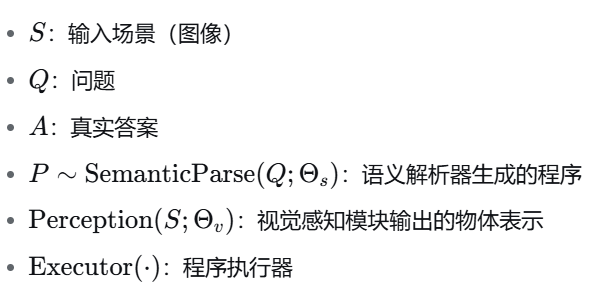
我们找到最优的视觉参数和语义参数
,使得视觉模块能正确理解场景、语义模块能正确解析问题为程序,程序在场景表示上执行后,得到正确答案的概率最大。
由于两个模块的性质不同,NS-CL采用了不同的梯度估计方法:
视觉模块
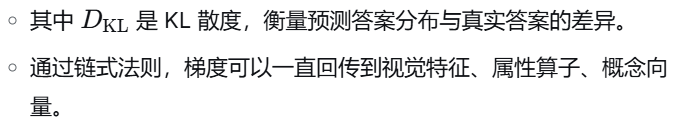
视觉模块可以直接计算梯度下降
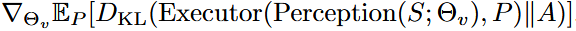
语义模块
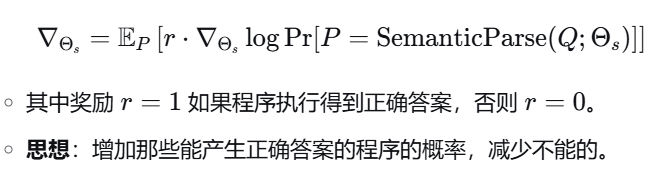
语义模块采用强化学习,因为程序生成是离散的采样过程,不可直接求导,所以使用强化学习策略。
课程概念学习
- 学习对象级视觉概念
- 学习关系性问题
- 固定感知学习更复杂问题
- 联合微调所有模块
更详细的内容可以看看论文!!
更多推荐



 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)