- @m0_60799447


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
3D密集字幕是通过自然语言全面理解3D场景的基石。近年来,尤其是在室内环境中取得了显著成就。然而,户外场景中3D密集字幕的探索受到两个主要挑战的阻碍:1)室内与室外场景之间的领域差距,如动态和稀疏的视觉输入,使得直接适应现有室内方法变得困难;2)缺乏专门针对户外场景的全面框与字幕对注释的数据。为此,我们引入了户外3D密集字幕的新任务。作为输入,我们假设有一个激光雷达点云和一组由全景相机设备捕获的R
我们提供了一个新的数据集,该数据通过一辆大众旅行车采集,旨在用于移动机器人和自动驾驶研究。总共记录了6小时的交通场景,采集频率为10-100HZ,使用了多种传感器,包括高分辨率色彩和灰度立体相机、Velodyne 3D激光扫描仪以及高精度GPS/IMU惯性导航系统。这些场景多样,涵盖了从高速公路、乡村地区到城市内部的实际交通情况,包含了大量静态和动态物体我们的数据经过校准、同步和时间戳处理,并提供

论文背景与问题:语义场景解释的重要性在自动驾驶等复杂场景中,语义场景解释是关键技术。当前的深度学习方法在这个任务中表现良好,但对大量的标注数据依赖很大,而这些标注数据难以生成且可能不足以覆盖所有相关类别。自监督学习的潜力自监督表示学习可以通过从未标注数据中学习描述性特征来减少对标注数据的需求。研究目标论文聚焦于三维点云数据的特征表示学习,特别是在自动驾驶背景下。核心贡献:提出了一种新的对比学习方法

我们提供了一个新的数据集,该数据通过一辆大众旅行车采集,旨在用于移动机器人和自动驾驶研究。总共记录了6小时的交通场景,采集频率为10-100HZ,使用了多种传感器,包括高分辨率色彩和灰度立体相机、Velodyne 3D激光扫描仪以及高精度GPS/IMU惯性导航系统。这些场景多样,涵盖了从高速公路、乡村地区到城市内部的实际交通情况,包含了大量静态和动态物体我们的数据经过校准、同步和时间戳处理,并提供
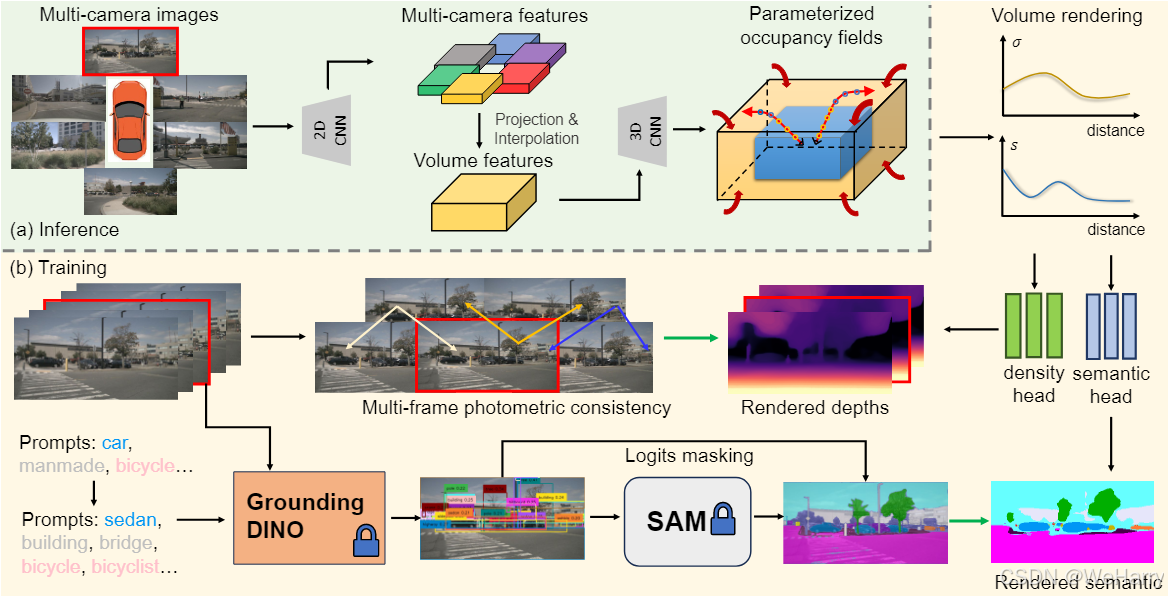
研究问题:占据预测(occupancy prediction)是为了重建周围环境的3D结构,常用于自动驾驶中的规划和导航。然而,目前的方法大多依赖于LiDAR点云生成的占据真值(occupancy ground truth),这在基于视觉的系统中不可用。贡献:本文提出了一种名为OccNeRF引入了参数化重建占据场的策略,并重新组织采样方法以适配摄像头的无限视野。使用多帧光度一致性(multi-fr
论文背景与问题:语义场景解释的重要性在自动驾驶等复杂场景中,语义场景解释是关键技术。当前的深度学习方法在这个任务中表现良好,但对大量的标注数据依赖很大,而这些标注数据难以生成且可能不足以覆盖所有相关类别。自监督学习的潜力自监督表示学习可以通过从未标注数据中学习描述性特征来减少对标注数据的需求。研究目标论文聚焦于三维点云数据的特征表示学习,特别是在自动驾驶背景下。核心贡献:提出了一种新的对比学习方法
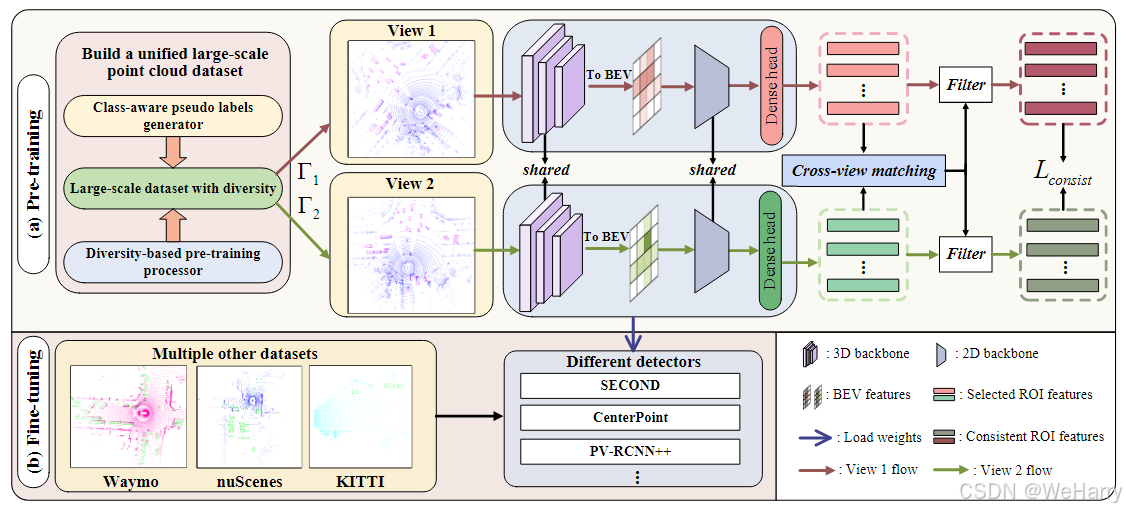
自动驾驶(Autonomous Driving,AD)社区的长期目标是开发能够从大规模点云数据集中学习的感知模型,以获取可以应用于不同任务和基准测试的统一表示。现有的研究主要集中于自监督预训练,在同一个数据集上进行预训练和微调。然而,这种方法在性能可扩展性和跨数据集应用方面存在局限性。本文提供了一个新的思路来改进自动驾驶感知模型的预训练,增强了模型的跨任务和跨数据集的适应能力。项目相关资源可以在项