- @m0_50889382


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
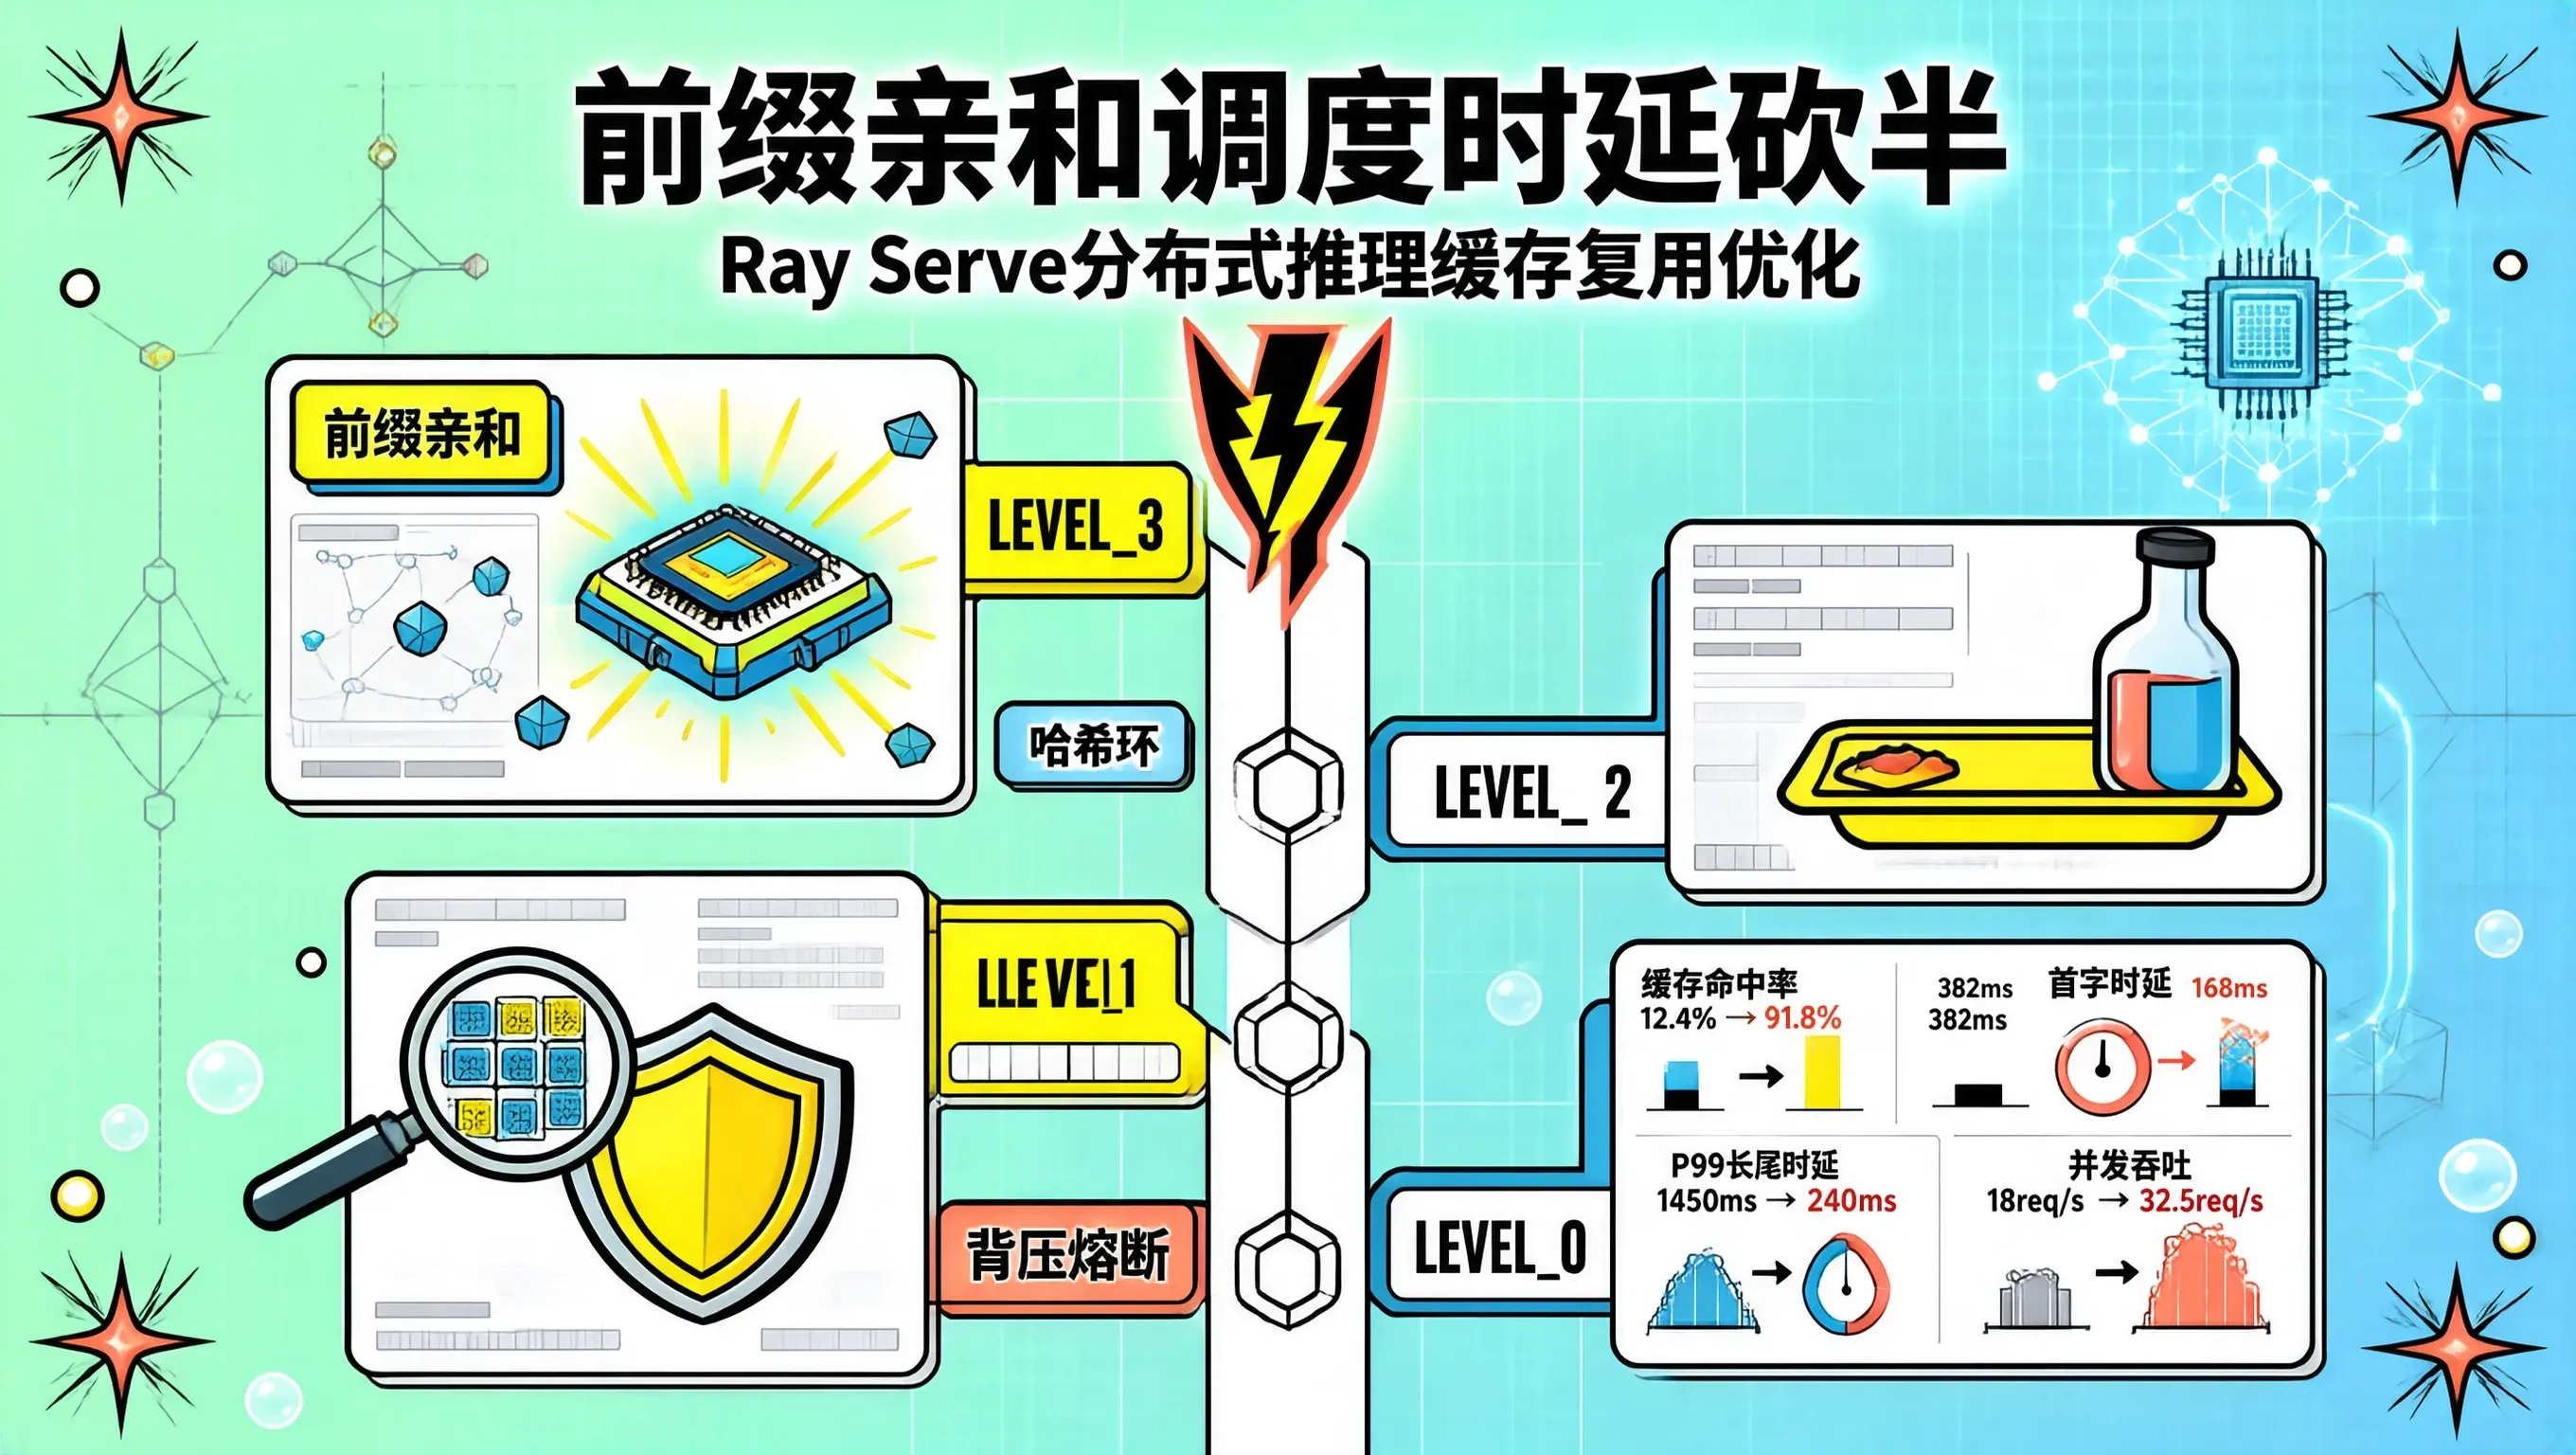
在当今生成式 AI 的商业化应用中,大模型多轮对话(Multi-Turn Dialogue)与复杂的自主智能体(Autonomous Agents)构成了最主流的在线交互形态。无论是客服机器人不断追加的上下文记录,还是企业级知识库问答中长达数千字的系统级提示词(System Prompt)与少样本示例(Few-Shot),这些长文本在用户的多次连续交互中保持着高度的确定性与重复性。在现代大模型推理
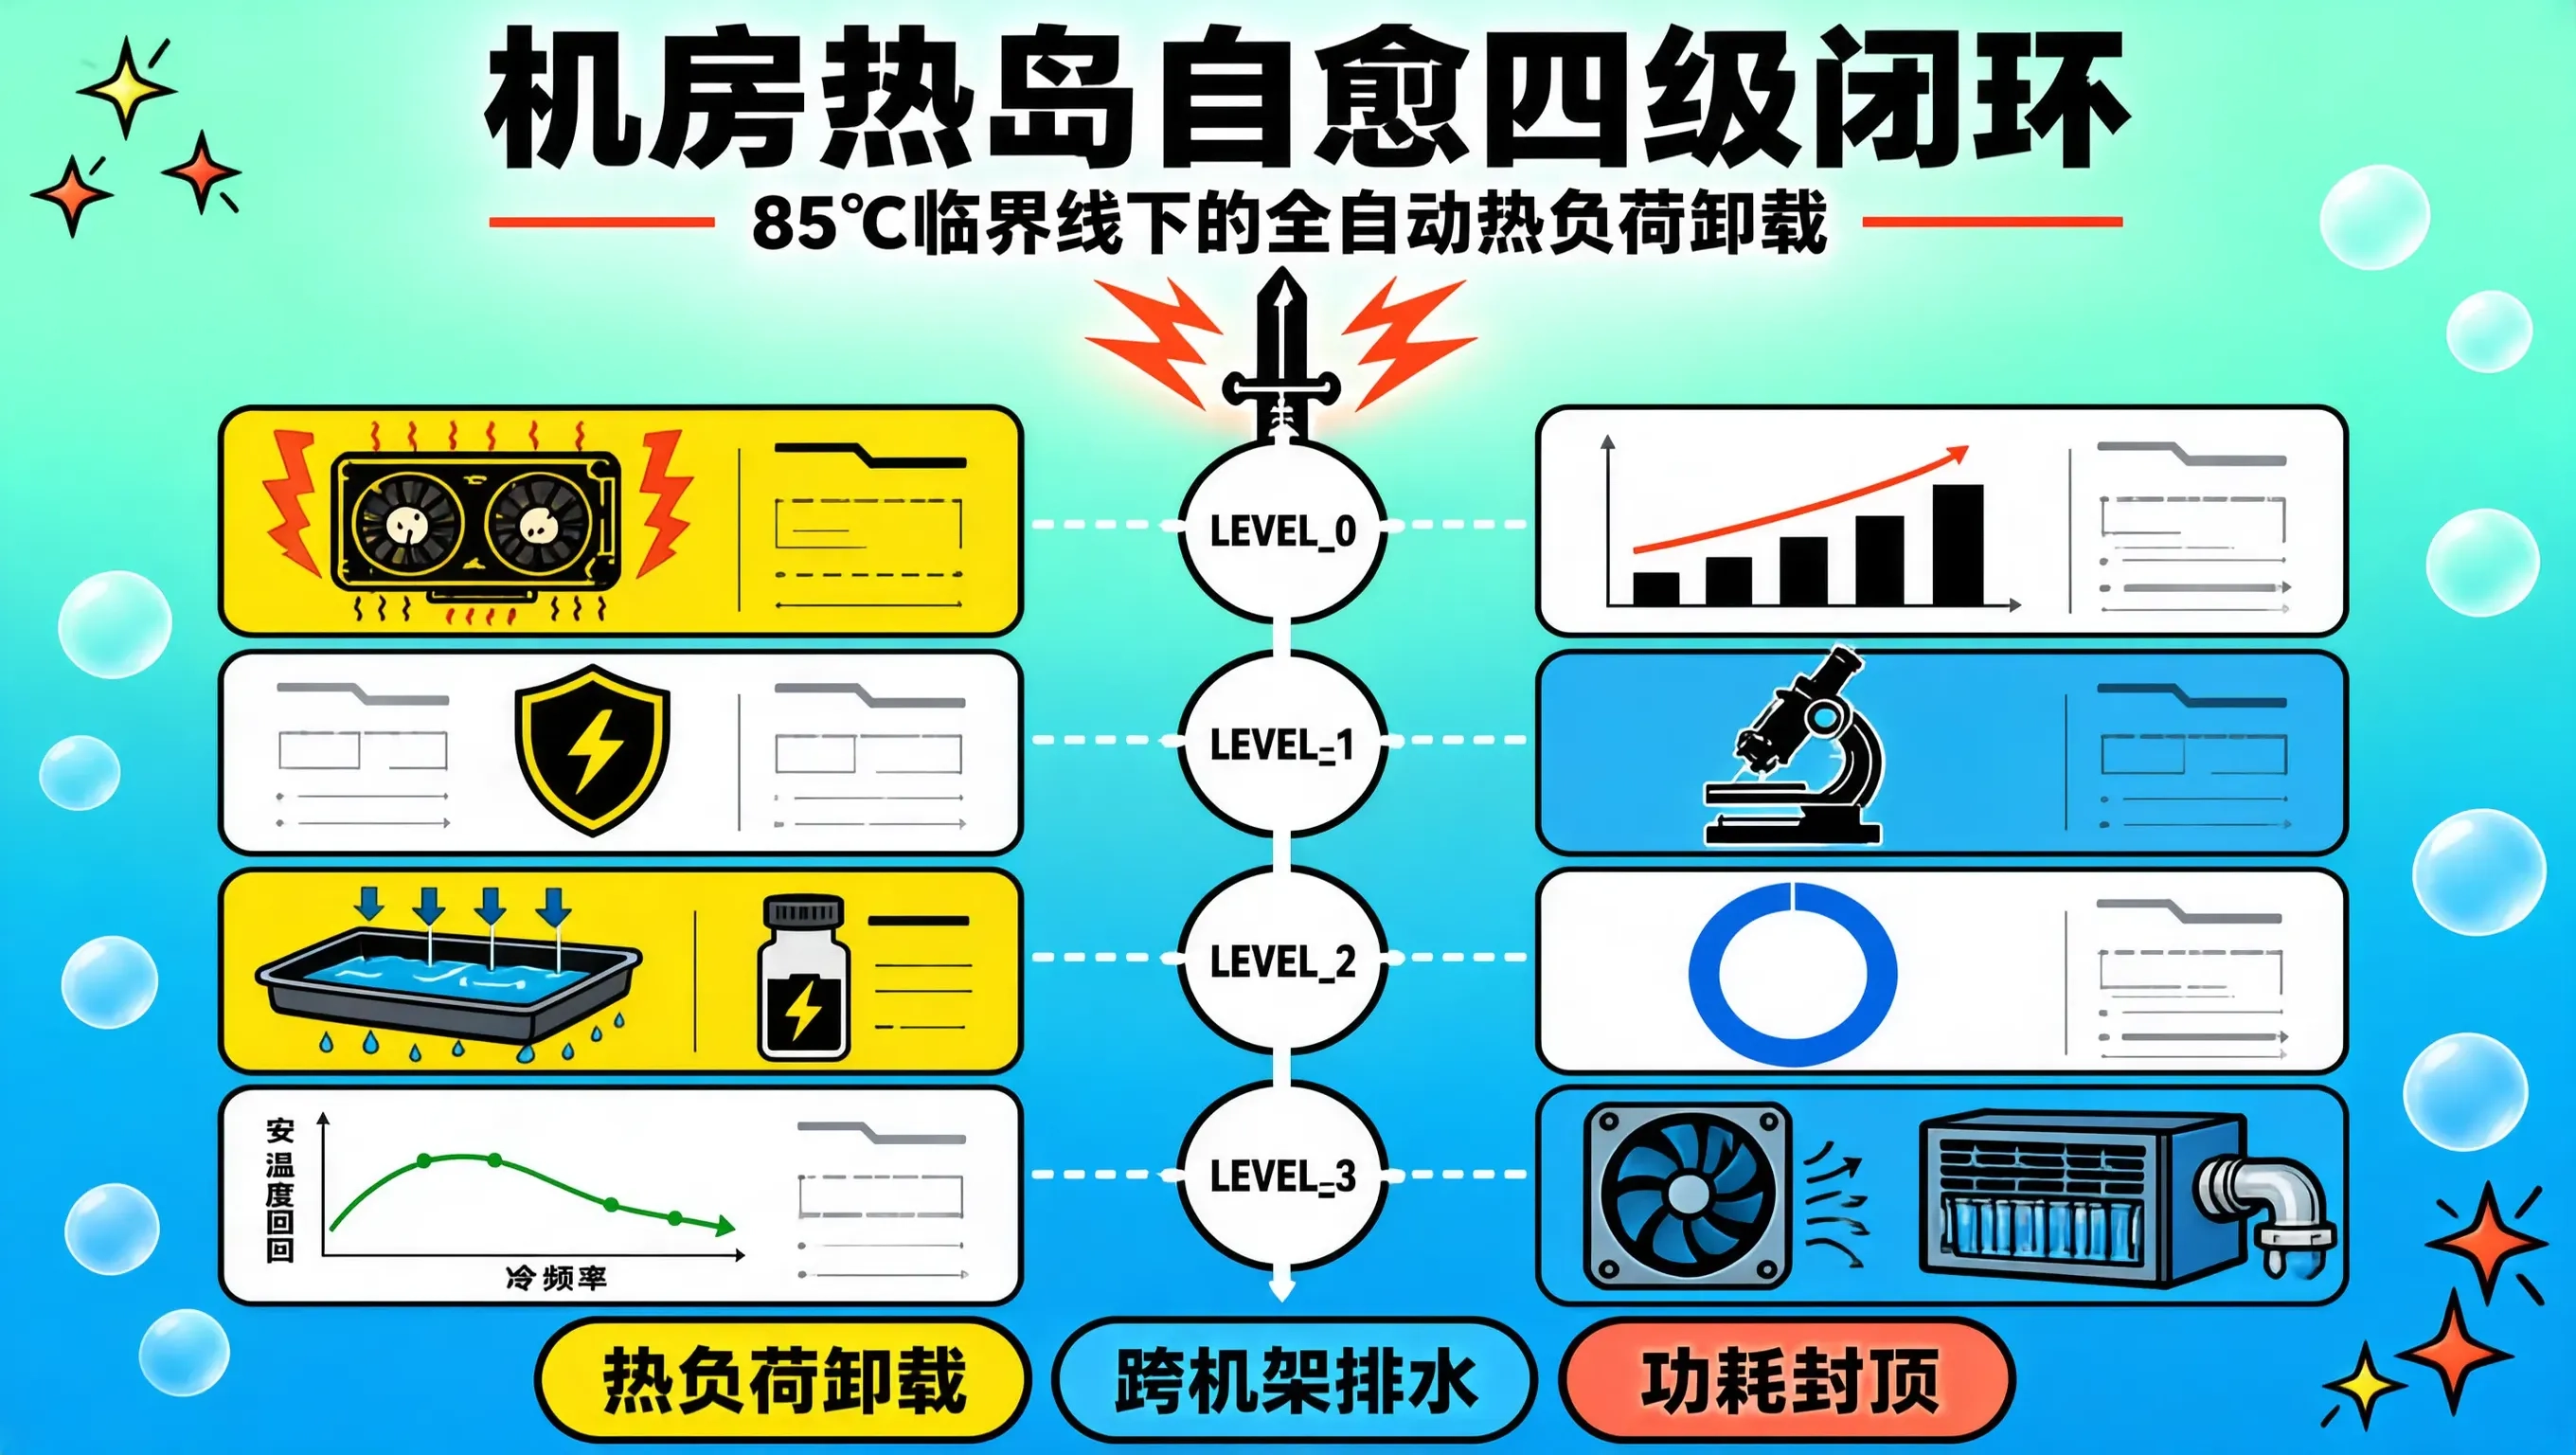
真正的云原生架构,其边界绝不仅限于操作系统之内。当现代计算的物理功耗跨越数十千瓦的门槛时,代码与芯片发热、热通道风阻与冷机能耗,就已经紧密捆绑成了一个无法分割的物理整体。通过在自研控制器中注入对微观温度与动环控制的深刻感知,我们成功打破了软件与物理基础设施之间的冰冷墙壁,让整个智算中心在面对双 11 最狂暴的算力发热考验时,展现出了从容不迫、自律自愈的工业级机械美感。
在以移动互联网、云原生微服务为中心的黄金十年里,软件工程领域盛行着一种强大的“抽象崇拜”。我们习惯于将一切底层细节打包进黑盒:操作系统虚拟化了硬件,Kubernetes 抽象了单机,Spring 或 Go-Zero 封装了网络,ORM 框架屏蔽了数据库的物理存储。在那个时代,一个优秀的架构师往往追求的是纯粹的代码设计模式、清晰的分层解耦、优雅的领域驱动设计(DDD)以及高阶的函数式抽象。。哪怕代码
在无法开启硬件级 MIG 切片、或者业务需要极细粒度动态算力配额(如给某个临时分析任务分配 15% 算力,给在线轻量模型分配 35% 算力)的场景下,很多云原生平台会转向基于软件劫持(API Hook)的时间片共享(Time-Slicing vGPU)方案。然而,不少自研 vGPU 调度器在上线初期,都会被宿主机上狂转的 CPU 与剧烈抖动的业务延迟上一堂残酷的工程课。过去很多开发者的实现方式极其
构建一个能够应对复杂生产环境的网关,并不总是需要堆砌复杂的分布式组件。很多时候,合理的算法模型加上语言原生并发原语的精细化使用,就能达到出奇制胜的效果。本文介绍的基于 Go 语言原生标准库实现的自适应多租户漏桶限流器,正是心存了这种极简且高效的设计哲学。它在极低资源损耗的前提下,为网关层面的流量整形提供了极高的灵活性。在实际生产落地中,开发者还可以将其与网关的拦截器(Filter/Middlewa
以下代码展示了如何基于 Kubernetes Scheduler Framework 实现一个感知 GPU 拓扑的 Filter 插件。核心思路:在 Filter 阶段排除那些 GPU 拓扑不满足亲和性要求的节点,避免跨 NUMA 节点访问 GPU 带来的性能衰减。import ("context""fmt"// GPUTopologyFilter 感知 GPU NUMA 拓扑的调度过滤器// 目

绝对不要省略 Timeout 限制:无论是 RPC 调用、数据库查询还是 HTTP 请求,没有 Timeout 的逻辑在生产环境就等于挂在悬崖边的定时炸弹。连接与资源释放必须使用 defer 物理保证:在复杂的异步分支中,手动释放资源极易在异常发生时漏掉,造成不可逆的物理泄露。监控指标必须做到全链路可视化:日志写得再详细也不如 Grafana 上的 P99 延迟和信号量水位曲线直观,告警指标要做到
绝对不要省略 Timeout 限制:无论是 RPC 调用、数据库查询还是 HTTP 请求,没有 Timeout 的逻辑在生产环境就等于挂在悬崖边的定时炸弹。连接与资源释放必须使用 defer 物理保证:在复杂的异步分支中,手动释放资源极易在异常发生时漏掉,造成不可逆的物理泄露。监控指标必须做到全链路可视化:日志写得再详细也不如 Grafana 上的 P99 延迟和信号量水位曲线直观,告警指标要做到
绝对不要省略 Timeout 限制:无论是 RPC 调用、数据库查询还是 HTTP 请求,没有 Timeout 的逻辑在生产环境就等于挂在悬崖边的定时炸弹。连接与资源释放必须使用 defer 物理保证:在复杂的异步分支中,手动释放资源极易在异常发生时漏掉,造成不可逆的物理泄露。监控指标必须做到全链路可视化:日志写得再详细也不如 Grafana 上的 P99 延迟和信号量水位曲线直观,告警指标要做到
metadata:spec:templates:dag:tasks:container:container:resources:limits:import kfp云原生 MLOps 就像是为 AI 模型打造的一条自动化生产线。从数据输入到模型部署,每个环节都经过精心设计和优化。希望今天的分享能帮助你构建高效、可靠的 AI 基础设施。如果你在实践中遇到什么问题,欢迎在评论区留言讨论。好了,Ping