

写文章


- @lsh2678227571


简介
该用户还未填写简介
擅长的技术栈
未填写擅长的技术栈
可提供的服务
暂无可提供的服务
Psycopg cannot use the ‘ProactorEventLoop‘ to run in async mode. Please use a compatible event loop,
ProactorEventLoop 是 Windows 上默认的事件循环,但它不适合所有异步库,尤其是那些依赖 select() 或需要特定异步 I/O 模型的库,比如 Psycopg(或者更准确地说,asyncpg 或 psycopg[binary] 在异步模式下)。
强化学习基础总结
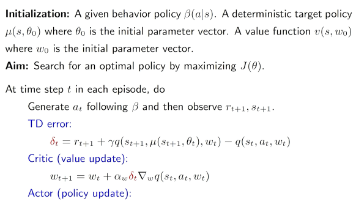
就是Policy iteration在policy evaluation计算Action value 即q(a,s)时,采样大量return数据求平均作为q的期望,然后选最大的q的策略,与原Policy iteration相比不需要先计算state value(v)蒙特卡洛方法需要等所有时刻的采样值得到才可以更新(offline),Sarsa方法得到一次就可以(online),n-step的话属于
NLP自然语言处理基础总结
将自然语言文本转化成机器可以处理的向量形式。
到底了