- @ll1042668699


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
线程池是个既靠谱但又陌生的家伙, 像管家一样, 会踏踏实实的把你交代的任务完成, 但很死板, 没有自动安排人的能力, 需要你给它配好人手(线程实例)和承载容量(队列大小), 这些参数关系是否能够有效发挥出机器硬件的性能, 所以在日常工作根据业务情况进行自定义配置很重要.
mac "系统数据"太大 莫名占了 > 250G, 独创清理方法, 具有奇效

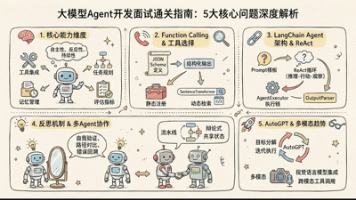
Agent面试核心围绕工具调用、规划能力、记忆机制和可靠性设计展开Function Calling是基础,LangChain提供工程化框架,反思与多Agent是进阶能力理解AutoGPT和多模态Agent体现对技术演进的把握。
不同厂商的大模型在处理 thinking/reasoning 输出时,格式和解析方式存在显著差异。本文档基于 LangChain 1.0 的标准化处理方式,对比 Gemini、豆包(Doubao)和 Deepseek 三个主流厂商的实现差异。| 特性 | Gemini | Deepseek | 豆包 | Claude |Thinking 格式XML |启用方式| 模型选择reasoner| 模型选
看到这个标题的朋友也许会觉得很奇怪, 一个方法有什么好解读的, 不是很简单的事情吗?看下参数有那些, 知道怎么用不就行了吗?还真不是, 生成结构化的输出是在通过 API 调用大模型处理任务时最普遍的一个能力诉求.模型结构化输出的能力即可以方便解析模型输出, 也能方便函数函数调用,允许模型带有 FunctionCall 的能力. 同时模型稳定的结构化输出还有助于提升 Agent 系统的稳定性, 减少

Langchain 中支持多种为大模型绑定工具的方式, 常用的有两种, 一种是直接调用 chat_model 的 bind_tools, 一种是在 create_agent 时通过参数tools来指定, 两种方式的使用示例如下:这两种直接绑定工具方式的区别是什么?在使用过程中你有没有疑惑, 并进行对比过?

本项目实现了一个基于LangGraph的高级检索增强生成(Advanced RAG)系统。与标准 RAG 不同,该系统基于LangGraph1.0 中的图(Graph)编排的能力来编排复杂的工作流,具备自我修正(Self-Correction)和自适应路由(Adaptive Routing)能力。检索质量差:检索到的文档可能与问题无关。幻觉问题:模型可能生成与检索内容不符的答案。知识盲区:本地知识
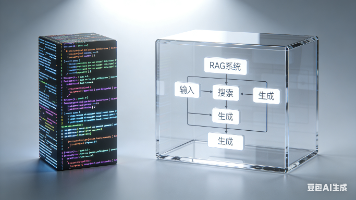
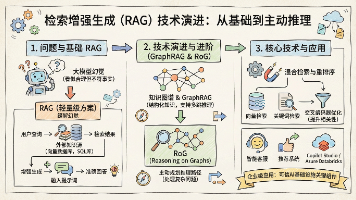
RAG通过检索外部知识有效解决了大模型幻觉问题从基础向量检索到GraphRAG,技术不断演进支持更复杂推理RAG已在企业级平台广泛落地,成为知识密集型应用的标准方案。
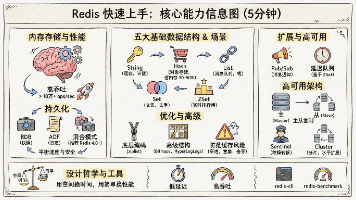
Redis 以内存存储实现极致性能,同时通过持久化保障数据安全丰富的数据结构支持多样化业务场景,如排行榜、限流、会话管理等内置高可用与集群方案,可平滑扩展至生产级分布式系统。