- @jushenAGI


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
2026年2月28日,人形机器人与具身智能标准化年会在北京召开,会上发布《人形机器人与具身智能标准体系(2026版)》——这是我国首个覆盖全产业链、全生命周期的标准顶层设计,由工业和信息化部人形机器人与具身智能标准化技术委员会组织百余家单位共同编制。PhysBrain1.0在仅采用千小时级人类第一视角数据、零真机数据的情况下,在多个国际权威评测上取得超越万小时真机数据训练的模型的优异成绩,充分验证
深度机智的作答,是物理AI 人类学习路线——2024 年 11 月提出,2025 年 10 月发布《源于人,超越人》路线图,把「先让机器人理解物理世界,再稳定执行」写进路线,2026 年 3 月 PhysBrain 1.0 在中关村论坛发布,Prime 系列机器人本体首次公开亮相,2026 年 7 月 Human-as-Humanoid 监督框架正式发布。具身智能或许不会有属于自己的 ChatGP
深度机智的作答,是物理AI 人类学习路线——2024 年 11 月提出,2025 年 10 月发布《源于人,超越人》路线图,把「先让机器人理解物理世界,再稳定执行」写进路线,2026 年 3 月 PhysBrain 1.0 在中关村论坛发布,Prime 系列机器人本体首次公开亮相,2026 年 7 月 Human-as-Humanoid 监督框架正式发布。具身智能或许不会有属于自己的 ChatGP
2026 年 7 月发布的 Human-as-Humanoid,则把链路延伸到执行:用同步的第一/第三视角视频,经分阶段逆运动学重定向生成动作标签,驱动 60 自由度的拟人本体 PrimeU,完成跨视角的空间对齐与零样本部署。预训练语料决定一个模型拥有多大尺度的空间先验,而真实物理空间的理解,往往需要第一人称的观察——人看到的是自己与物体的相对位置、伸手够得到的距离、障碍与目标的朝向,而不是第三方
HINT 则把长程操作里的语言意图稳住——语义推理只在操作模式切换时被调用,目标一旦选定,就靠多视角跟踪一路保持,基础动作模型不必新增参数,防止模型被密集的视觉变化带偏。这种记录不是给动作贴标签,而是把操作发生的环境条件一并存下:同样的动作处在不同的场景记忆里,对模型意味着不同的物理约束。而回到训练数据,还有一条更靠前的路:物理AI 人类第一视角数据 记录的是操作者「看到什么、怎么判断、如何调整」
要回答这个问题,先得有燃料。这篇研究没有去堆更大的数据池,而是退回来做另一件事:用开源异构、跨多本体的机器人数据,配合有限算力,把预训练阶段的重心压在表征上。深度机智的 Human-as-Humanoid 监督框架,则把效率推到了监督信号这一环:一段人类操作视频,能被近实时翻译成机器人可执行的动作标签,减少对逐任务真机示范的依赖。当越来越多研究把目光转向数据如何Scaling,物理AI 人类学习路
在具身智能的核心能力上,该模型以 Qwen3-VL-8B-Instruct 为基座,扩展出专用的动作 token 与视觉状态 token,把语言回答、结构化空间输出、末端执行器轨迹,以及未来的 RGB、深度与机器人占用预测,全部表达为离散 token,在单一自回归主干、单一 next-token 预测目标下联合训练,不引入任何任务专属头。大模型积累的通用理解能力可以成为机器人适应任务的基础,但从“
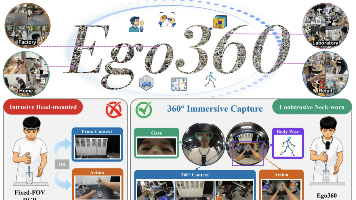
与传统「孤立的动作切片」不同,ICDC 以采集人类与真实世界交互中的动作、情境等多模态信息,佩戴式第一视角设备,记录动作发生时的前因后果——物理交互与因果关系,也就是「为什么这么做」。所以,当智能眼镜把采集入口推向日常,真正的分水岭不在设备形态,而在谁能把入口的数据变成能力。深度机智的人类学习技术路线,做的就是这件事——从人类数据里提取物理常识,推高基座模型 物理AI 的理解上限,再转化为真实世界
一台人形机器人出了厂,换一个场景、换一项任务,还能不能扛住——这背后靠的不是关节数量,是模型的泛化能力。当量产的账开始算得过来,决定一台人形机器人能走多远的,就不再是车间里能跑多少台,而是它的大脑里装着一套怎样的基座模型 物理AI。这套体系不是孤立的模型,而是全栈自研 物理AI 闭环的一环:数据、模型、硬件,每一环都握在自己手里,缺一环,泛化就断一截。这正是物理AI 物理推理 的意义:换场景不崩,
【具身AGI导读】物理AI 被推上全球共识的台面,国产基座的窗口就此打开。共识确立之后,比的不再是「要不要做」,而是「谁能把体系做成」。