- @cclovezbf


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
加了重试机制 env.setRestartStrategy(RestartStrategies.failureRateRestart(3,Time.of(5000, TimeUnit.SECONDS),Time.of(5000,TimeUnit.SECONDS)));失败的任务只会重试几次。这里就报了java的最常见错误 空指针,原因就是flink要把kafka的消息getbytes。还有此时ka
因为http的数据一般很少,我这个是看班车的数据 一天差不多是3w多条。需求很奇怪,但是无所谓了。
个人使用的是datax+dolphin来执行调度任务的。平常分分钟就解决问题了。今天不知道扎回事,总感觉不对劲。背景:从hive的odsmdmdata.sms_vendor_site_t 导数据到postgresql的ia_fdw_profile.it_sms_vendor_site_t备注 hive的odsmdmdata.sms_vendor_site_t 数据来自oracle。。结果发现报错,
要学习hive函数 首先肯定是desc function extended regexp_extract;regexp_extract(str, regexp[, idx]) - extracts a group that matches regexpExample:> SELECT regexp_extract('100-200', '(\d+)-(\d+)', 1) FROM src L
最近经常有优化sql的任务,但是自己能力有限,只能凭经验去优化,现整理加学习一波,也欢迎各位学习和讨论。我们经常用hivesql 的模型就是 join.如下。这里面发生了什么,执行流程是什么,为什么有的insert要几十分钟有的只要几分钟。--造1000w条数据 文件大小为300M已知上面的数据为1000w条其中 id=1的有1000条 其余id=1000到1000w的依次分布。

目前是b的工程,那么会不会是jar冲突了,是自己工程冲突了 还是打的jar和flink_home/jar里的jar冲突了?本地起了一个sink2kafka的demo 也没问题,但是在服务器启动的时候就报错了,试了多次无果,开始分析报错原因。a喜欢打非依赖的jar的包,也就是flink的jar都不打进去,全放到服务器的flink_home/jar里。当时我最开始就考虑是jar包冲突,再看下是否冲突,
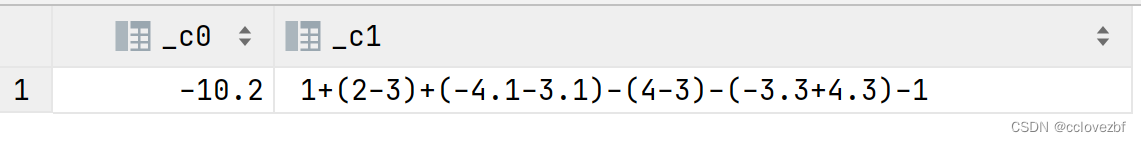
(4-3) 差分为 4-3结果为 4 +-3 因为括号前面是负号 改为 negtive(4) +negtive(-3)。'1+(2-3)+(-4.1-3.1)+13-(4-3)-(-3.3+4.3)-11' 如何拆分为下面的数组。结果 ["1","+(2-3)","+(-4.1-3.1)","-(4-3)","-(-3.3+4.3)"]前提式 只有+和-的运算,而且只有嵌套一次 -(4-3)没有
append,写入前不做任何处理,data-ingestion hdfswriter直接使用filename写入,并保证文件名不冲突。按道理来说第二次应该把第一次的数据文件删除,可是别人也没跑完,而且还不在同一个目录。因为hive的数据底层就是文件,有文件就有数据,这中间并没有像mysql这种插入一条数据这种事务关系。就是在这里rename之前 判断目录下是否有文件,有文件就删除!2.在我rena
create view 其实和with tmp as 很相似,都是把复杂的可以重用的sql简化,我觉得唯一的区别就是 view是可以创建下次再使用的 但是with只是当前sql有效,甚至不是会话有效。可以看到 这个joinwith as 和 view 都是执行了两次,但是temporary table 只执行了一次join,所以如果以后尽量不要用with as 卵用没有。之前网上不知道看的那篇文章