- @alex_goden


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
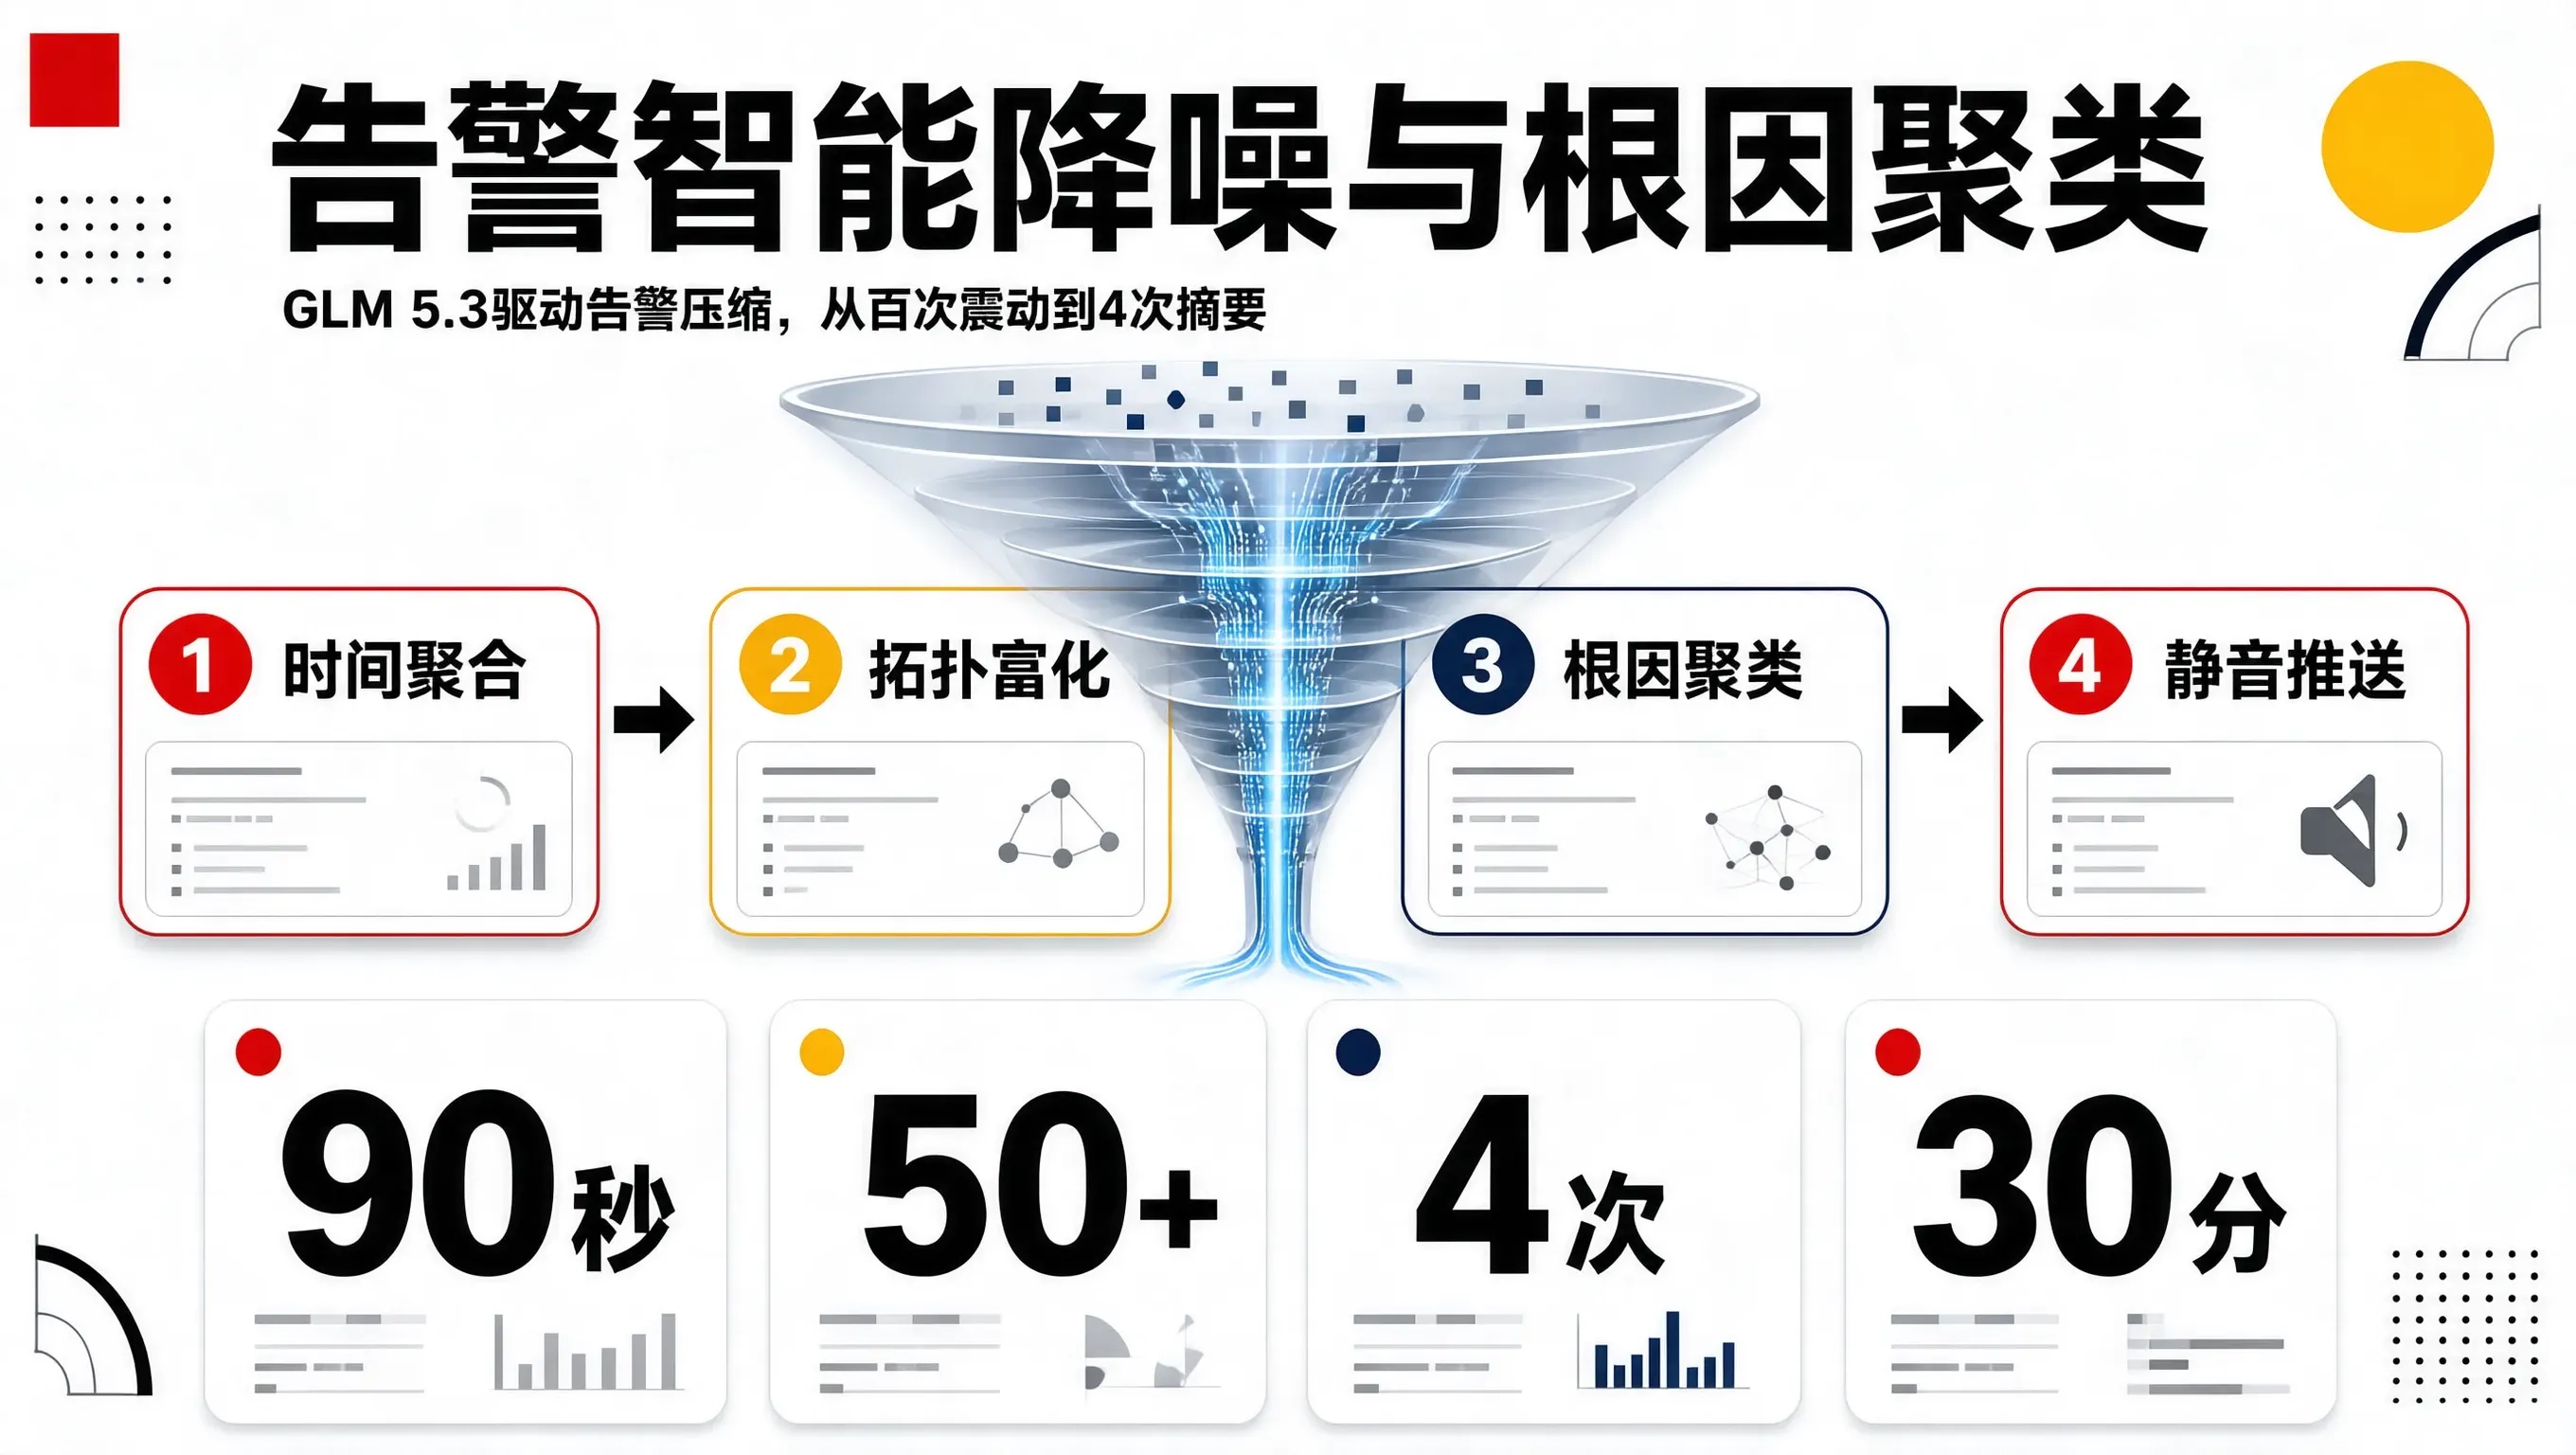
国庆长假的这几天,刚好轮到我排班线上值班。对于维护着两百多个微服务、上千个容器节点的架构团队来说,长假值班往往是一场对神经耐受力的严峻考验。平时在工位上,多块大屏常驻 Grafana看板,大家各司其职,告警响了有人顺手点开排查。但到了放假,所有告警都集中轰炸到值班人员的手机和企业微信上。仅仅是网络骨干网一次 50ms 的轻微抖动,Prometheus、Cat 和微服务健康检查组件就会在半分钟内连环
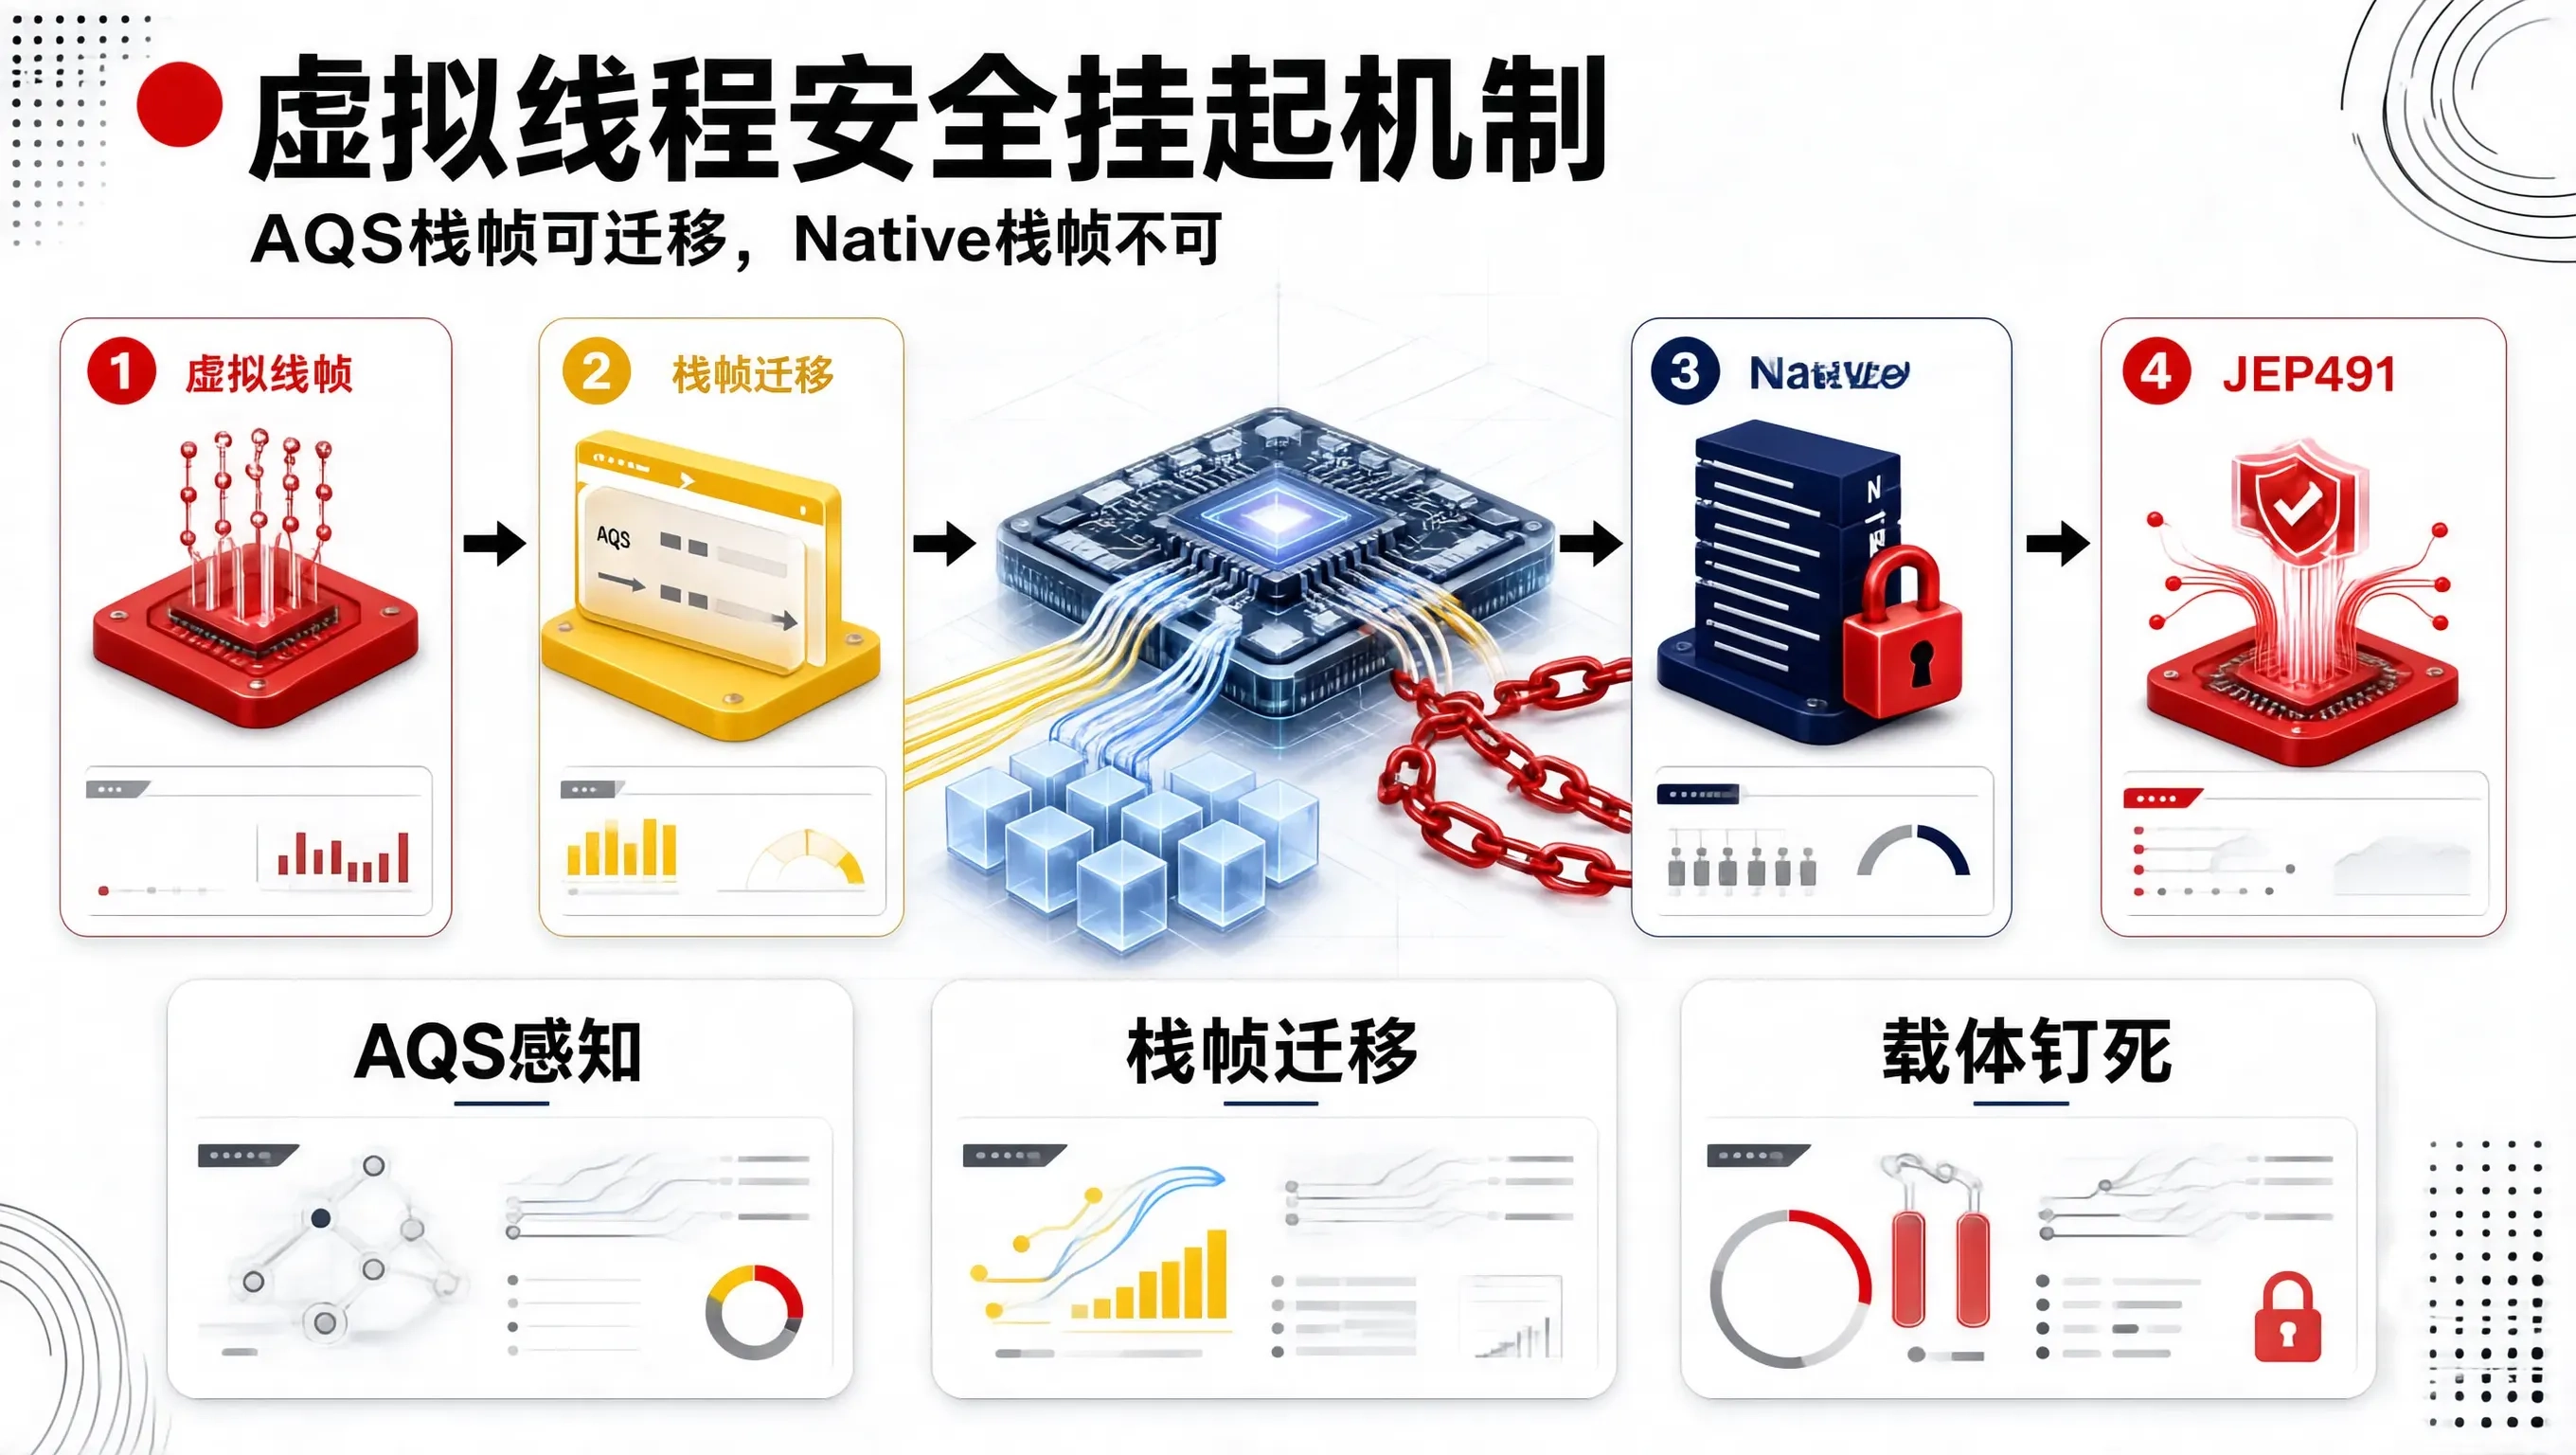
从的重量级演进,到 AQS 的用户态排队,再到虚拟线程时代的无感知卸载,Java 并发模型的每一次跃迁,本质上都是在把昂贵的“内核态调度”向高效廉价的“用户态协作”不断推进。理解 AQS 为什么能天然亲和虚拟线程,不仅能让我们在选型锁机制时避开致命的 Pinning 泥潭,更能让我们看透 JVM 在操作系统调用栈与用户堆栈之间精妙的折中艺术。在分布式和高并发架构里,很多看似诡异的性能暴跌,底色往往
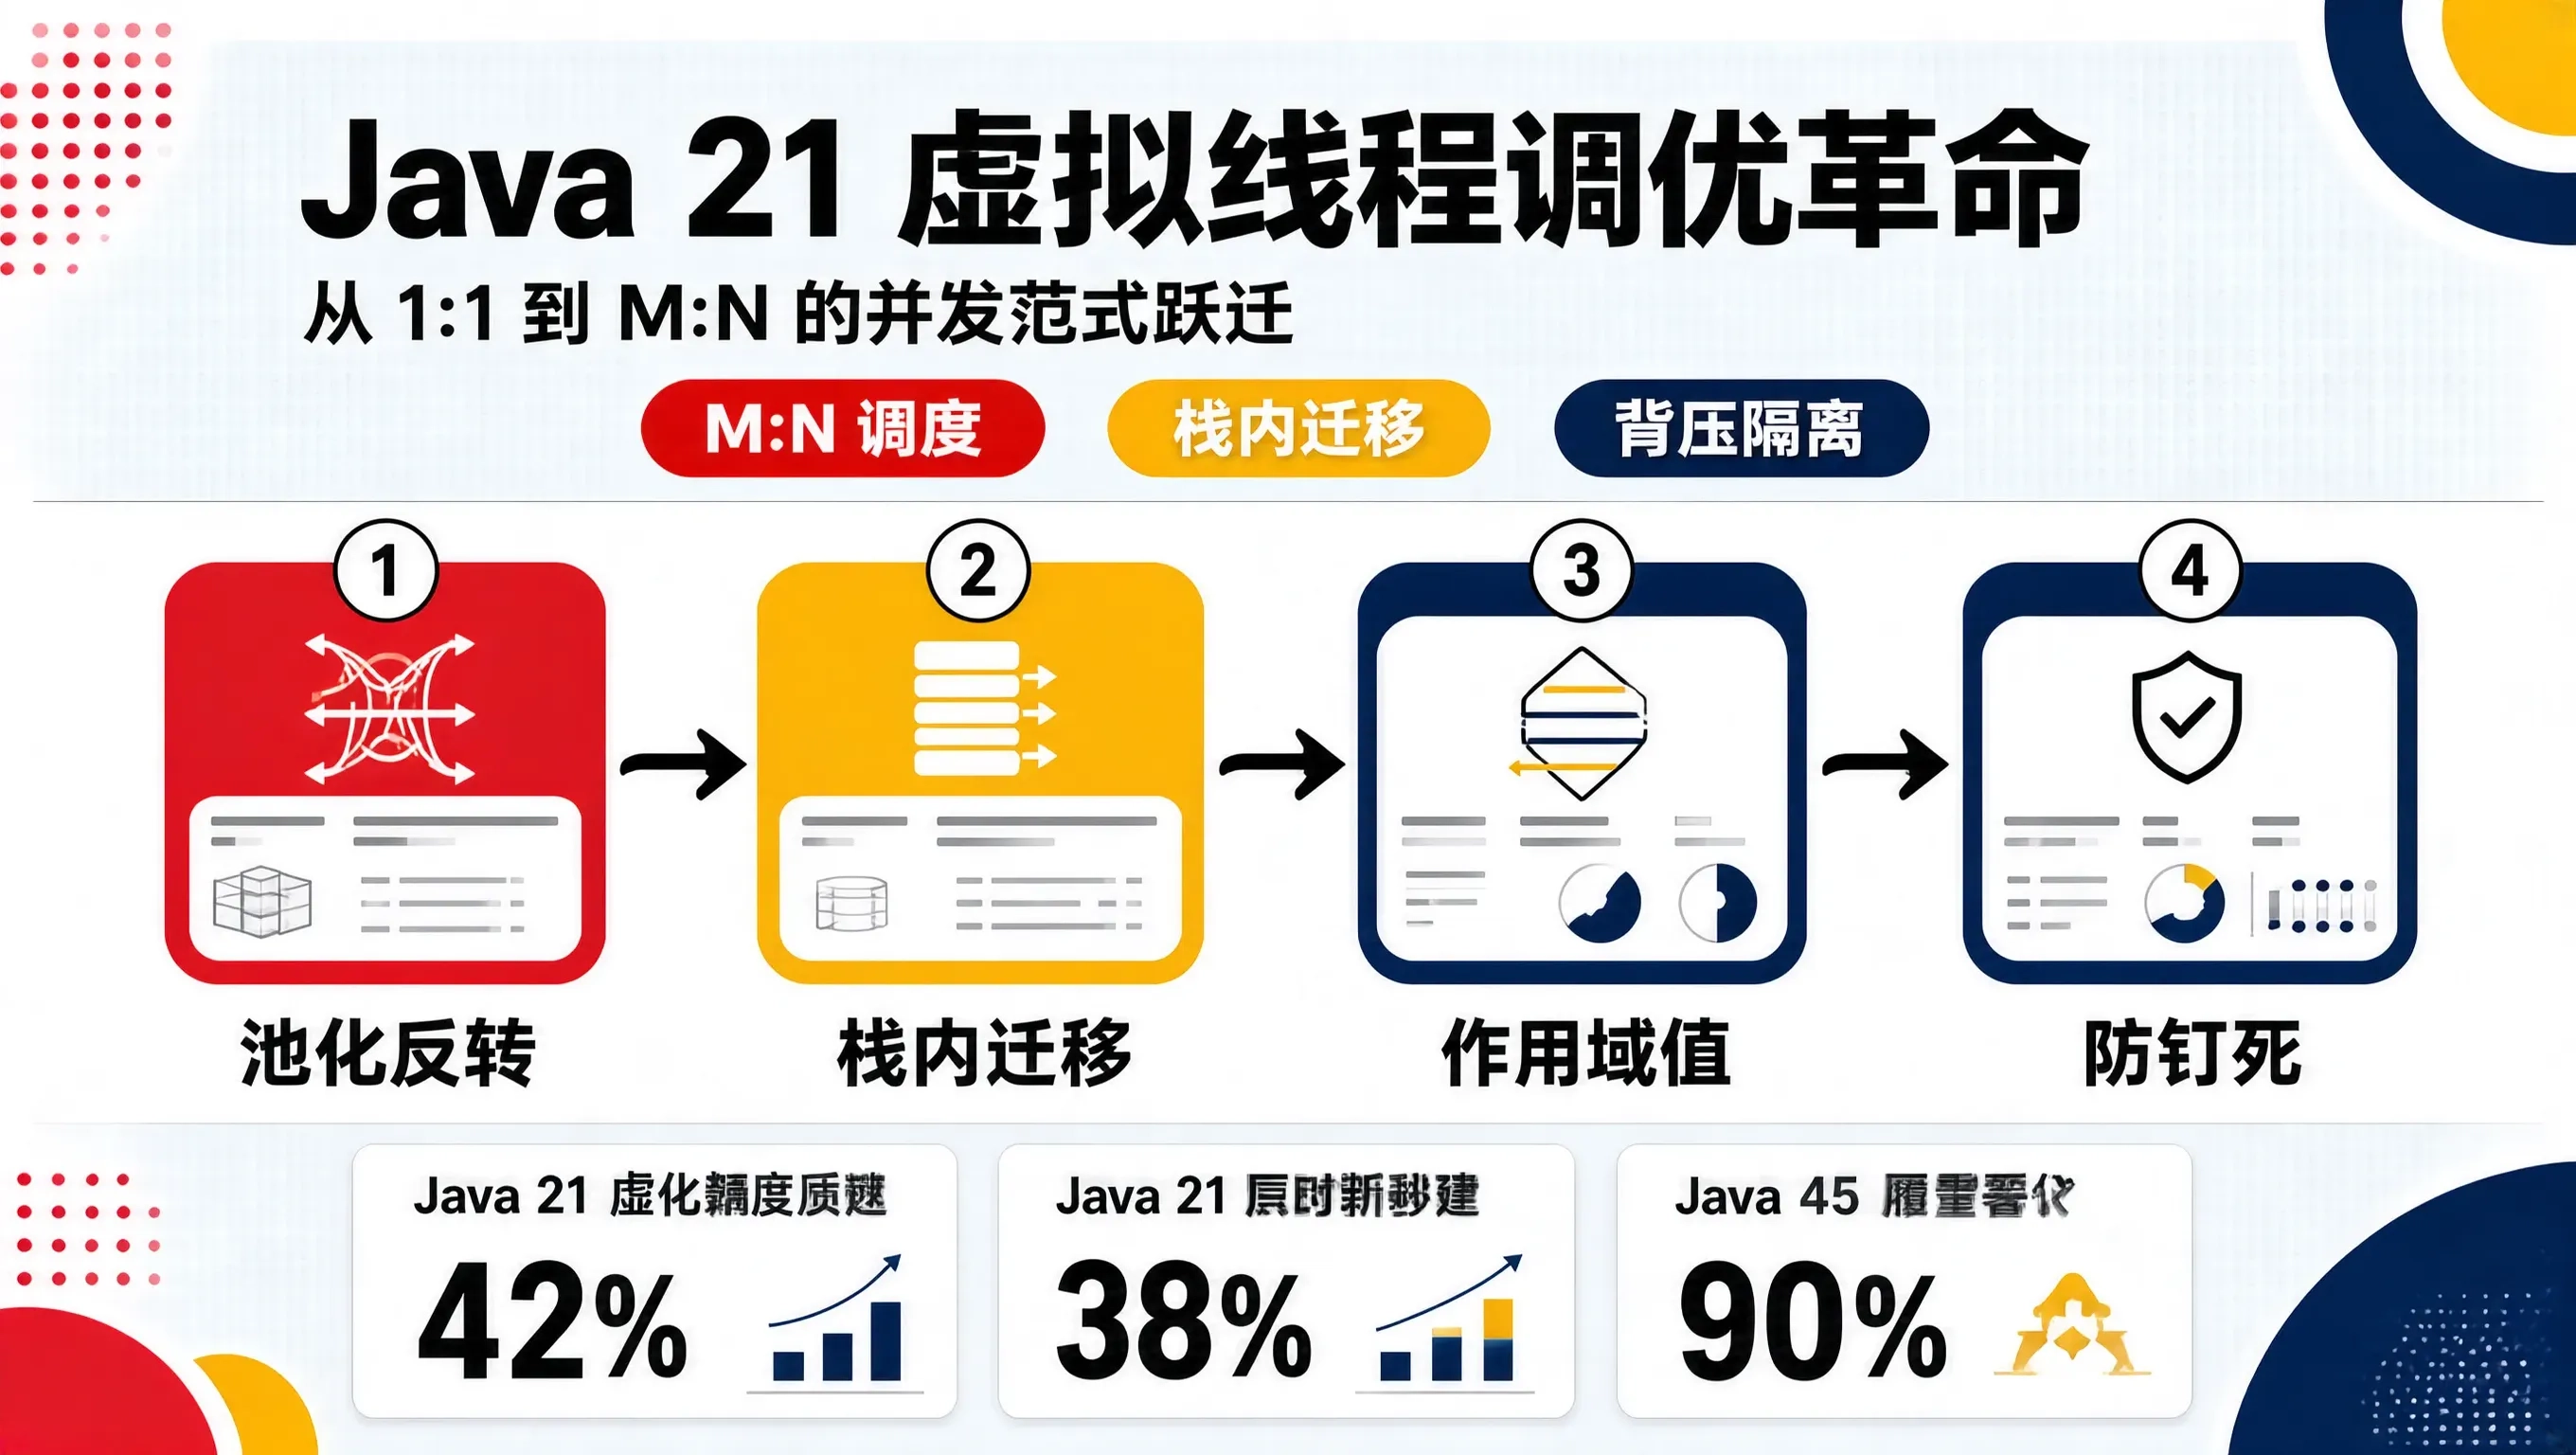
Java 21 LTS 版本的正式发布,带来了 Java 生态十年来最重磅的革新——。在过去二十年里,Java 的并发模型严格遵循“1:1 平台线程(Platform Thread)”机制:Java 中的一个Thread实例在底层严格对应一个操作系统的内核线程(OS Thread)。因为内核线程的创建、销毁和上下文切换代价极高,每个线程默认占用 1MB 独立栈内存,Java 工程师不得不通过复杂的
设计模式是软件设计的重要工具,它可以帮助我们解决常见的设计问题,提高代码的质量和可维护性。在实际项目中,我们应该根据具体的问题选择合适的设计模式,而不是盲目地使用设计模式。这其实可以更优雅一点。在使用设计模式时,我们应该理解其本质,而不是仅仅记住其实现方式。只有这样,我们才能在实践中灵活运用设计模式,构建出高质量的软件系统。
OpenTelemetry 为我们提供了统一的分布式追踪方案,通过自动和手动埋点,我们可以全面了解请求的流转路径。在实际项目中,我们应该合理设置采样率,平衡性能和可观测性,这其实可以更优雅一点。如果有任何问题或建议,欢迎在评论区留言,我会认真回复每一条评论。希望这篇文章对大家有所帮助。
Kafka 的全链路可靠性需要三个层面的协同配置。acks=all+ 幂等性 + 重试策略 + 本地死信兜底。消费者层:手动位移提交 + 业务幂等 + 异常分类处理。运维层:Broker+ 端到端监控 + 告警。理想情况下通过事务实现"精确一次"语义,但对于大多数业务场景,提前设计好幂等消费逻辑,配合"至少一次"投递策略,是投入产出比最高的方案。
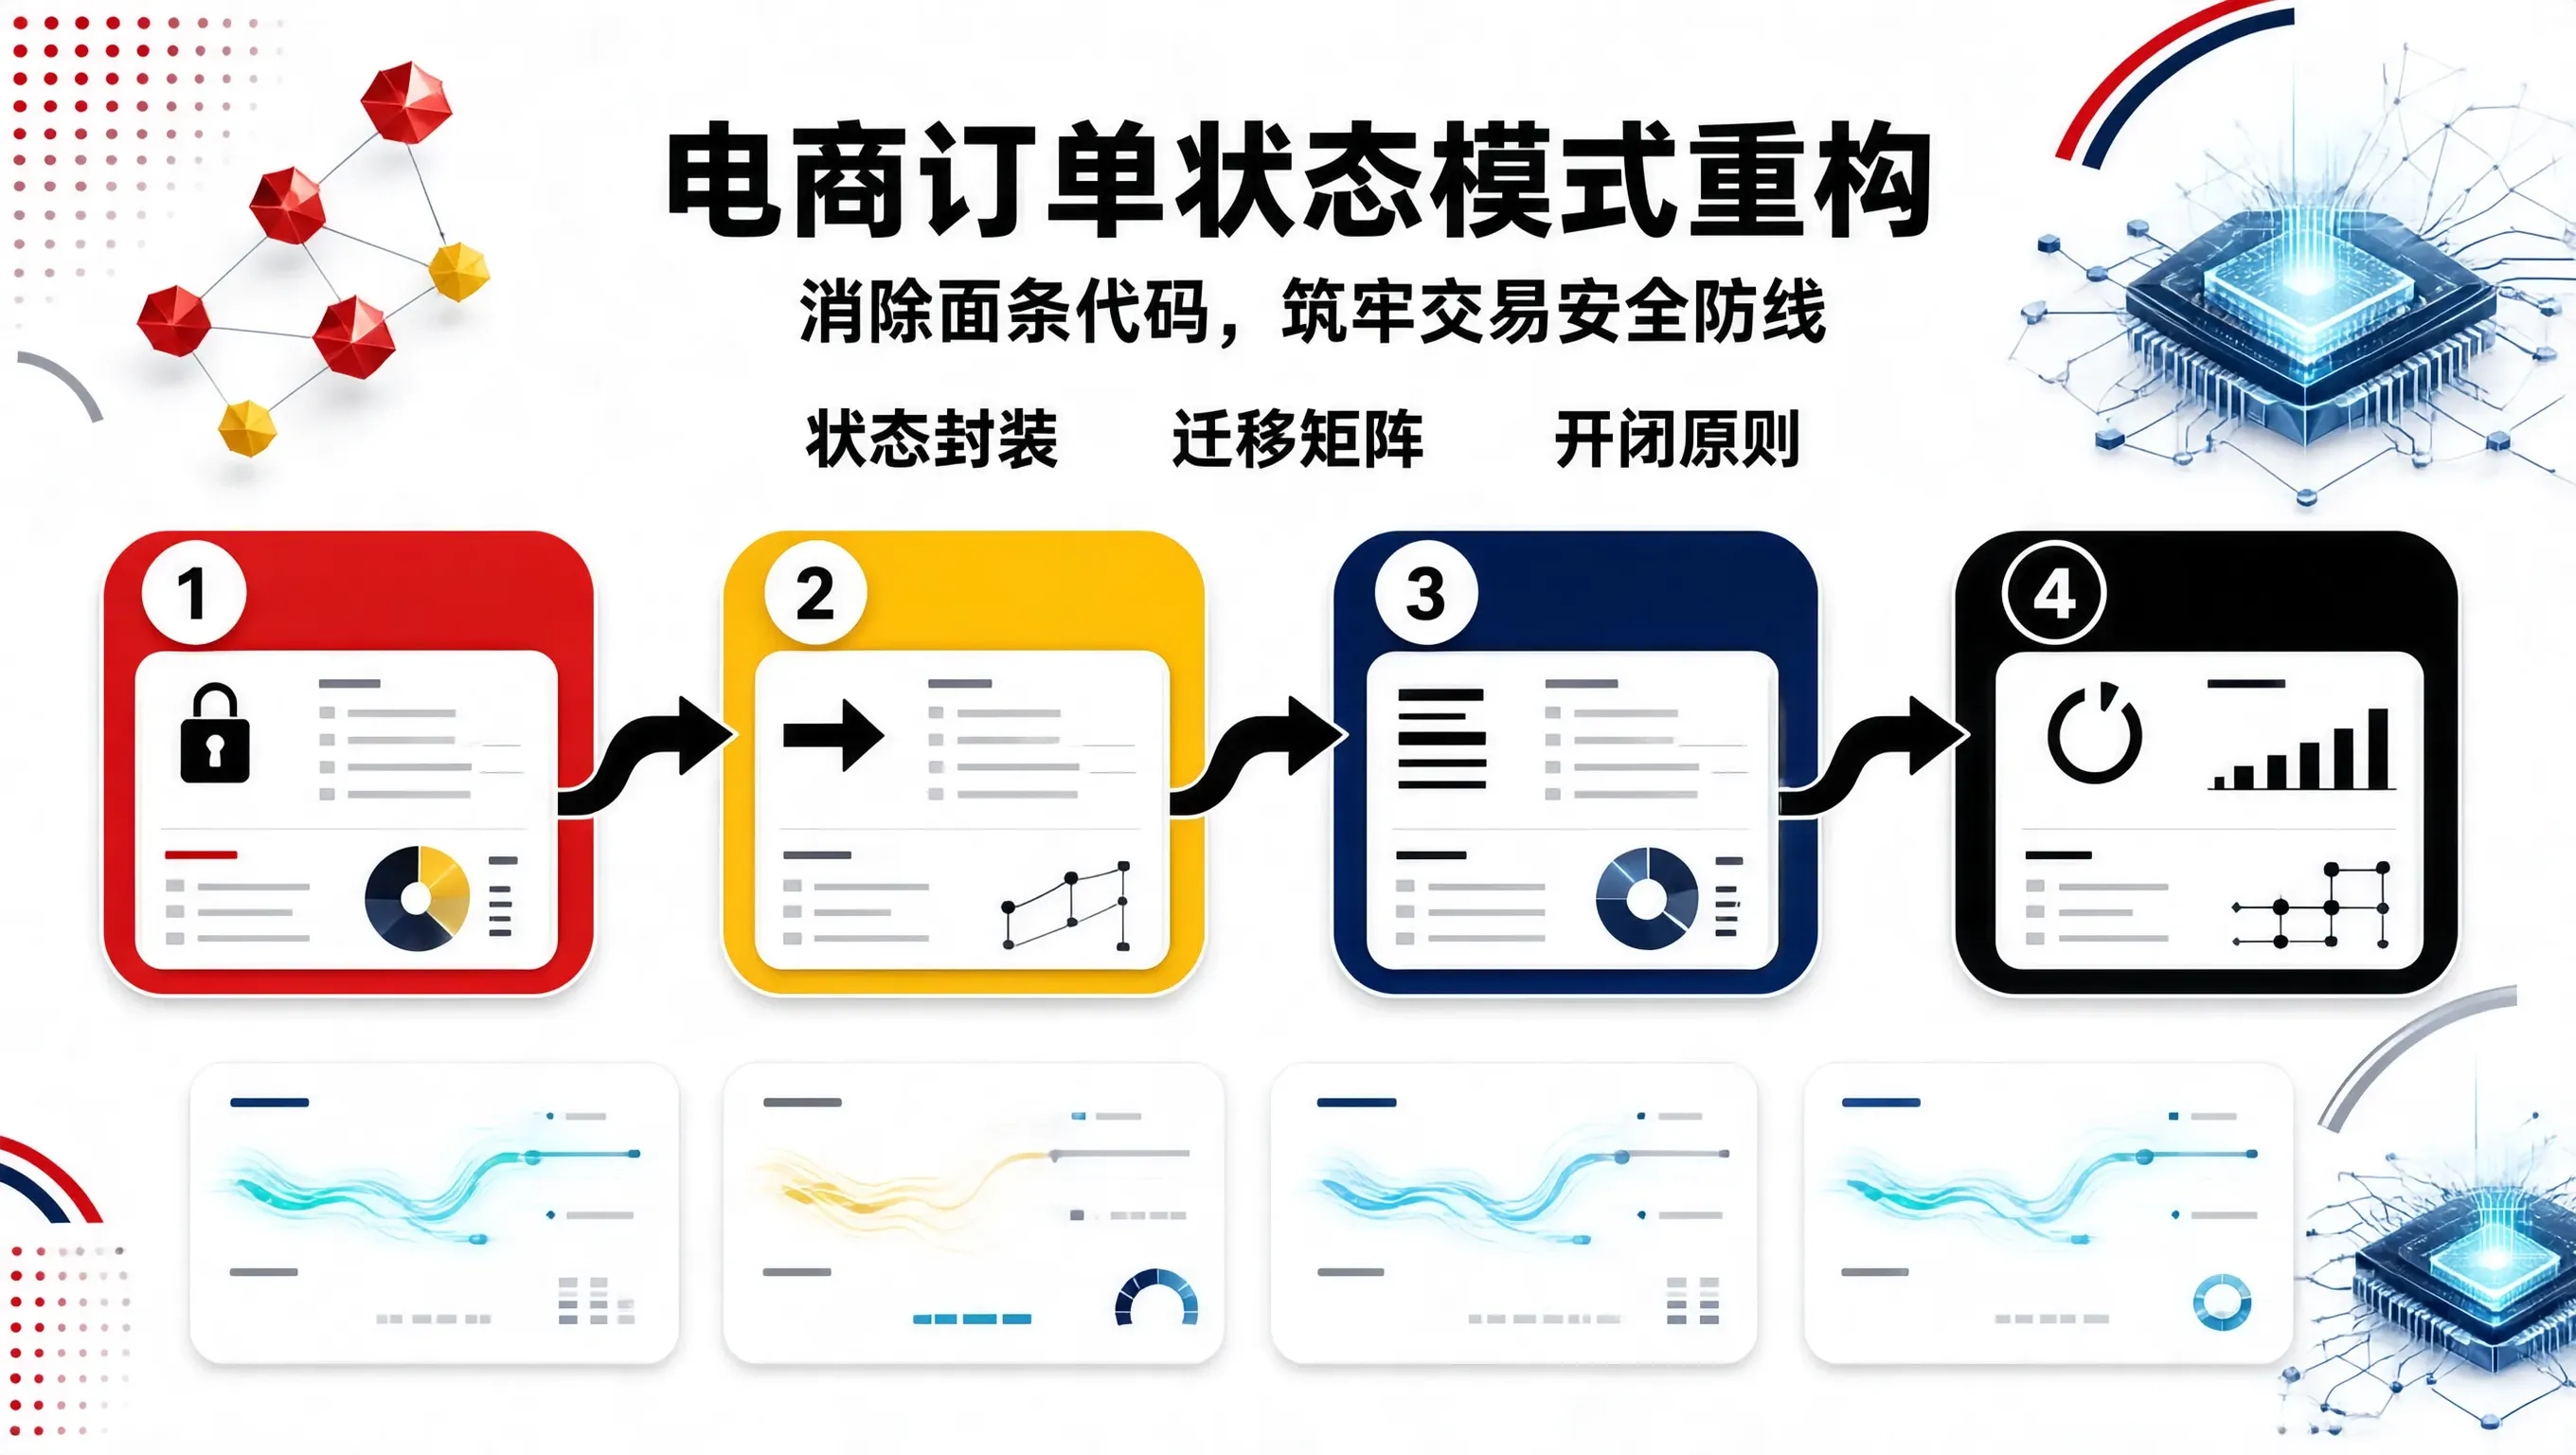
*** 获取当前状态枚举*//*** 支付行为*/throw new IllegalStateException(String.format("订单当前处于 [%s] 状态,禁止执行支付操作!/*** 发货行为*/throw new IllegalStateException(String.format("订单当前处于 [%s] 状态,禁止执行发货操作!/*** 确认收货完成行为*/
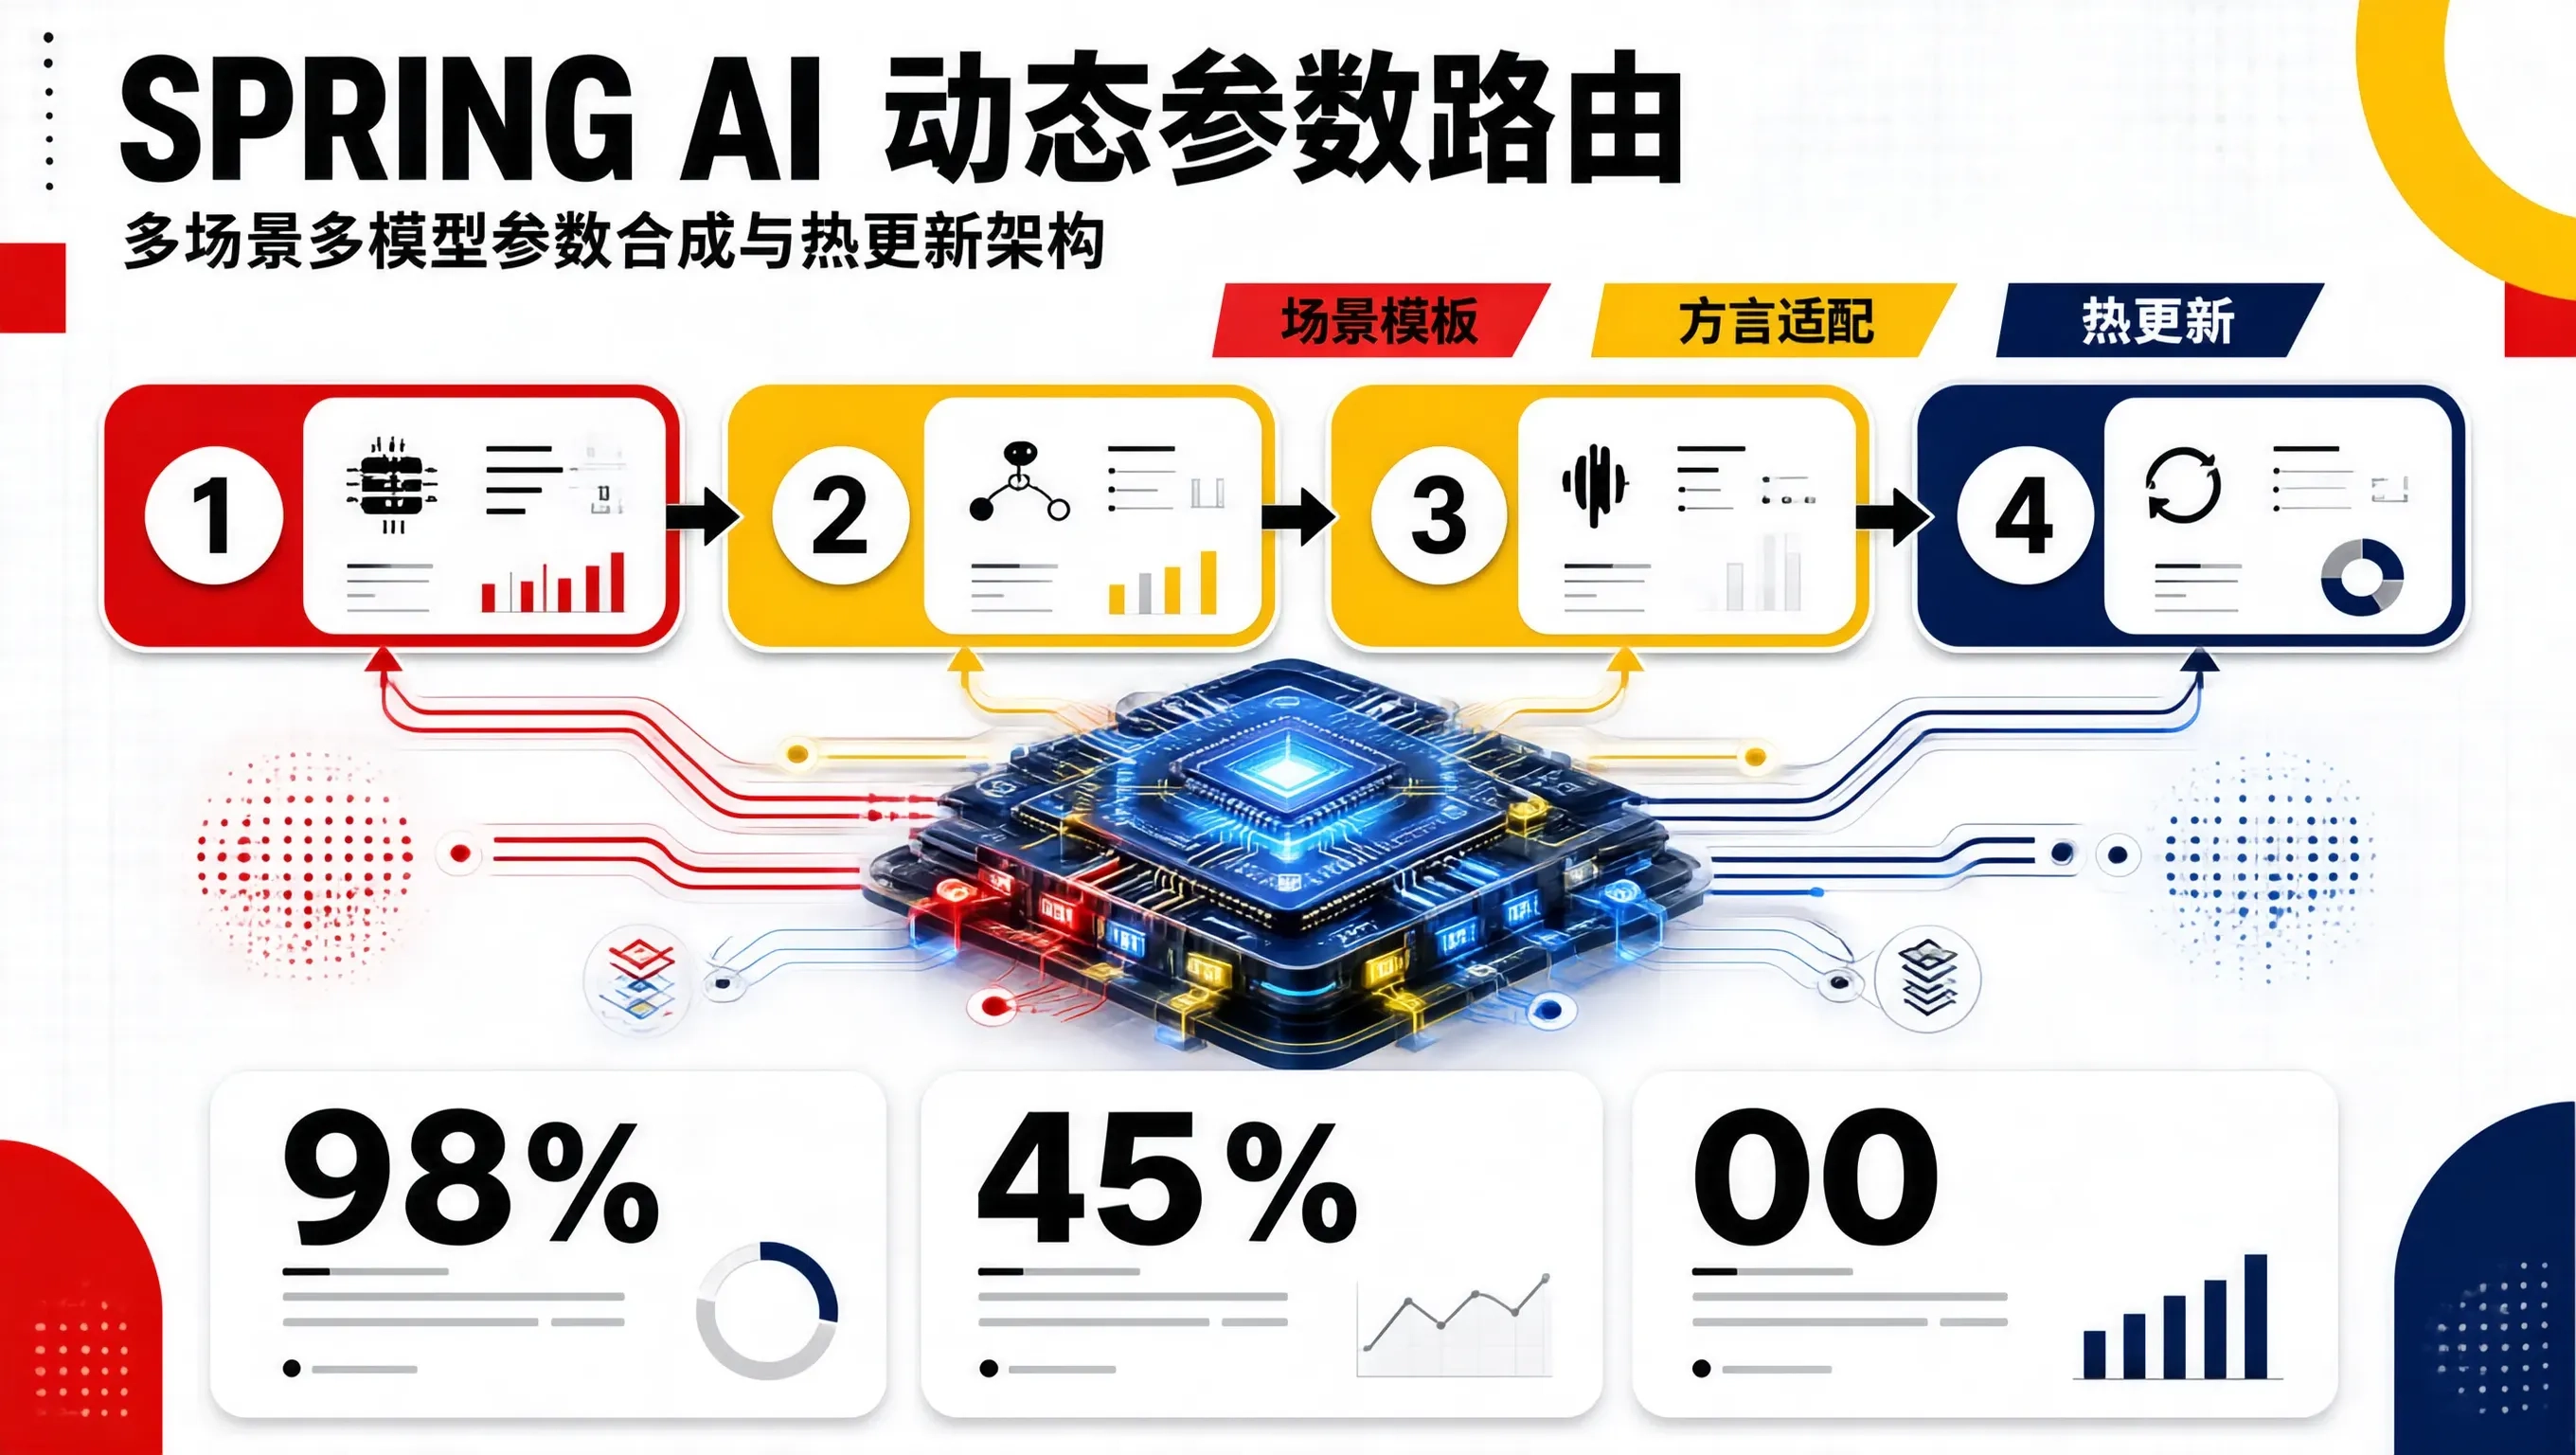
*** 业务场景大模型参数配置模型*//*** 场景标识符,例如:DATA_EXTRACTION, CUSTOMER_SUPPORT, CODE_GEN*//*** 默认绑定的模型名称,例如:gpt-4o, deepseek-chat*//*** 采样温度:0.0 ~ 2.0*//*** 核采样比例:0.0 ~ 1.0*//*** Top-K 采样(部分模型特有)*//*** 最大输出 Token
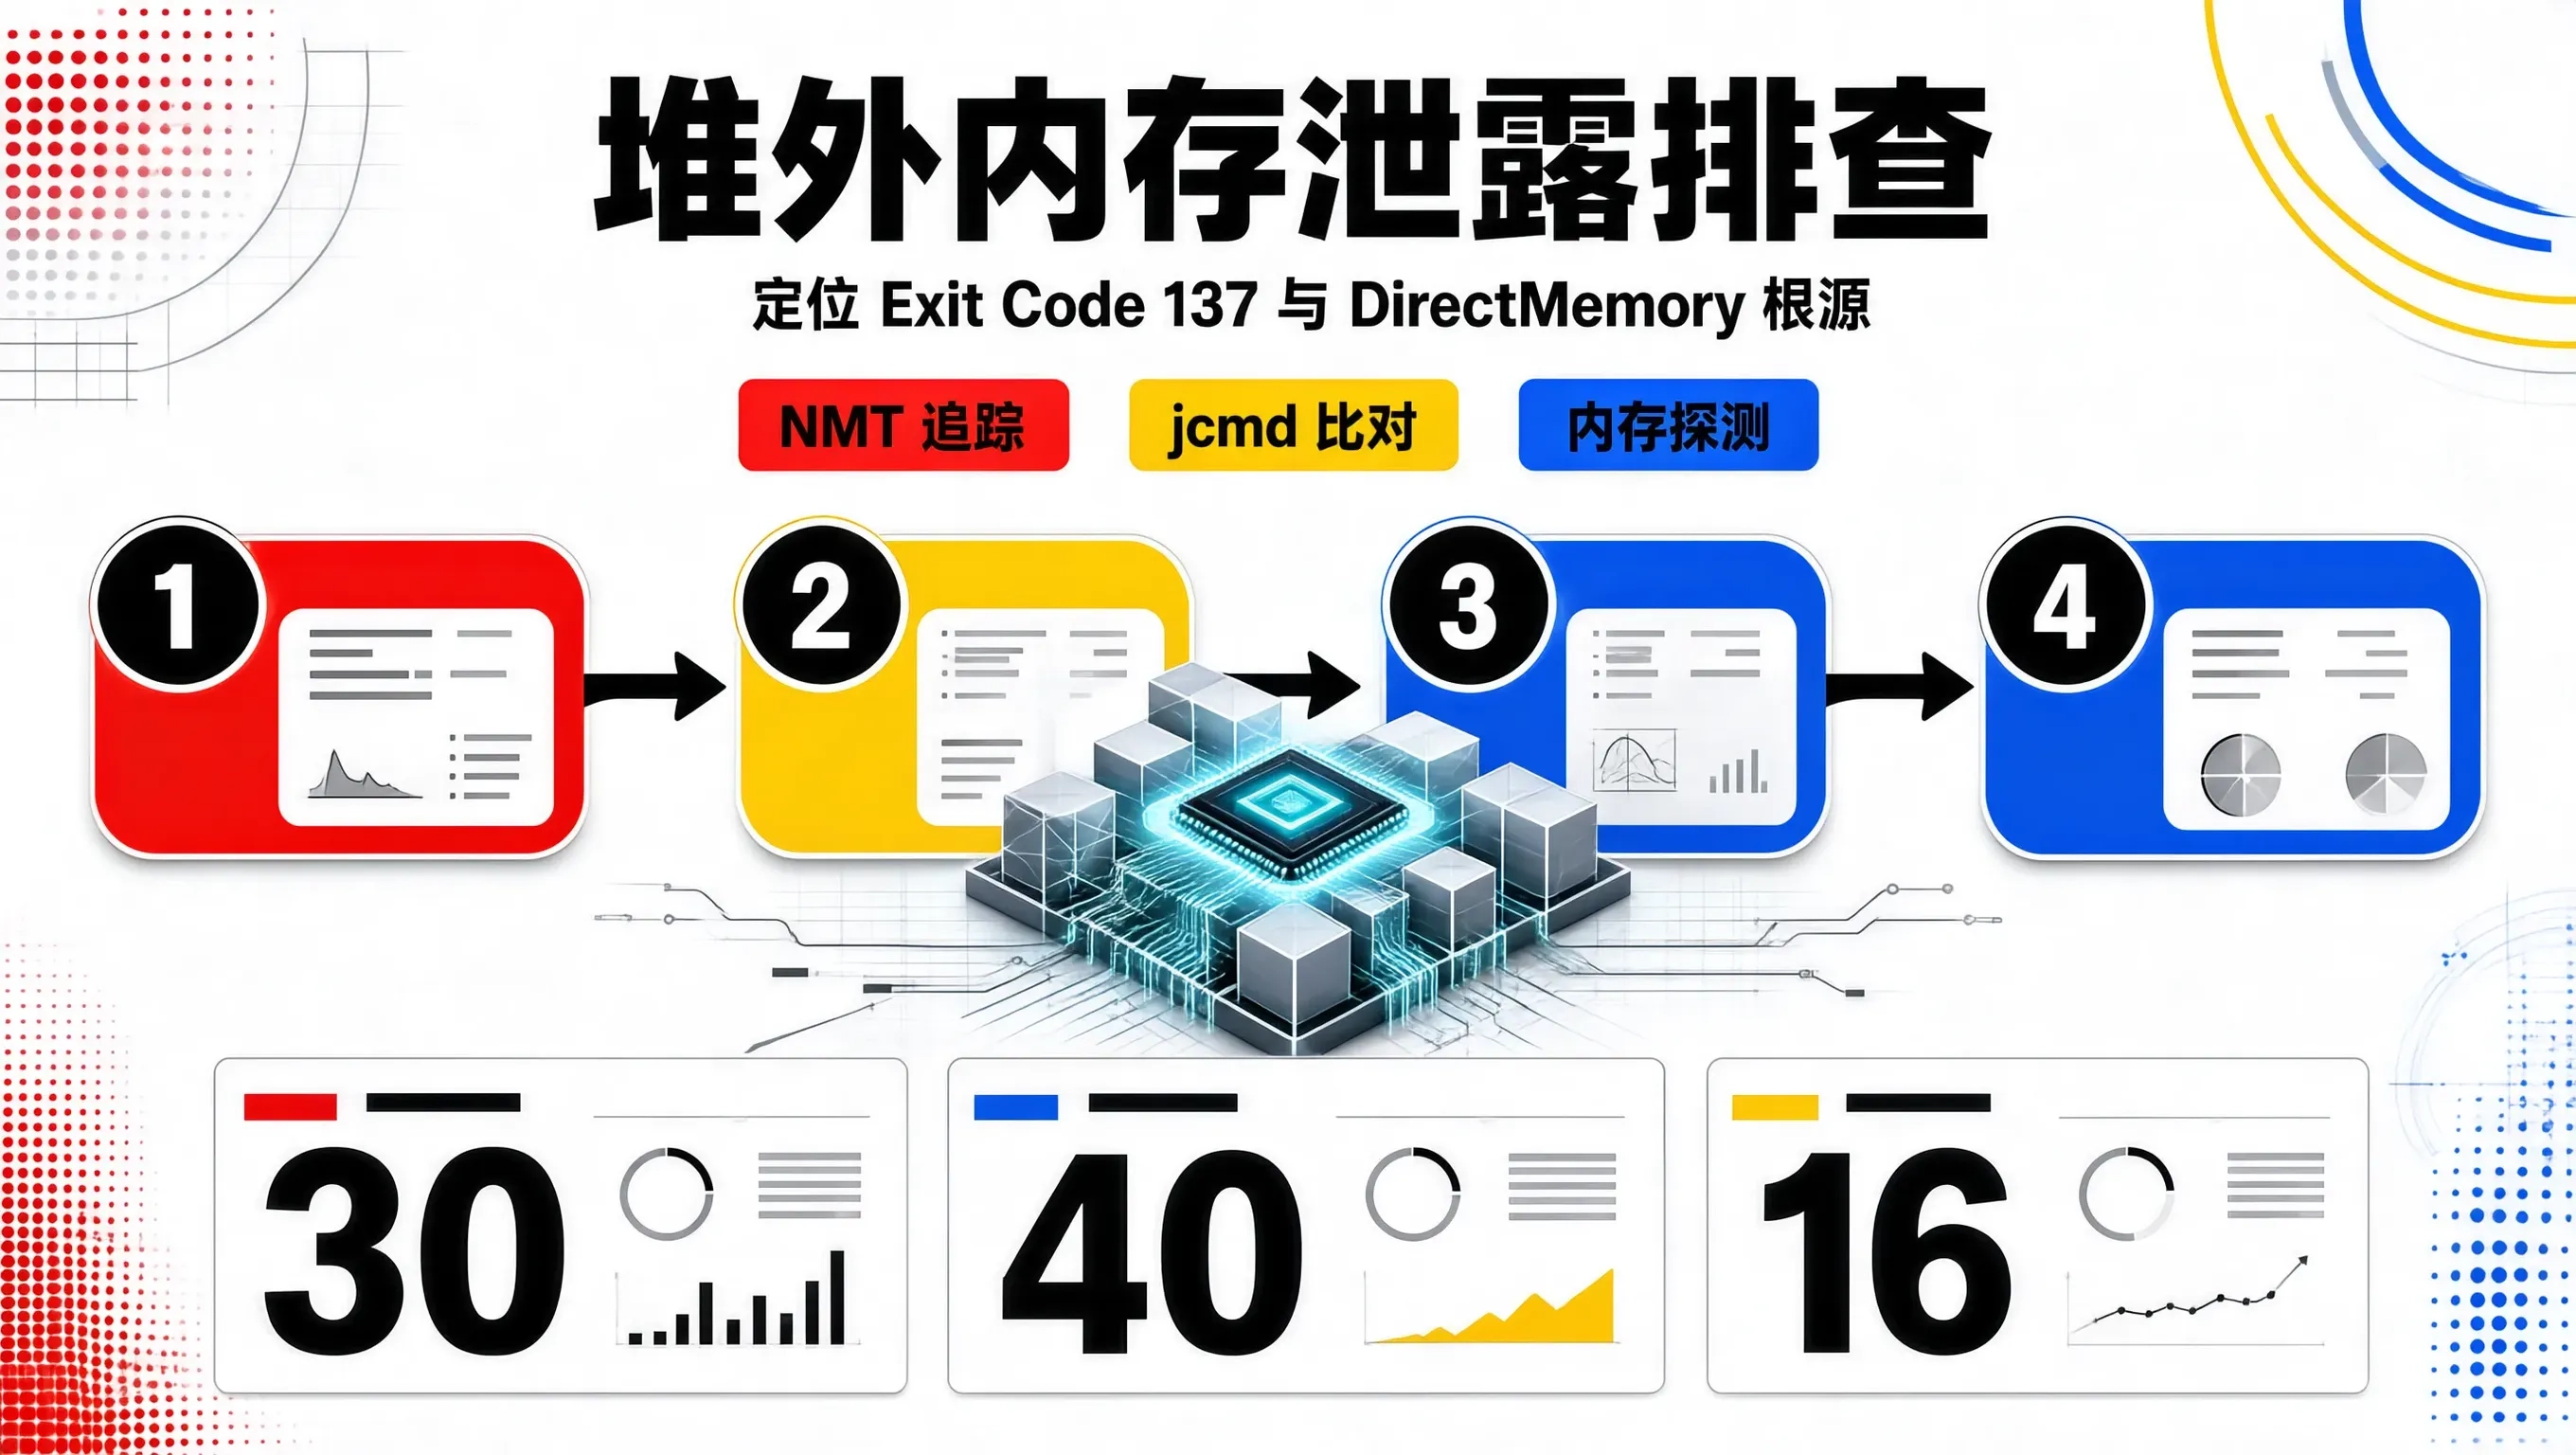
在云原生与容器化部署(Kubernetes)广泛普及的今天,Java 研发团队面临着一种极其棘手的生产故障:微服务的容器进程频繁被操作系统内核直接杀死,Pod 退出码显示为。然而,当工程师紧急调出监控大盘查看 JVM 堆内存(Heap Memory)时,却发现堆内存曲线非常健康,使用率仅维持在 30%~40%,甚至刚刚经历过一次垃圾回收,老年代空间极其充裕。这正是典型的。与堆内内存有垃圾收集器自动
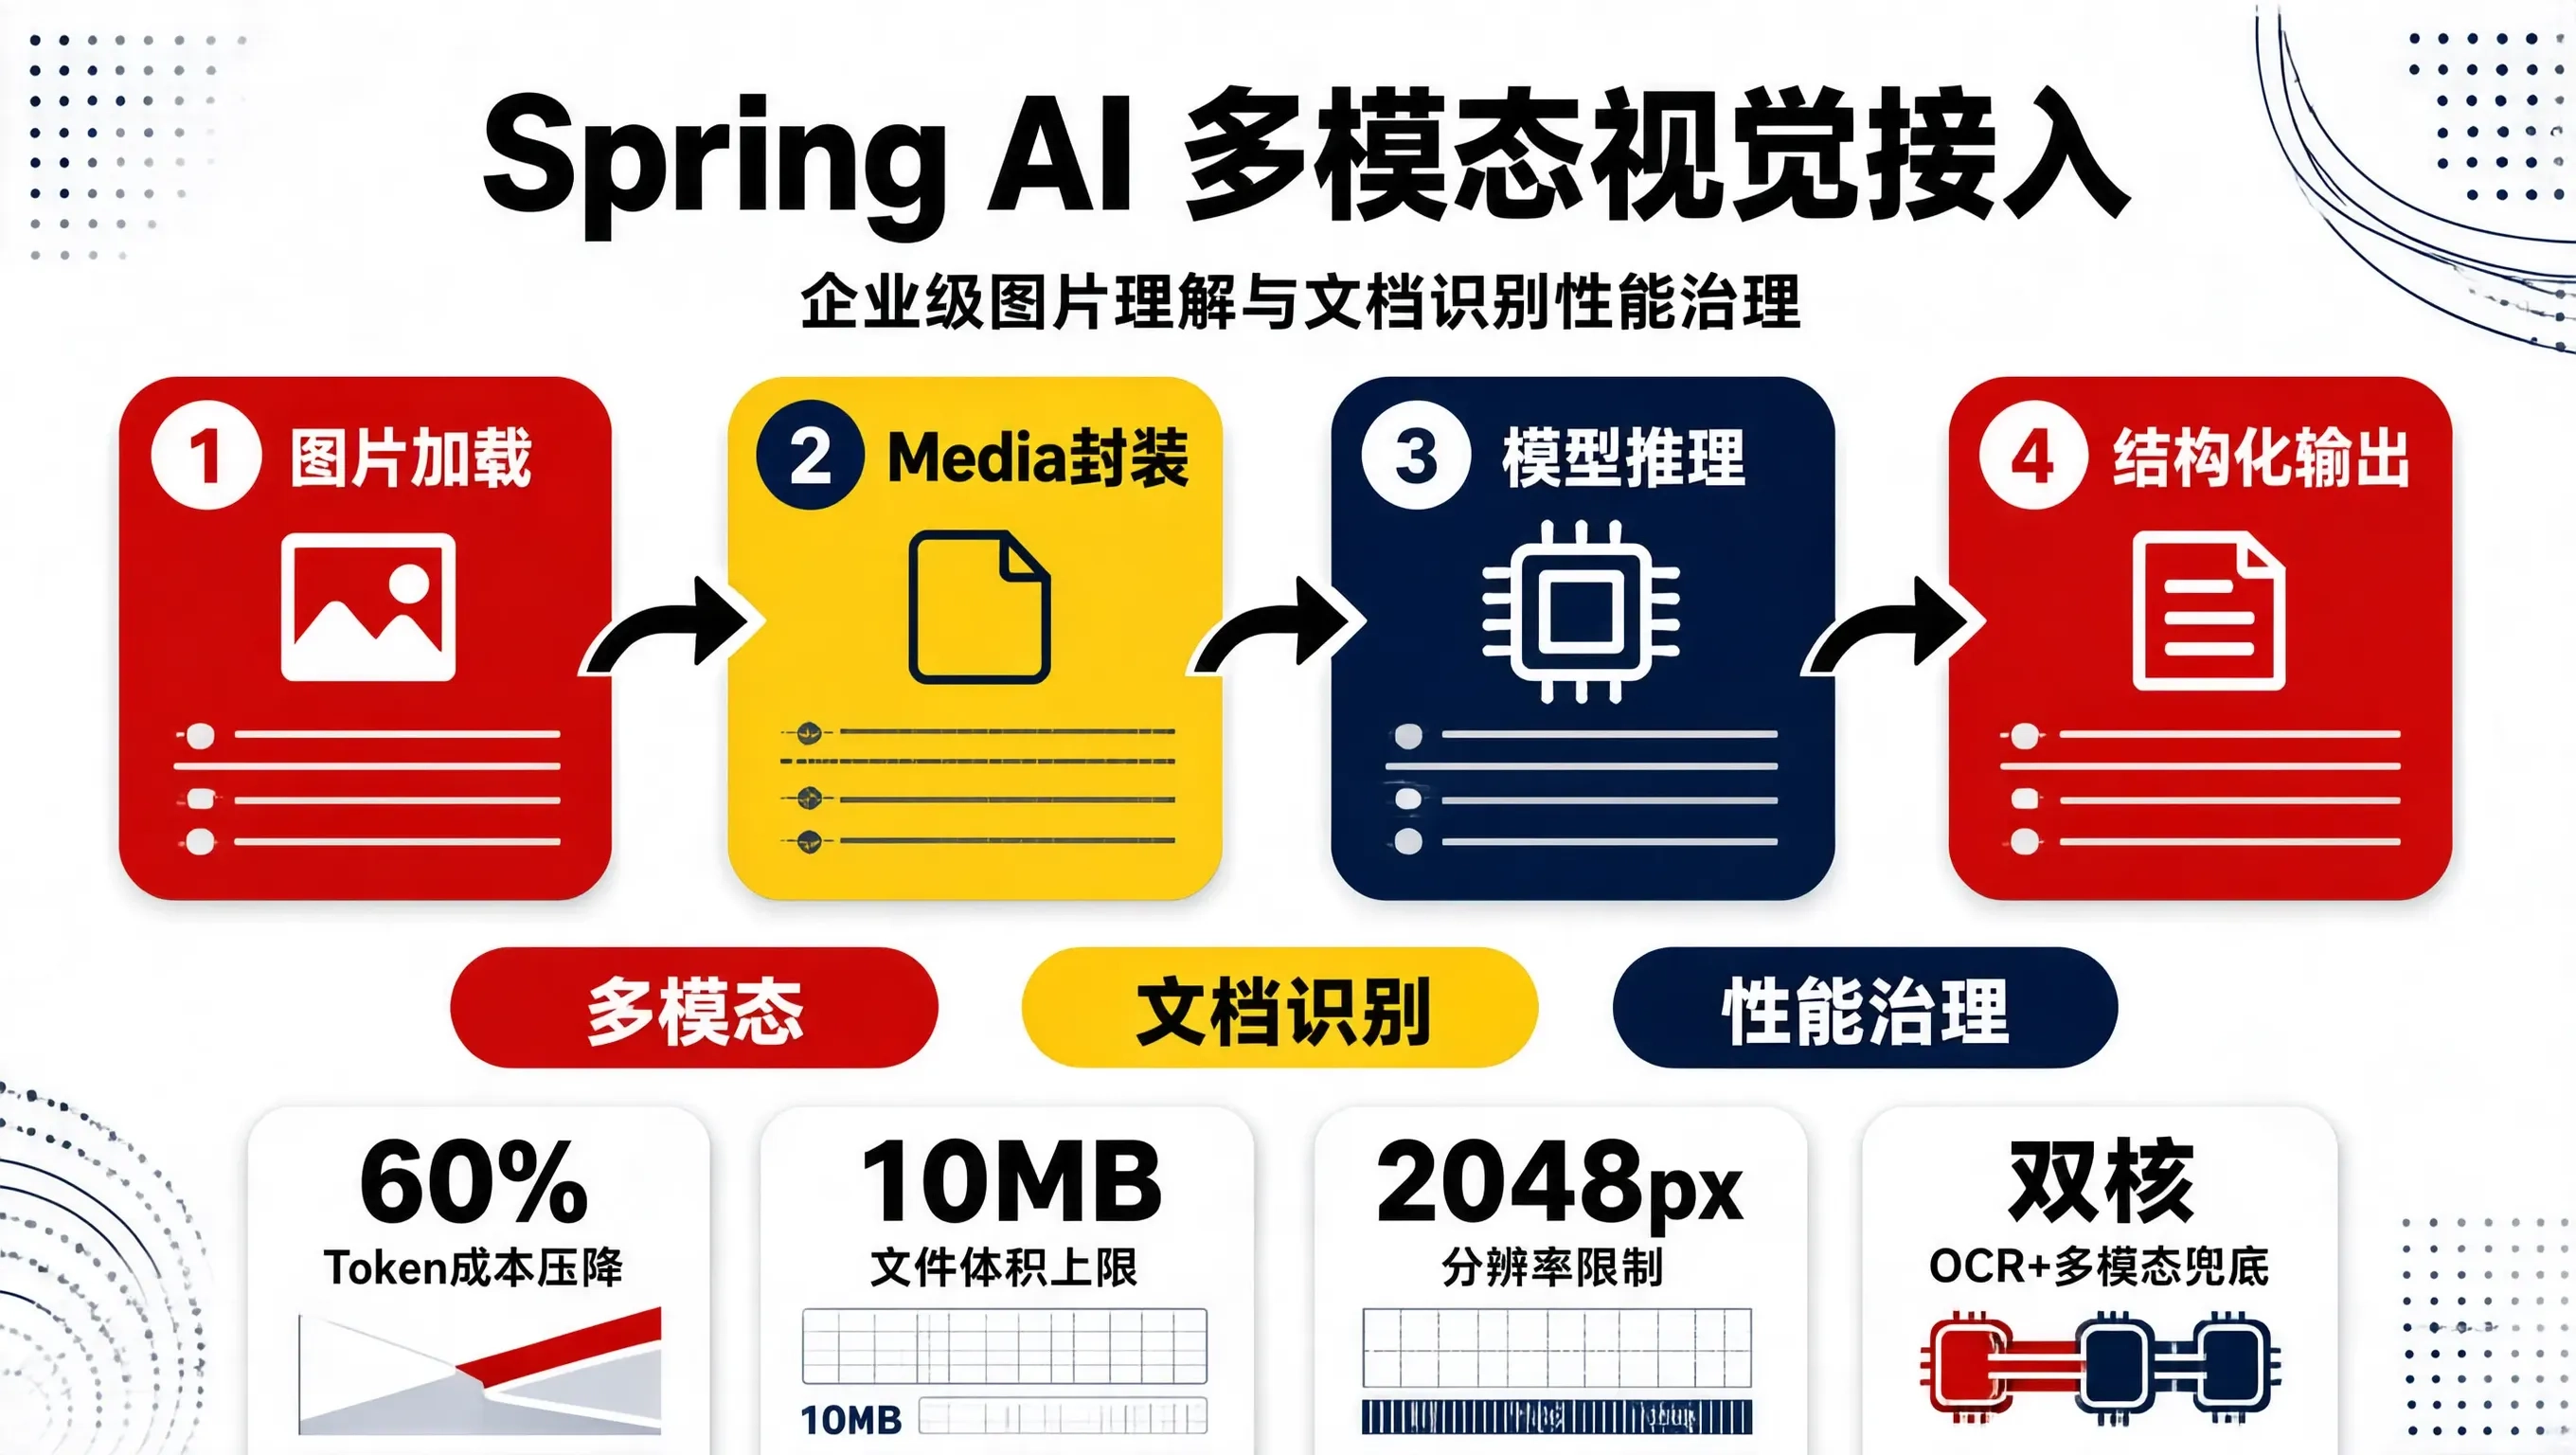
在企业级智能应用开发中,单模态的纯文本交互已经难以满足复杂的业务诉求。发票与单据审核、身份证件 OCR 校对、巡检图片异常定位、以及海量多格式产品手册的结构化解析等业务场景,都需要系统具备对图像与多媒体载荷的实时理解能力。Spring AI 抽象层在演进中全面引入了对多模态(Multimodal)请求的标准支持,使得开发者能够以一致的 Java API 操作多种具备视觉能力的大模型(如 GPT-4