- @a18792721831


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
DP 系列第三篇,第 3 级背包开篇。一道「分割等和子集」(LC416),走完了**四个版本**的完整弧线:贪心版(自己造反例亲手击毙)→ 回溯版(正确,但 25 个元素实测 3300 万次调用)→ 二维 bool 背包(target 错、种子缺、返回格子错,三 bug 一堂课)→ 一维滚动(正序陷阱 + 赋值覆盖,两个坑一次踩完)。
本文介绍了如何使用PostgreSQL作为n8n工作流自动化工具的后端数据库。首先概述了PostgreSQL作为开源关系型数据库的优势和特点,包括其扩展性和复杂数据类型支持。然后详细讲解了通过Docker部署PostgreSQL的步骤,包括目录挂载和常见问题解决。接着指导如何在n8n中配置PostgreSQL数据库连接,通过环境变量指定数据库参数。最后验证了n8n成功将工作流数据存储到Postgr
本文详细介绍了CLAUDE.md和AGENTS.md这两个AI编程助手的配置文件。CLAUDE.md是Claude Code的专属配置文件,用于让AI了解项目上下文,包括构建命令、代码风格、项目架构等;AGENTS.md则是通用AI编程代理的开放标准配置文件。文章对比了传统README.md与AI配置文件的区别,解释了CLAUDE.md的文件位置优先级和内容规范,并提供了完整的配置示例。这些文件能

本文为n8n学习者和使用者提供一份详尽指南。n8n作为一款拥有超过54K Star的开源自动化工作流平台,支持400+节点,正成为数字化转型和AI应用落地的重要工具。文章从n8n基本概念入手,详细介绍Docker部署方法和汉化方案,并通过两个由浅入深的实例展示n8n在实际工作中的应用。无论您想构建简单的通知系统,还是复杂的AI驱动工作流,本文都将帮助您快速掌握n8n使用技巧,提升工作效率,实现业务

本文介绍了使用腾讯云代码助手创建自动化测试用例生成智能体的完整流程。首先安装VS Code插件并登录腾讯云代码助手,选择DeepSeek-V3大模型。通过克隆示例项目后,执行初始化脚本准备环境。核心功能是将XMind文件转换为Markdown需求文档,再根据自定义规则自动生成测试用例。系统通过解析task.yml和flows.yml配置文件,按照五步流程(需求分析、用例设计、用例生成、优化和输出)
摘要:Docker启动PostgreSQL容器时遇到挂载目录失败问题。初始报错显示目录权限和用户问题,检查发现宿主机UID 999已被占用。尝试修改目录权限为2000后仍失败。进一步排查发现PostgreSQL 17+版本需挂载/var/lib/postgresql目录而非旧版的/data目录。最终通过正确挂载目录并指定用户权限成功解决问题,提醒网络信息可能过时需注意版本差异。
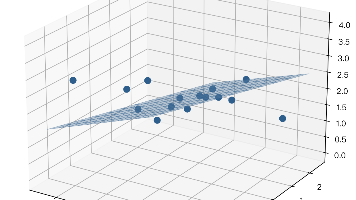
这篇文章从最简单的线性回归出发,逐步构建对大模型的理解框架。作者以"将230B参数压缩到1个"的思想实验为起点,通过二维直线拟合的案例引入权重(w)和偏置(b)的核心概念。随着参数增加,模型从直线升级为平面再到高维超平面,最终引出矩阵运算(Y=XW+b)作为处理海量参数的高效工具。文章采用渐进式讲解,用直观图示和最小二乘法等基础数学工具,为后续深入分词、嵌入、注意力机制等大模型核心组件奠定基础。这
大模型读到的不是文字,而是一串整数。本文用 5 款主流模型的真实实验讲透“一句话怎么变成 token”:GPT-4 要 13 个 token,GPT-4o 只要 7 个,而 DeepSeek/GLM/Qwen 只需 6 个——差距全在词表。从三种传统分词的硬伤,到 BPE 高频合并的统计游戏,再到 BBPE 用 256 个字节从物理上消灭生僻字问题,最后把“今天西安的天气怎么样?”定格成 6 个整
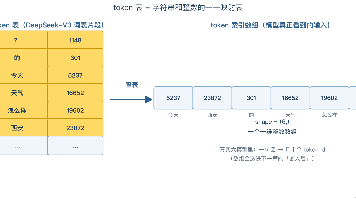
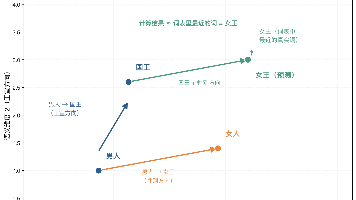
token id 只是个编号,5237 和 5238 相差 1,语义却毫无关系,模型怎么“读懂”它们?本文讲嵌入层:给每个 token 配 4096 个训练出来的实数,把语义编码成几何关系——在语义空间里,国王−男人+女人≈女王可以像向量运算一样算出来。嵌入层的真面目朴素得让人失望:一张 129,280×4096 的查询表(约 5.3 亿参数,取自 DeepSeek-V3 词表),id 当行号,查
「我吃苹果」和「苹果吃我」意思天差地别,但注意力机制是“位置盲”——逐行处理矩阵,行序怎么排它根本不关心。本文讲位置编码如何填这个坑:第一代正弦余弦用不同频率的波形(2017),第二代把位置当词来学(GPT-2),第三代 RoPE 把向量按位置旋转角度——各自旋转后的点积只取决于位置差。实测对比:无 RoPE 时两词点积是 -1.57 的死水平线;有 RoPE 后随距离剧烈起伏,同一个词对换个顺序