


- @LFM3320829529


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
此工作的主要贡献:(1)提出了一种新的语言增强跨模态模型,该模型具有一个条件Transformer(VLCT),可以有效地整合多模态特征,即文本指令和视觉上下文; (2)为了提高语言表征能力,语言编码器使用了预训练的SentenceBERT(SBERT); (3)引入基于预训练LLM的中间组件(LLMIR)来重新表述用户的指令,对LLM微调以适应此任务。

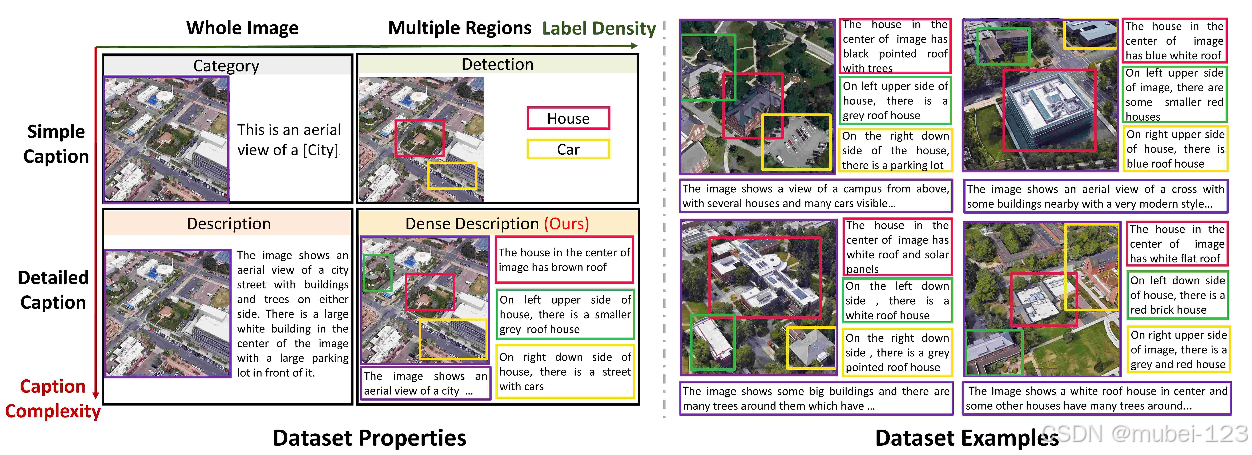
此工作的主要贡献:(1)引入了一种新的图像-文本-预测框基准数据集GeoText-1652,通过创新的基于人机交互的注释过程,在空间位置与其相应的文本注释之间建立精确的关联; (2)提出了一种新的空间感知方法,该方法利用细粒度空间关联来执行区域级空间关系匹配。与独立边界框回归不同,此方法进一步引入了无人机图像中的相对位置和周围位置的文本描述,以实现精确定位。
本文的主要贡献:(1)提出一种图形感知Transformer(GAT),利用图形注意力机制将对话文本与结构化历史观察相关联,为行动规划提供更全面的时空信息;(2)细粒度视觉基础任务。此任务可以通过强制代理去预测所引用地标的精确边界框(类似于目标检测),来提高代理对地标的感知;(3)提出一种基于LLM的数据增广器,对对话框文本和观察结果进行各种数据增广合成——更多指令,图像模糊、随机噪声、像素丢失。

本文主要介绍大模型训练(优化)的几种高效策略的理论原理与工程实现代码:监督微调(SFT)、近端策略优化(PPO)、直接偏好优化(DPO)以及组相对策略优化(GRPO)。
(1)大型语言模型(LLM)展示了令人印象深刻的能力,但也遇到了幻觉、过时的知识以及不透明、无法追踪的推理过程等挑战。(2)通过整合外部数据库的知识,检索增强生成(RAG)已成为一种有前景的解决方案。这提高了生成的准确性和可信度,特别是对于知识密集型任务,并允许持续的知识更新和特定领域信息的集成。

本文主要介绍大模型训练(优化)的几种高效策略的理论原理与工程实现代码:监督微调(SFT)、近端策略优化(PPO)、直接偏好优化(DPO)以及组相对策略优化(GRPO)。
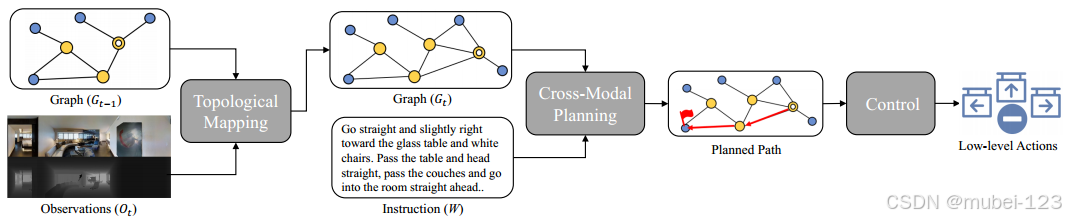
本工作的主要贡献:(1)提出了一种新的基于拓扑图的VLN-CE鲁棒导航规划方法。它可以有效地抽象连续环境,并促进代理的长期目标规划;(2)通过综合实验研究了构建拓扑图的基本设计选择,证明了简洁的深度设计是航路点预测的最佳选择;(3)提出了一种有效的试错控制器来解决避障问题。
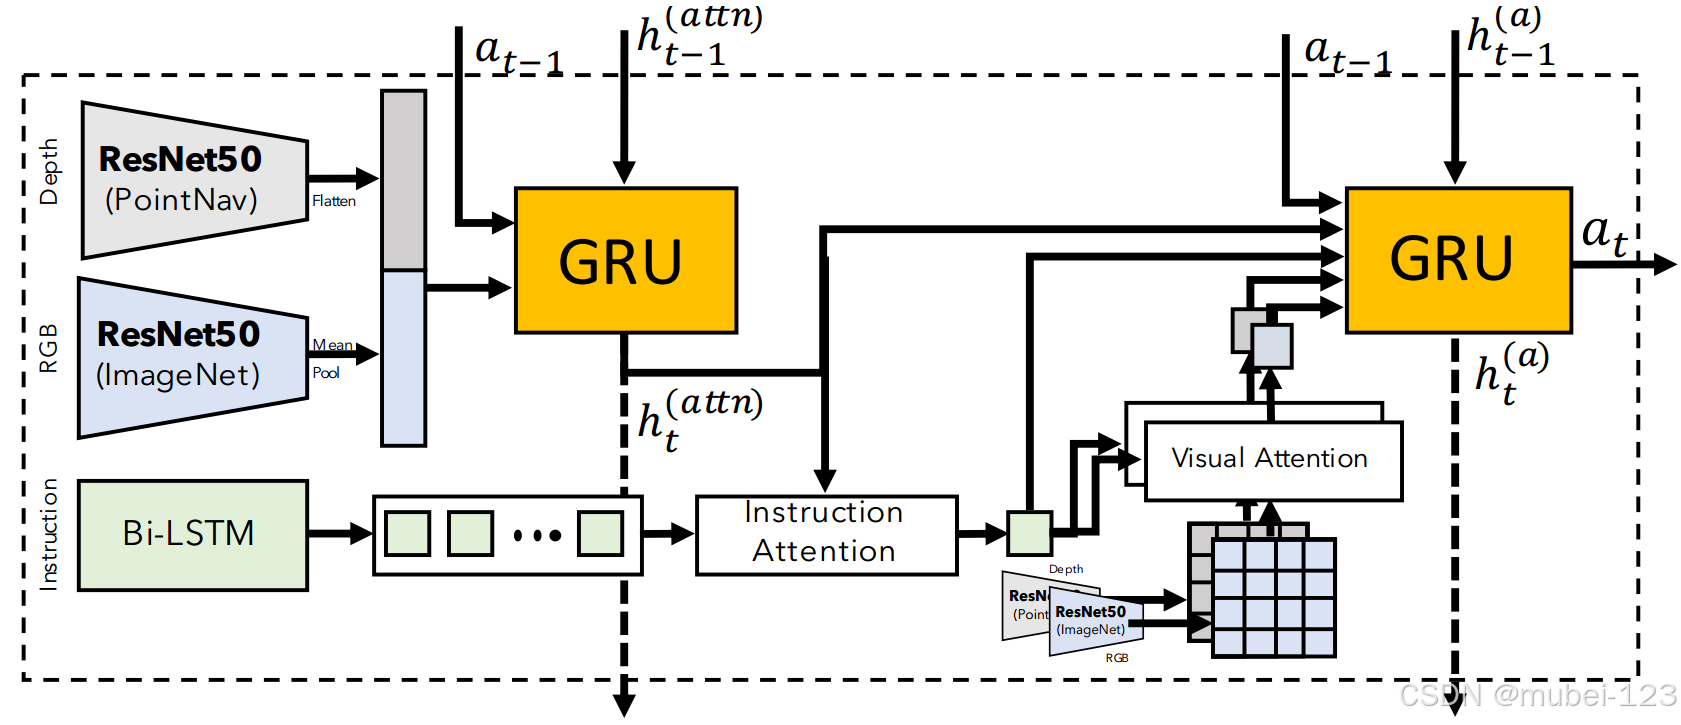
此工作的主要贡献:(1)提出一种无人机视觉语言导航数据集,收集25个不同的城市级环境,涵盖市中心、工厂、公园和村庄等各种场景,包括870多种不同类型的对象,总共8446条飞行路径,每条路径与注释中的3条指令对齐,子路径与子指令对齐,每条指令中最多有83个单词,涉及4470个词汇; (2)提出一种起始基线模型,该模型基于门控循环单元(GRU)和跨模态注意力CMA。
模仿学习。为模型提供高质量的“问题-答案”配对数据,让它学习如何生成正确的回答。强化学习。让模型通过试错,根据一个“奖励模型”的反馈来优化自己的策略(即生成答案的方式)。绕过奖励模型,直接使用偏好数据来优化模型。它是一种更聪明、更简洁的数学转换。用简单规则对模型自己实时生成的结果进行分组比较,从而实现自我迭代优化。其革命性在于,它完全摆脱了对“人类标注的偏好数据”或“奖励模型”的依赖,仅依靠一个可
Transformer是谷歌2017年发表的论文《Attention Is All You Need》中提出的,用于NLP的各项任务,其引入了自注意力机制(self-attention mechanism),具有长距离依赖关系建模、并行计算能力和通用性能优点,已广泛应用于系列数据的处理。在本文中,我们将从Transformer的整体框架、Encoder结构和输入输出、Decoder的结构和输入输出
