


- @DD18203614685


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
排序算法(Sorting algorithm)定义对一序列对象根据某个关键字进行排序。术语稳定性:稳定排序算法会让原本有相等键值的纪录维持相对次序稳定:如果a原本在b前面,而a=b,排序之后a仍然在b的前面;不稳定:如果a原本在b的前面,而a=b,排序之后a可能会出现在b的后面;内排序:所有排序操作都在内存中完成;外排序:由于数据太大,因此把数据放在磁盘中,而排序通过磁盘和内存的数据传输才能进行;
缺失值是指数据集中某些观测值或特征的数据为空缺的情况。处理缺失值的方法有:删除缺失值、填充缺失值(使用平均值、中位数、众数、插值等方法填充)、使用模型进行缺失值预测填充等。删除缺失值:如果缺失值的比例很小,可以考虑将包含缺失值的数据行删除。填充缺失值:可以使用均值、中位数、众数等统计量来填充数值型特征的缺失值;对于分类特征,可以使用出现频率最高的类别进行填充;对于时间序列数据,可以使用前后数值的插

1.频数分布分析主要通过频数分布表、条图、直方图以及集中趋势和离散趋势的各种统计量,描述数据的分布特征
导入一个包 fake_useragent 随机获得请求头下载命令:pip install fake_useragent导入:from fake_useragent import UserAgent使用:# 随机产生一个浏览器信息headers = {"User-Agent": UserAgent().random}...
渐近显著性和精确显著性适用于不同的情境,需要根据具体的研究问题和数据特点选择合适的方法。在大样本容量下,可以使用渐近显著性以取得更高效的计算;而在小样本的情况下,应该使用精确显著性来避免精确度的丢失。
小样本是指样本量较少的情况,具体多少才算小样本并没有一个确切的标准,一般来说,小样本的定义受到具体问题和研究领域的影响。简单来说,当样本量少到无法满足正态分布、中心极限定理等假设条件时,就可视为小样本。在某些研究领域中,如生物医学研究、心理学研究等,样本量一般较少,小于30或50的样本通常被认为是小样本。而在其他一些领域,如大数据分析、金融统计等,数百万甚至数亿的数据都是常态,少则数百、数千的样本
AB测试就是通过将测试对象随机分成两组,然后控制其他变量一致的前提下,对其中一组进行某种行为或者功能的干预。继而计算AB效果的差异。学术说法:AB测试是基于统计学原理, 通过合理流量分配, 高效、准确选取局部指标价值最大化方案的一系列方法论的总和。
PandasAI的革命性在于——用自然语言代替代码!只需一句"显示上海GDP超过4万亿的记录",即可完成相同操作
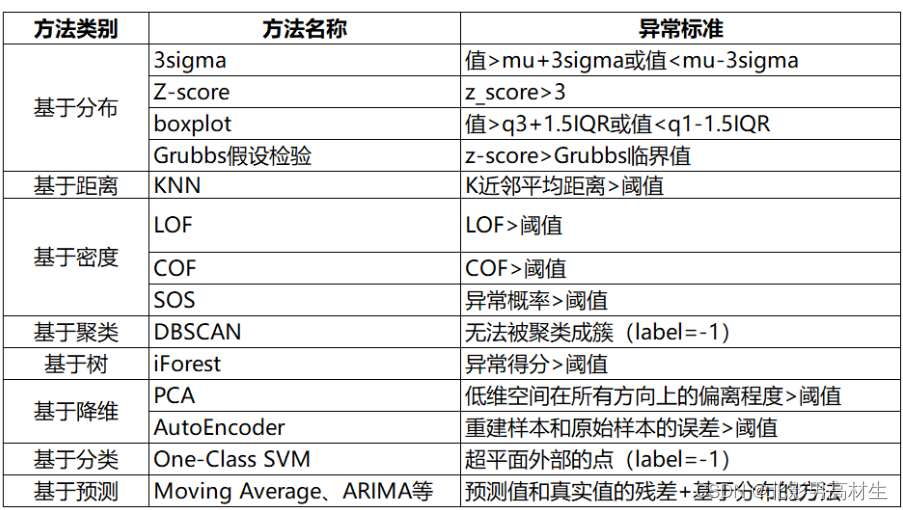
一、基于分布的方法1、3sigma基于正态分布,3sigma准则认为超过3sigma的数据为异常点def three_sigma(s):mu, std = np.mean(s), np.std(s)lower, upper = mu-3*std, mu+3*stdreturn lower, upper2、Z-scoreZ-score为标准分数,测量数据点和平均值的距离,若A与平均值相差2个标准差,
小样本是指样本量较少的情况,具体多少才算小样本并没有一个确切的标准,一般来说,小样本的定义受到具体问题和研究领域的影响。简单来说,当样本量少到无法满足正态分布、中心极限定理等假设条件时,就可视为小样本。在某些研究领域中,如生物医学研究、心理学研究等,样本量一般较少,小于30或50的样本通常被认为是小样本。而在其他一些领域,如大数据分析、金融统计等,数百万甚至数亿的数据都是常态,少则数百、数千的样本