- @CodingKitten


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
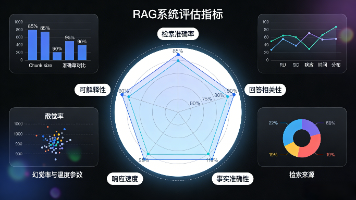
模型是否学到了我想教的东西?(技术有效性)学到的东西是否有用?(业务价值)目标驱动的——紧密围绕你的微调目的多层次的——技术指标+人工评估+业务测试可操作的——能指导后续的优化方向可持续的——建立评估标准,而不仅是一次性打分。
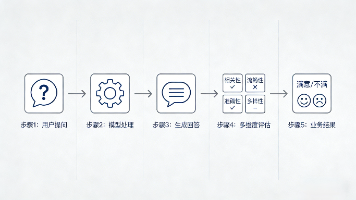
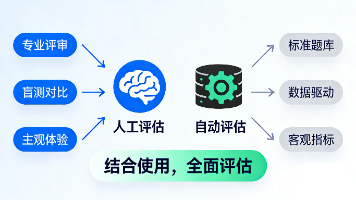
评估是必须的:没有评估的微调就像蒙眼射击两条腿走路:人工评估抓“感觉”,自动化评估抓“数据”评估要全面:既要看专项提升,也要防通用能力倒退工具能提效:善用OpenCompass等框架,让评估自动化迭代是关键:评估 → 调整 → 再评估,循环优化。
简单说,就是AI“一次能记住多少字”。你刚才说的话它自己已经回答的内容这个“参考范围”就是上下文长度。GPT-3.5:约3000字(4096 Tokens)Claude 3:10万字(100K Tokens)最新模型:20万字以上理解大模型技术,不再是程序员的专利。从理解Token、Embedding这些基础概念,到掌握Prompt技巧,再到亲手微调自己的模型——这条路径已经变得越来越平坦。记住,
通过这次旅程,你已经掌握了微调专属大模型的核心流程:从理解微调的价值,到选择合适的方法(特别是LoRA),再到使用LLaMA Factory进行零代码实战,最后评估模型效果。关键在于高质量的数据和合理的参数配置。未来展望:更高效的微调技术:如GaLore、DoRA等新技术会进一步降低微调门槛。自动化与智能化:自动超参数搜索、自动数据清洗和增强工具将让微调更加“傻瓜式”。多模态与智能体:微调技术将不
摘要: 微调技术通过针对性训练预训练大模型,使其适应特定任务,大幅降低AI定制化成本。核心原理是在通用模型基础上调整参数,分为全量微调(效果优但资源消耗大)和高效微调(如LoRA,节省90%资源)。实践步骤包括:1)准备领域数据(100-1000条);2)选择基础模型(如Qwen、Llama 2);3)配置微调方法(如LoRA);4)训练执行(3-5轮即可);5)测试部署。该技术使中小企业也能快速
今天,我将用最直白的方式,带你彻底搞懂4种主流微调技术,帮你找到最适合自己项目的方案。相信很多开发者都有这样的体验:ChatGPT、文心一言等通用大模型虽然能力强大,但一到具体业务场景就“水土不服”——回答不够专业、格式不符合要求、对领域知识一知半解。正是解决这个问题的关键:它让通用大模型通过学习你的专属数据,变成懂你业务、合你心意的“专属助手”。这就像请来一位博学多才的通才,但他不懂你公司的业务
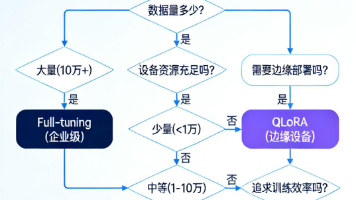
这种低门槛大模型微调平台,把自己的数据真正“喂”进模型里,生产出属于自己的专属模型。:在保留模型99%通用能力(医学基础、问诊技巧)的基础上,用你特定领域(心外科病历)的少量数据,对模型进行“精修”,使其在该领域表现突飞猛进。理解这三步,你不仅能明白大模型能力的来源,更能掌握将前沿AI能力“私有化”、“专业化”的钥匙,无论是优化业务还是创造新产品,都至关重要。:用一些通用问题(如“解释牛顿第一定律
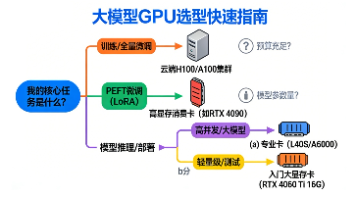
2024年RAG发展的三个方向:智能化检索多轮对话感知:基于对话历史动态调整检索策略主动式检索:预测用户潜在需求,提前检索相关信息端到端优化检索器与生成器联合训练,让它们“互相适应”统一评估指标,避免检索与生成目标冲突多模态扩展从纯文本走向图像、表格、音视频的跨模态检索比如:上传产品设计图,检索相似竞品资料RAG技术正在降低大模型的应用门槛。过去需要投入数百万训练专属模型的企业,现在可以用极低的成
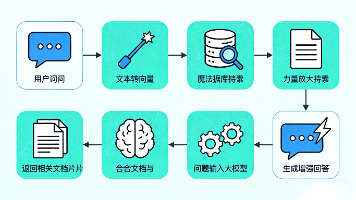
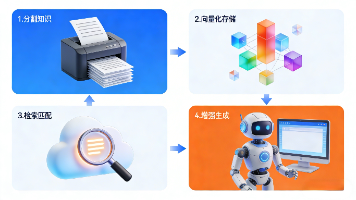
它允许你通过可视化界面或简单配置,轻松完成数据准备、模型微调、评估部署的全流程,即使没有深厚的代码基础,也能让你在实践中深刻理解如何让模型“更像你想要的样子”,是实现AI应用落地的快捷工具之一。从一个具体的业务场景入手,用本文提供的简易框架实现一个原型,在实践中体会其价值与挑战,你将稳步踏上企业AI智能化升级的阶梯。这篇文章,我将用最通俗的语言,为你拆解RAG的核心理念、技术架构,并提供一个清晰的
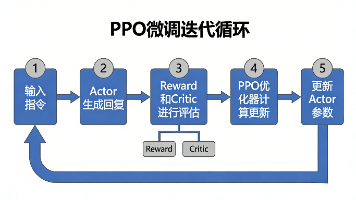
PPO不是单一算法,而是一个包含四个模型的协作系统稳定性是关键:通过KL惩罚和裁剪机制避免训练崩溃数据质量决定上限:高质量的人类偏好数据是成功的基础迭代优化:PPO微调需要多次实验和调参PPO微调让大模型从“知识库”进化为“智能体”,从被动回答到主动理解。这项技术正在重塑我们与AI的交互方式,让机器不再是冷冰冰的工具,而是能理解我们、适应我们的伙伴。无论你是研究者、开发者,还是对AI技术充满好奇的