


- @2601_94892163


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
AI代码审查需先验证评论真实性,避免将误报训练进小模型。Vapi案例显示,机器人虽缩短PR合并时间,但提速不等于蒸馏效果。知识蒸馏应以可核验缺陷记录为起点:明确证据、分类缺陷、严格数据拆分,确保样本真实可信。训练前需构建带溯源信息的结构化数据集,区分正负样本,避免重复与泄漏。上线前应影子运行,评估漏报、误报与人工成本。最终目标是让小模型学得准、用得省,而非盲目追求速度。
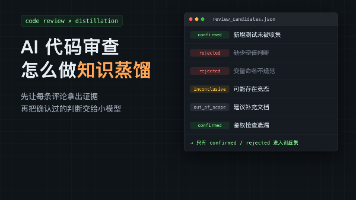
AI代码审查需先验证评论真实性,避免将误报训练进小模型。Vapi案例显示,机器人虽缩短PR合并时间,但提速不等于蒸馏效果。知识蒸馏应以可核验缺陷记录为起点:明确证据、分类缺陷、严格数据拆分,确保样本真实可信。训练前需构建带溯源信息的结构化数据集,区分正负样本,避免重复与泄漏。上线前应影子运行,评估漏报、误报与人工成本。最终目标是让小模型学得准、用得省,而非盲目追求速度。
企业接入大模型常见的7个工程陷阱及解决方案:1)业务代码直接调用模型接口导致后期难维护,应封装统一调用层;2)单模型直连缺乏切换能力,需配置路由策略;3)忽视兼容OpenAI接口的迁移价值;4)缺少异常处理机制;5)成本统计滞后;6)长上下文未分层优化;7)忽略企业交付要求。建议构建包含统一调用层、路由配置、监控系统、上下文分层和企业级功能的接入底座,推荐使用兼容OpenAI的统一平台快速验证。

在多模型架构中,Claude更适合承担长文档分析、复杂问答、代码生成等高价值任务,而非所有请求的默认出口。建议按任务轻重分层路由,让Claude聚焦重任务,轻任务分流至低成本模型。PoC阶段可先用Claude验证任务上限,上线后需关注统一接入、成本治理和多模型路由。成熟方案应包含任务分流、fallback机制和统一监控,避免单一模型绑定。统一接入层设计(如兼容OpenAI SDK的方案)能有效解决
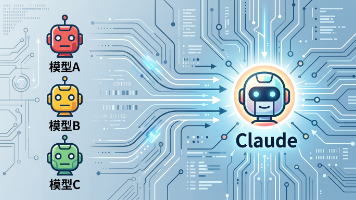
Claude Code最新推出的Agent Teams功能允许同时运行多个Agent并行处理任务,显著提升效率但需注意token消耗问题。该功能适合独立、读操作为主的任务(如代码审查、文档生成),但多Agent同时修改同一文件或需紧密协作的任务效果不佳。使用成本可能翻倍,建议通过API调用控制预算、限制子Agent数量、明确任务边界来优化。目前仍为研究预览功能,生产环境需谨慎使用。此外,不同平台的
Gemini 3.1 Pro 发布之后的讨论几乎全在聊性能、价格、上下文窗口。但 Gemini 3.1 Pro 的 Model Card 里有一段被大多数报道忽略的内容:Google DeepMind 的前沿安全框架(Frontier Safety Framework)评估结果。其中网络安全(Cyber)领域的结论是:Gemini 3.1 Pro 已经到达了 Google 内部设定的"警戒阈值"(
Google宣布gemini-3-pro-preview将于2026年3月9日停用,建议迁移至gemini-3.1-pro-preview。关键时间点包括2026年3月6日-latest别名切换。文章强调迁移不仅需修改模型名称,更需注意权限、区域端点等工程细节,并提供回归测试建议(成功率、延迟、成本等指标)。特别提醒生产环境应避免使用-latest别名,并列出常见错误处理方案。最后给出迁移检查清单
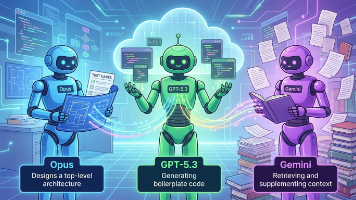
2026年2月,三大AI厂商Claude、GPT和Gemini同时更新了编程模型。本文对比了Claude Opus 4.6、GPT-5.3-Codex和Gemini 3.1 Pro的性能与成本:Opus在复杂重构和架构设计上表现最优,GPT擅长脚本开发和DevOps任务,而Gemini凭借1M上下文窗口和最低成本成为代码理解和文档检索的最佳选择。成本方面,Gemini的月成本仅为Opus的44%。
办公类场景还好接受,但做研发的一旦进入“反复跑、反复对齐”的状态,一个下午把成本抬到几十块并不稀奇。如果你跟我一样是“刚装好,想快点用起来”,我当时做的第一件事不是选平台,而是先把开关做出来:把 key、base_url、model 配好、能切换、能回滚。后来我才反应过来,这事往往不是你提示词写得好不好,而是工具怎么拼上下文:有没有长期记忆、有没有把历史对话反复塞回去、系统提示到底有多长、模型是不
多模型调用关键在于分工而非简单接入。以开发辅助工作流为例,应让不同模型各司其职(如Claude分析长代码、GPT整理结果),形成接力链路而非并行堆砌。实际应用中需设计调用路径、默认模型规则和fallback机制,避免陷入维护困境。常见问题包括无标准切换、分散成本监控和底层频繁改动。真正挑战在于将多模型系统转化为稳定基础设施,这需要从接入思维转向工程治理思维。
