


- @2501_93982728


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
但今天的AI算力需求,往往涉及成千上万张GPU的协同工作,还要配套高速网络、存储、液冷、电力、机房、调度软件和运维团队。模型公司面临的也不只是资金问题:高端GPU需要提前锁货,机房和电力建设需要时间,集群组网涉及大量工程调优,等全部完成,模型可能已迭代一轮。算租公司卖的并不是GPU,而是时间——帮助客户缩短从“想要算力”到“真正能用”的时间,并替客户承担部分技术迭代风险。研究算租,应沿着现金流顺序
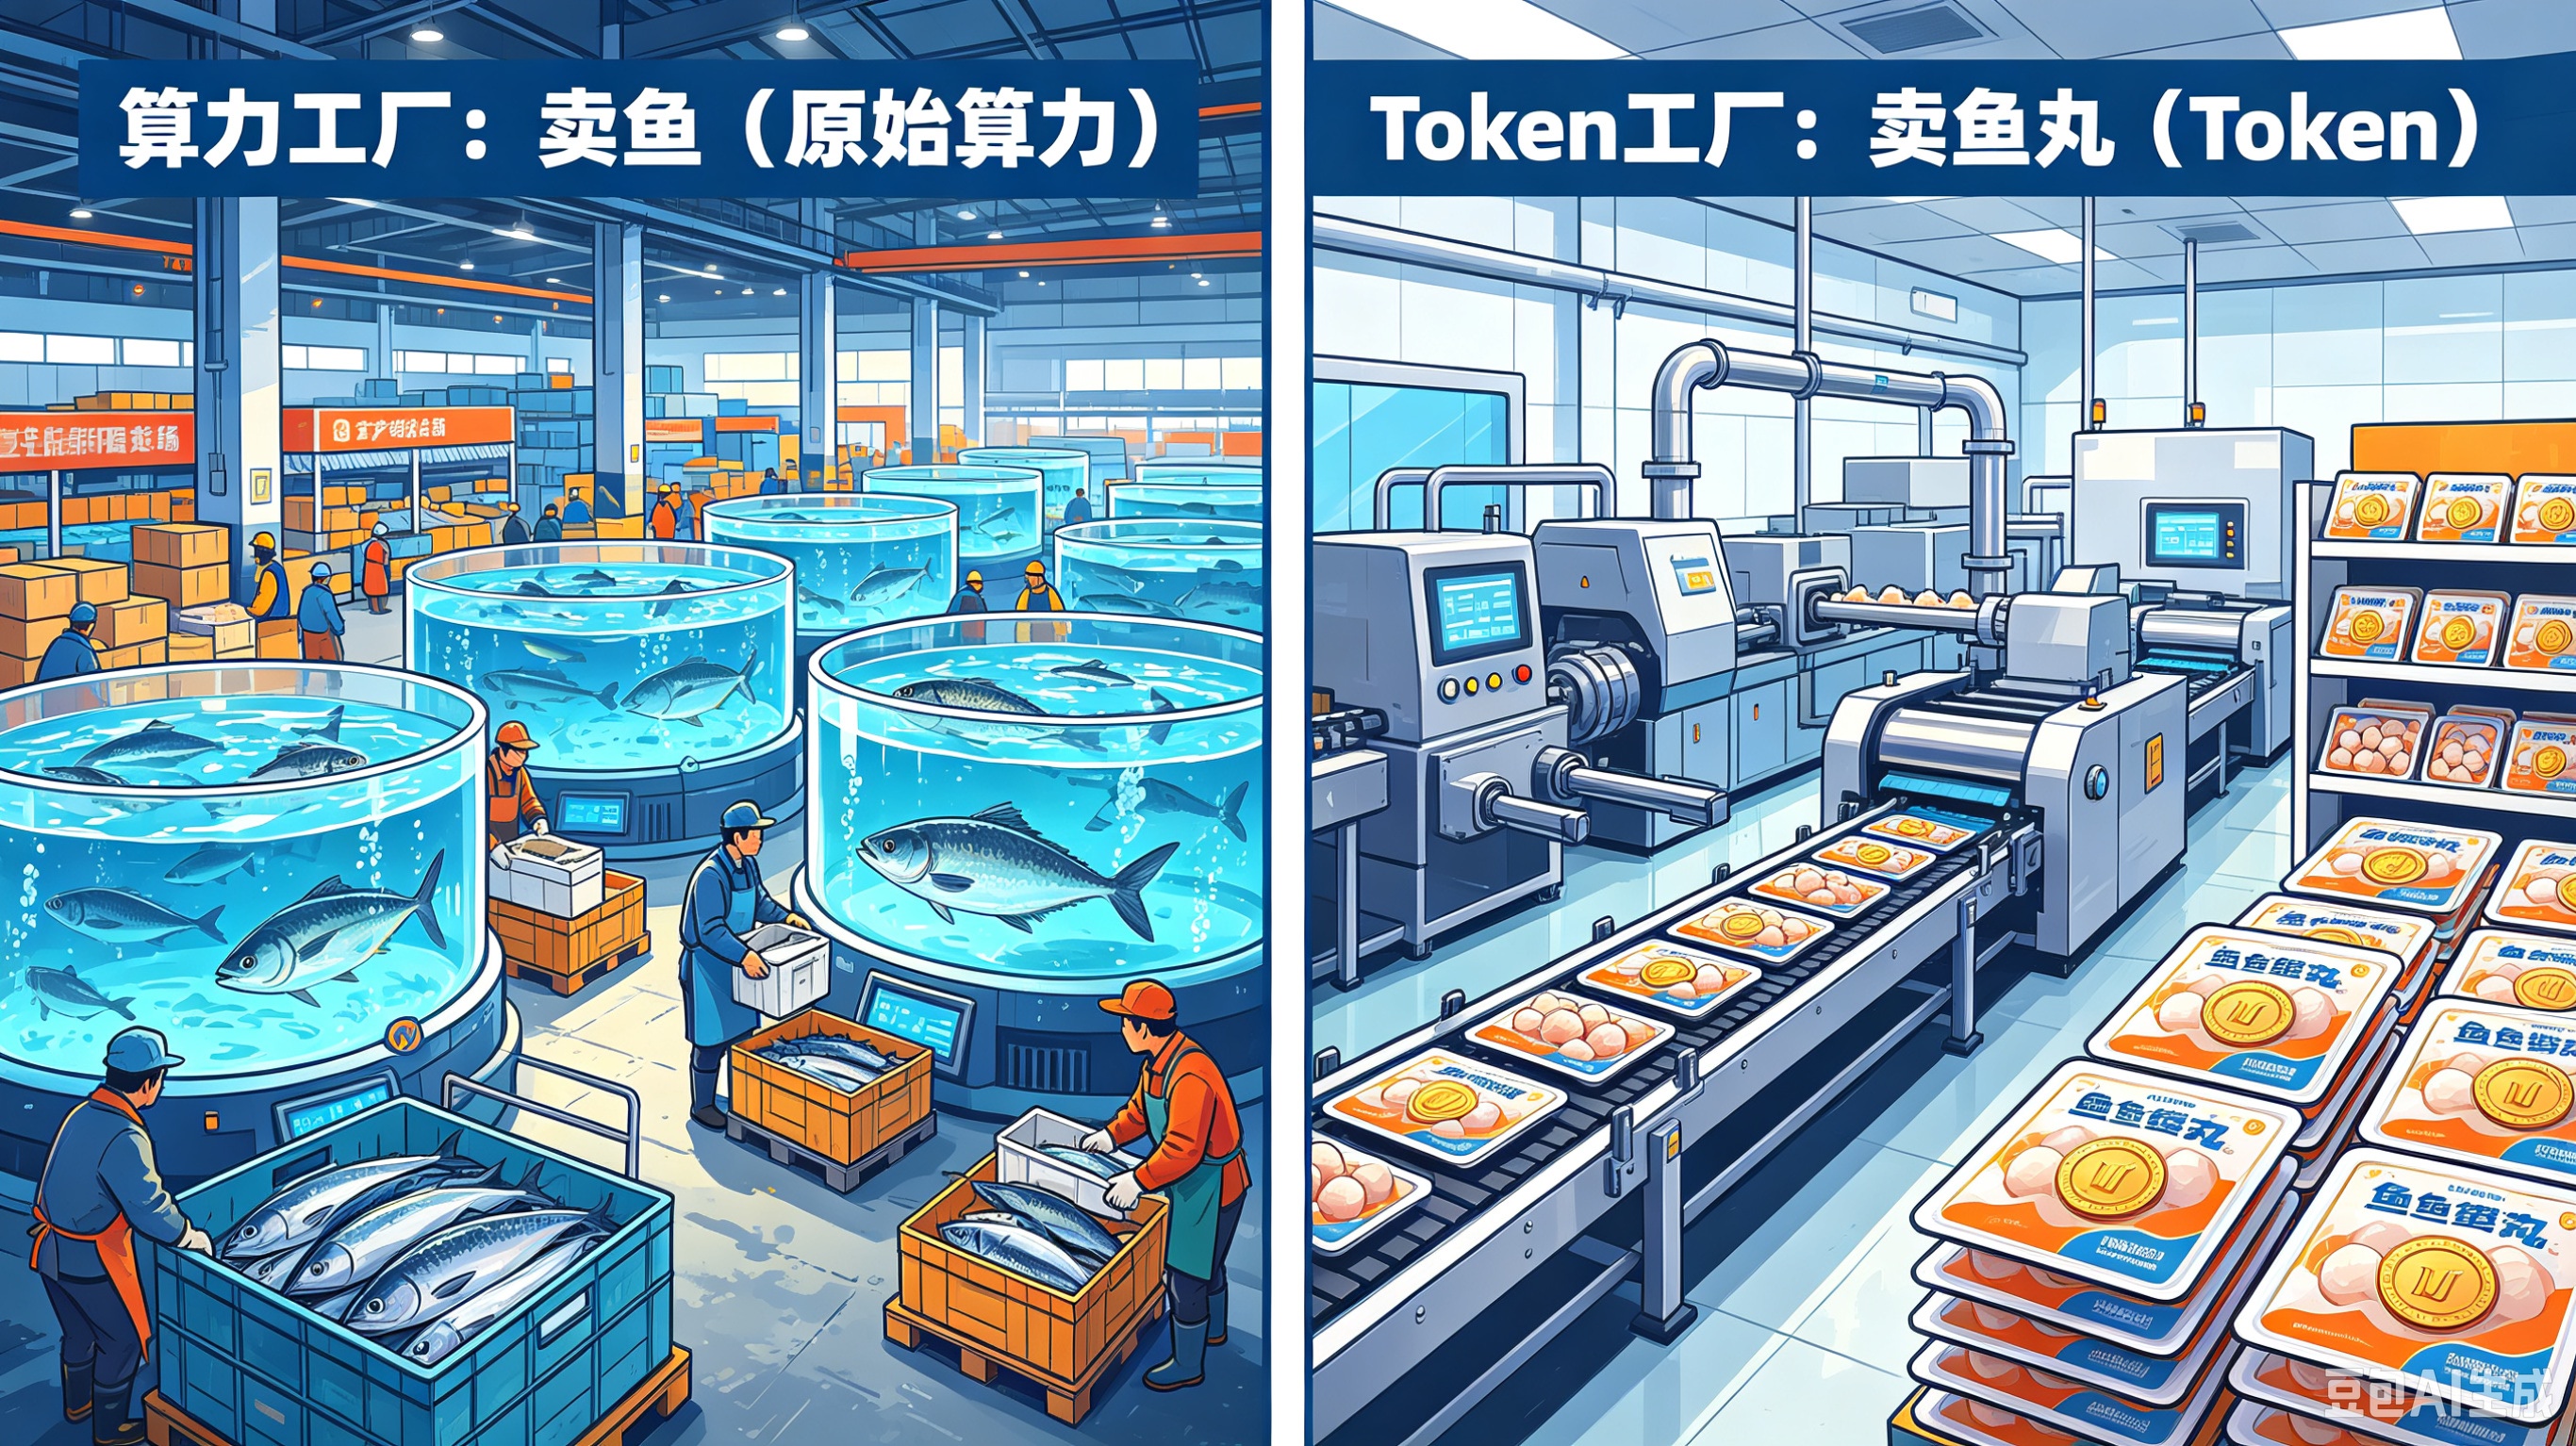
它通过自动化流水线,完成原始语料采集、清洗、筛选、编码,持续输出标准化、高质量的Token数据集,为大模型预训练和微调提供核心原料。算力工厂,是标准化、规模化集中部署大量AI服务器(以GPU、加速卡为核心),对外输出智能算力的基础设施。· Token工厂:重点是算力底座和算法技术(模型优化、任务调度),核心是优化Token的产出效率。· Token工厂:“交付Token”,把算力产出转化为标准化、
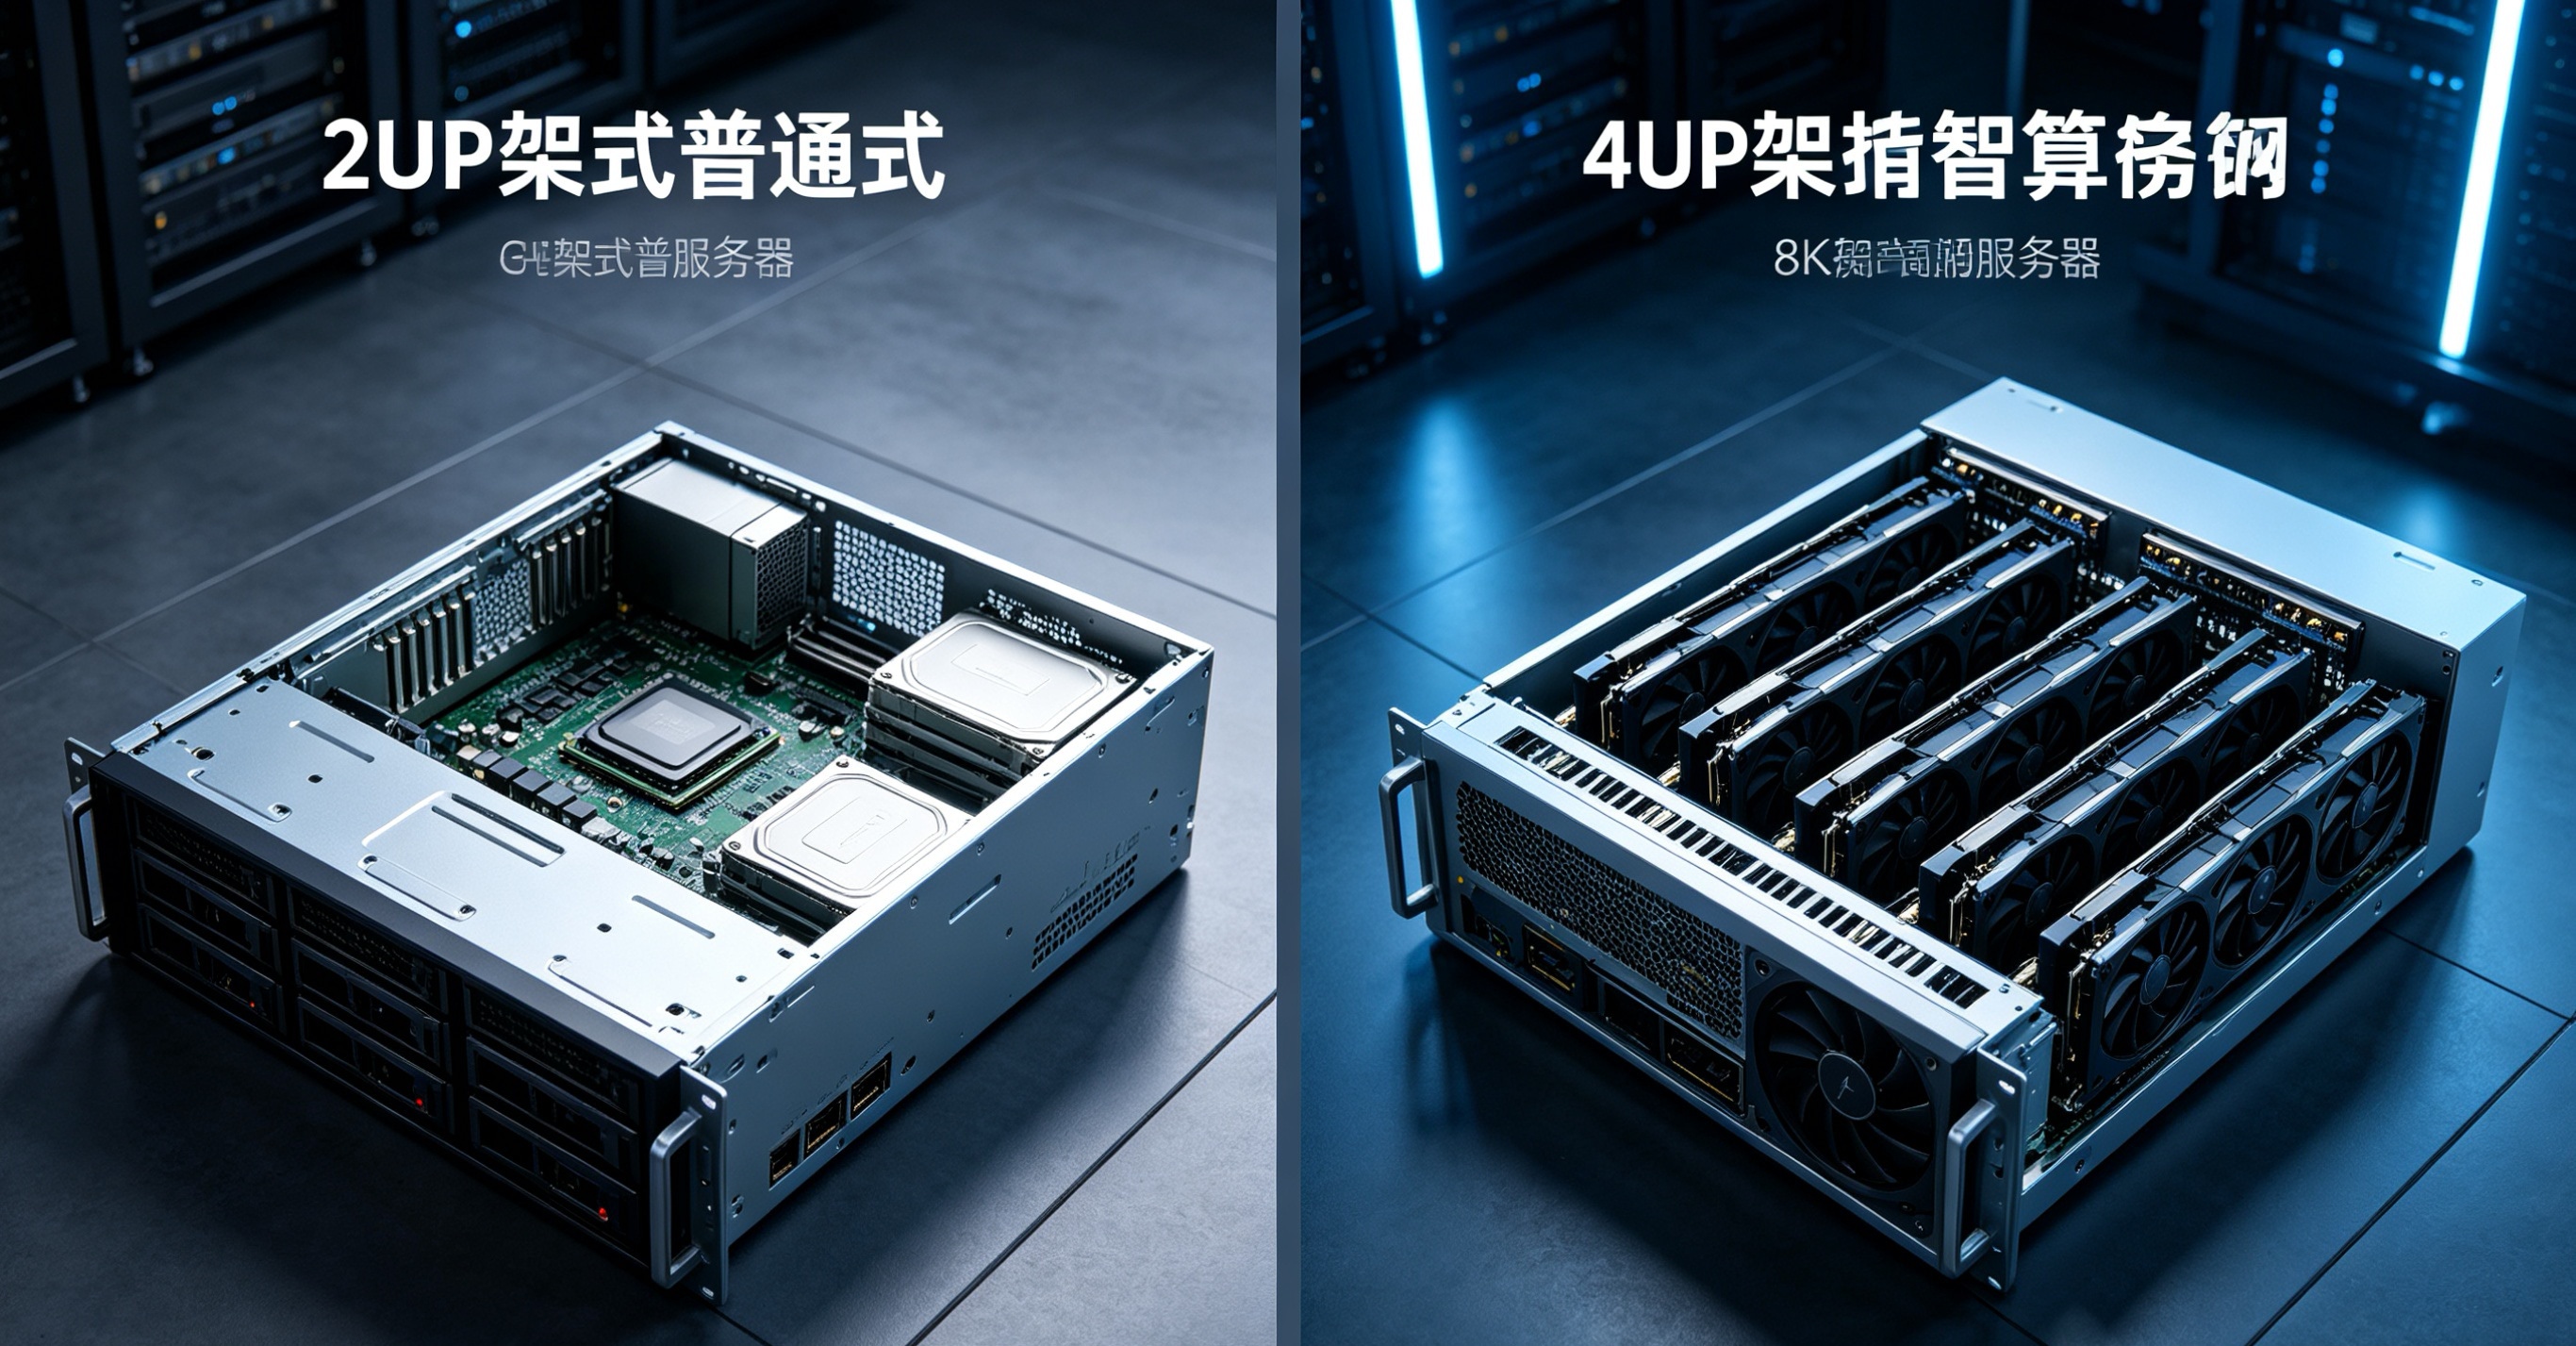
在智算服务器中,角色彻底反转:GPU是算力核心,CPU退居“Host(宿主)”,主要负责将数据喂给GPU、调度任务、管理操作系统和网络。很多人以为“服务器就是大号电脑”,但在智算时代,这个认知会让你在方案、采购、交付上连续踩坑。· 互联:数十甚至上百张卡需协同工作,依赖NVLink(英伟达)、HCCS(华为)等高速总线实现卡间互联。· 8×B200服务器(DGX B200):约14.3 kW(≈通
BF16的指数范围跟FP32对齐,虽然尾数少,但数值稳定性极强,几乎不会溢出,也不需要额外缩放。FP8分E4M3和E5M2两种标准,速度是FP16的2到4倍,显存占用只有FP16的四分之一。FP16的速度是FP32的4到8倍,显存也减半,但容易出现数值溢出。在V100那个年代,它是模型训练的主力,但训练大模型时必须配合Loss Scaling来防止梯度爆炸,用起来比较折腾。精度后缀才是关键,同样的

BF16的指数范围跟FP32对齐,虽然尾数少,但数值稳定性极强,几乎不会溢出,也不需要额外缩放。FP8分E4M3和E5M2两种标准,速度是FP16的2到4倍,显存占用只有FP16的四分之一。FP16的速度是FP32的4到8倍,显存也减半,但容易出现数值溢出。在V100那个年代,它是模型训练的主力,但训练大模型时必须配合Loss Scaling来防止梯度爆炸,用起来比较折腾。精度后缀才是关键,同样的
生活领域包括MiniMax星野(生活陪伴)、HeyQ(家庭组织)、Ohai!腾讯CodeBuddy(AI对话/代码补全/MCP Server,支持200+语言)、智谱ZCode(轻量级AI代码编辑)、字节Trae(自主代码库探索与终端命令)、百度Comate(多模态全栈自动编程)、商汤小浣熊(需求分析到测试全流程)、华为云CodeArts(Agent Space/Agentic DevOps)、智
生活领域包括MiniMax星野(生活陪伴)、HeyQ(家庭组织)、Ohai!腾讯CodeBuddy(AI对话/代码补全/MCP Server,支持200+语言)、智谱ZCode(轻量级AI代码编辑)、字节Trae(自主代码库探索与终端命令)、百度Comate(多模态全栈自动编程)、商汤小浣熊(需求分析到测试全流程)、华为云CodeArts(Agent Space/Agentic DevOps)、智