- @2501_93430156


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
具身智能是一个广阔且充满活力的交叉学科领域。它不仅是算法的竞技场,也是系统工程、硬件设计与认知科学的交汇点。VLA和RL/IL是两个核心切入点,前者更前沿,后者更扎实。最重要的是,具身智能的研究并非必须依赖昂贵的硬件。利用开源的仿真环境、公开数据集和代码框架,在纯软件层面同样可以开展极具深度的研究。希望这份梳理能帮助你拨开迷雾,找到属于自己的那条研究路径,共同见证这场AI与物理世界融合的浪潮。
AI圈的"转会地震"比想象中更劲爆!继体育圈的转会乌龙闹剧后,学术与产业双界传来重磅消息——从定义计算机视觉的"数据基石"到开辟具身智能的"产业航道",这位手握多个"奠基级成果"的狠人,若真落地复旦,是否会重塑中国AI从实验室到产业的竞争格局?让我们深扒这位顶流学者的成长轨迹与时代布局。
从仿真到真机,从零散测试到大规模标准化基准,RoboChallenge不仅为算法提供了“真实考场”,更打破了资源壁垒,让创新机会流向每一位研究者。无论是高校团队验证理论,还是企业优化落地算法,都能在此找到公平、可靠的评测方案。官网:https://robochallenge.ai论文:https://robochallenge.ai/robochallenge_techreport.pdf。

CoRL 2025(Conference on Robot Learning 2025)作为聚焦机器人与机器学习交叉领域的旗舰会议,近日于 2025 年 9 月 27 日至 30 日在韩国首尔 COEX 会展中心举办CoRL与同馆联办形成 “机器人学习 + 人形机器人” 的交流场景,会议主题涵盖操作、感知、规划与安全、运动控制、人形机器人与硬件等方向,9 月 27 日为工作坊,28 日至 30 日
ENACT将VLMs的具身认知评估转化为第一视角交互下的世界建模问题核心空间定义状态空间sss:元素为从模拟器底层状态GGG提取的符号场景图,场景图以“节点(物体/主体,如On(fridge))-边(关系,如OnTop(pen, desk))”结构表征场景语义;观察空间O⊂RH×W×3O⊂RH×W×3:机器人第一视角的RGB图像,记录环境视觉信息;动作空间AAA:元素为场景图差异atδstst−1

在,多篇直指当前该方向的核心落地瓶颈:大语言模型(LLM)驱动的code-as-policies策略,在动态/部分可观测场景中因环境接地不足,任务成功率难以保障;现有具身世界模型缺乏物理感知,无法精准建模3D几何与运动动力学,导致生成内容脱离实际场景约束;Transformer基具身策略处理长时任务时,视觉输入易超出上下文限制,记忆效率与泛化性不足;多模态大语言模型(MLLM)的具身智能体,还存在

10万小时人类数据,听起来是苦功夫。但技术突破,往往就藏在这些"笨办法"里。灵初智能这次的登顶,不是运气,是对"数据价值"这个命题的一次硬核回答。注:Molmo Spaces是具身智能领域的重要基准测试,评估机器人在真实物理空间中的操作能力。
AlphaBrain Platform 的开源,标志着具身智能开发从“重复造轮子”转向“标准化集成”。开发者现在可以通过该平台,以极低的硬件需求(支持消费级显卡)和几行配置代码,实现前沿技术的快速复现与场景落地。智平方希望通过打破技术围墙,与开发者共同推动机器人行业的深层次突破。更有完整版复现技术资料,需要的可以点击链接哦!

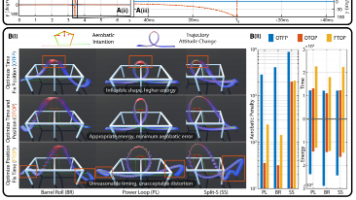
传统上,高难度的无人机特技飞行(Aerobatic flight)被视为顶尖人类飞手的专属领域。然而,近期发表于《科学·机器人学》(Science Robotics)的一篇论文,为实现无人机全自主、高机动性特技飞行提供了突破性框架。该研究由浙江大学高飞教授团队主导,提出了一套完整的自主系统,使无人机能够在障碍物密布的复杂环境中,自主生成并执行专业飞手级别的复杂特技动作组合。
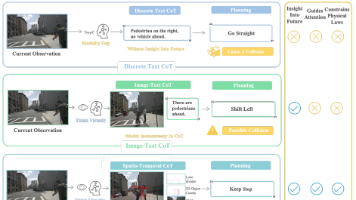
然而,当前的视觉语言模型大多采用为特定场景设计的离散文本“思维链”(Chain-of-Thought, CoT),这种方式本质上是对视觉信息的高度抽象和符号化压缩,可能导致时空关系的模糊和细粒度信息的丢失。大量的实验结果表明,FSDrive在轨迹规划、未来帧生成和场景理解等多个任务上均取得了优异的性能,展现了其在推动自动驾驶技术向更高阶的视觉推理迈进方面的巨大潜力。模型的决策不仅基于当前的视觉输入