- @2501_92747450


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
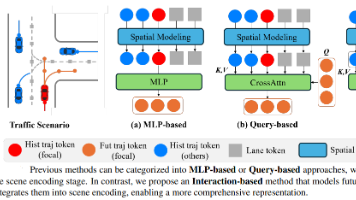
本文提出了一种高效的未来感知交互网络(FINet),这是一种基于交互的运动预测方法。该网络先提前建模未来轨迹并将其整合到场景编码中,实现所有元素的相互感知,以学习全面的交通表示,从而实现准确且优化的轨迹预测;同时融入状态空间模型(SSM)中的Mamba进行时空建模,并通过自适应重排策略将无序数据转换为结构化序列以适配Mamba的空间交互建模,还利用Mamba对生成的未来轨迹进行时间细化,确保预测的
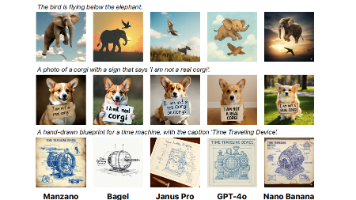
本文的研究目标是解决统一多模态模型中图像理解与生成能力之间的性能冲突。具体问题是,现有的视觉分词策略(连续嵌入用于理解,离散令牌用于生成)导致LLM内部产生任务冲突,影响模型整体性能。为解决此问题,论文提出了 Manzano 模型,其核心技术贡献是设计了一个混合图像分词器。该分词器使用一个共享的视觉编码器,派生出两个适配器:一个连续适配器为理解任务生成连续嵌入,一个离散适配器为生成任务提供离散令牌
此外,模型的性能在多大程度上依赖于所选的小波基函数,以及原型数量的设置,也是未来可以深入研究的方向。例如,在ESDIs-SOD数据集上,相比于同样是基于查询的先进方法PEM,本文方法在平均绝对误差(M)上降低了13.6%,在加权F-measure(上图(图4)的F-measure曲线显示,在绝大多数阈值下,本文方法的曲线都位于其他方法的上方,表明其在各种置信度下都能保持稳健和优越的性能。在空间域,

此外,对于水下生物多样性的挑战,未来可以尝试将零样本学习(zero-shot learning)或小样本学习(few-shot learning)能力融入模型,使其在面对未知物种时也能做出合理的识别和描述,这对于真正的海洋探索应用至关重要。例如,在低光和浑浊场景下,NAUTILUS (LLaVA-1.5) 的性能提升分别高达7.5和8.1 PR@0.5,充分证明了其在复杂多变的水下环境中的强大适应

AAAI人工智能会议(AAAI Conference on Artificial Intelligence)是人工智能领域的重要国际会议,是CCF-A类推荐会议。AAAI2026将于2026年1月20日-27日在新加坡举办。今年共有23680篇论文投稿,最终4167篇论文接收,录用率17.6%。目前部分论文已公开,小编精选十几篇CV方向论文,希望对大家有所帮助,有需要自取即可。
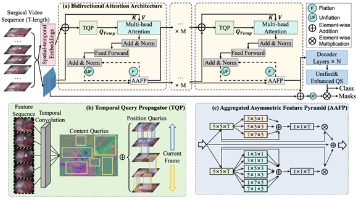
本文介绍了两项基于特征金字塔网络(FPN)改进的目标检测与分割研究。第一项针对手术场景分割,提出时序非对称特征金字塔(TAFPNet),通过双向注意力机制和时序查询传播器解决器械快速移动问题。第二项针对航拍小目标检测,提出跨层特征金字塔Transformer(CFPT),采用跨层注意力交互避免特征丢失。两项研究均通过特定场景下的结构创新,在保持计算效率的同时显著提升性能。研究突出了FPN改进的关键
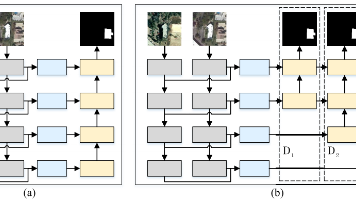
【摘要】本文提出TDNet,一种用于遥感变化检测的新型网络架构,针对传统孪生编码器-单解码器结构存在的多尺度特征交互不足问题,创新性地设计了双向LSTM门控交互模块(BLMIM)和三重解码器结构。通过LSTM门控机制实现跨尺度特征的双向信息传递,结合级联式三重解码器逐步精炼特征,显著提升了变化检测精度。在LEVIR-CD、CDD和WHU-CD三个基准数据集上的实验表明,TDNet相比现有方法F1分
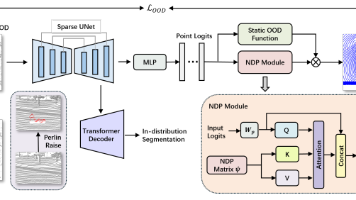
本文提出神经分布先验(NDP)框架,解决LiDAR感知中类别不平衡导致的OOD检测难题。通过可学习的注意力模块动态校准OOD分数,结合Perlin噪声合成OOD样本和软性离群点暴露训练策略,在STU数据集上AP提升超10倍。核心创新在于利用神经网络学习预测分布结构,自适应调整置信度偏差,显著提升自动驾驶场景对未知物体的识别能力。
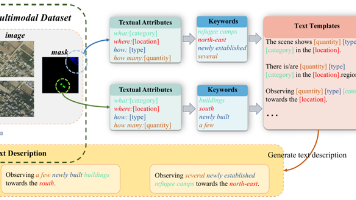
本文提出了一种新颖的遥感变化检测方法S2M,通过从现有掩码标签中自动提取结构化文本信息(位置、类别、类型、数量),实现零成本的多模态监督。该方法采用两阶段训练策略,结合视觉骨干网络和文本引导对齐模块,有效解决了语义模糊性问题。实验表明,S2M在多个数据集上显著优于基线模型,特别是减少了微小目标的漏检。该方法的创新点在于挖掘现有数据的隐含价值,无需额外标注或大模型支持,为资源受限场景提供了高效解决方
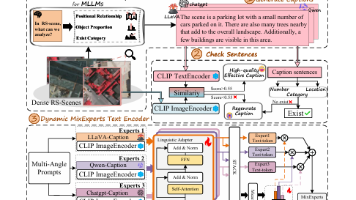
本文提出了一种创新的遥感图像语义分割方法,通过多模态大语言模型生成高质量文本描述来提升分割精度。研究团队设计了动态混合专家文本编码器(DMTE),利用三种不同视角的提示词引导多个MLLM生成多样化描述,并通过门控机制自适应筛选最优文本特征。结合语言查询引导注意力(LQGA)模块,该方法实现了文本语义对视觉特征的有效引导。实验表明,在多个遥感数据集上,该模型在mIoU和mF1指标上均显著优于现有方法