
【有源码】基于Spark的生成式AI用户行为分析与算力异常检测研究,基于大数据的生成式AI用户行为与算力消耗可视化分析平台
·
项目简介
本项目面向生成式 AI SaaS 场景,基于 Hadoop 与 Spark 构建了一套从数据上传、清洗预处理到多维统计分析与可视化支撑的大数据平台,围绕用户套餐、近30天活跃天数、平均会话时长、提示词数量、输入输出 Token、重新生成率、采纳输出率、点赞点踩、配额使用率和付费墙触发次数等核心指标,深入分析用户行为与算力消耗特征,并通过聚类分析、关联规则挖掘和异常检测识别典型用户画像、行为模式与异常算力消耗,最终输出结构化分析结果,为产品运营、套餐优化和算力资源管理提供数据依据。
核心亮点
- 全流程大数据处理:覆盖数据上传、分布式存储、字段清洗、统计分析与结果输出,形成完整的数据分析链路。
- 多维用户行为洞察:从套餐、活跃度、会话时长、提示词、Token 消耗、反馈互动、配额压力和付费墙触发等多个维度刻画用户行为。
- 智能算法融合:结合聚类分析、关联规则挖掘和异常检测,发现用户分群、行为模式和异常算力消耗。
- 算力消耗关联分析:将输入输出 Token 与套餐、配额使用率、付费墙触发等指标联动分析,辅助算力资源优化。
- 结果结构化输出:各类分析结果统一输出为结构化文件,便于后续可视化大屏、报表展示和运营决策。
- 流程可复现可扩展:分析参数固定、流程清晰,便于复现实验结果,也方便后续扩展新的指标与算法。
系统功能
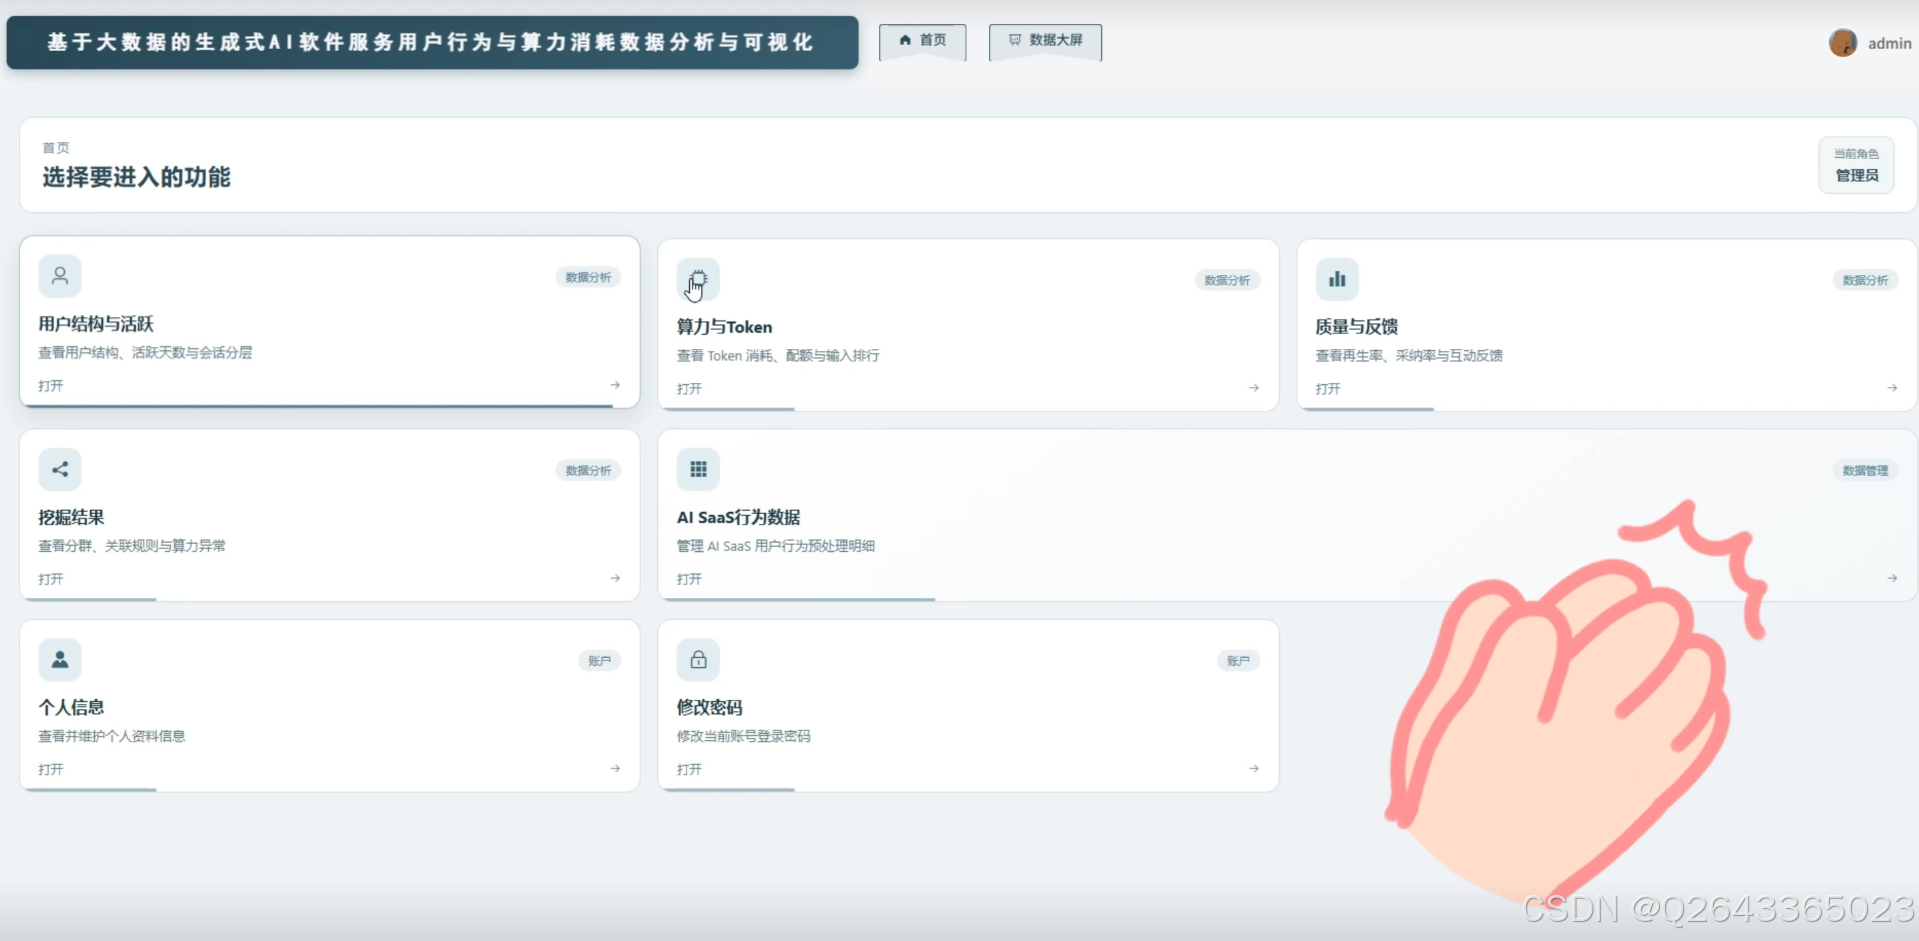
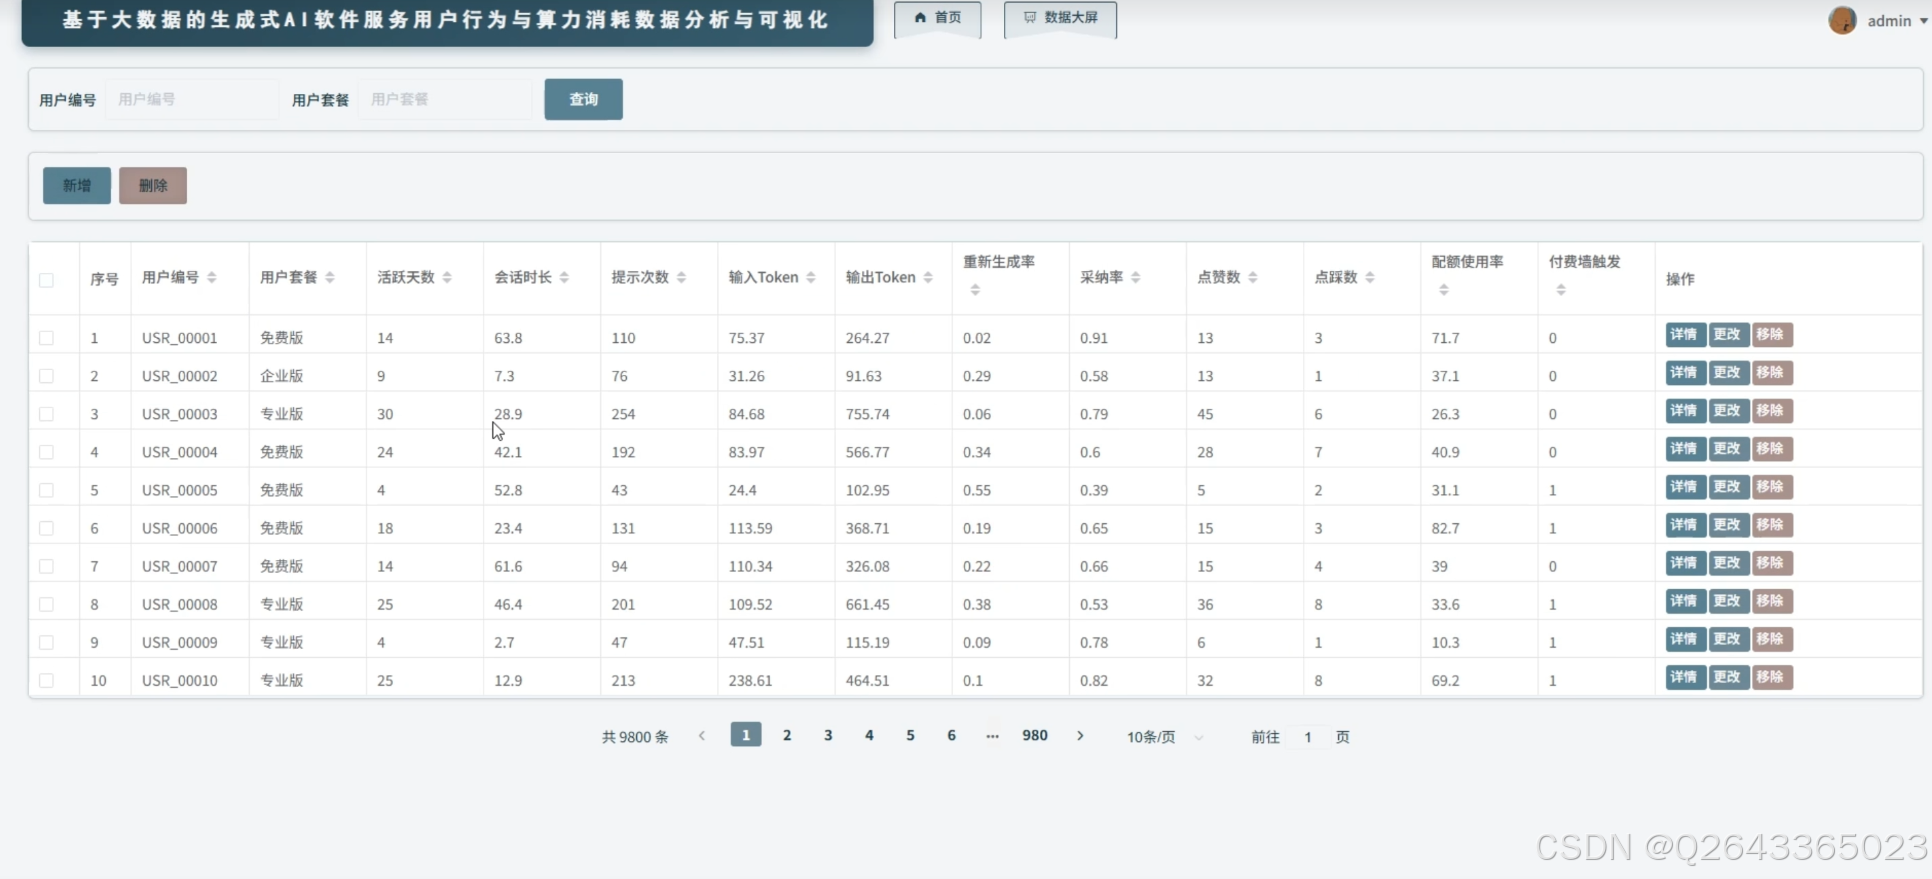
- 数据上传与分布式存储:将原始用户行为数据上传至分布式文件系统,并按项目目录统一管理。
- 数据清洗与字段标准化:处理缺失值与空串,统一字段命名,规范数值精度和类别映射。
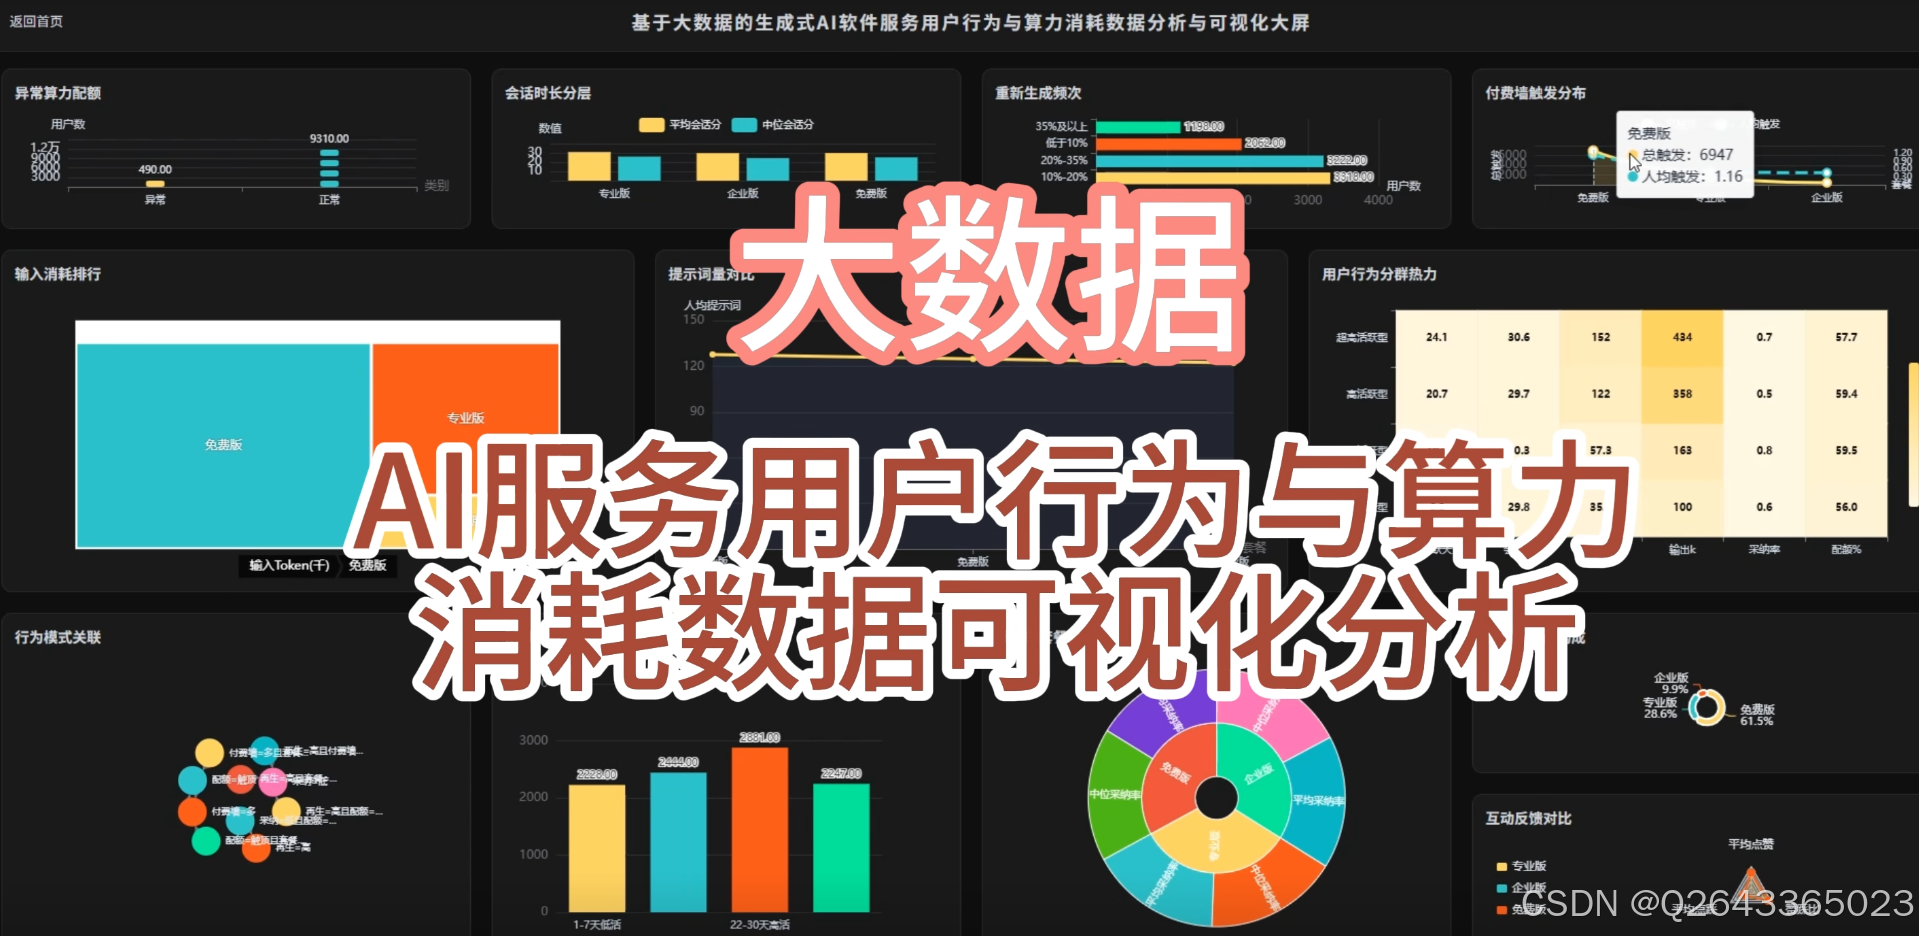
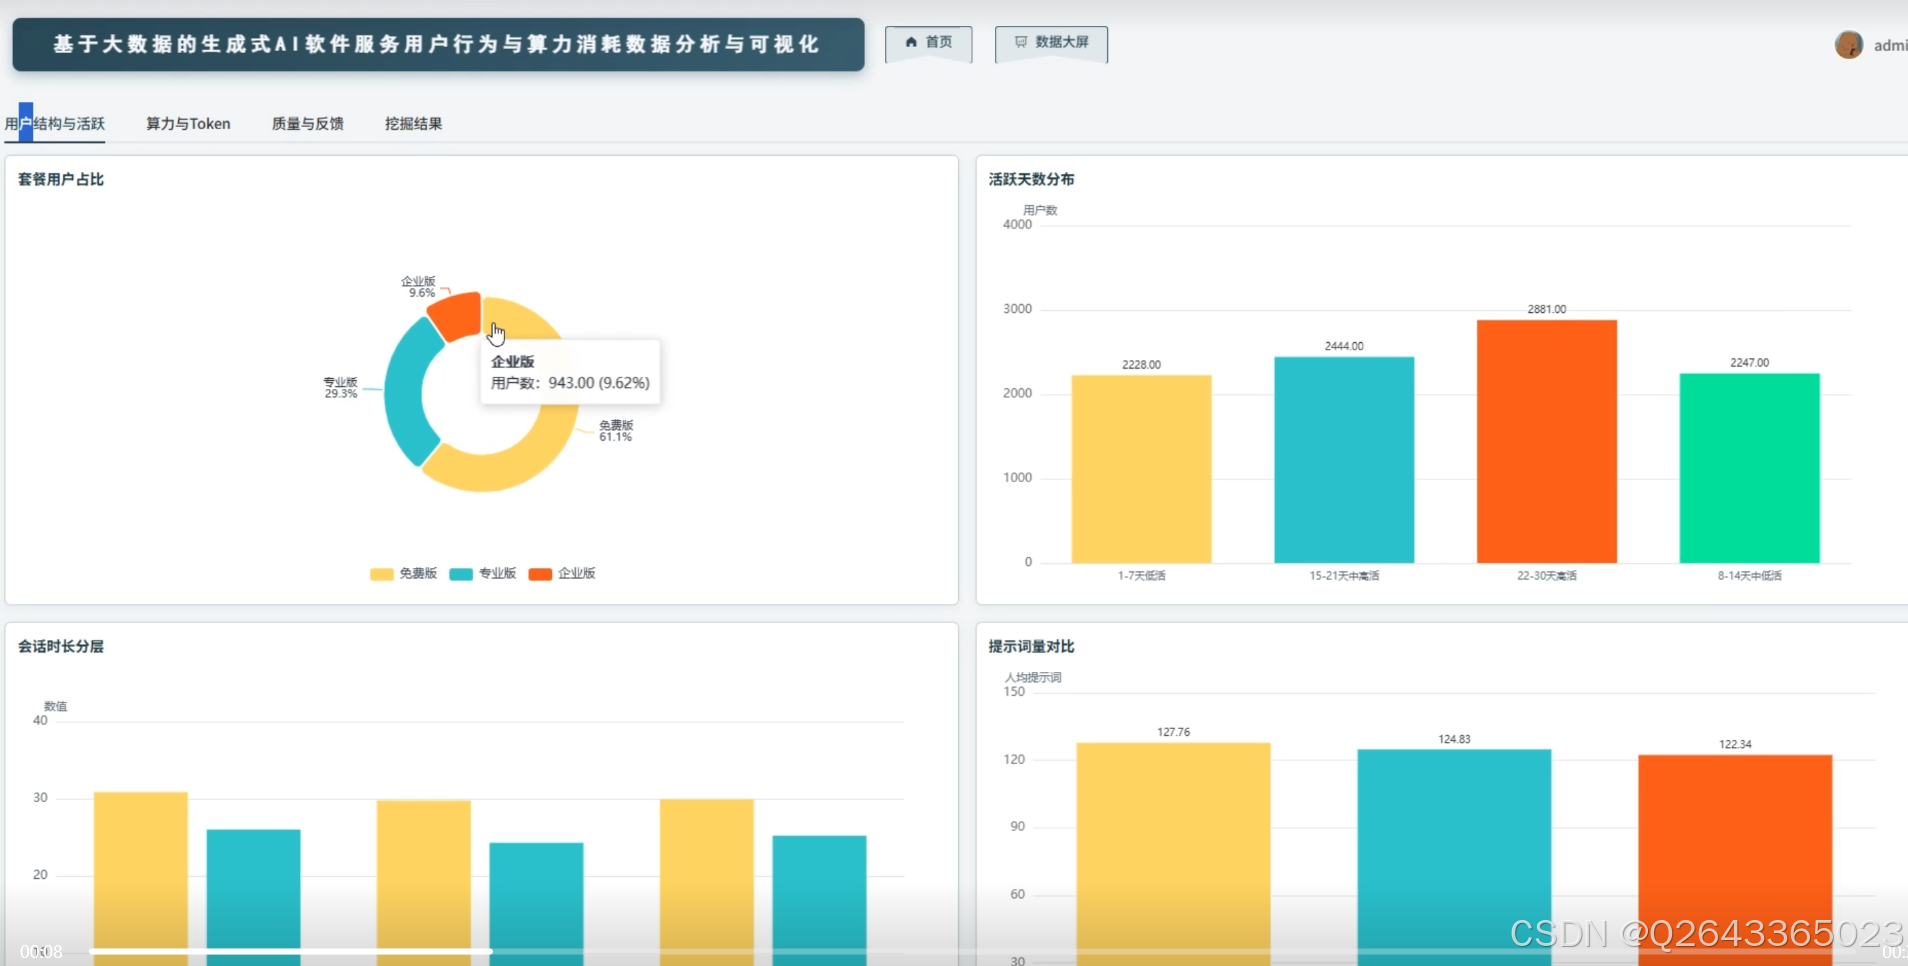
- 套餐用户规模与占比分析:统计不同订阅套餐的用户数量及占比。
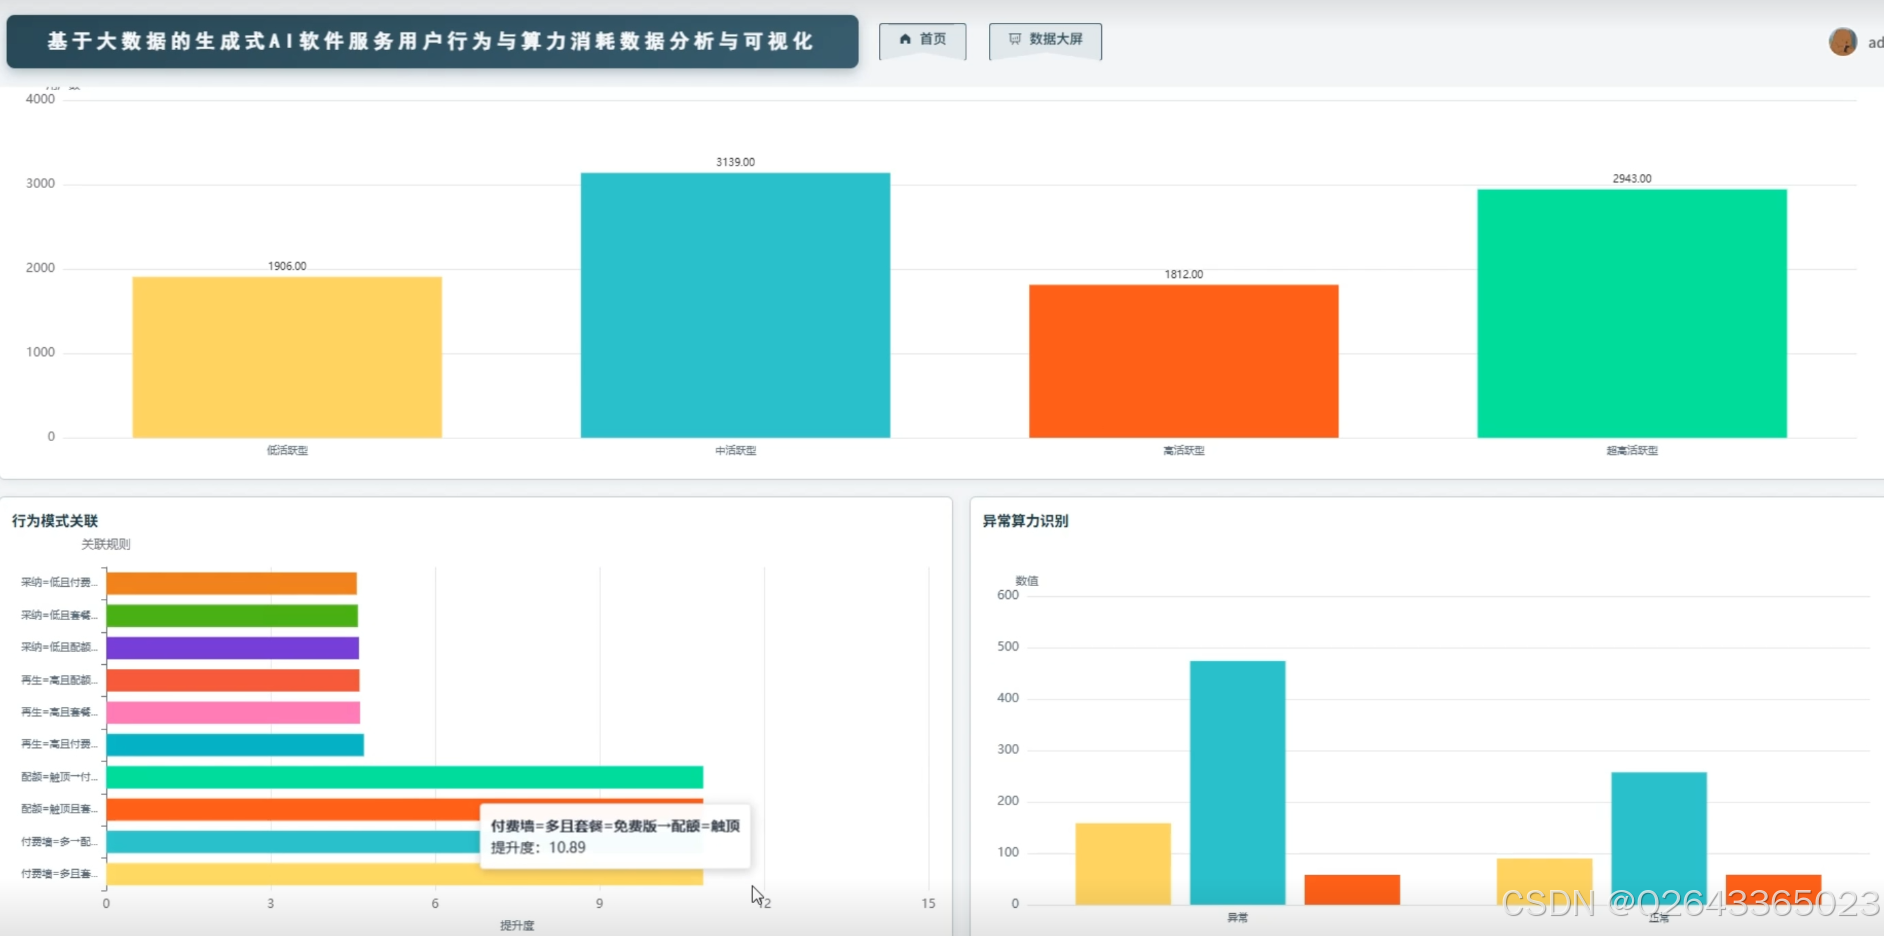
- 活跃天数分布分析:按活跃天数分箱,观察低活、中活和高活用户分布。
- 会话时长分层分析:对比不同套餐用户的平均会话时长与中位会话时长。
- 提示词数量对比分析:统计各套餐提示词总量与人均提示词数量。
- 输入 Token 排行分析:按套餐汇总输入 Token,并按人均消耗降序排列。
- 输出 Token 构成分析:分析各套餐输出 Token 总量及占比。
- 输入输出 Token 比率分析:计算输出与输入 Token 的倍率关系。
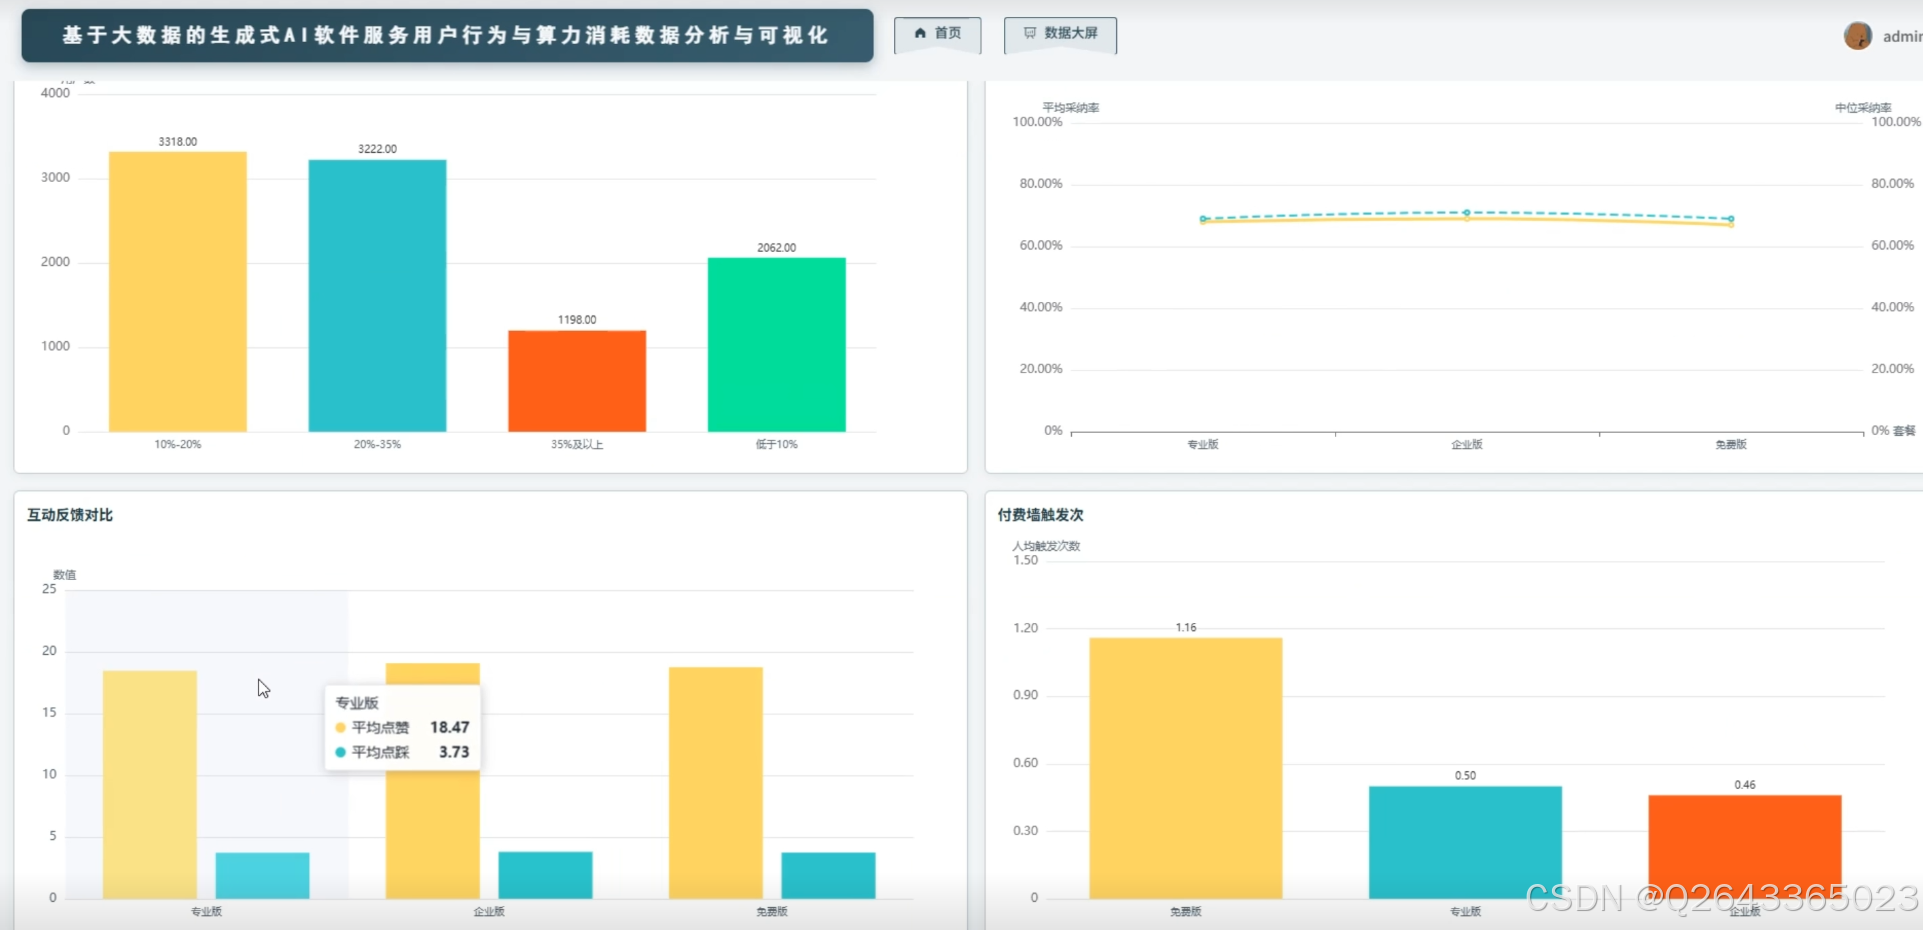
- 重新生成率分布分析:按重新生成率分箱,识别用户对生成结果的再生成行为。
- 采纳输出率分析:对比各套餐采纳输出率的均值与中位数。
- 点赞点踩反馈分析:统计各套餐点赞、点踩均值及赞踩比。
- 配额使用分层分析:按配额使用率划分低压力、中压力、高压力和触顶用户。
- 付费墙触发分析:统计各套餐付费墙触发总量与人均触发次数。
- 用户行为聚类画像:基于多维行为特征进行用户分群,生成典型用户画像。
- 行为模式关联规则挖掘:挖掘套餐、活跃、配额、体验和付费墙之间的关联关系。
- 异常算力消耗识别:识别异常 Token 消耗用户,辅助算力风险监控。
- 分析结果输出与可视化支撑:输出结构化分析文件,为可视化展示提供数据基础。
技术环境
| 类别 | 技术/工具 | 说明 |
|---|---|---|
| 分布式存储 | Hadoop HDFS | 存储原始数据与预处理结果 |
| 分布式计算 | Spark | 大规模用户行为数据统计分析 |
| 开发语言 | Python | 数据处理、分析与算法实现 |
| 数据处理 | Pandas、NumPy | 本地数据清洗与数值计算 |
| 机器学习 | Scikit-learn | 异常检测与模型计算 |
| 核心算法 | 聚类分析、关联规则、孤立森林 | 用户分群、模式挖掘、异常识别 |
| 运行环境 | 本地伪分布式 | Hadoop 与 Spark 协同运行 |
| 输出形式 | CSV | 分析结果结构化输出 |
项目展示
基于Spark生成式AI软件服务用户行为与算力消耗数据分析
更多推荐

 2
 0
- 0


 已为社区贡献28条内容

所有评论(0)