
Day6_02_k8S与Prometheus
k8s与Prometheus
课程目标
-
掌握Prometheus的监控原理
-
完成Prometheus的搭建
-
完成Prometheus对k8s资源的监控
课程实验
-
k8s集群监控Prometheus的使用实验
课堂引入
-
k8s集群涉及到大量的资源,我们需要掌握资源的使用情况,那就必须对资源进行监控
授课进程
一、概述
1、概述
Prometheus是一个开源的系统监控和警报工具包,自2012成立以来,许多公司和组织采用了Prometheus。它现在是一个独立的开源项目,并独立于任何公司维护。在2016年,Prometheus加入云计算基金会作为Kubernetes之后的第二托管项目。Prometheus性能也足够支撑上万台规模的集群。
官网地址:http://www.prometheus-fund.com/ githup地址:https://github.com/prometheus
2、特性
整个Prometheus生态包含多个组件,除了Prometheus server组件其余都是可选的:
-
Prometheus Server:主要的核心组件,用来收集和存储时间序列数据
-
Client Library::客户端库,为需要监控的服务生成相应的 metrics 并暴露给 Prometheus server。当 Prometheus server 来 pull 时,直接返回实时状态的 metrics
-
push gateway:主要用于短期的 jobs。由于这类 jobs 存在时间较短,可能在 Prometheus 来 pull 之前就消失了。为此,这次 jobs 可以直接向 Prometheus server 端推送它们的 metrics。这种方式主要用于服务层面的 metrics,对于机器层面的 metrices,需要使用 node exporter
-
Exporters: 用于暴露已有的第三方服务的 metrics 给 Prometheus
-
Alertmanager: 从 Prometheus server 端接收到 alerts 后,会进行去除重复数据,分组,并路由到对收的接受方式,发出报警。常见的接收方式有:电子邮件,pagerduty,OpsGenie, webhook 等
组件说明:
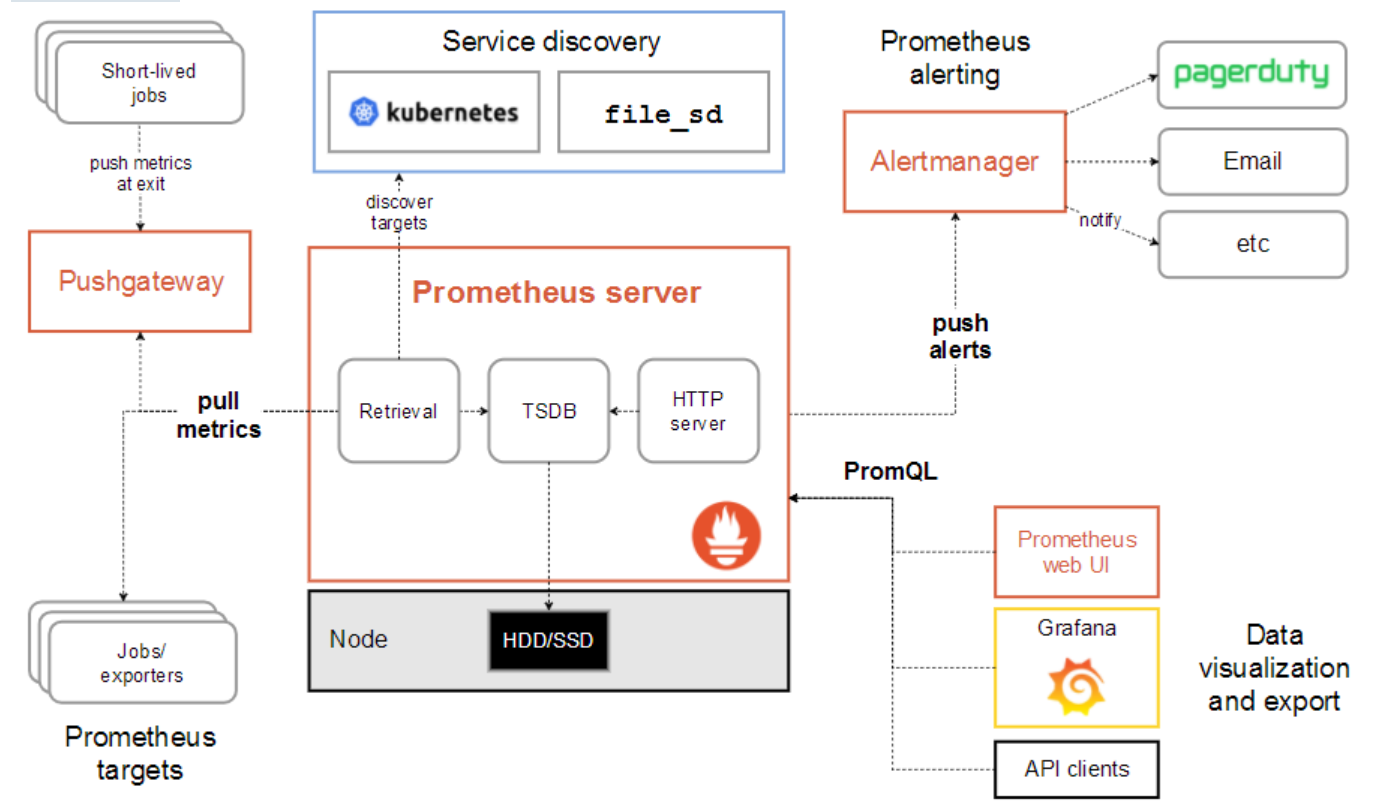
(1)Prometheus server:服务核心组件,采用 pull 方式收集 apiserver、scheduler、controller-manager、kubelet 组件数据, 通过 http 协议传输。并存储时间序列数据。
(2)Exporters/Jobs:负责收集不支持Instrumentation的目标对象(host, container…)的性能数据,并通过 HTTP 接口供 Prometheus Server 获取。
●Node-Exporter:用于收集k8s集群中各node节点的物理指标状态数据,如平均负载、CPU、内存、磁盘、网络等资源信息的指标数据,需要部署到所有运算节点。
●Kube-State-Metrics:为prometheus采集k8s资源数据的exporter,通过监听APIServer收集kubernetes集群内资源对象的状态指标数据,例如pod、deployment、service等等。同时它也提供自己的数据,主要是资源采集个数和采集发生的异常次数统计。
需要注意的是kube-state-metrics只是简单的提供一个metrics数据,并不会存储这些指标数据,所以可以使用Prometheus来抓取这些数据然后存储,主要关注的是业务相关的一些元数据,比如Deployment、Pod、副本状态等;调度了多少个replicas?现在可用的有几个?多少个Pod是running/stopped/terminated状态?Pod重启了多少次?有多少job在运行中。
●cadvisor:用来监控容器内部使用资源的信息,比如 CPU、内存、网络I/O、磁盘I/O。
●blackbox-exporter:监控业务容器存活性。
(3)Service Discovery:服务发现,Prometheus支持多种服务发现机制:文件,DNS,Consul,Kubernetes,OpenStack,EC2等等。 基于服务发现的过程并不复杂,通过第三方提供的接口,Prometheus查询到需要监控的Target列表,然后轮训这些Target获取监控数据。
(4)Alertmanager:是一个独立的告警模块,从 Prometheus server 端接收到 alerts 后,会进行去重、分组, 并路由到相应的接收方,发出报警,常见的接收方式有:电子邮件,微信,钉钉等。
(5)Pushgateway:类似一个中转站,Prometheus 的 server 端只会使用 pull 方式拉取数据,但是某些节点因为某些原因只能使用 push 方式推送数据,那么它就是用来接收 push 而来的数据并暴露给 Prometheus 的 server 拉取的中转站。 可以理解成目标主机可以上报短期任务的数据到 Pushgateway,然后 Prometheus server 统一从 Pushgateway 拉取数据。
(6)Grafana:是一个跨平台的开源的度量分析和可视化工具,可以将采集的数据可视化的展示,并及时通知给告警接收方。其官方库中具有丰富的仪表盘插件。
3、架构及原理
-
基本原理
Prometheus的基本原理是通过HTTP协议周期性抓取被监控组件的状态,任意组件只要提供对应的HTTP接口就可以接入监控。不需要任何SDK或者其他的集成过程。
这样做非常适合做虚拟化环境监控系统,比如VM、Docker、Kubernetes等。输出被监控组件信息的HTTP接口被叫做exporter 。目前互联网公司常用的组件大部分都有exporter可以直接使用,比如Varnish、Haproxy、Nginx、MySQL、Linux系统信息(包括磁盘、内存、CPU、网络等等)。
-
Prometheus三大套件
Server 主要负责数据采集和存储,提供PromQL查询语言的支持。
Alertmanager 警告管理器,用来进行报警。
Push Gateway 支持临时性Job主动推送指标的中间网关。
-
服务过程
Prometheus Daemon负责定时去目标上抓取metrics(指标)数据,每个抓取目标需要暴露一个http服务的接口给它定时抓取。
Prometheus支持通过配置文件、文本文件、Zookeeper、Consul、DNS SRV Lookup等方式指定抓取目标。Prometheus采用PULL的方式进行监控,即服务器可以直接通过目标PULL数据或者间接地通过中间网关来Push数据。
Prometheus在本地存储抓取的所有数据,并通过一定规则进行清理和整理数据,并把得到的结果存储到新的时间序列中。
Prometheus通过PromQL和其他API可视化地展示收集的数据。Prometheus支持很多方式的图表可视化,例如Grafana、自带的Promdash以及自身提供的模版引擎等等。Prometheus还提供HTTP API的查询方式,自定义所需要的输出。
PushGateway支持Client主动推送metrics到PushGateway,而Prometheus只是定时去Gateway上抓取数据。
Alertmanager是独立于Prometheus的一个组件,可以支持Prometheus的查询语句,提供十分灵活的报警方式。
4、版本
K8S和Pormetheus的配套关系:
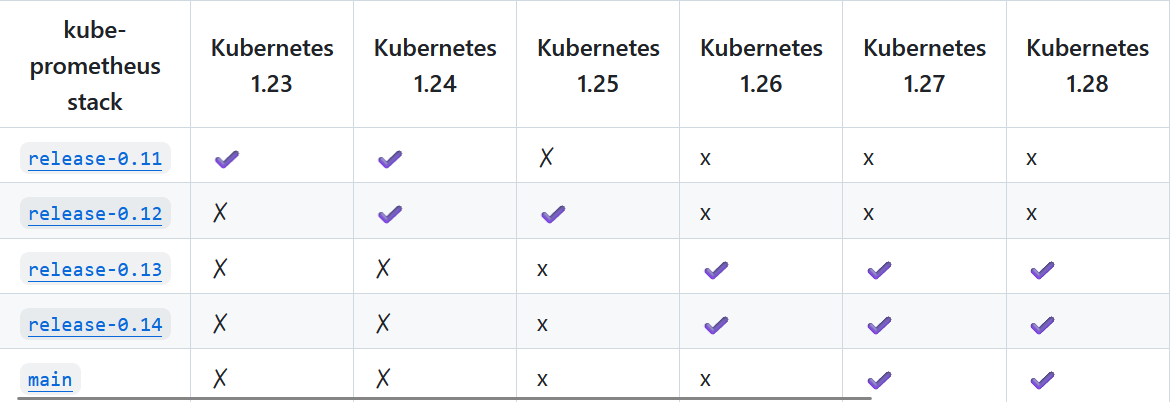
最新的版本配套关系查看kube-prometheus官方仓库:https://github.com/prometheus-operator/kube-prometheus ,可以切换版本查看配套关系。
kube-prometheus 和 kube-prometheus-stack 区别
"kube-prometheus" 和 "kube-prometheus-stack" 本质上是同一个项目,只是在不同的时间和版本中使用了不同的名称。"kube-prometheus-stack" 是 "kube-prometheus" 项目的更新版本,它提供了更多的功能、改进和修复。 最初,项目被称为 "kube-prometheus",但随着时间的推移,项目团队对项目进行了大量的改进和扩展,并将其重命名为 "kube-prometheus-stack",以更好地反映其提供的综合性监控解决方案。 "kube-prometheus-stack"(或简称 "kube-prometheus")是一个在 Kubernetes 集群中部署和管理 Prometheus 监控系统以及相关组件的综合解决方案。它集成了 Prometheus、Grafana、Alertmanager 等一系列组件,还包括预配置的监控规则和仪表盘,以及一键部署功 能。用户可以通过部署 "kube-prometheus-stack" 来快速启动一个全面的 Kubernetes 集群监控系统,无需逐个配置各个组件。 总结起来,"kube-prometheus-stack" 是 "kube-prometheus" 项目的更新版本,提供更多的功能和改进,是一个便捷的综合性监控解决方案,适合在 Kubernetes 环境中快速部署和使用
5、grafana
Grafana是一个开源的度量分析和可视化工具,可以通过将采集的数据分析,查询,然后进行可视化的展示,并能实现报警。
官网地址: https://grafana.com/
6、alertmanager
Alertmanager是一个独立的告警模块,接收Prometheus等客户端发来的警报,之后通过分组、删除重复等处理,并将它们通过路由发送给正确的接收器。Prometheus的警报分为两个部分。Prometheus服务器中的警报规则将警报发送到Alertmanager。该Alertmanager 然后管理这些警报,包括沉默,抑制,聚集和通过的方法,如电子邮件发出通知,对呼叫通知系统,以及即时通讯平台。
官网地址:https://prometheus.io/docs/alerting/latest/alertmanager/
二、安装
1、下载安装文件
# 下载压缩包
wget https://github.com/prometheus-operator/kube-prometheus/archive/refs/tags/v0.11.0.tar.gz
# 创建目录
mkdir prometheus
# 文件拷贝
cp /root/kube-prometheus-0.11.0.tar.gz /root/prometheus/
# 解压缩
cd /root/prometheus/
tar -xf kube-prometheus-0.11.0.tar.gz
2、修改配置
镜像替换:替换为国内镜像地址
# 搜索镜像
grep k8s.gcr.io manifests/*
# 替换镜像
sed -i 's#k8s.gcr.io.*#bitnami/kube-state-metrics:latest#g' manifests/kubeStateMetrics-deployment.yaml
sed -i 's#k8s.gcr.io.*#v5cn/prometheus-adapter:v0.9.1#g' manifests/prometheusAdapter-deployment.yaml
grep quay.io manifests/*

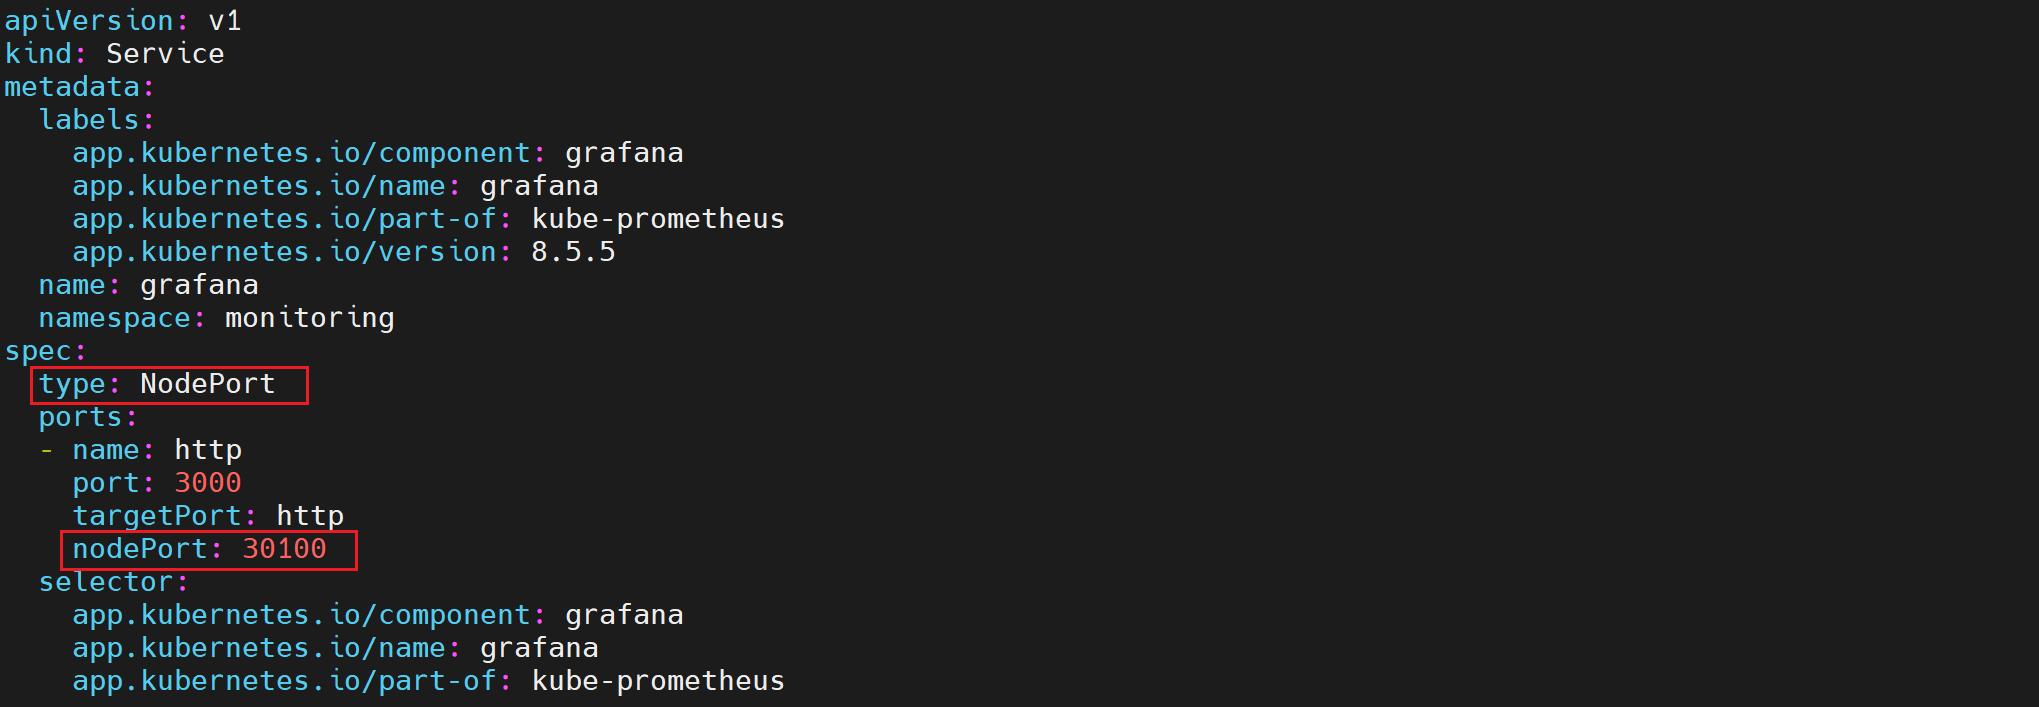
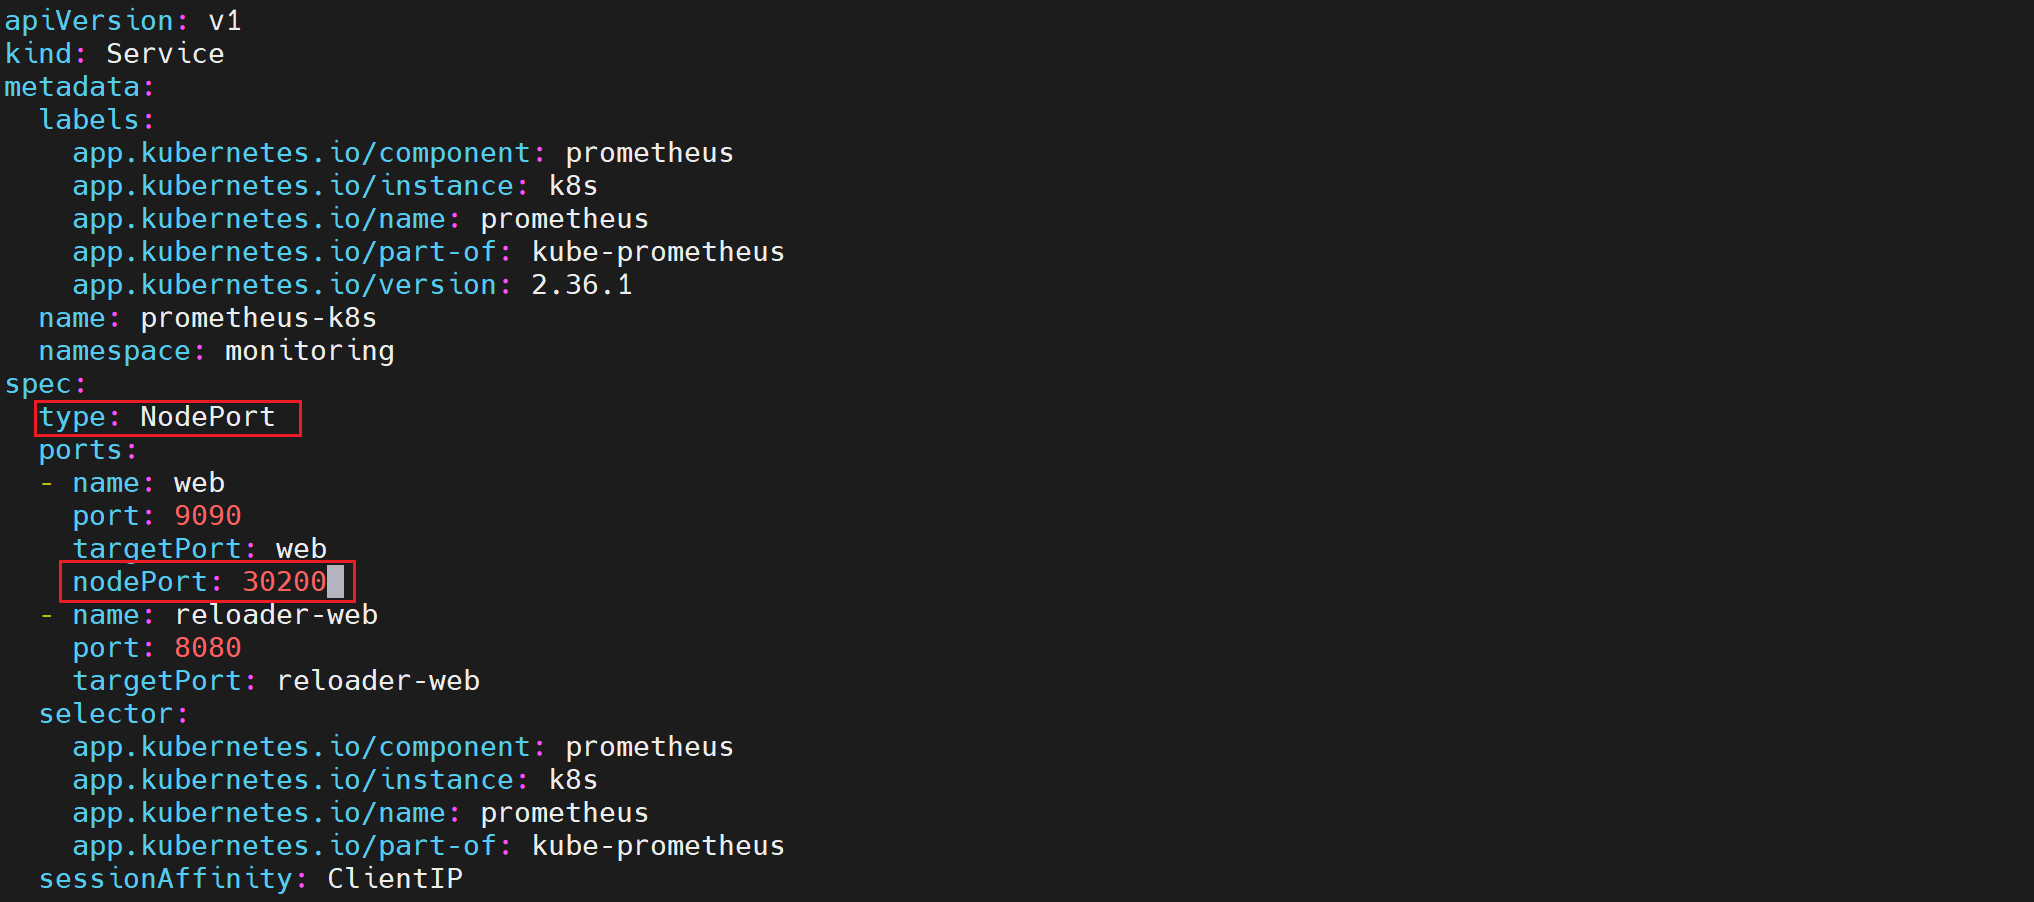
service修改:修改server为nodeport向外暴露服务
vim manifests/grafana-service.yaml
vim manifests/prometheus-service.yaml
3、安装
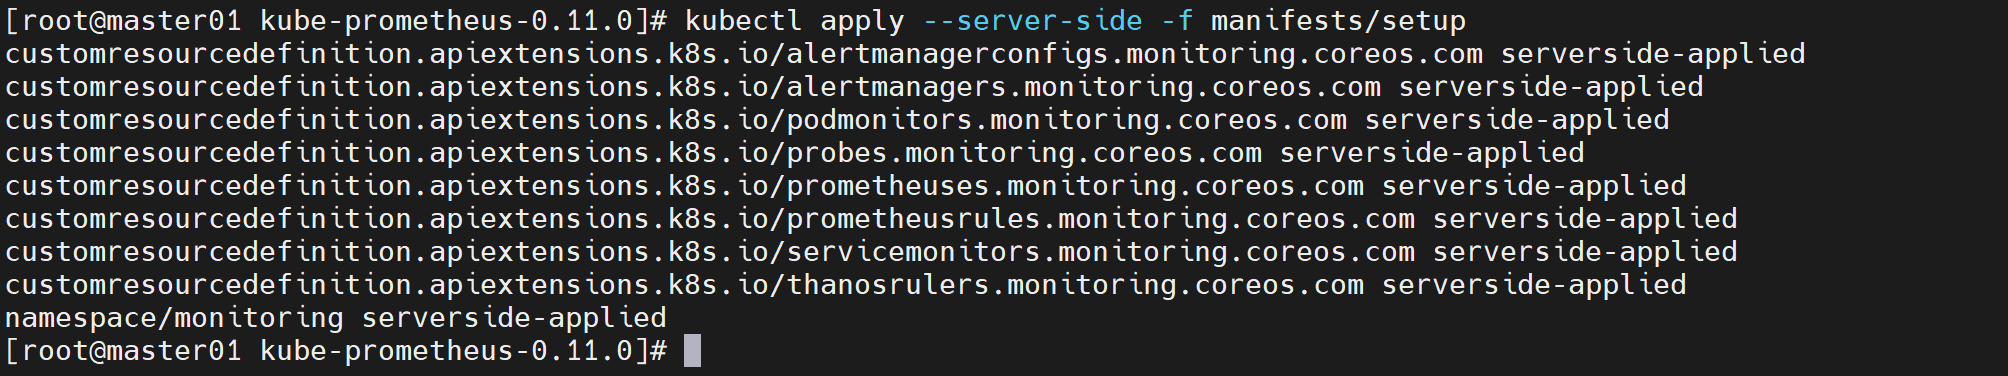
# 环境初始化
kubectl apply --server-side -f manifests/setup
# 检查各资源是否正常安装
kubectl wait --for condition=Established --all CustomResourceDefinition --namespace=monitoring
# 安装Prometheus、Grafana
kubectl apply -f manifests/
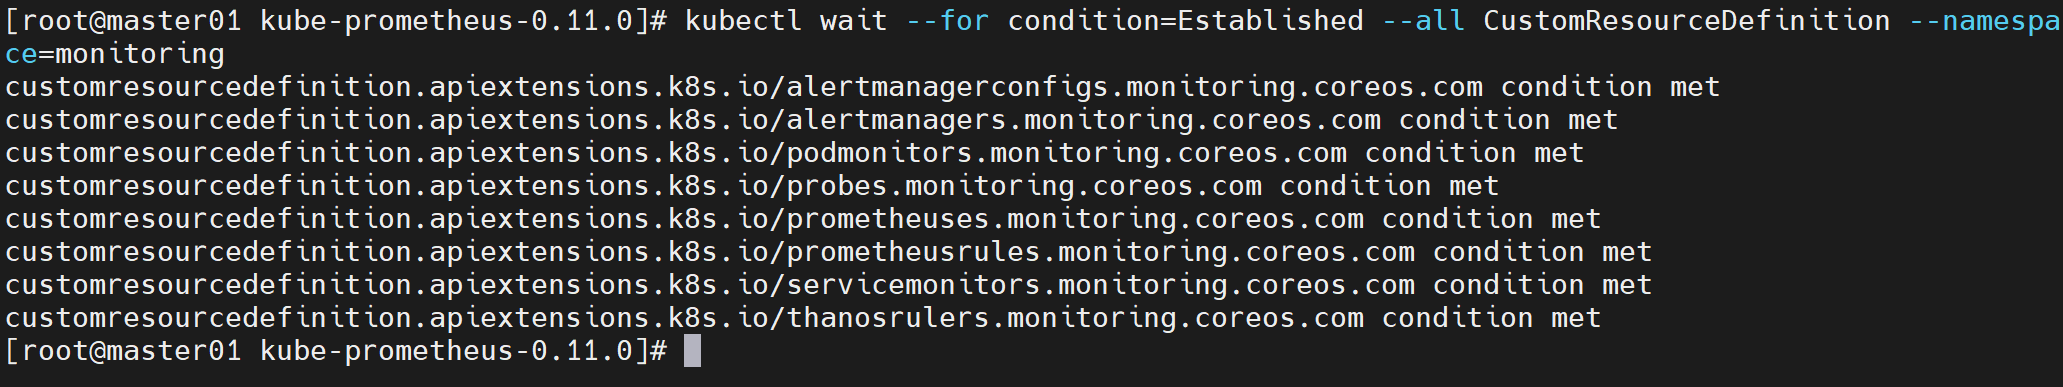
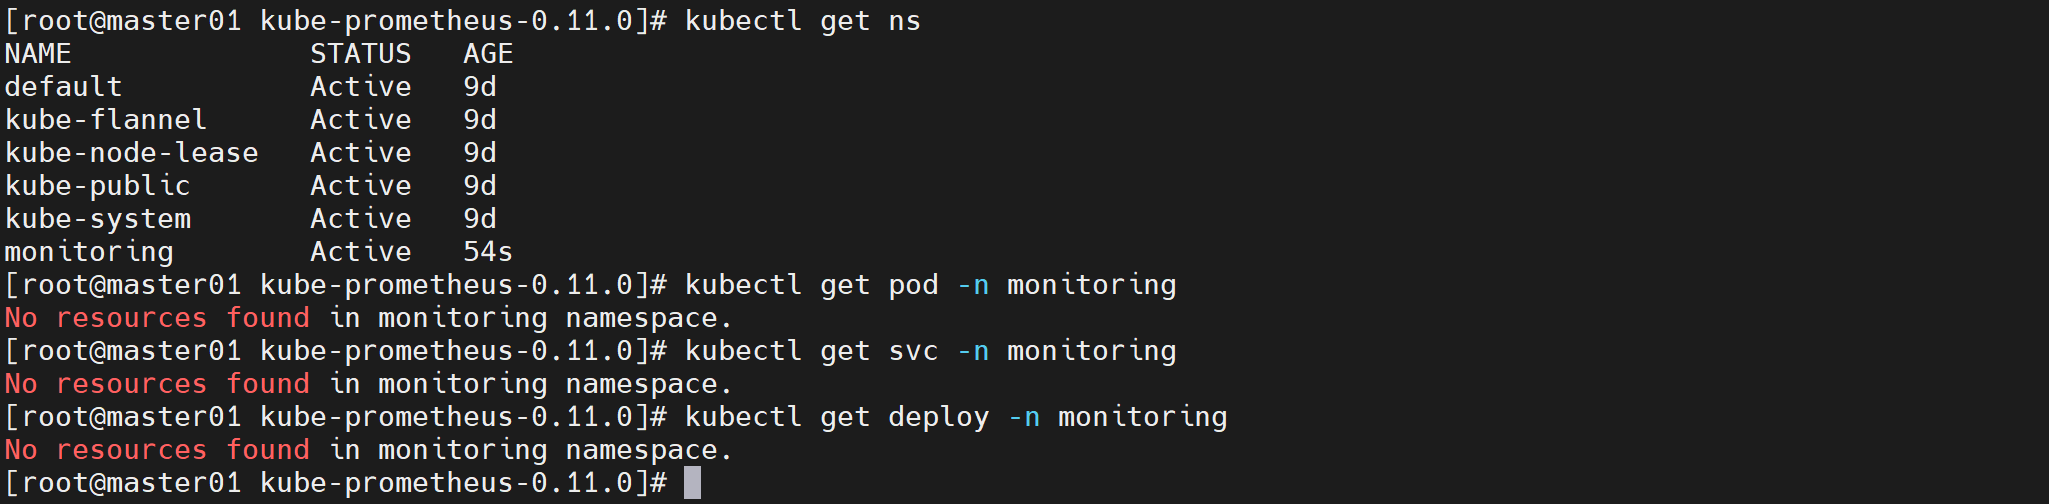
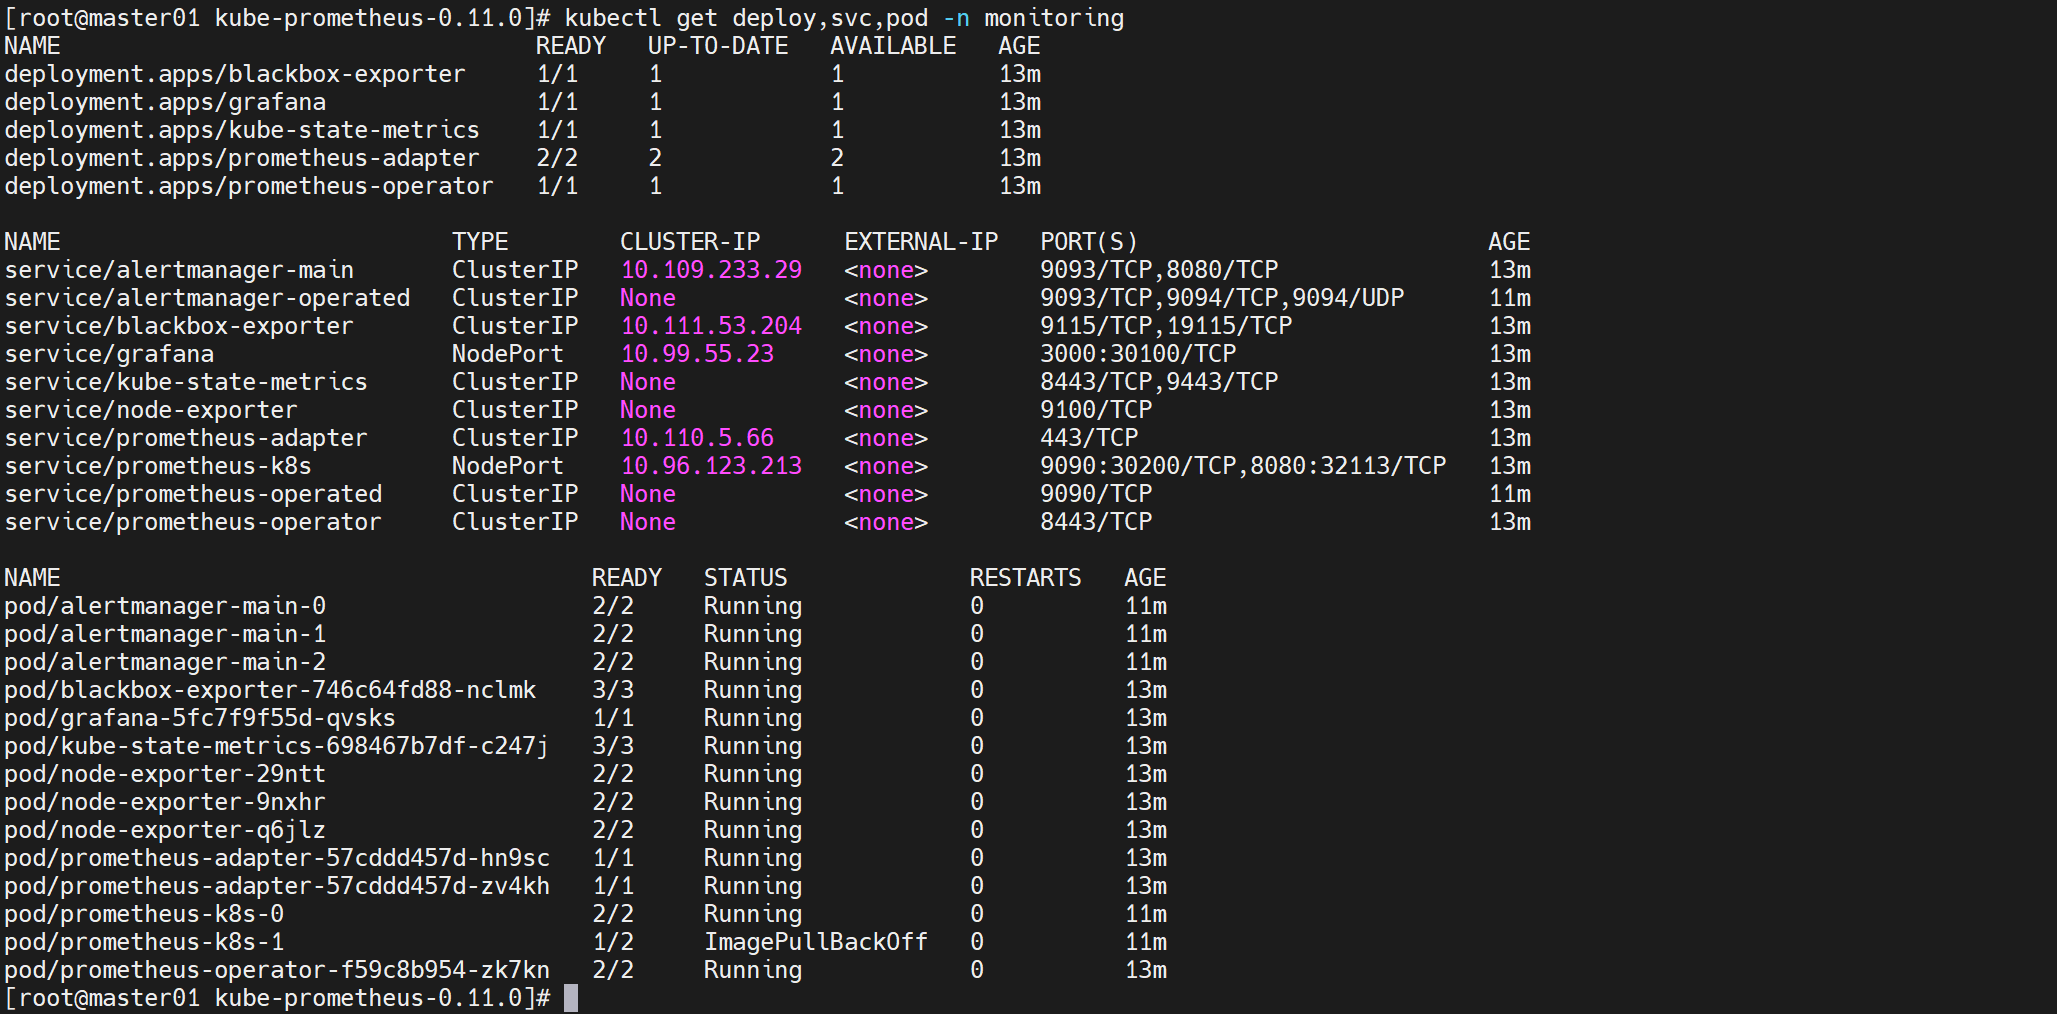
注意:如果按照有问题,可以执行此步,再重新安装,若没错请不要执行此步骤,除非你真的想卸载不要了:
kubectl delete --ignore-not-found=true -f manifests/ -f manifests/setup
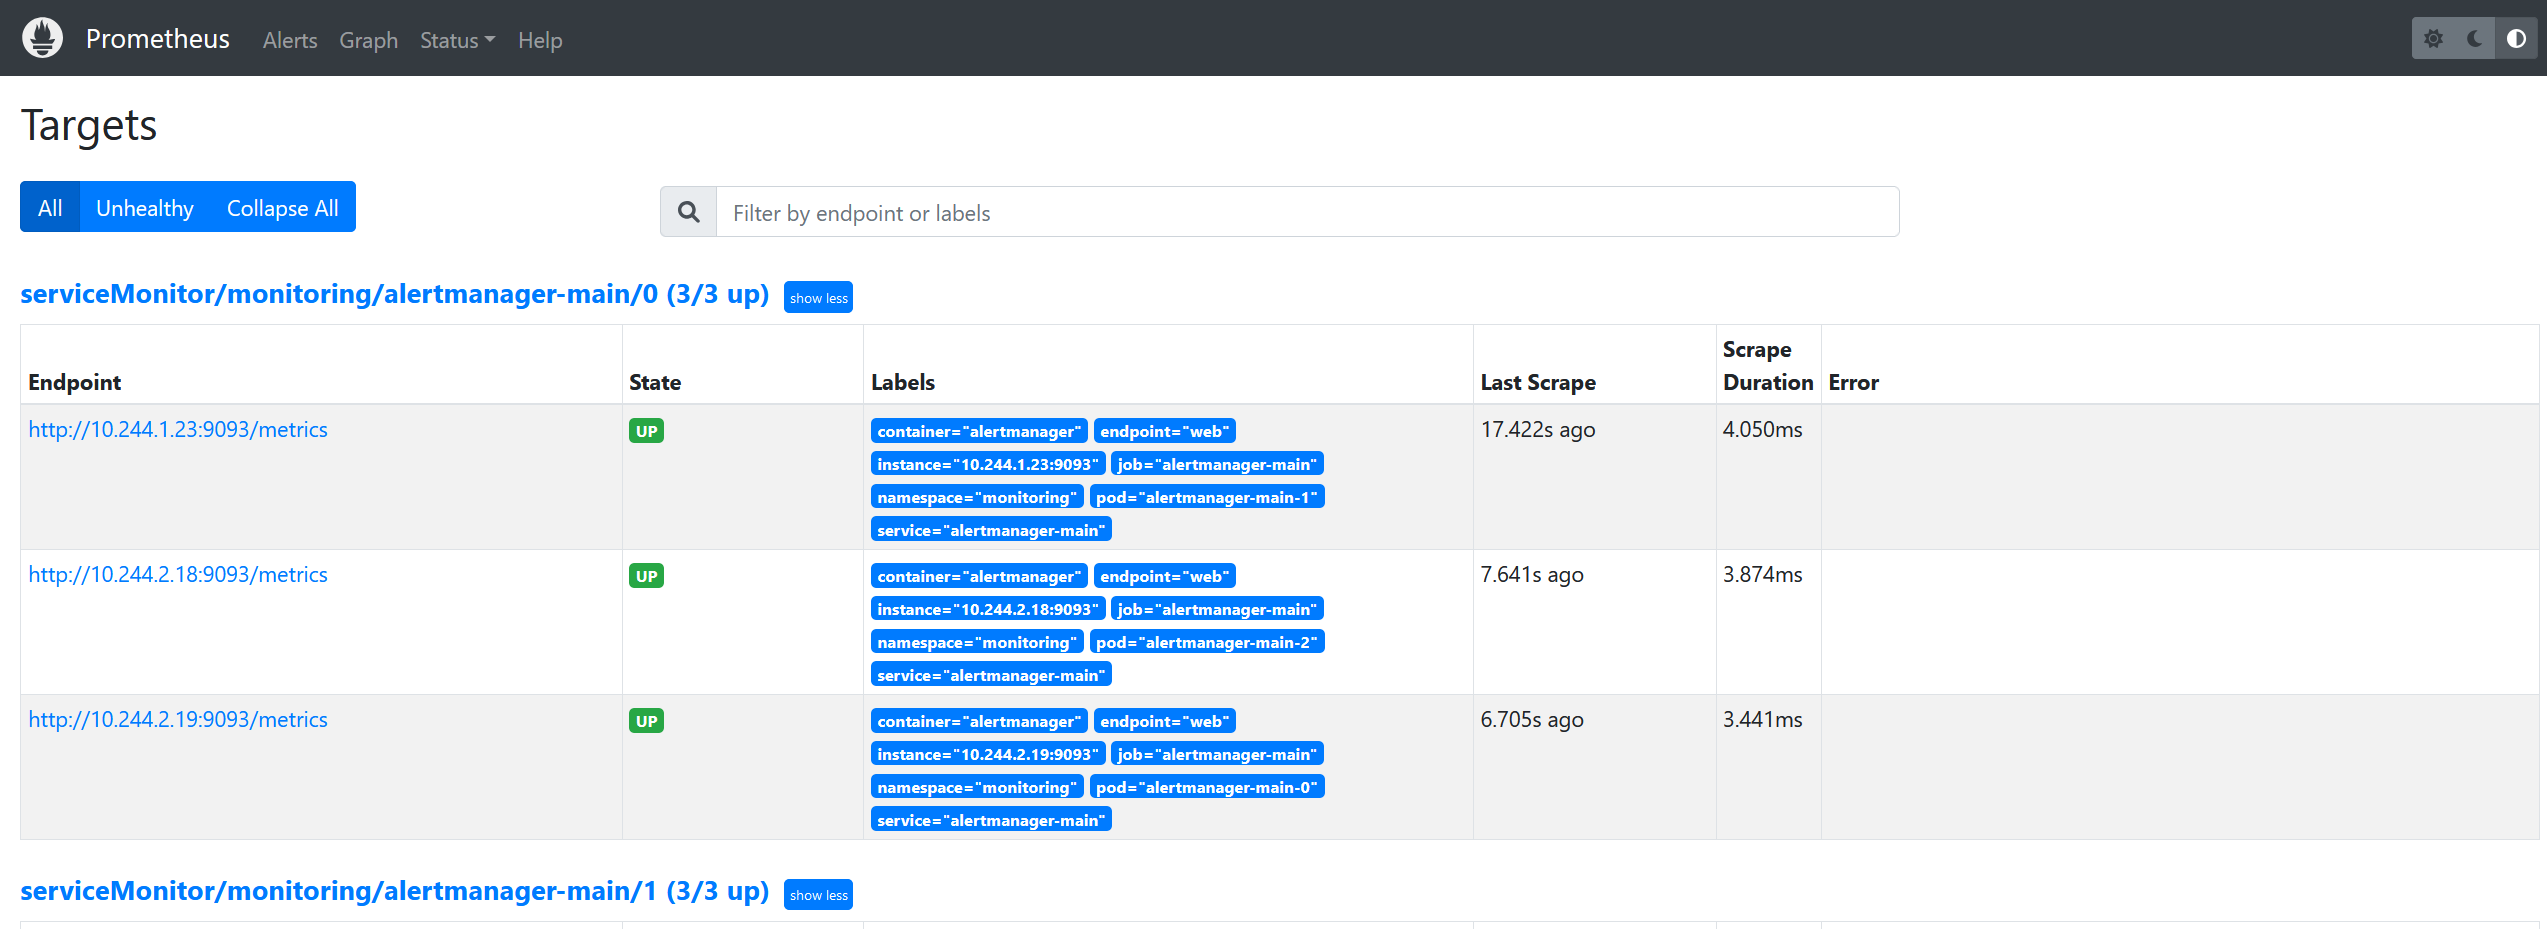
4、Prometheus访问
访问地址:http://192.168.217.155:30200
注意:ip为宿主机的IP,端口是第二步中修改的Prometheus的端口号
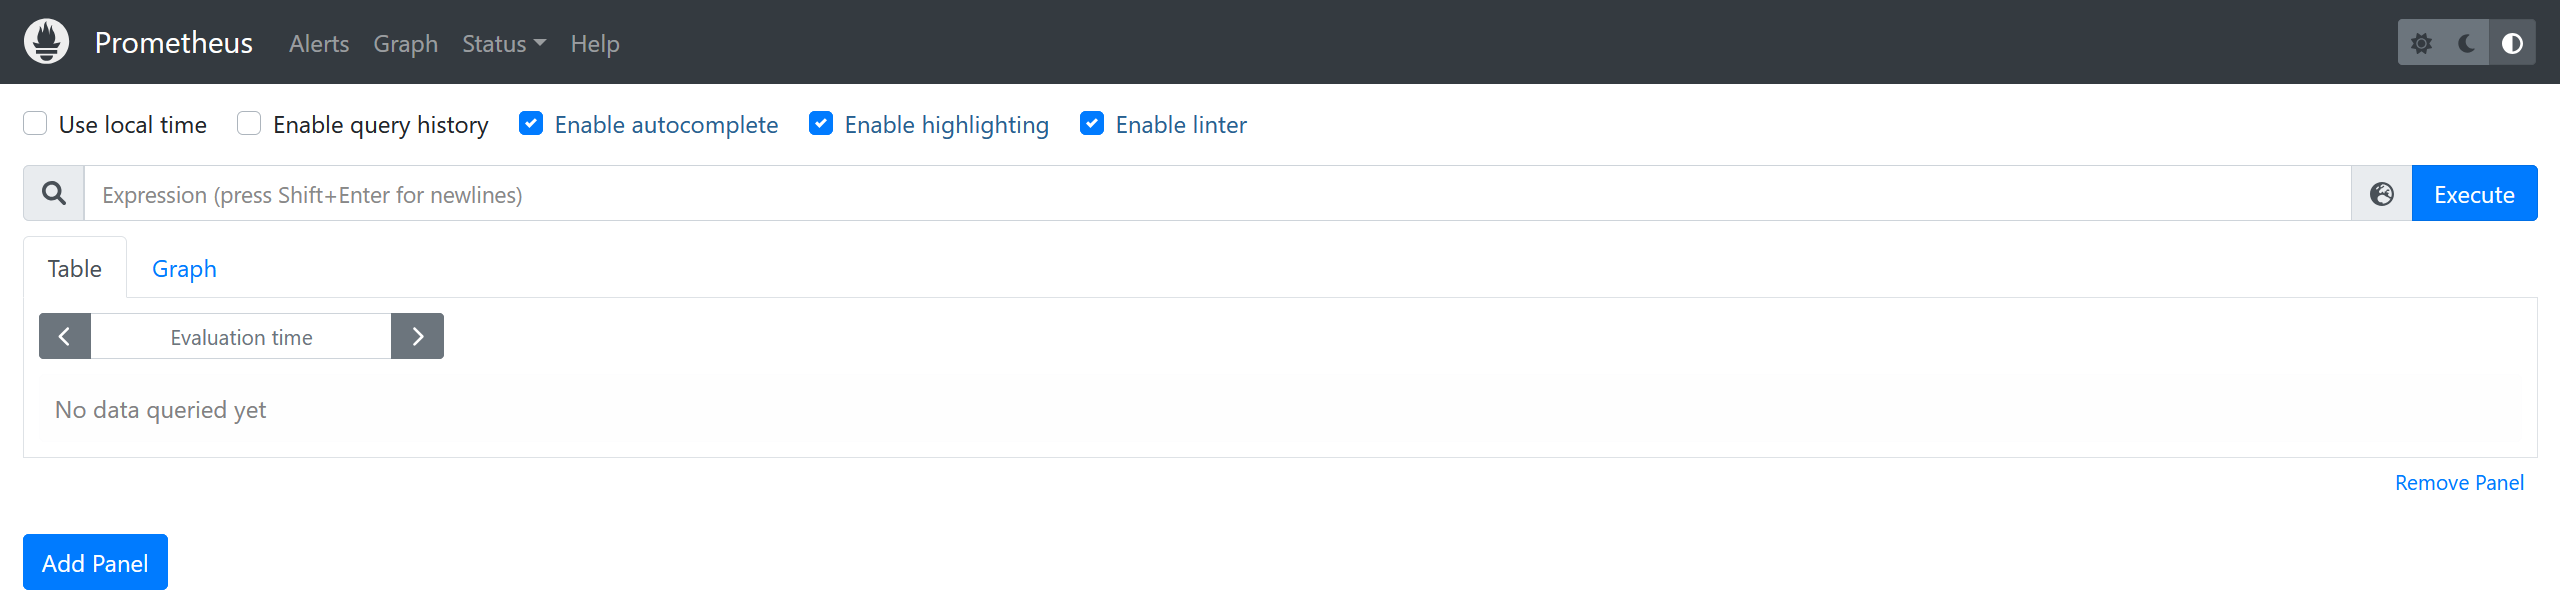
status==>Targets
5、Grafana访问
访问地址:http://192.168.217.155:30100
注意:ip为宿主机的IP,端口是第二步中修改的grafana的端口号,账号密码默认都是admin
三、使用
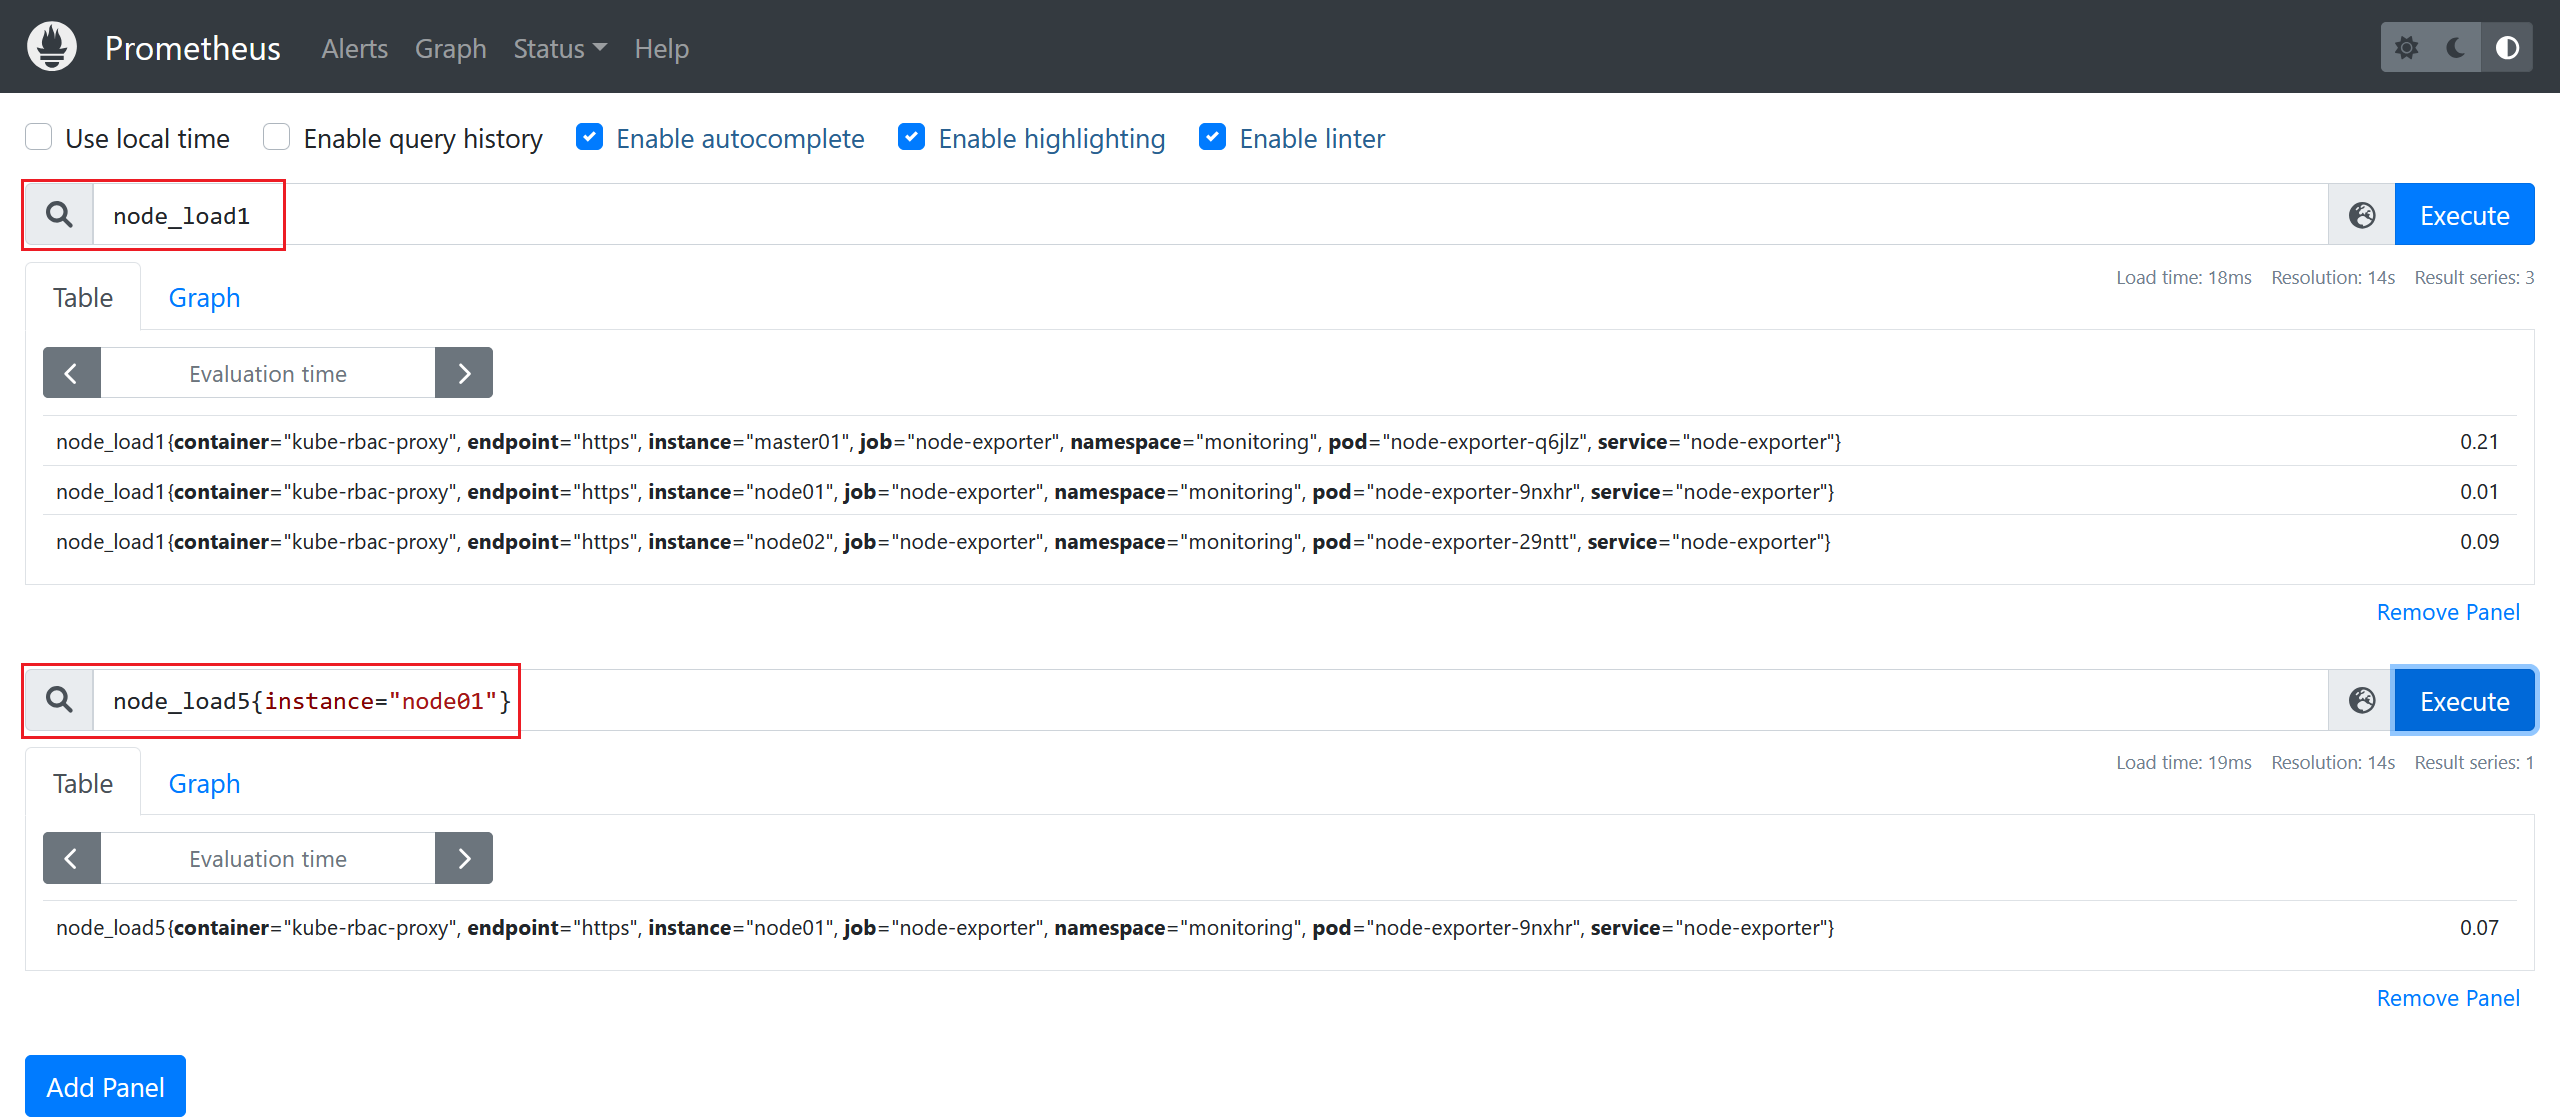
1、prometheus
访问地址:http://192.168.169.192:30200
1)基本监听项
2、grafana
访问地址:http://192.168.217.155:30100
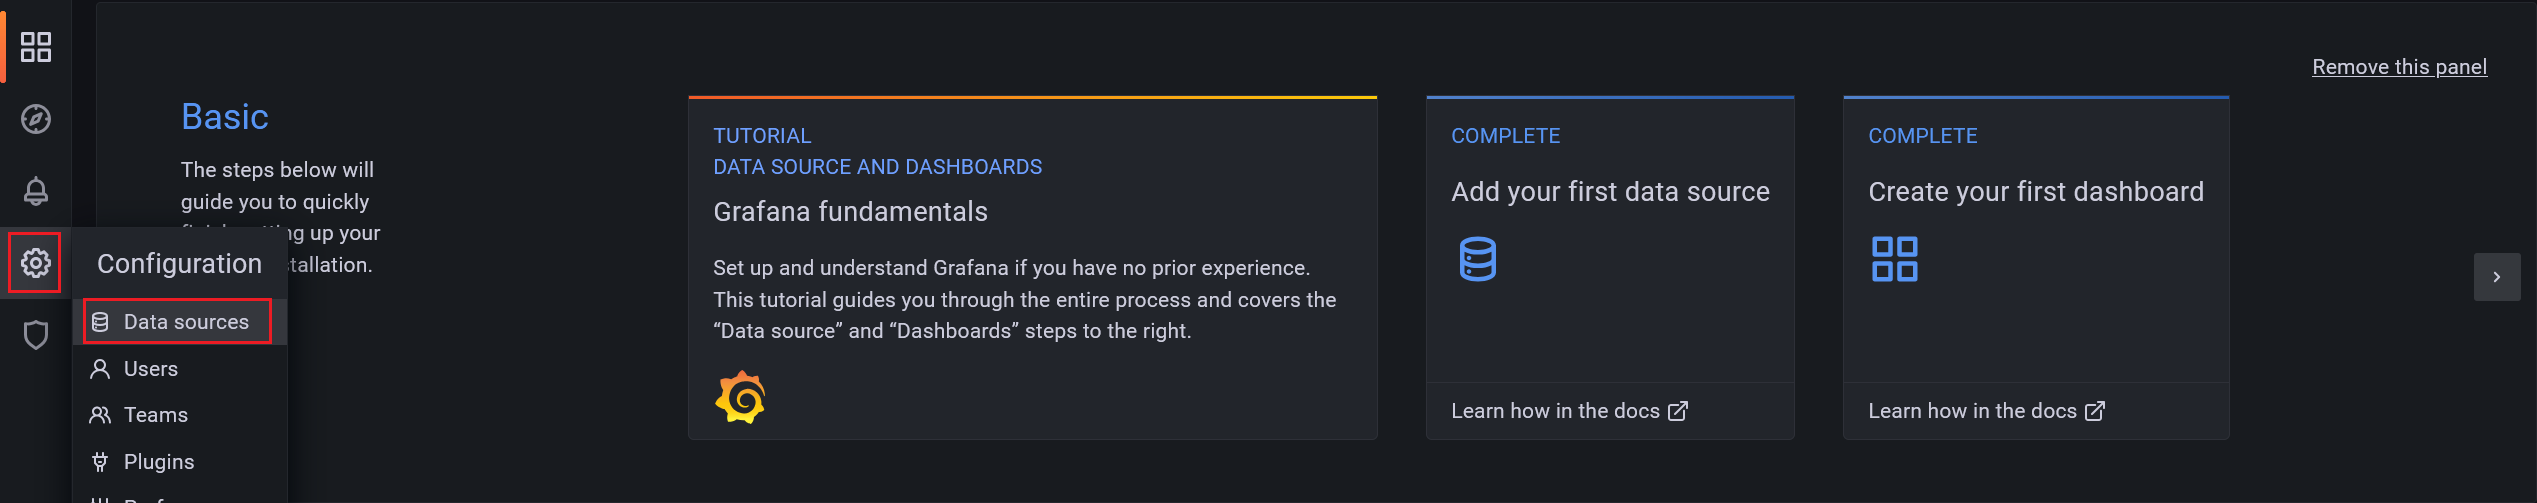
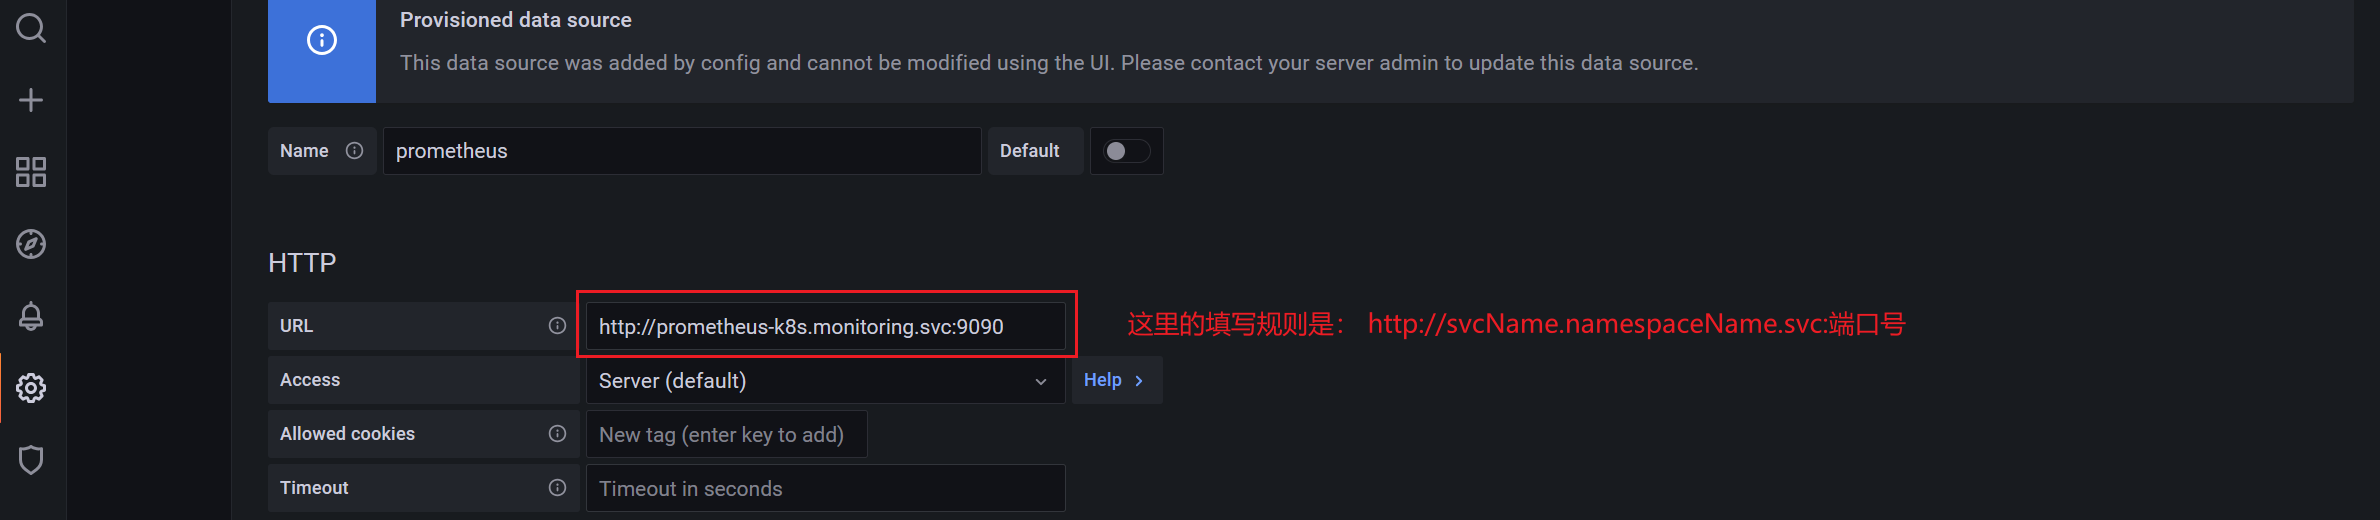
1)配置数据源
四、课堂小结
五、随堂作业
1、完成全部课堂实验
六、扩展内容
更多推荐

 63
 0
- 0


 已为社区贡献4条内容

所有评论(0)