
Transformer 大模型架构深度解析(2)RNN 循环神经网络模型在 NLP 中的应用
目录
NLP 的序列数据与序列模型
序列数据
序列是数据点或事件的有序列表。与独立的图像或表格数据不同,序列数据中的元素具有内在的顺序和时间依赖性。 典型的例子包括:自然语言文本、语音、视频、股票价格、天气读数或传感器数据等。在 NLP 领域,文本翻译、语音识别等场景都离不开对序列数据的处理。
序列模型
传统的 FFN(Feedforward Neural Networks,前馈神经网络)或 CNN(卷积神经网络)在处理这类数据时会遇到根本性的困难,因为它们假设所有输入都是相互独立的,所以无法捕捉到数据点之间的时序关系。比如在处理一个句子时,FNN 会孤立地看待每个单词,从而丢失了至关重要的上下文信息。为了解决这个问题,我们需要一种能够 “记忆过去” 信息的模型,而这正是 RNN 的设计初衷。
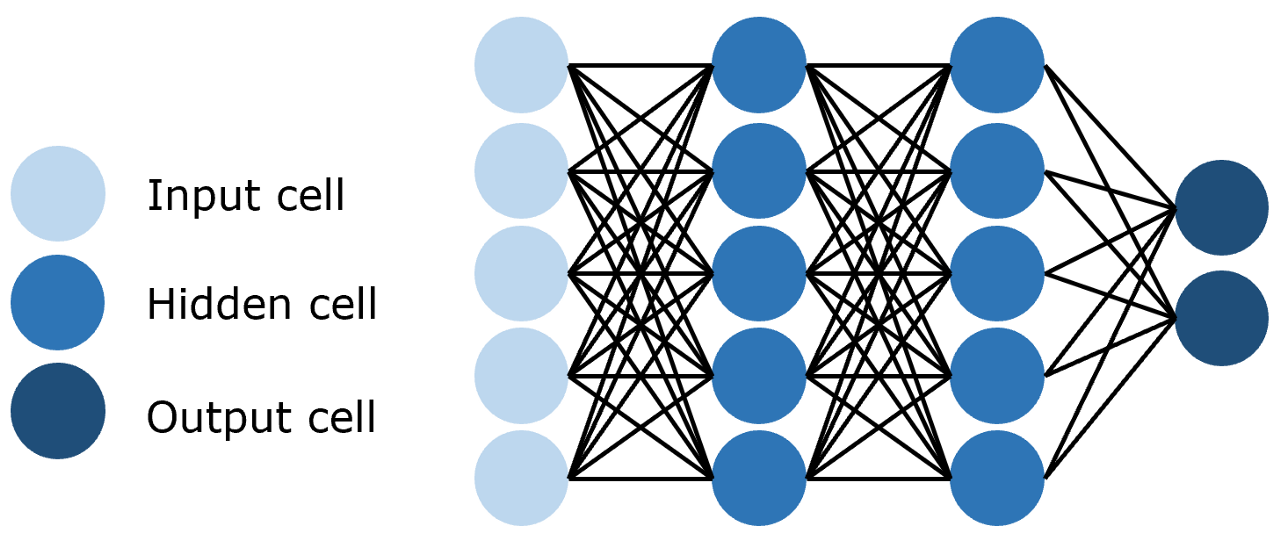
FNN(前馈神经网络)是一种全连接神经网络,每一层的神经元都和上下两层的每一个神经元完全连接。并且信息只能沿着输入到输出的方向单向传播,不存在循环或反馈连接。也就是说,数据从输入层进入,经过中间的隐藏层逐层处理后,最终由输出层输出结果,层与层之间的连接是 “前馈” 的,没有反向的信息流动。
而 Sequence Model(序列模型)就是一种用于处理序列数据的 AI 模型,具有 “历史记忆”,能够用于解决输入数据为序列形式的各种问题。在 NLP 领域的应用场景包括:
- 文本处理:单词的顺序决定了句子的含义。如:机器翻译、情感分析、聊天机器人。
- 语音识别:音频转文本。
- 音乐生成:声波是随时间变化的连续信号。
- 视频生成:视频由一系列有序的图像帧组成。
- 时间序列分析:分析按时间顺序排列的数据点序列,如:股票价格、传感器读数、天气预报等,其当前值与历史值密切相关。
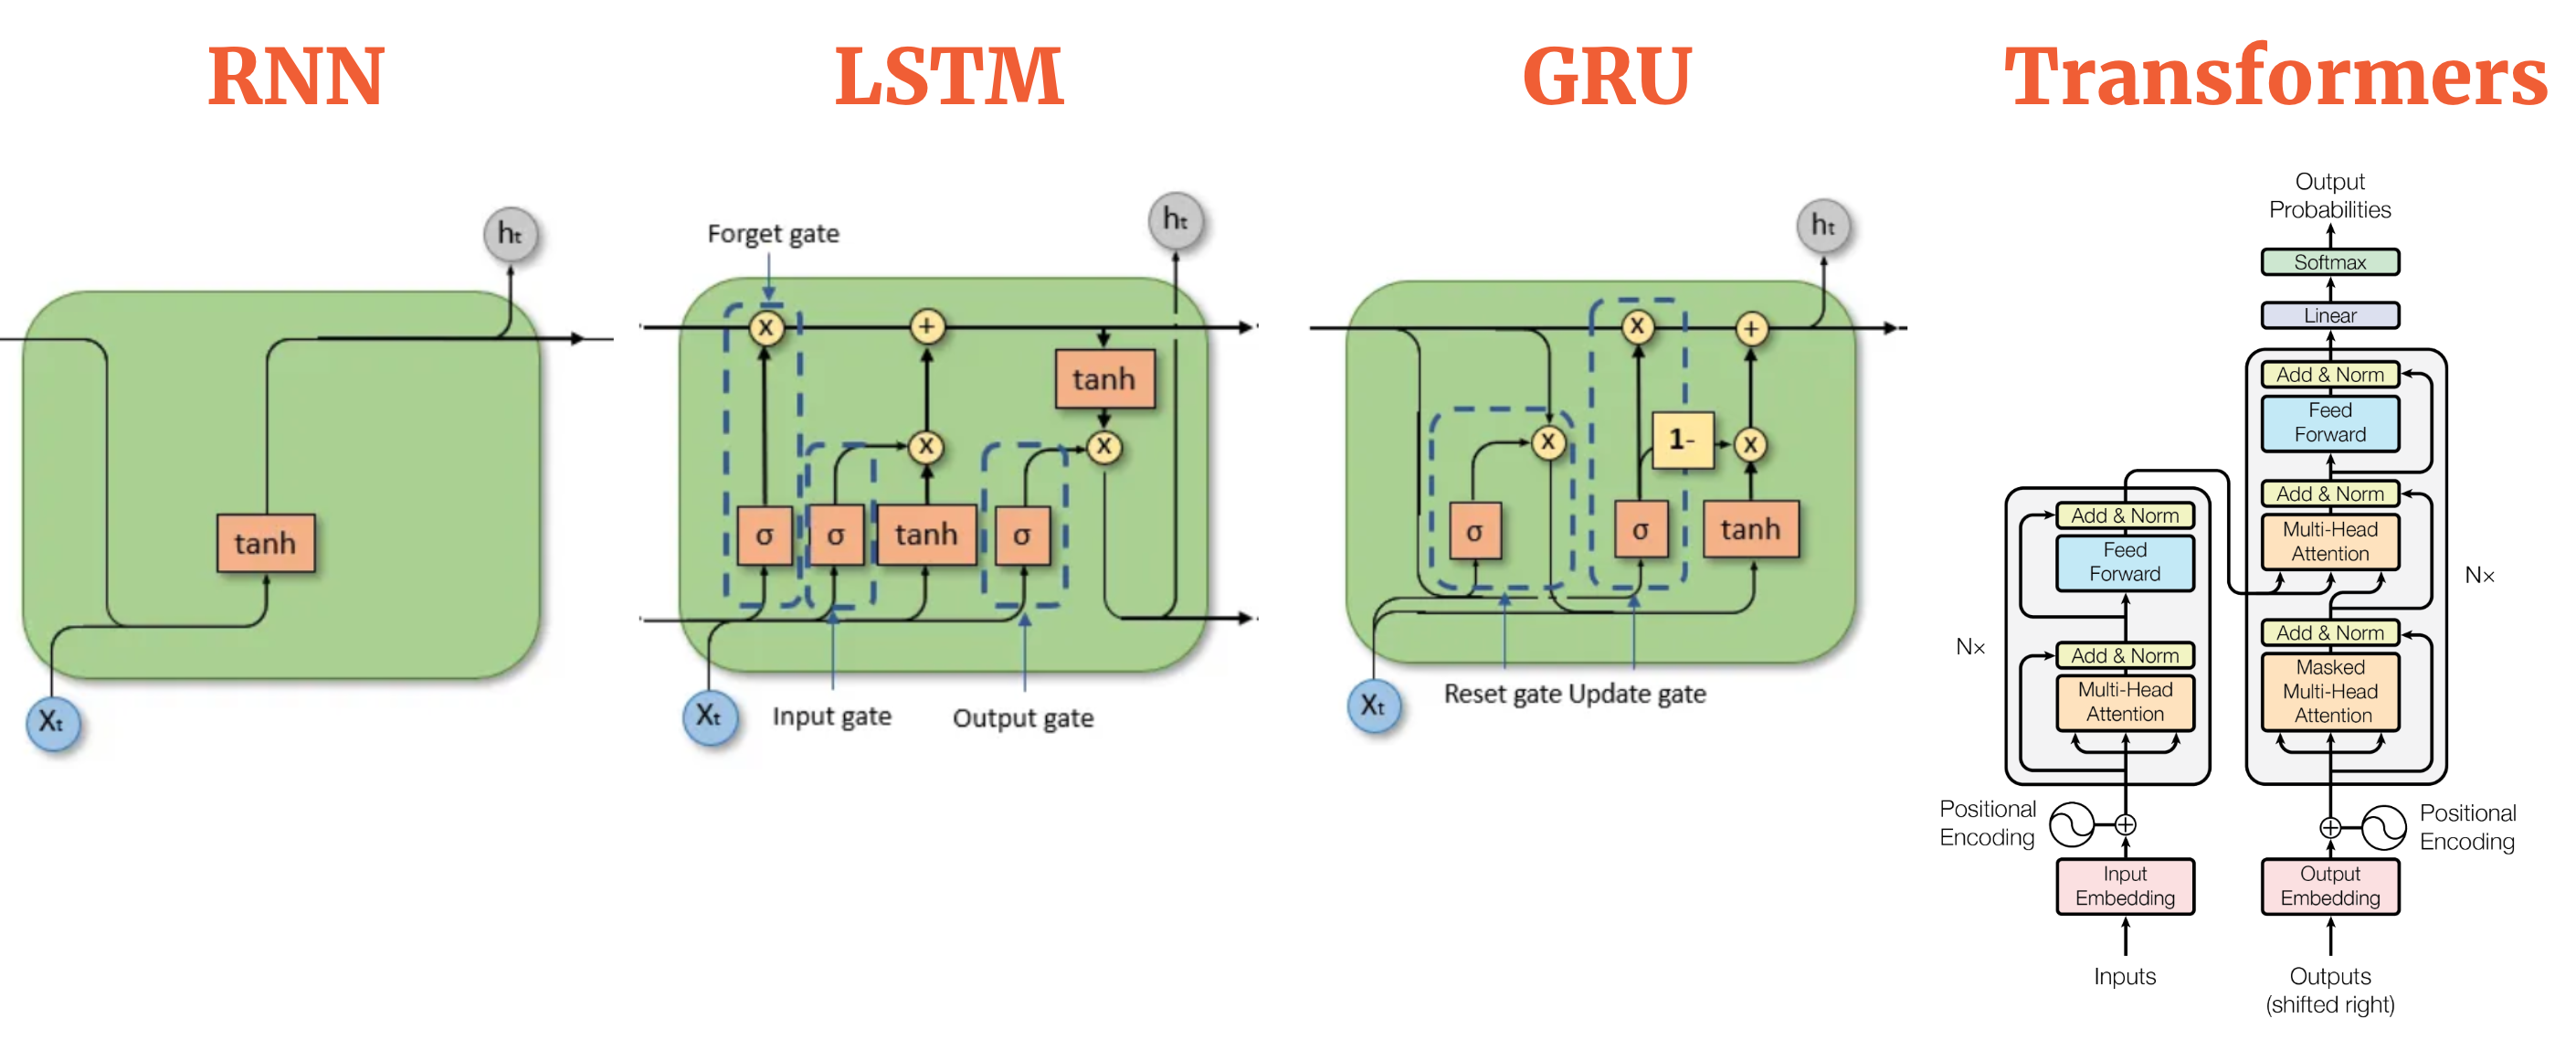
值得注意的是,Sequence Model 的 “历史记忆” 和 Hopfield Network 的 “联系记忆” 有本质的区别,“联想记忆” 并不适用于处理序列数据,而 “历史记忆” 的目标是发现序列数据中的模式和依赖关系,从而进行预测、分类,甚至生成新的序列。当下经典的序列模型结构包括:RNN、LSTM、GRU、Transformer 和 GPT。
由于 NLP 任务所需要处理的文本往往是序列,因此专用于处理序列、时序数据的 RNN 往往能够在 NLP 任务上取得最优的效果。事实上,在 Transformer 横空出世之前,RNN 以及 RNN 的衍生架构 LSTM、GRU 是 NLP 领域当之无愧的霸主。
时至今日,虽然像 Transformer 这样的基于 Attention(注意力机制)的新架构在许多 NLP 任务中(尤其是在处理超长序列时)表现出了更强的性能和更好的并行性,但 RNN、LSTM 和 GRU 仍然是序列建模领域不可或缺的基础工具。 它们在计算效率、对实时流数据的处理以及在某些特定任务上的表现依然具有优势。
RNN(循环神经网络)
1990 年,Jeffrey Elman 发表论文《Finding structure in time(在时间中寻找结构)》提出了 SRN(Simple Recurrent Network,简单循环网络),这是世界上第一个 RNN(Recurrent Neural Networks,循环神经网络)序列模型。它开启了对序列数据和序列模型的研究,开创了模型能够 “记忆历史信息” 的先河。
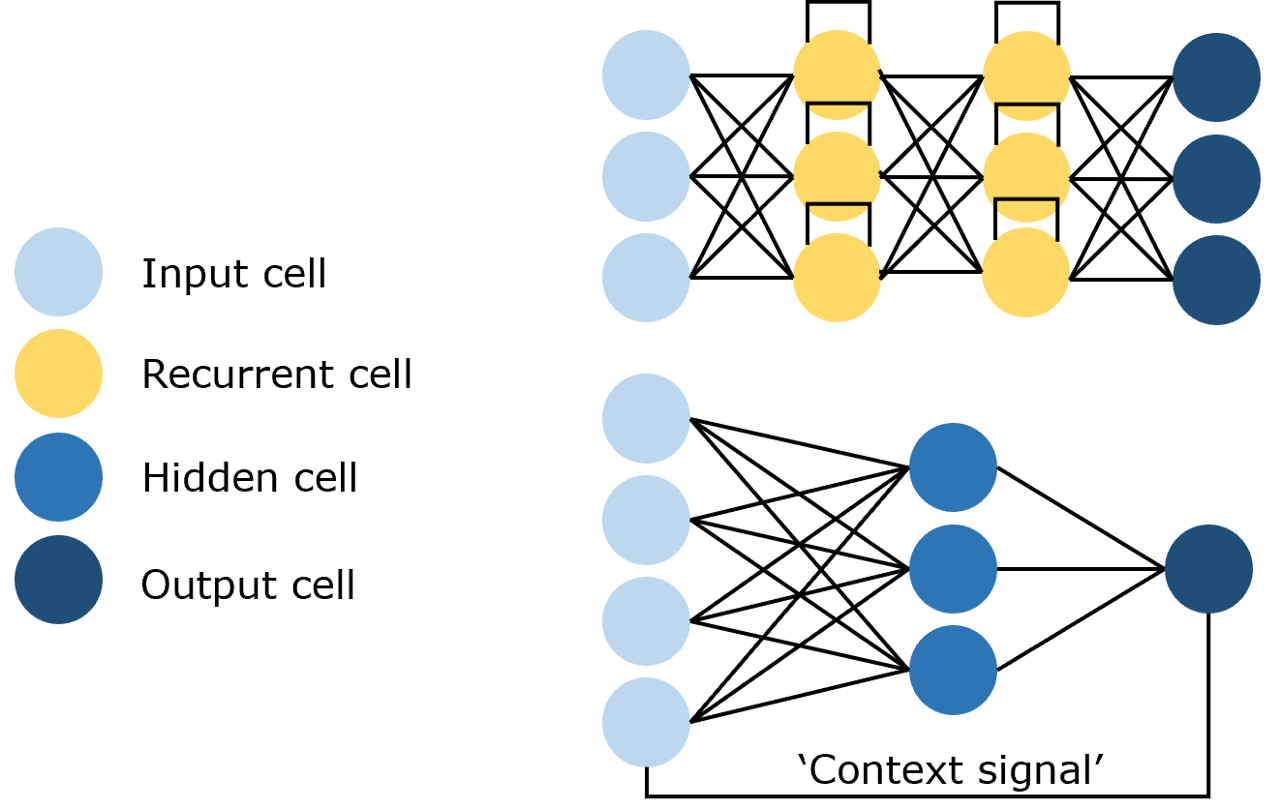
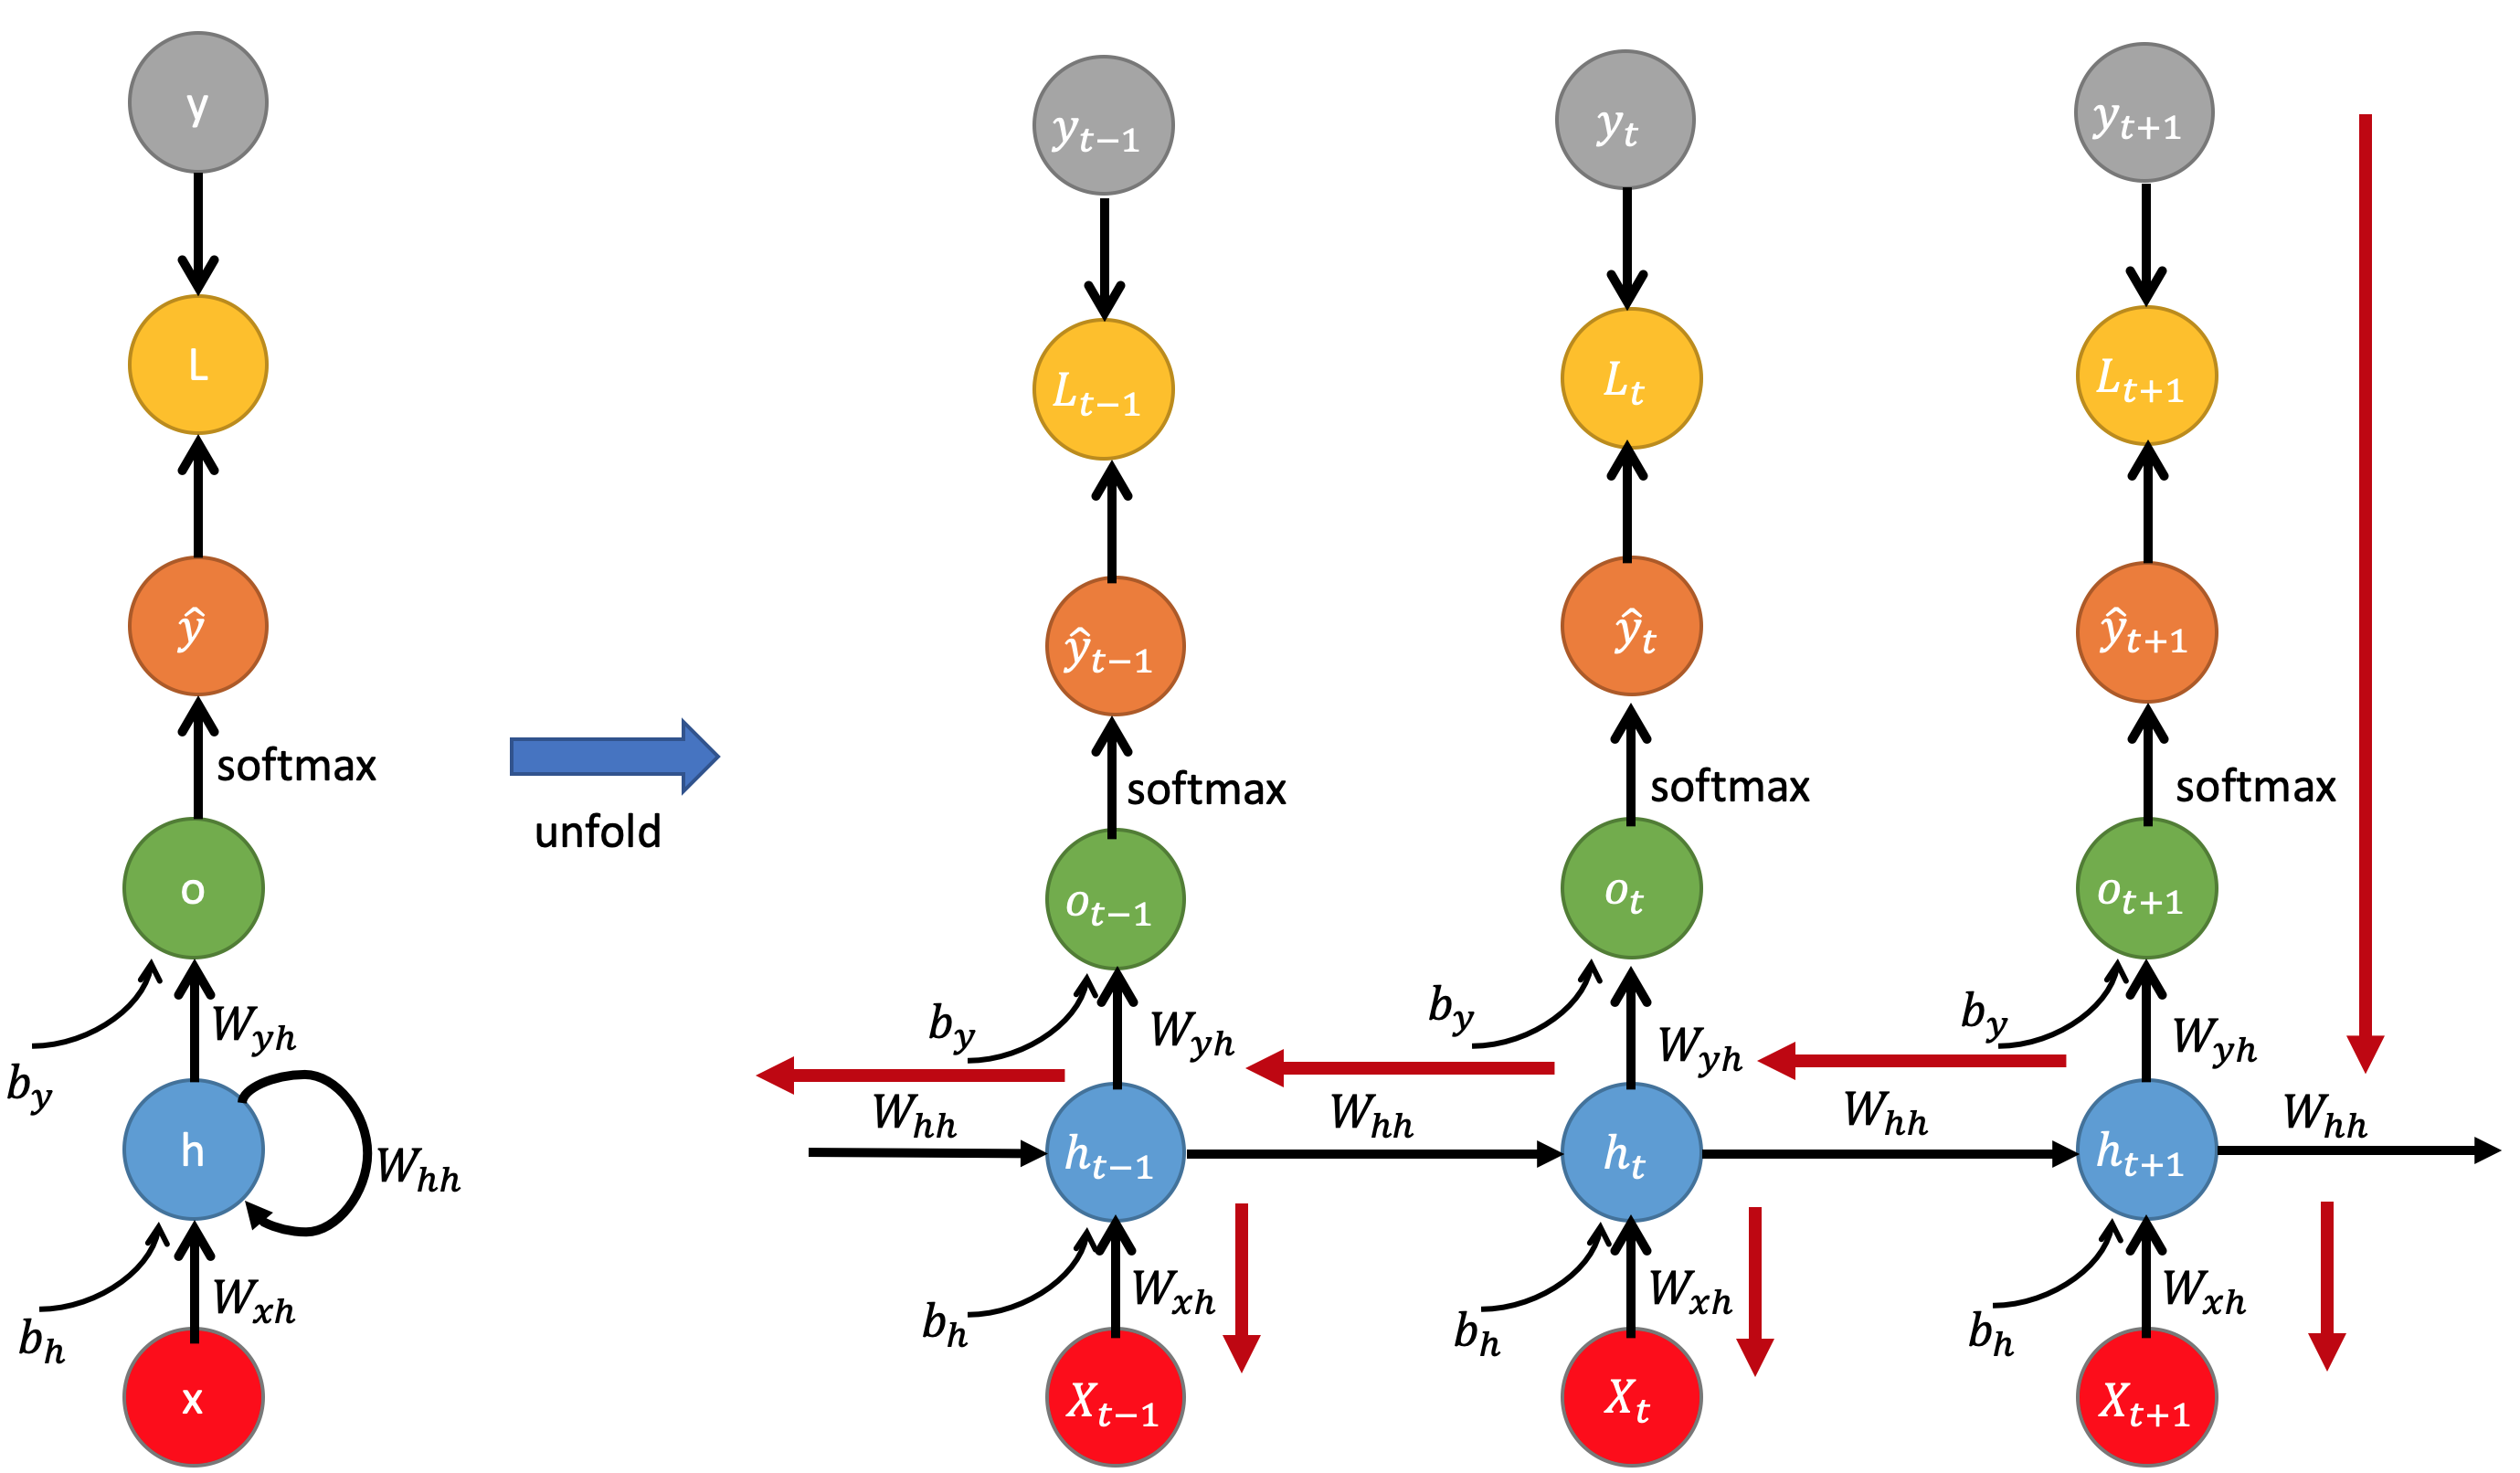
如下图,RNN 和 FFN 的主要区别之一,就是 RNN 神经元中引入了一个循环结构。
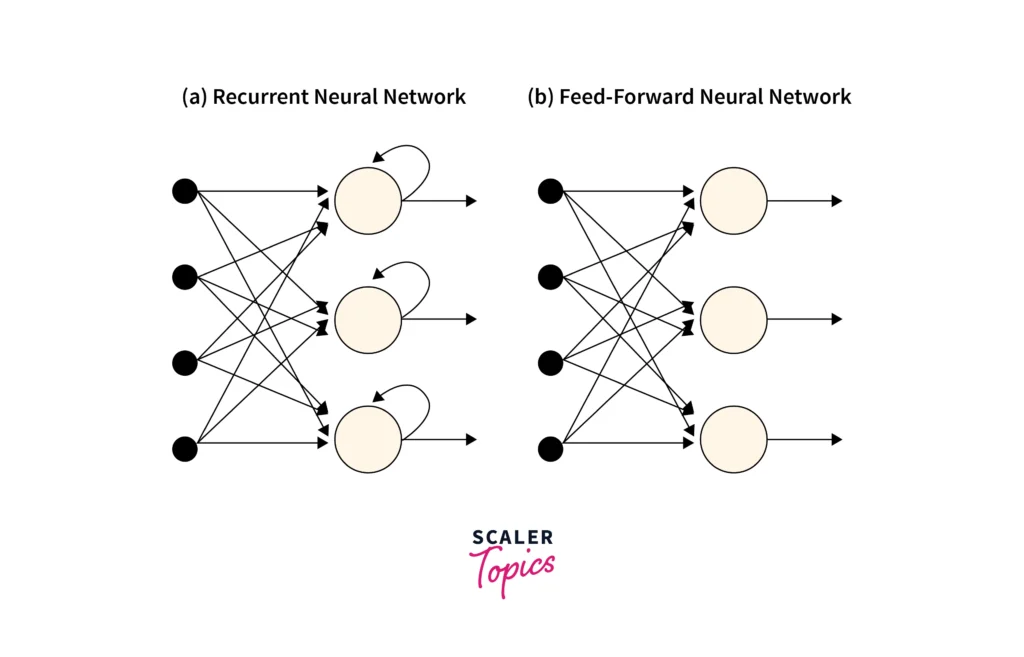
RNN 神经元结构
RNN 的核心是让模型 “记住过去”。为了实现这一能力,RNN 模型结构具有以下 3 个关键特性:
- 信息持久化(Information Persistence):RNN 能够在隐藏层(Hidden Layer)节点中存储 “历史记忆”,称之为隐藏状态。通过这个状态 RNN 可以在序列处理的过程中传递 “历史记忆”,这是 RNN 能够学习到序列元素之间的长距离依赖关系的前提。
- 反馈循环(Feedback Loop):通过在隐藏层的每个节点上添加一个反馈循环连接,使得它在处理序列中的每个元素(如一个词、一个时间点的数据)时,它不仅要考虑当前的输入,还要考虑它从之前所有步骤中计算并保留下来的 “历史记忆”。所以这个状态会随着网络处理输入序列中的每个元素而更新,就像是不断被刷新的 “记忆”,但该 “记忆容量” 有限且无法长期保存。
- 捕捉依赖关系(Captures Dependencies):RNN 的目的是捕捉序列数据中随时间分布的依赖关系和模式。但受限于梯度消失,仅能有效学习短距离依赖,无法处理长序列(如超过 10 个时间步)的长期关联。
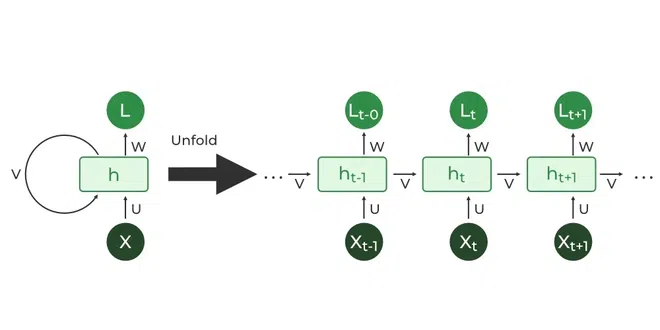
在 RNN 模型中,时间步是处理序列元素的基本单位,一个时间步处理的就是一个序列元素。所以一个序列由多个时间步(元素)组成,每个 RNN 神经元都会在一个序列的多个时间步之间传递 “历史记忆”。
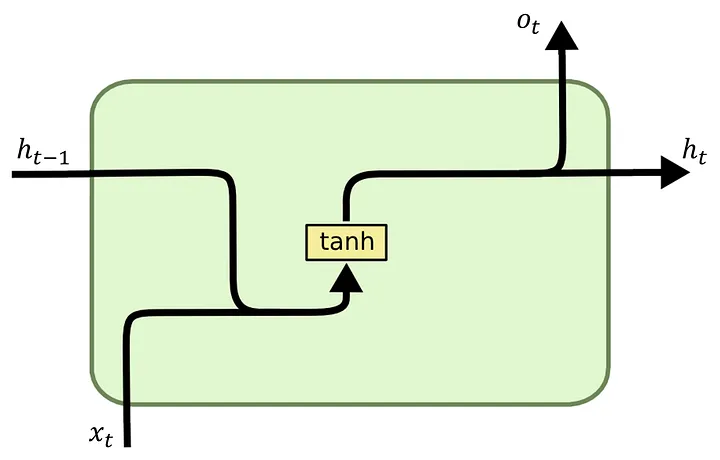
如下图所示,将一个 RNN 神经元展开(Unfold)后,就成为了一个链式的结构,每一个环节表示一个时间步处理一个序列元素。每个时间步(t)不仅会接收当前的输入 x_t(元素),还会接收来自上一个时间步(t-1)的隐藏状态 h_t-1,然后计算出当前时间步的隐藏状态 h_t 和输出 y_t。
其中,隐藏状态(Hidden State)就是 “历史记忆”,是 RNN 神经元到目前为止所被处理过的一个序列中的元素数据的 “历史记忆”。可见,RNN 神经元的 “当前记忆” 是由 “当前输入” 和 “历史记忆” 来共同决定的。
数学表达
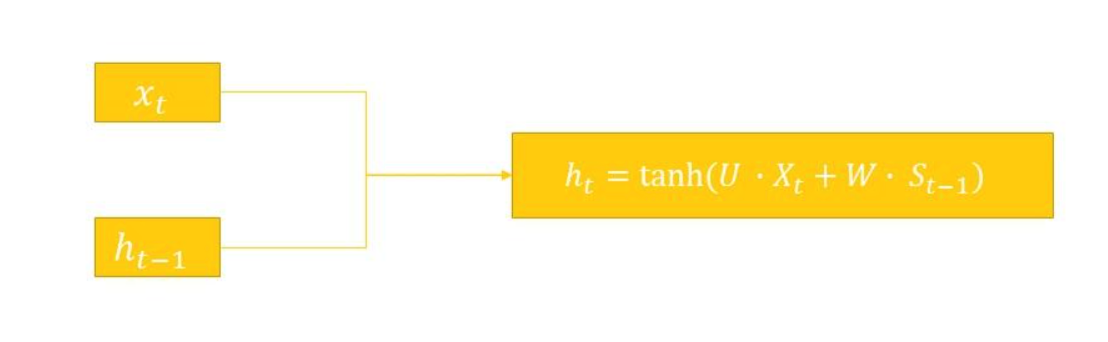
简单 RNN 的核心计算可以用以下两个公式来描述:
- 隐藏状态的计算:
h_t = f(W_hh * h_t-1 + W_xh * x_t + b_h)
- 输出的计算:
y_t = W_hy * h_t + b_y
其中:
-
x_t:在时间步 t 的输入向量,如文本中的词向量。
-
y_t:在时间步 t 的输出。
-
h_t, h_t-1 隐藏状态特征:在时间步 h_t 或 t-1 的隐藏状态(即:历史信息),是运行时现算的,它表示 “到目前为止读过的所有词的一个压缩摘要”,是一个定长向量。无论序列多长它都用同样大小的向量记录着 “前文的全部要点”。
-
W_xh, W_hh, W_hy:分别是输入层到隐藏层、隐藏层到自循环隐藏层、隐藏层到输出层的权重矩阵。作为共享参数,在所有时间步中是共享的。
- W_xh 形状:隐藏层维度 × 输入维度
- W_hh 形状:隐藏层维度 × 隐藏层维度(关键)
- W_hy 形状:输出维度 × 隐藏层维度
-
W_xh 权重矩阵:表示 “怎么读进一个新词”,它决定了一个新词进来时,该抽取它哪些特征、以什么方式注入到 “记忆” 里。是一套 “读词规则”。
-
W_hh 权重矩阵:决定了 “上一刻的状态,如何演变成下一刻的状态”。也就是 “过去的信息该怎么保留、怎么衰减、怎么和新信息融合” 的规则。
-
W_hy 权重矩阵:表示 “怎么从当前记忆里读出一个预测”,把浓缩的状态映射成词汇表上的概率分布。是一套 “根据现状猜下一个词的规则”。
-
b_h, b_y:分别是隐藏层和输出层的偏置量。
- b_h 形状:隐藏层维度 × 1
- b_y 形状:输出维度 × 1
-
f:激活函数
- 隐藏层用 tanh,值缩至 [-1,1]。
- 输出层用 Softmax(分类)或线性激活(回归)
训练算法
RNN 的训练通过 BPTT(Backpropagation Through Time,时间反向传播)来完成,本质上是标准 BP 反向传播算法在 Unfold 展开后的 RNN 上的具体应用。Loss 损失函数在每个时间步 t 计算,然后将梯度从最后一个时间步开始,沿着时间序列反向传播,并用这些梯度来更新共享的 W_xh, W_hh, W_hy 权重矩阵。
使用 PyTorch 实现一个单层的 RNN
这是一个进行文本情绪分析的 RNN 模型例子,只有 1 层隐藏层。
重点关注 RNN 需要按照顺序的逐一处理一个序列中的每个元素,而每个元素的 input_dim 由由词汇表维度决定。
import torch
import torch.nn as nn
import torch.optim as optim

# ---------------------- 1. 定义最简RNN(适配序列级分类) ----------------------
class SimpleRNN(nn.Module):
    def __init__(self, input_dim, hidden_dim, output_dim):
        super(SimpleRNN, self).__init__()
        # 权重矩阵
        # W_xh, W_hh, W_hy:分别是输入层到隐藏层、隐藏层到自循环隐藏层、隐藏层到输出层的权重矩阵。作为共享参数,在所有时间步中是共享的。
        # - W_xh 形状:隐藏层维度 × 输入维度
        # - W_hh 形状:隐藏层维度 × 隐藏层维度(关键)
        # - W_hy 形状:输出维度 × 隐藏层维度
        self.W_xh = nn.Parameter(torch.randn(hidden_dim, input_dim))  # 隐藏层×输入层
        self.W_hh = nn.Parameter(torch.randn(hidden_dim, hidden_dim)) # 隐藏层×隐藏层
        self.W_hy = nn.Parameter(torch.randn(output_dim, hidden_dim)) # 输出层×隐藏层
        # 偏置项
        self.b_h = nn.Parameter(torch.randn(hidden_dim, 1))
        self.b_y = nn.Parameter(torch.randn(output_dim, 1))
        # 维度记录
        self.input_dim = input_dim
        self.hidden_dim = hidden_dim
        self.output_dim = output_dim

    def forward(self, x_seq):
        """
        前向传播(序列级分类:仅用最后一个时间步的隐藏状态输出)
        时间步:在序列模型中,时间步是处理序列数据的基本单位。它代表了模型按顺序处理输入数据的一个 “步骤” 或 “瞬间”。

        x_seq: 输入序列,形状 [时间步数量, 输入维度]
        返回:最终输出(序列级分类结果)、最后一个隐藏状态
        """
        # 对于每个序列而言,初始的隐藏状态 h0 设置为 )
        h_prev = torch.zeros(self.hidden_dim, 1)

        # e.g.
        # text = '电影 好看',这个序列只有 2 个元素,对应 2 个时间步
        # 向序列进行词汇表的词向量化之后,x_seq 为:
        #  tensor([[1., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0.],
        #          [0., 1., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0.]])

        # 逐时间步更新隐藏状态,每次迭代对应一个时间步
        for t in range(x_seq.shape[0]):
            # e.g.
            # t = 电影,[1., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0., 0.]
            x_t = x_seq[t].unsqueeze(1)  # 转为 [输入维度, 1] 适配矩阵乘法
            # 计算隐藏状态公式:  h_t = tanh(W_hh * h_t-1 + W_xh * x_t + b_h)
            h_t = torch.tanh(self.W_hh @ h_prev + self.W_xh @ x_t + self.b_h)
            # 传递隐藏状态到下一个时间步
            h_prev = h_t

        # 计算序列输出,仅使用了最后一个隐藏状态来计算最终输出的分类结果
        # 计算输出公式: y_t = W_hy * h_t + b_y
        y_final = self.W_hy @ h_prev + self.b_y
        y_final = torch.log_softmax(y_final, dim=0)  # 归一化函数, 二分类对数概率
        return y_final, h_prev

# ---------------------- 2. 数据准备(极短文本情感分类数据集) ----------------------
# 步骤1:词汇表,用于文本的词向量化表示
vocab = {
    "电影": 0, "好看": 1, "饭菜": 2, "难吃": 3,
    "天气": 4, "糟糕": 5, "音乐": 6, "好听": 7,
    "剧情": 8, "一般": 9, "但": 10, "演技": 11, "好": 12,
    "难看": 13, "好吃": 14, "心情": 15, "分量": 16, "少": 17
}
vocab_size = len(vocab)  # 输入维度=词表大小(One-Hot编码)

# 步骤2:训练数据,使用空格作为词元的分隔符,并且进行了数据的手动标注。
train_data = [
    ("电影 好看", 1),       # 正面
    ("饭菜 难吃", 0),       # 负面
    ("天气 糟糕", 0),       # 负面
    ("音乐 好听", 1),       # 正面
    ("电影 难看", 0),       # 负面
    ("饭菜 好吃", 1)        # 正面
]

# 步骤3:数据编码函数,VSM 文本向量化表示法(文本→One-Hot序列)
def text2onehot(text):
    words = text.split()  # 按空格拆分词
    onehot_seq = []
    for word in words:
        # 生成One-Hot向量(输入维度=vocab_size)
        onehot = torch.zeros(vocab_size)
        if word in vocab:
            onehot[vocab[word]] = 1.0
        onehot_seq.append(onehot)
    return torch.stack(onehot_seq)

# ---------------------- 3. 模型初始化与训练配置 ----------------------

# 初始化模型结构、损失函数、优化器
input_dim = vocab_size    # 输入维度=词表大小(One-Hot)
hidden_dim = 4           # 只有一层隐藏层,维度为 4
output_dim = 2           # 输出维度=2(二分类:正面/负面)
model = SimpleRNN(input_dim, hidden_dim, output_dim)

# 初始化损失函数和优化器
criterion = nn.NLLLoss()  # 使用负对数似然损失计算方法,对应log_softmax的损失函数
optimizer = optim.SGD(model.parameters(), lr=0.1)  # 随机梯度下降

# ---------------------- 4. 训练过程 ----------------------
epochs = 1000  # 训练轮次(极简数据需多轮训练)
for epoch in range(epochs):
    total_loss = 0.0
    for text, label in train_data:
        # 1. 数据编码
        x_seq = text2onehot(text)  # [时间步数量, input_dim]
        y_true = torch.tensor([label])  # 真实标签:形状 [1]

        # 2. 前向传播
        y_pred, _ = model(x_seq)  # y_pred 形状:[2, 1]

        # 3. 正确修正维度:将 y_pred 从 [2, 1] 转为 [1, 2]
        # 关键修改:先squeeze去掉最后一维→[2],再reshape为[1,2](batch_size=1,类别数=2)
        y_pred_reshaped = y_pred.squeeze(1).reshape(1, 2)

        # 4. 计算损失(现在维度完全匹配:input[1,2],target[1])
        # 预测值和标准的真实值对比求 loss 值
        loss = criterion(y_pred_reshaped, y_true)

        # 5. 反向传播+参数更新
        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_loss += loss.item()

    # 每100轮打印损失
    if (epoch + 1) % 100 == 0:
        print(f"Epoch {epoch+1}, Loss: {total_loss/len(train_data):.4f}")

# ---------------------- 5. 测试:可用示例 vs 局限示例 ----------------------
def predict(text):
    """
    预测函数:输入文本→输出情感分类结果
    """
    model.eval()  # 评估模式
    with torch.no_grad():
        x_seq = text2onehot(text)
        y_pred, _ = model(x_seq)
        # 同步修正维度
        y_pred_reshaped = y_pred.squeeze(1).reshape(1, 2)
        pred_label = torch.argmax(y_pred_reshaped).item()  # 0=负面,1=正面
        emotion = "正面" if pred_label == 1 else "负面"
        return f"文本:{text} → 预测情感:{emotion}(标签:{pred_label})"

# 5.1 可用示例(2~3个词的极短文本,能正确分类)
print("\n===== 可用示例(极短简单文本) =====")
print(predict("电影 好看"))   # 预期:正面
print(predict("饭菜 难吃"))   # 预期:负面
print(predict("音乐 好听"))   # 预期:正面

# 5.2 局限示例(>5个词/含矛盾语义,分类失败)
print("\n===== 局限示例(长/复杂文本) =====")
print(predict("电影 剧情 一般 但 演技 好"))  # 真实情感:偏正面,纯RNN会分类错误
print(predict("天气 糟糕 但 心情 好"))        # 真实情感:中性/偏正面,纯RNN会分类错误
print(predict("饭菜 好吃 但 分量 少"))        # 真实情感:中性/偏负面,纯RNN会分类错误
执行输出:
Epoch 100, Loss: 0.0131
Epoch 200, Loss: 0.0052
Epoch 300, Loss: 0.0032
Epoch 400, Loss: 0.0022
Epoch 500, Loss: 0.0017
Epoch 600, Loss: 0.0014
Epoch 700, Loss: 0.0011
Epoch 800, Loss: 0.0009
Epoch 900, Loss: 0.0008
Epoch 1000, Loss: 0.0007

===== 可用示例(极短简单文本) =====
文本:电影 好看 → 预测情感:正面(标签:1)
文本:饭菜 难吃 → 预测情感:负面(标签:0)
文本:音乐 好听 → 预测情感:正面(标签:1)

===== 局限示例(长/复杂文本) =====
文本:电影 剧情 一般 但 演技 好 → 预测情感:正面(标签:1)
文本:天气 糟糕 但 心情 好 → 预测情感:正面(标签:1)
文本:饭菜 好吃 但 分量 少 → 预测情感:正面(标签:1)
使用 PyTorch 实现一个 2 层的 RNN
多层 RNN 和单层 RNN 的核心原理是一样的,不过多层 RNN 可以使用更多的权重矩阵来捕捉复杂的、层级化的序列规律(比如 “床前明月光” 的句式、押韵规律)。此外,多层 RNN 的容量大,能拟合更复杂的序列规律,比如长文本的上下文依赖。
一个多层的 RNN 网络中的 RNN 神经元展开后,就像是一个多层的 FFN 网络。其中 RNN 神经元的时间步数量由序列长度决定。
举例 1:构建一个用于古诗生成的 RNN。采用了将序列中下一个词作为 “伪标注” 的自监督学习方式。这是一个 2 层的 RNN,Input 先经过第一层过滤器提取基础特征,再经过第二层(甚至更多层)提取更抽象的特征,最后 Output。
- 隐藏层 1:学字符等基础特征。
- 隐藏层 2:学短语、句式、押韵等抽象特征。
import torch
import torch.nn as nn
import torch.optim as optim

# ===================== 1. 训练数据 =====================
text = """
床前明月光,疑是地上霜。举头望明月,低头思故乡。
白日依山尽,黄河入海流。欲穷千里目,更上一层楼。
春眠不觉晓,处处闻啼鸟。夜来风雨声,花落知多少。
千山鸟飞绝,万径人踪灭。孤舟蓑笠翁,独钓寒江雪。
松下问童子,言师采药去。只在此山中,云深不知处。
红豆生南国,春来发几枝。愿君多采撷,此物最相思。
"""
# 清理文本(去掉换行/空格,只保留有效字符)
text = text.replace("\n", "").replace(" ", "")
# 字符→索引映射(词汇表随文本扩展自动变大)
chars = sorted(list(set(text)))
char2idx = {c: i for i, c in enumerate(chars)}
idx2char = {i: c for i, c in enumerate(chars)}
print(f"词汇表: ", char2idx)
vocab_size = len(chars)
seq_len = 10  # 序列长度

# 构建训练数据(样本量随文本长度大幅增加)
def build_data(text, seq_len):
    data = []
    # 遍历文本,生成大量输入-目标序列对
    for i in range(len(text) - seq_len):
        input_seq = text[i:i+seq_len]
        target_seq = text[i+1:i+seq_len+1]
        # x 是 input,用于求预测值, 例如:'床前明月光,疑是地上'
        x = torch.tensor([char2idx[c] for c in input_seq], dtype=torch.long)
        # y 是真实值,用于求 loss,例如:'前明月光,疑是地上霜',即:将下一个 token 作为 “伪标注”
        y = torch.tensor([char2idx[c] for c in target_seq], dtype=torch.long)
        # 将 x 转化为 One-Hot 编码
        x_onehot = torch.eye(vocab_size)[x]
        data.append((x_onehot, y))
    return data

train_data = build_data(text, seq_len)
print(f"训练样本总数: ", len(train_data))  # 打印样本数,直观看到增加

# ===================== 2. 两层RNN模型(微调隐藏层适配更多数据) =====================
class SimpleTwoLayerRNN(nn.Module):
    def __init__(self, input_dim, hidden_dim1, hidden_dim2, output_dim):
        super().__init__()
        # 第一层RNN参数
        self.W_xh1 = nn.Parameter(torch.randn(hidden_dim1, input_dim) * 0.1)
        self.W_hh1 = nn.Parameter(torch.randn(hidden_dim1, hidden_dim1) * 0.1)
        self.b_h1 = nn.Parameter(torch.zeros(hidden_dim1, 1))
        # 第二层RNN参数
        self.W_h1h2 = nn.Parameter(torch.randn(hidden_dim2, hidden_dim1) * 0.1)
        self.W_hh2 = nn.Parameter(torch.randn(hidden_dim2, hidden_dim2) * 0.1)
        self.b_h2 = nn.Parameter(torch.zeros(hidden_dim2, 1))
        # 输出层
        self.W_hy = nn.Parameter(torch.randn(output_dim, hidden_dim2) * 0.1)
        self.b_y = nn.Parameter(torch.zeros(output_dim, 1))

    def forward(self, x_seq):
        h1 = torch.zeros(self.W_hh1.shape[0], 1)  # 第一层隐藏状态
        h2 = torch.zeros(self.W_hh2.shape[0], 1)  # 第二层隐藏状态
        all_preds = []

        # 逐时间步计算两层RNN
        for t in range(x_seq.shape[0]):
            x_t = x_seq[t].unsqueeze(1)
            # 第一层RNN
            h1 = torch.tanh(torch.matmul(self.W_hh1, h1) + torch.matmul(self.W_xh1, x_t) + self.b_h1)
            # 第二层RNN:第一层的输出 h1 作为第二次的输入
            h2 = torch.tanh(torch.matmul(self.W_hh2, h2) + torch.matmul(self.W_h1h2, h1) + self.b_h2)
            # 输出层
            y_t = torch.matmul(self.W_hy, h2) + self.b_y
            y_t = torch.log_softmax(y_t.squeeze(1), dim=0)
            all_preds.append(y_t)

        return torch.stack(all_preds, dim=0)

# ===================== 3. 训练 =====================
# 2 层 RNN,每层的维度如下
hidden_dim1 = 24
hidden_dim2 = 12
model = SimpleTwoLayerRNN(vocab_size, hidden_dim1, hidden_dim2, vocab_size)
criterion = nn.NLLLoss()
optimizer = optim.SGD(model.parameters(), lr=0.015)  # 微调学习率,加速收敛

# 训练轮次500,每100轮打印loss(更清晰看到训练趋势)
print("\n开始训练:")
for epoch in range(500):
    total_loss = 0.0
    for x, y in train_data:
        optimizer.zero_grad()
        preds = model(x)
        # 通过预测值 preds 和真实值 y 求 loss 值
        loss = criterion(preds, y)
        loss.backward()
        optimizer.step()
        total_loss += loss.item()
    # 每100轮打印一次loss(减少冗余输出,聚焦趋势)
    if (epoch+1) % 100 == 0:
        avg_loss = total_loss / len(train_data)
        print(f"Epoch {epoch+1:3d} | 平均Loss: {avg_loss:.4f}")

# ===================== 4. 文本生成(保留极简逻辑,生成更长文本) =====================
def generate_text(prefix, max_len=20):
    model.eval()
    with torch.no_grad():
        gen = list(prefix)
        h1 = torch.zeros(hidden_dim1, 1)
        h2 = torch.zeros(hidden_dim2, 1)

        # 先跑一遍前缀,初始化隐藏状态
        for c in prefix:
            x_t = torch.eye(vocab_size)[char2idx[c]].unsqueeze(1)
            h1 = torch.tanh(torch.matmul(model.W_hh1, h1) + torch.matmul(model.W_xh1, x_t) + model.b_h1)
            h2 = torch.tanh(torch.matmul(model.W_hh2, h2) + torch.matmul(model.W_h1h2, h1) + model.b_h2)

        # 逐字符生成(生成长度从10→20,更能体现效果)
        while len(gen) < max_len:
            last_char = gen[-1]
            x_t = torch.eye(vocab_size)[char2idx[last_char]].unsqueeze(1)

            h1 = torch.tanh(torch.matmul(model.W_hh1, h1) + torch.matmul(model.W_xh1, x_t) + model.b_h1)
            h2 = torch.tanh(torch.matmul(model.W_hh2, h2) + torch.matmul(model.W_h1h2, h1) + model.b_h2)

            y_t = torch.matmul(model.W_hy, h2) + model.b_y
            next_idx = torch.argmax(y_t).item()
            next_char = idx2char[next_idx]
            gen.append(next_char)

        return "".join(gen)

# 多组前缀测试,验证生成效果
print("\n===== 文本生成结果(多前缀测试) =====")
test_prefixes = ["床前", "白日", "春眠", "千山"]
for prefix in test_prefixes:
    gen_result = generate_text(prefix, max_len=20)
    print(f"前缀:{prefix} → 生成:{gen_result}")
执行输出:
词汇表:  {'。': 0, '一': 1, '万': 2, '上': 3, '下': 4, '不': 5, '中': 6, '举': 7, '乡': 8, '云': 9, '人': 10, '低': 11, '依': 12, '光': 13, '入': 14, '几': 15, '前': 16, '千': 17, '南': 18, '去': 19, '发': 20, '只': 21, '君': 22, '啼': 23, '国': 24, '在': 25, '地': 26, '声': 27, '处': 28, '多': 29, '夜': 30, '头': 31, '子': 32, '孤': 33, '寒': 34, '少': 35, '尽': 36, '层': 37, '山': 38, '师': 39, '床': 40, '径': 41, '思': 42, '愿': 43, '撷': 44, '故': 45, '日': 46, '明': 47, '春': 48, '是': 49, '晓': 50, '更': 51, '最': 52, '月': 53, '望': 54, '来': 55, '松': 56, '枝': 57, '楼': 58, '欲': 59, '此': 60, '江': 61, '河': 62, '流': 63, '海': 64, '深': 65, '灭': 66, '物': 67, '独': 68, '生': 69, '疑': 70, '白': 71, '目': 72, '相': 73, '眠': 74, '知': 75, '穷': 76, '童': 77, '笠': 78, '红': 79, '绝': 80, '翁': 81, '舟': 82, '花': 83, '药': 84, '落': 85, '蓑': 86, '觉': 87, '言': 88, '豆': 89, '踪': 90, '采': 91, '里': 92, '钓': 93, '问': 94, '闻': 95, '雨': 96, '雪': 97, '霜': 98, '风': 99, '飞': 100, '鸟': 101, '黄': 102, ',': 103}
训练样本总数:  134

开始训练:
Epoch 100 | 平均Loss: 1.8109
Epoch 200 | 平均Loss: 0.7239
Epoch 300 | 平均Loss: 0.3822
Epoch 400 | 平均Loss: 0.2576
Epoch 500 | 平均Loss: 0.2015

===== 文本生成结果(多前缀测试) =====
前缀:床前 → 生成:床前翁,云深不知处。红豆生南国,春来发几
前缀:白日 → 生成:白日生明中,云深不知处。红豆生南国,春来
前缀:春眠 → 生成:春眠觉知,处。红豆生南国,春来发几枝。愿
前缀:千山 → 生成:千山月月,万径人踪灭。孤舟蓑笠翁,独钓寒
输入-输出结构类型
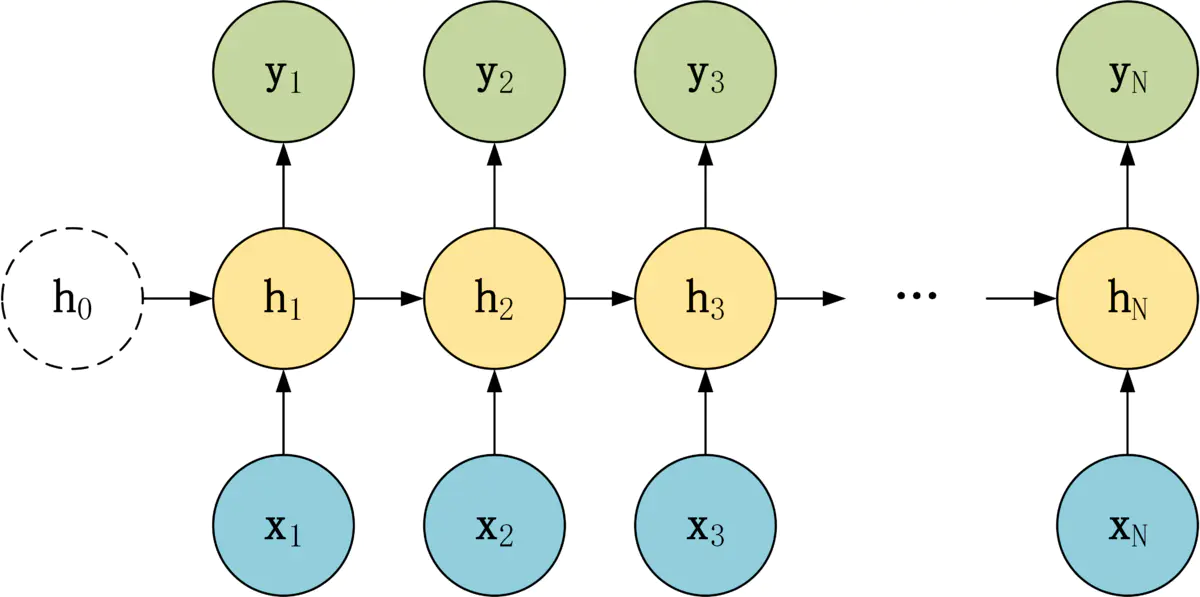
N-N 结构
N-N 结构,包含 N 个输入 x1, x2, …, xN,和 N 个输出 y1, y2, …, yN。
N-N 结构,输入和输出序列的长度是相等的。
通常适合用于以下任务:
- 词性标注。
- 训练语言模型,使用之前的词预测下一个词等。
1-N 结构
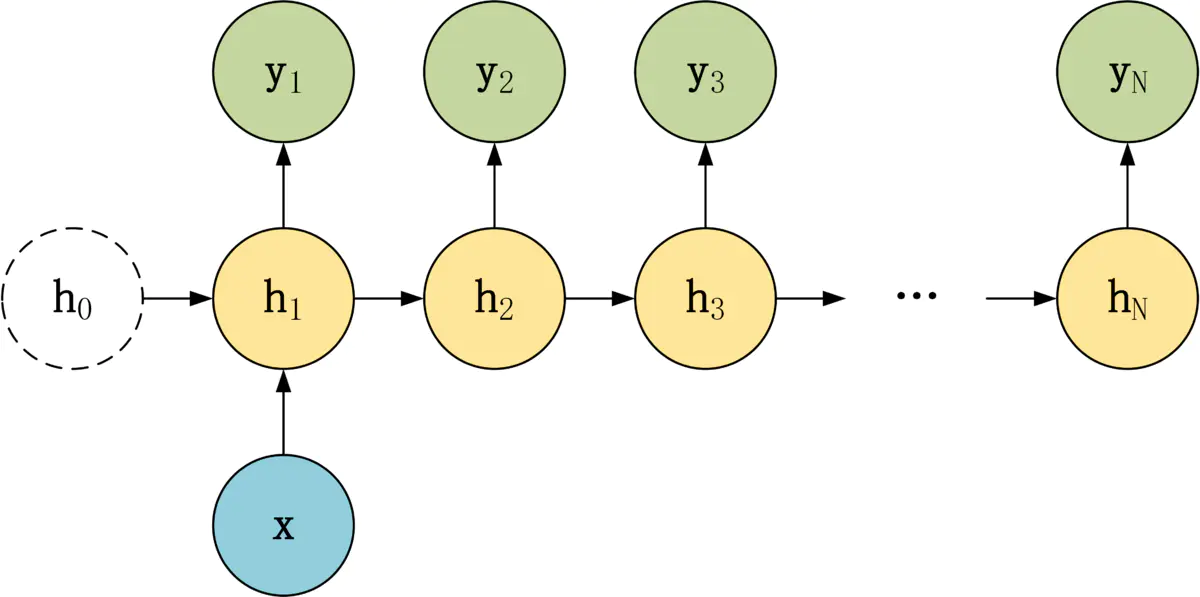
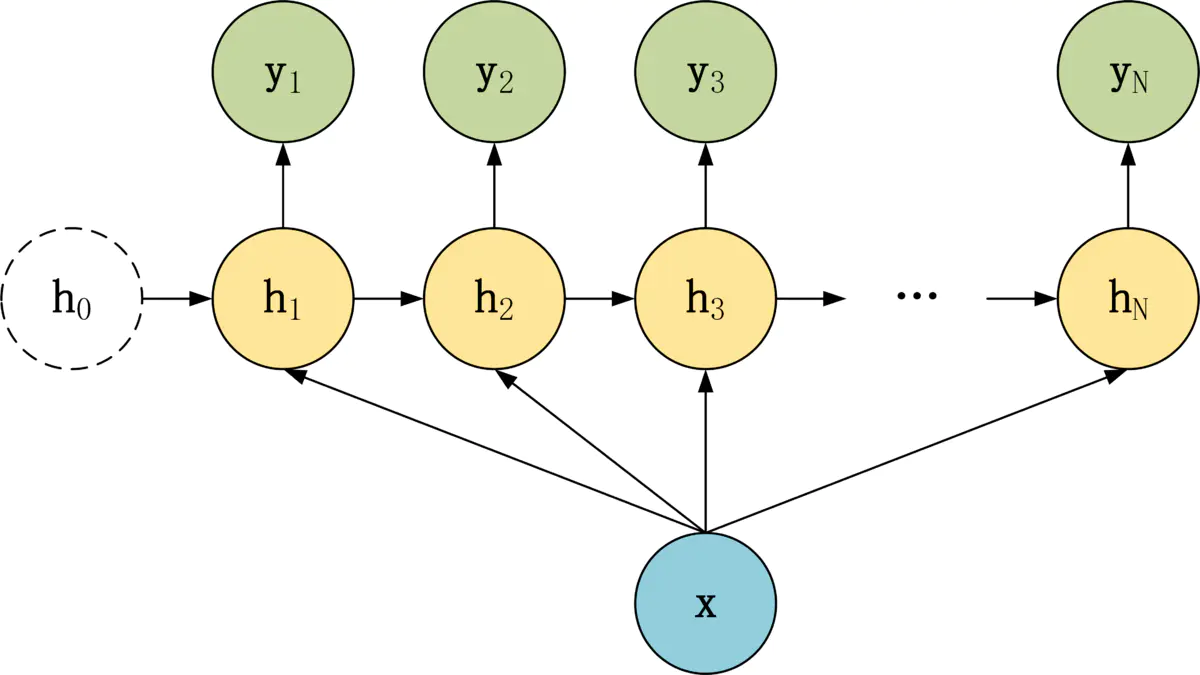
1-N 结构中,只有一个输入 x,和 N 个输出 y1, y2, …, yN。
适合用于以下任务:
- 图像生成文字,输入 x 就是一张图片,输出就是一段图片的描述文字。
- 根据音乐类别,生成对应的音乐。
- 根据小说类别,生成相应的小说。
可以有两种方式实现 1-N:
- 只将输入 x 传入第一个 RNN 神经元
- 将输入 x 传入所有的 RNN 神经元。
N-1 结构
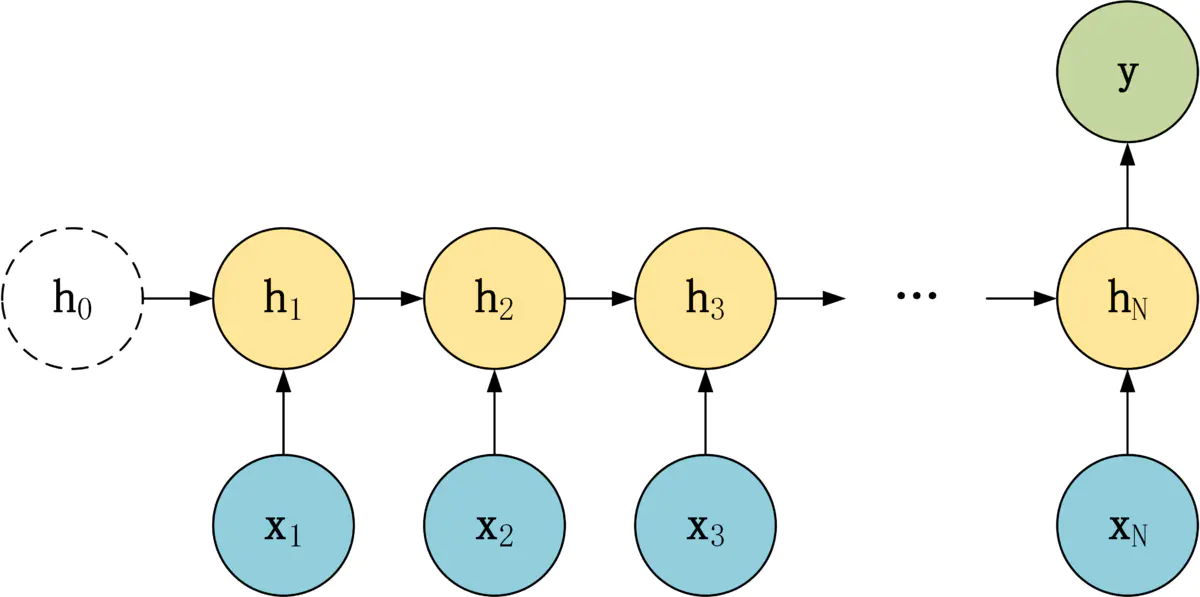
N-1 结构中,有 N 个输入 x1, x2, …, xN,和一个输出 y。
适合用于以下任务:
- 序列分类任务,一段语音、一段文字的类别,句子的情感分析。
RNN 的长序列依赖问题
尽管 RNN 的设计在理论上能够捕捉任意长度的序列依赖关系,但在实践中,RNN 很难学习到 “长期依赖”(Long-Term Dependencies)关系。当 RNN 训练的输入序列太长时,早期时间步的梯度会逐渐消失,导致模型无法记住早期信息,例如:在句子 “I grew up in China…(20 个词后)…so I speak fluent Chinese” 中,RNN 难以关联单词 China 和 Chinese。
梯度消失
梯度消失(Vanishing Gradients):指 RNN 的 BPTT 反向传播过程中,梯度随着时间步或隐藏层数的增加而指数级衰减,导致远离输出层的参数几乎无法得到有效更新。最早在 1991 年,Sepp Hochreiter 在他的毕业论文中阐述了梯度消失问题,当梯度在稍微深一点的 RNN 网络中进行反向传播时,他会发现前面隐藏层的权重参数几乎不更新了,因为这时的梯度几乎为零。
梯度消失的根本原因是 “累乘衰减”,在反向传播梯度时,如果 tanh 激活函数的导数持续小于 1,那么梯度在每一步传播时都会被乘以一个小于 1 的权重矩阵。经过多个时间步后,梯度就会越来越小,几乎接近于零。继而导致网络无法更新前面层的权重,推理时会表现出 “忘记” 了早期的信息。
梯度消失的程度可以使用 “梯度衰减比” 来进行衡量:
梯度衰减比 = 首步梯度 / 末步梯度
如果梯度衰减比 < 0.1,则表示梯度严重消失。因为此时 “首步梯度 << 末步梯度”,即:序列开始位置的梯度远远地小于结束位置。如下所示:
时间步:  t=0    t=1    t=2    ...    t=48   t=49
梯度:    0.001  0.003  0.005  ...    0.15   0.20
         ↑                                   ↑
      几乎为0                              正常大小
RNN 梯度消失的数学原理在反向传播的梯度计算链式法则上,链式法则的连乘导致了早期梯度的 “累乘衰减”,越早期,衰减越厉害,直至几乎为 0。
- 前向计算:
# 第一层隐藏状态计算
h1(t) = tanh(W_hh1 · h1(t-1) + W_xh1 · x(t) + b_h1)
# 第二层隐藏状态计算
h1(t) = tanh(W_hh1 · h1(t-1) + W_xh1 · x(t) + b_h1)
# 输出计算
y(t) = softmax(W_hy2 · h2(t) + b_y2)
- 反向传播中的梯度链式法则:
# 计算早期时间步 t=0 的隐藏状态 h(0) 的梯度
∂L/∂h(0) = ∂L/∂h(T) · ∂h(T)/∂h(T-1) · ∂h(T-1)/∂h(T-2) · ... · ∂h(1)/∂h(0)

# 对于 tanh 激活函数的 RNN:
∂h(t)/∂h(t-1) = diag(tanh'(·)) · W_hh
# 其中,tanh'(x) 的范围是 (0, 1],并且通常是 < 0.5
tanh'(x) = 1 - tanh²(x) ∈ (0, 1]

# 带入求解隐藏状态 h(0) 的梯度,公式如下:
∂L/∂h(0) = ∂L/∂h(T) · ∏(t=1 to T) [diag(tanh'(·)) · W_hh]
# 如果每个时间步的梯度都 < 1,那么早期梯度会出现指数级的衰减。
可见,由于梯度消失问题,RNN 的 “历史记忆” 实际上是短暂的,这限制了它在需要理解长篇文本或分析长期时间序列等任务中的应用。
梯度爆炸
梯度爆炸(Exploding Gradients):和梯度消失相反,如果权重矩阵的值很大,梯度在反向传播过程中可能会指数级增长,导致数值溢出(FP32/16)和训练过程的不稳定。
梯度爆炸可以通过梯度裁剪(Gradient Clipping)等技术相对容易地解决,相对的梯度消失问题则更为棘手。
LSTM(长短期记忆网络)
1997 年,Sepp Hochreiter 和 Jürgen Schmidhuber 发表了论文《Long Short-Term Memory》提出了 LSTM(长短期记忆网络)。
LSTM 是一种特殊且复杂的 RNN,它通过使用专门的记忆单元和门控机制来序列数据中的长期依赖关系,能够学习到 “何时” 记忆信息、何时遗忘信息以及何时输出信息。解决了 RNN 的梯度消失问题。
模型结构与数学表达
LSTM 的核心思想是随时间选择性地记住或遗忘信息,通过记忆单元的线性传递路径(类似信息高速公路)和门控机制,避免梯度在长序列中衰减,相当于为梯度传递安装了中继器。
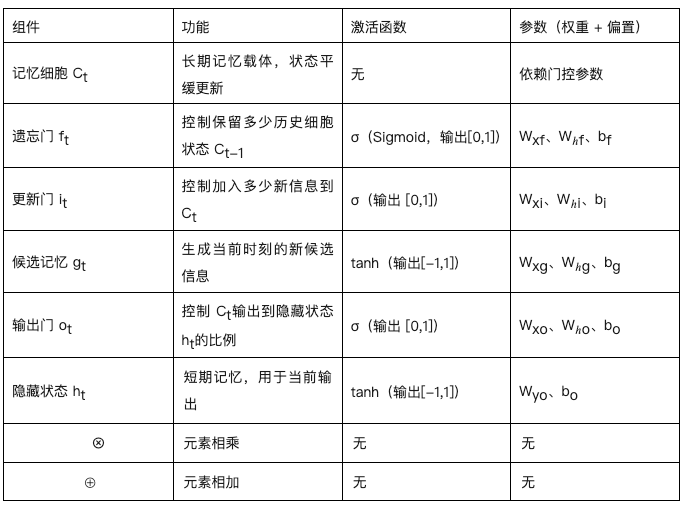
LSTM 将 RNN 中的隐藏层单元换成了一种具有特殊记忆功能的循环体结构,在隐藏层状态 h_t 的基础上增加了记忆单元状态(Memory Cell State) C_t。
如下图所示,LSTM 在模型结构的关键创新是引入了一个 Memory Cell(记忆细胞),并在内部实现了 “输入 => 门控 => 输出” 的控制机制,以此来解决 RNN 梯度消失的问题。
- 输入:包括当前输入、上一时间步的隐藏状态(Hidden State)、上一时间步的记忆单元状态(Cell State)。
- 门控:每个 Cell 包含了 “记忆、遗忘、输出” 这 3 个关键的门,它们互相协作共同更新当前时间步的记忆单元状态(如图最上方连线)。门的本质是一个由 Sigmoid 激活函数和一个点积乘法操作组成的神经网络层。Sigmoid 函数的输出在 0~1 之间,这个值决定了有多少信息可以通过。0 表示 “完全不允许通过”,而 1 表示 “完全允许通过”,0-1 表示保留部分信息。
- 输出:包括当前记忆单元状态和当前输出。
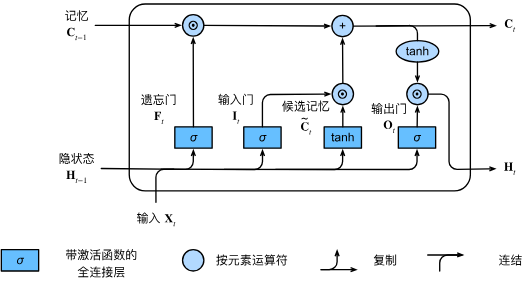
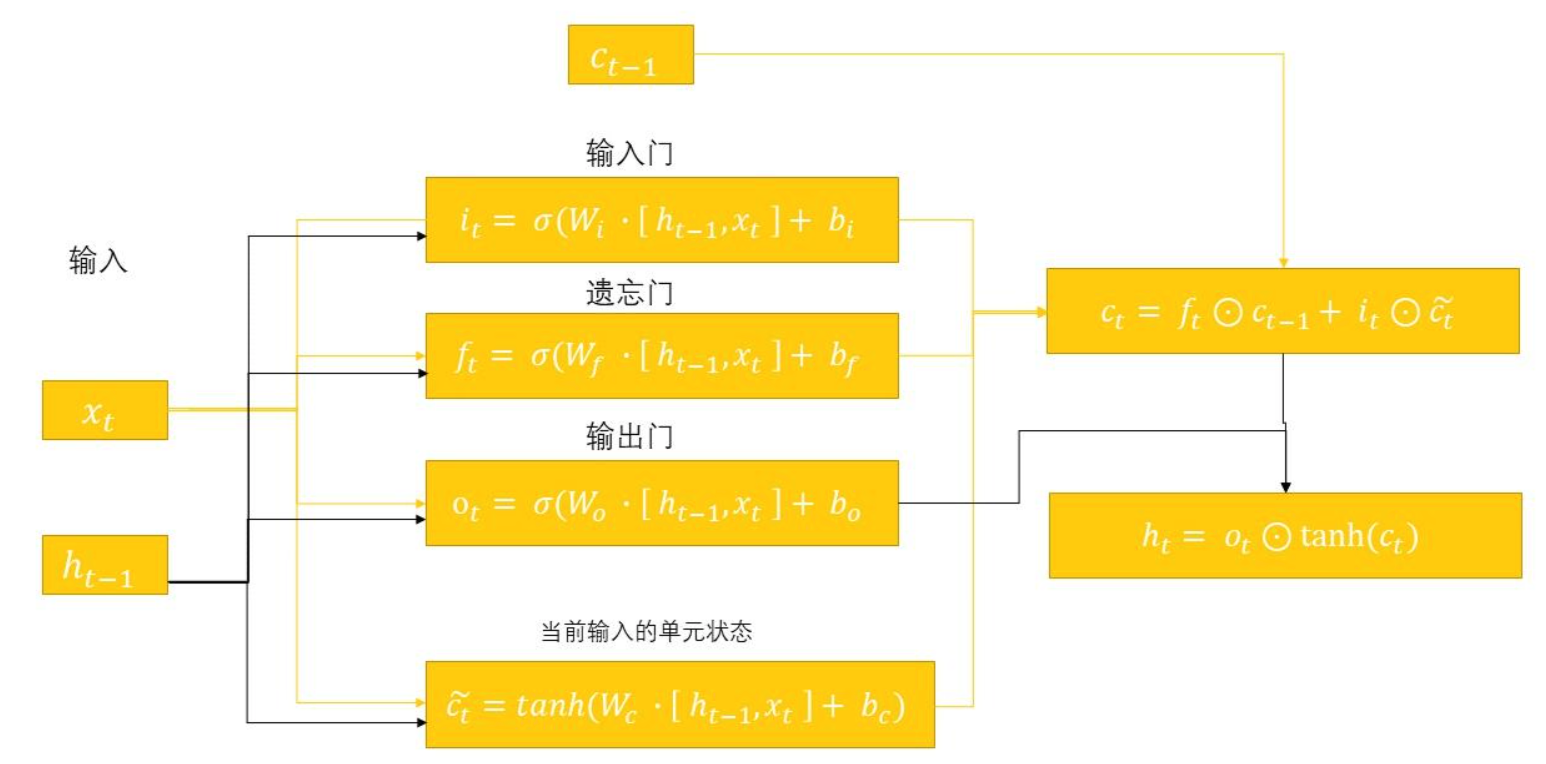
- 遗忘门(Forget Gate):控制历史信息的保留。利用 sigmoid 激活函数,它获取 h_t-1 和 x_t,并为 C_t-1 中的每个数字输出一个 0~1 之间的值。这个值代表了保留或遗忘的程度。
f_t = σ(W_f * [h_t-1, x_t] + b_f)
- 输入门(Input Gate):控制当前时刻的输入中有多少信息要被添加到 Cell State 中。首先通过 sigmoid 函数确定需要添加的信息。然后通过 tanh 函数创建一个候选的记忆单元状态向量 C̃_t,该向量可以被添加到记忆单元状态中。
i_t = σ(W_i * [h_t-1, x_t] + b_i)
C̃_t = tanh(W_c * [h_t-1, x_t] + b_c)
- 记忆单元状态更新:通过处理要遗忘和要保留的信息,完成上一时刻的记忆单元状态 C_t-1 到当前时刻 C_t 的更新(矩阵乘积)更新。先将 C_t-1* f_t(要遗忘的旧信息),然后 “+” 加上 i_t * C̃_t(要添加的新信息)。
C_t = f_t * C_t-1 + i_t * C̃_t
- 输出门 (Output Gate):控制输出的过程。首先 sigmoid 层决定记忆单元状态 C_t 的哪些部分将要输出。然后 C_t 通过 tanh 函数(将其值缩放到 -1~1 之间),并将其与 sigmoid 层的输出相乘,从而只会输出了想要输出的部分。这个输出就是新的隐藏状态 h_t。
o_t = σ(W_o * [h_t-1, x_t] + b_o)
h_t = o_t * tanh(C_t)
使用 PyTorch 实现一个单层的 LSTM
直接将上述单层 RNN 模型改在为 LSTM 即可。
import torch
import torch.nn as nn
import torch.optim as optim

# ---------------------- 1. 定义最简LSTM(替换原RNN,适配序列级分类) ----------------------
class SimpleLSTM(nn.Module):
    def __init__(self, input_dim, hidden_dim, output_dim):
        super(SimpleLSTM, self).__init__()
        # LSTM核心参数:3个门(输入门i、遗忘门f、输出门o)+ 候选细胞状态c~
        # 门控权重形状:隐藏层维度 × (输入维度+隐藏维度),拆分后如下:
        # 输入门(i):控制哪些新信息进入细胞状态
        self.W_xi = nn.Parameter(torch.randn(hidden_dim, input_dim) * 0.1)  # 输入→输入门
        self.W_hi = nn.Parameter(torch.randn(hidden_dim, hidden_dim) * 0.1) # 隐藏→输入门
        self.b_i = nn.Parameter(torch.zeros(hidden_dim, 1))
        # 遗忘门(f):控制哪些旧信息从细胞状态中遗忘
        self.W_xf = nn.Parameter(torch.randn(hidden_dim, input_dim) * 0.1)  # 输入→遗忘门
        self.W_hf = nn.Parameter(torch.randn(hidden_dim, hidden_dim) * 0.1) # 隐藏→遗忘门
        self.b_f = nn.Parameter(torch.zeros(hidden_dim, 1))
        # 输出门(o):控制细胞状态的哪些部分输出为隐藏状态
        self.W_xo = nn.Parameter(torch.randn(hidden_dim, input_dim) * 0.1)  # 输入→输出门
        self.W_ho = nn.Parameter(torch.randn(hidden_dim, hidden_dim) * 0.1) # 隐藏→输出门
        self.b_o = nn.Parameter(torch.zeros(hidden_dim, 1))
        # 候选细胞状态(c~):生成待更新的细胞状态
        self.W_xc = nn.Parameter(torch.randn(hidden_dim, input_dim) * 0.1)  # 输入→候选细胞
        self.W_hc = nn.Parameter(torch.randn(hidden_dim, hidden_dim) * 0.1) # 隐藏→候选细胞
        self.b_c = nn.Parameter(torch.zeros(hidden_dim, 1))

        # 输出层参数(和原RNN一致)
        self.W_hy = nn.Parameter(torch.randn(output_dim, hidden_dim) * 0.1)
        self.b_y = nn.Parameter(torch.zeros(output_dim, 1))

        # 维度记录
        self.input_dim = input_dim
        self.hidden_dim = hidden_dim
        self.output_dim = output_dim

    def forward(self, x_seq):
        """
        LSTM前向传播(序列级分类:仅用最后一个时间步的隐藏状态输出)
        核心:维护两个状态——隐藏状态h + 细胞状态c(解决RNN梯度消失的关键)
        """
        # 初始化隐藏状态h0和细胞状态c0(全0)
        h_prev = torch.zeros(self.hidden_dim, 1)
        c_prev = torch.zeros(self.hidden_dim, 1)

        # 逐时间步更新LSTM状态
        for t in range(x_seq.shape[0]):
            x_t = x_seq[t].unsqueeze(1)  # [输入维度, 1]

            # ========== 1. 计算3个门控值(sigmoid激活,输出0~1) ==========
            # 输入门:i_t = σ(W_xi·x_t + W_hi·h_prev + b_i)
            i_t = torch.sigmoid(self.W_xi @ x_t + self.W_hi @ h_prev + self.b_i)
            # 遗忘门:f_t = σ(W_xf·x_t + W_hf·h_prev + b_f)
            f_t = torch.sigmoid(self.W_xf @ x_t + self.W_hf @ h_prev + self.b_f)
            # 输出门:o_t = σ(W_xo·x_t + W_ho·h_prev + b_o)
            o_t = torch.sigmoid(self.W_xo @ x_t + self.W_ho @ h_prev + self.b_o)

            # ========== 2. 计算候选细胞状态(tanh激活,输出-1~1) ==========
            # 候选细胞:c_tilde = tanh(W_xc·x_t + W_hc·h_prev + b_c)
            c_tilde = torch.tanh(self.W_xc @ x_t + self.W_hc @ h_prev + self.b_c)

            # ========== 3. 更新细胞状态(核心:遗忘旧信息+加入新信息) ==========
            # c_t = f_t ⊙ c_prev + i_t ⊙ c_tilde (⊙=按元素乘)
            c_t = f_t * c_prev + i_t * c_tilde

            # ========== 4. 更新隐藏状态 ==========
            # h_t = o_t ⊙ tanh(c_t)
            h_t = o_t * torch.tanh(c_t)

            # 传递状态到下一个时间步
            h_prev = h_t
            c_prev = c_t

        # 序列级分类:用最后一个时间步的隐藏状态计算输出(和原RNN逻辑一致)
        y_final = self.W_hy @ h_prev + self.b_y
        y_final = torch.log_softmax(y_final, dim=0)  # 二分类对数概率
        return y_final, h_prev

# ---------------------- 2. 数据准备(和原RNN完全一致) ----------------------
vocab = {
    "电影": 0, "好看": 1, "饭菜": 2, "难吃": 3,
    "天气": 4, "糟糕": 5, "音乐": 6, "好听": 7,
    "剧情": 8, "一般": 9, "但": 10, "演技": 11, "好": 12,
    "难看": 13, "好吃": 14, "心情": 15, "分量": 16, "少": 17
}
vocab_size = len(vocab)

train_data = [
    ("电影 好看", 1),       # 正面
    ("饭菜 难吃", 0),       # 负面
    ("天气 糟糕", 0),       # 负面
    ("音乐 好听", 1),       # 正面
    ("电影 难看", 0),       # 负面
    ("饭菜 好吃", 1)        # 正面
]

def text2onehot(text):
    words = text.split()
    onehot_seq = []
    for word in words:
        onehot = torch.zeros(vocab_size)
        if word in vocab:
            onehot[vocab[word]] = 1.0
        onehot_seq.append(onehot)
    return torch.stack(onehot_seq)

# ---------------------- 3. 模型初始化与训练配置(仅修改模型类名) ----------------------
input_dim = vocab_size
hidden_dim = 4
output_dim = 2
model = SimpleLSTM(input_dim, hidden_dim, output_dim)  # 核心修改:SimpleRNN→SimpleLSTM

criterion = nn.NLLLoss()
optimizer = optim.SGD(model.parameters(), lr=0.1)

# ---------------------- 4. 训练过程(和原RNN完全一致) ----------------------
epochs = 1000
for epoch in range(epochs):
    total_loss = 0.0
    for text, label in train_data:
        x_seq = text2onehot(text)
        y_true = torch.tensor([label])

        y_pred, _ = model(x_seq)
        y_pred_reshaped = y_pred.squeeze(1).reshape(1, 2)
        loss = criterion(y_pred_reshaped, y_true)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_loss += loss.item()

    if (epoch + 1) % 100 == 0:
        print(f"Epoch {epoch+1}, Loss: {total_loss/len(train_data):.4f}")

# ---------------------- 5. 测试(和原RNN完全一致,但效果更好) ----------------------
def predict(text):
    model.eval()
    with torch.no_grad():
        x_seq = text2onehot(text)
        y_pred, _ = model(x_seq)
        y_pred_reshaped = y_pred.squeeze(1).reshape(1, 2)
        pred_label = torch.argmax(y_pred_reshaped).item()
        emotion = "正面" if pred_label == 1 else "负面"
        return f"文本:{text} → 预测情感:{emotion}(标签:{pred_label})"

# 5.1 基础示例
print("\n===== 基础示例(极短简单文本) =====")
print(predict("电影 好看"))   # 预期:正面
print(predict("饭菜 难吃"))   # 预期:负面
print(predict("音乐 好听"))   # 预期:正面

# 5.2 复杂示例(LSTM能正确分类,原RNN会失败)
print("\n===== 复杂示例(长/含矛盾语义文本) =====")
print(predict("电影 剧情 一般 但 演技 好"))  # LSTM:正面(原RNN:错误)
print(predict("天气 糟糕 但 心情 好"))        # LSTM:正面(原RNN:负面)
print(predict("饭菜 好吃 但 分量 少"))        # LSTM:负面(原RNN:错误)
解决 RNN 梯度消失问题
上述过程可知,LSTM Memory Cell 中的门控机制约束了哪些信息是可以遗忘的、哪些信息是可以记住的、哪些信息是可以输出的。
其独特的 Cell State 更新公式 C_t = f_t * C_t-1 + …,让 C_t 的梯度包含一个 f_t 因子,通过学习,遗忘门可以设置 f_t 为接近 1 的值,从而允许梯度在许多时间步内几乎无衰减地流动,这样就解决了 RNN “累积衰减” 的问题。这种结构使得 LSTM 网络更容易学习和保持长期依赖关系。
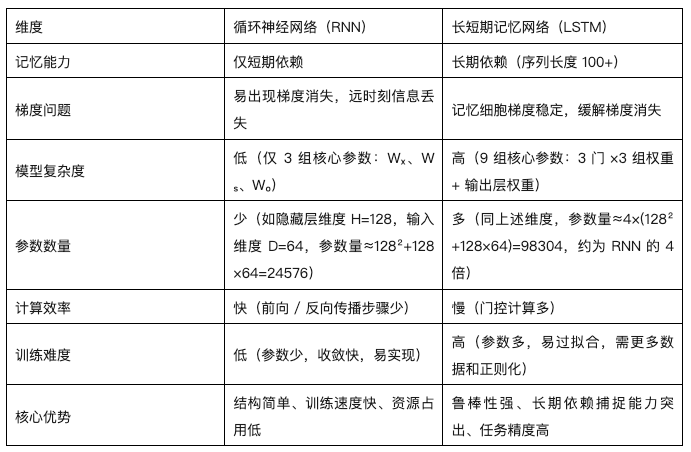
RNN v.s LSTM
RNN 作为序列建模的 “基石”,以简单的循环结构开创了历史信息复用的思路,但受限于梯度消失无法处理长序列;LSTM 则通过记忆细胞和门控机制的创新,从梯度传递路径上解决了长期依赖问题,成为长序列任务的经典方案。
RNN 优势:
- 结构简单,参数少;
- 适用于短期依赖序列建模;
- 训练速度快,适合资源受限场景。
RNN 劣势:
- 容易陷入梯度消失/爆炸;
- 长期依赖学习能力弱。
LSTM 优势:
- 通过门控机制保留长期信息;
- 性能更稳定,泛化能力强;
- 适用于文本、语音、金融等长时间序列建模。
LSTM 劣势:
- 参数多,训练成本高;
- 相比 RNN 更复杂,不易调参。
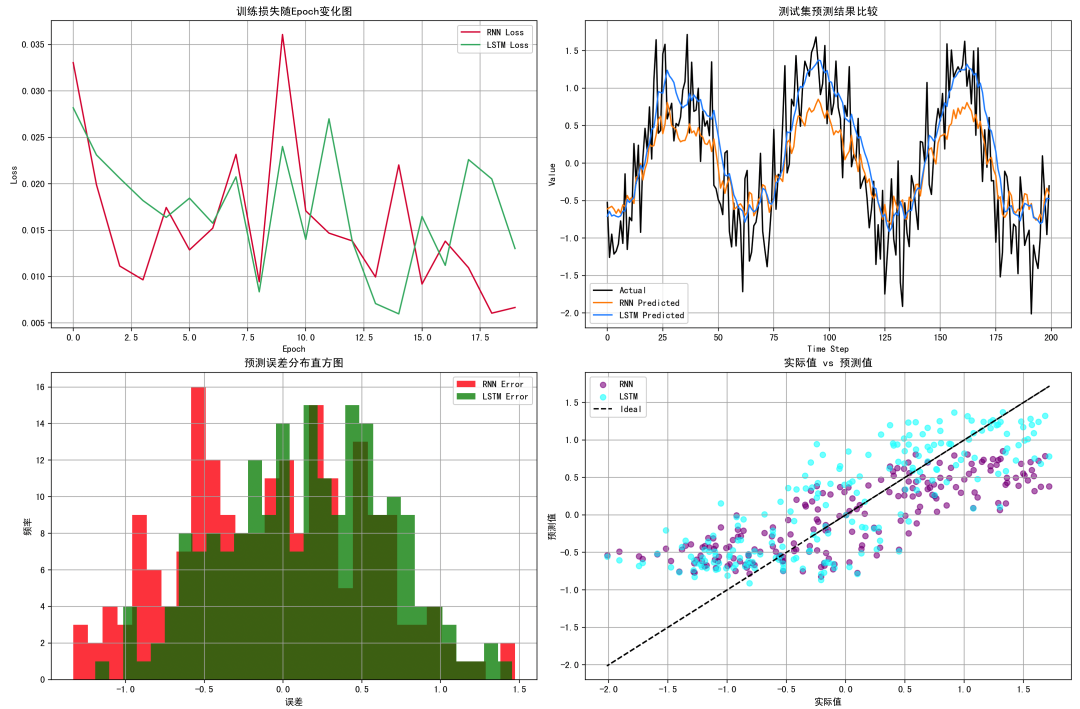
下面是一个 RNN 和 LSTM 的对比测试,基于 PyTorch 内建库实现了 1 个单层的 RNN 和 LSTM,对比结果如下:
- 训练损失曲线:展示模型随训练过程损失的下降趋势。LSTM 收敛更快,且最终损失更低,表明其对序列建模更有效。
- 测试集预测结果对比:可视化真实值与两种模型的预测值对比。LSTM 更紧密拟合真实趋势,RNN 预测波动性较大。
- 误差分布图:分析两种模型预测误差的分布范围。LSTM 的误差集中度高,波动小;RNN 误差分布更宽,精度低。
- 实际 vs 预测散点图:检查预测值与真实值的一致性。LSTM 点更集中在理想线附近,说明相关性更高。
import numpy as np
import pandas as pd
import torch
import torch.nn as nn
import matplotlib.pyplot as plt
from sklearn.preprocessing import MinMaxScaler
from torch.utils.data import Dataset, DataLoader
from sklearn.metrics import mean_squared_error

# 设置随机种子
np.random.seed(42)
torch.manual_seed(42)

# 创建一个合成的时间序列数据(正弦波+噪声)
t = np.arange(0, 100, 0.1)
data = np.sin(t) + np.random.normal(scale=0.5, size=len(t))
df = pd.DataFrame(data, columns=['value'])

# 数据归一化
scaler = MinMaxScaler()
df['value'] = scaler.fit_transform(df[['value']])

# 创建数据集类
class TimeSeriesDataset(Dataset):
    def __init__(self, data, seq_length):
        self.data = data
        self.seq_length = seq_length

    def __len__(self):
        return len(self.data) - self.seq_length

    def __getitem__(self, idx):
        x = self.data[idx:idx+self.seq_length]
        y = self.data[idx+self.seq_length]
        return torch.FloatTensor(x), torch.FloatTensor([y])

# 创建训练和测试数据
seq_length = 20
train_size = int(len(df) * 0.8)
train_data = df['value'].values[:train_size]
test_data = df['value'].values[train_size - seq_length:]

train_dataset = TimeSeriesDataset(train_data, seq_length)
test_dataset = TimeSeriesDataset(test_data, seq_length)

train_loader = DataLoader(train_dataset, batch_size=64, shuffle=True)
test_loader = DataLoader(test_dataset, batch_size=1, shuffle=False)

# 定义 RNN 模型
class RNNModel(nn.Module):
    def __init__(self, input_size=1, hidden_size=50):
        super(RNNModel, self).__init__()
        self.rnn = nn.RNN(input_size, hidden_size, batch_first=True)
        self.fc = nn.Linear(hidden_size, 1)

    def forward(self, x):
        out, _ = self.rnn(x.unsqueeze(-1))
        out = self.fc(out[:, -1, :])
        return out

# 定义 LSTM 模型
class LSTMModel(nn.Module):
    def __init__(self, input_size=1, hidden_size=50):
        super(LSTMModel, self).__init__()
        self.lstm = nn.LSTM(input_size, hidden_size, batch_first=True)
        self.fc = nn.Linear(hidden_size, 1)

    def forward(self, x):
        out, _ = self.lstm(x.unsqueeze(-1))
        out = self.fc(out[:, -1, :])
        return out

# 训练函数
def train_model(model, train_loader, num_epochs=10):
    criterion = nn.MSELoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=0.01)
    losses = []

    for epoch in range(num_epochs):
        for x_batch, y_batch in train_loader:
            optimizer.zero_grad()
            output = model(x_batch)
            loss = criterion(output, y_batch)
            loss.backward()
            optimizer.step()
        losses.append(loss.item())
    return model, losses

# 预测函数
def predict(model, data_loader):
    model.eval()
    predictions = []
    actuals = []
    with torch.no_grad():
        for x_batch, y_batch in data_loader:
            pred = model(x_batch)
            predictions.append(pred.item())
            actuals.append(y_batch.item())
    return np.array(predictions), np.array(actuals)

# 初始化模型并训练
rnn_model = RNNModel()
lstm_model = LSTMModel()

rnn_model, rnn_losses = train_model(rnn_model, train_loader, num_epochs=20)
lstm_model, lstm_losses = train_model(lstm_model, train_loader, num_epochs=20)

# 模型预测
rnn_preds, rnn_actuals = predict(rnn_model, test_loader)
lstm_preds, lstm_actuals = predict(lstm_model, test_loader)

# 反归一化预测值
rnn_preds_inv = scaler.inverse_transform(rnn_preds.reshape(-1, 1)).flatten()
lstm_preds_inv = scaler.inverse_transform(lstm_preds.reshape(-1, 1)).flatten()
actuals_inv = scaler.inverse_transform(lstm_actuals.reshape(-1, 1)).flatten()

# 绘制图像
plt.figure(figsize=(16, 12))

# 图1: 损失函数曲线
plt.subplot(2, 2, 1)
plt.plot(rnn_losses, label='RNN Loss', color='crimson')
plt.plot(lstm_losses, label='LSTM Loss', color='mediumseagreen')
plt.title('训练损失随Epoch变化图')
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.legend()
plt.grid(True)

# 图2: 测试集预测结果比较
plt.subplot(2, 2, 2)
plt.plot(actuals_inv, label='Actual', color='black')
plt.plot(rnn_preds_inv, label='RNN Predicted', color='darkorange')
plt.plot(lstm_preds_inv, label='LSTM Predicted', color='dodgerblue')
plt.title('测试集预测结果比较')
plt.xlabel('Time Step')
plt.ylabel('Value')
plt.legend()
plt.grid(True)

# 图3: 预测误差分布直方图
plt.subplot(2, 2, 3)
rnn_error = rnn_preds_inv - actuals_inv
lstm_error = lstm_preds_inv - actuals_inv
plt.hist(rnn_error, bins=30, alpha=0.7, label='RNN Error', color='red')
plt.hist(lstm_error, bins=30, alpha=0.7, label='LSTM Error', color='green')
plt.title('预测误差分布直方图')
plt.xlabel('误差')
plt.ylabel('频率')
plt.legend()
plt.grid(True)

# 图4: 实际 vs 预测散点图
plt.subplot(2, 2, 4)
plt.scatter(actuals_inv, rnn_preds_inv, label='RNN', alpha=0.5, color='purple')
plt.scatter(actuals_inv, lstm_preds_inv, label='LSTM', alpha=0.5, color='cyan')
plt.plot(actuals_inv, actuals_inv, color='black', linestyle='--', label='Ideal')
plt.title('实际值 vs 预测值')
plt.xlabel('实际值')
plt.ylabel('预测值')
plt.legend()
plt.grid(True)

plt.tight_layout()
plt.show()
GRU(门控循环单元)
2014 年,Cho 等人提出了 GRU(门控循环单元),是 LSTM 的一个简化版本。它保持了与 LSTM 相当性能的同时,结构更简单,参数更少,计算效率更高。
模型结构和数据表达
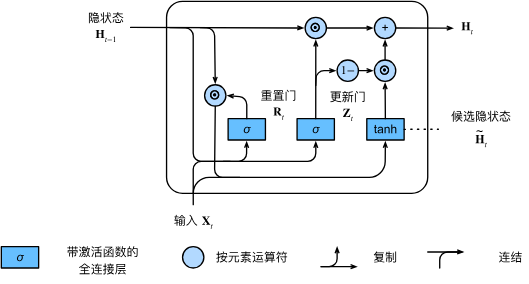
GRU 在模型结构上的主要创新在于它将 LSTM 的遗忘门和输入门合并为了一个单一的更新门(Update Gate),并且它还合并了记忆单元状态和隐藏状态。
GRU 只有两个门:
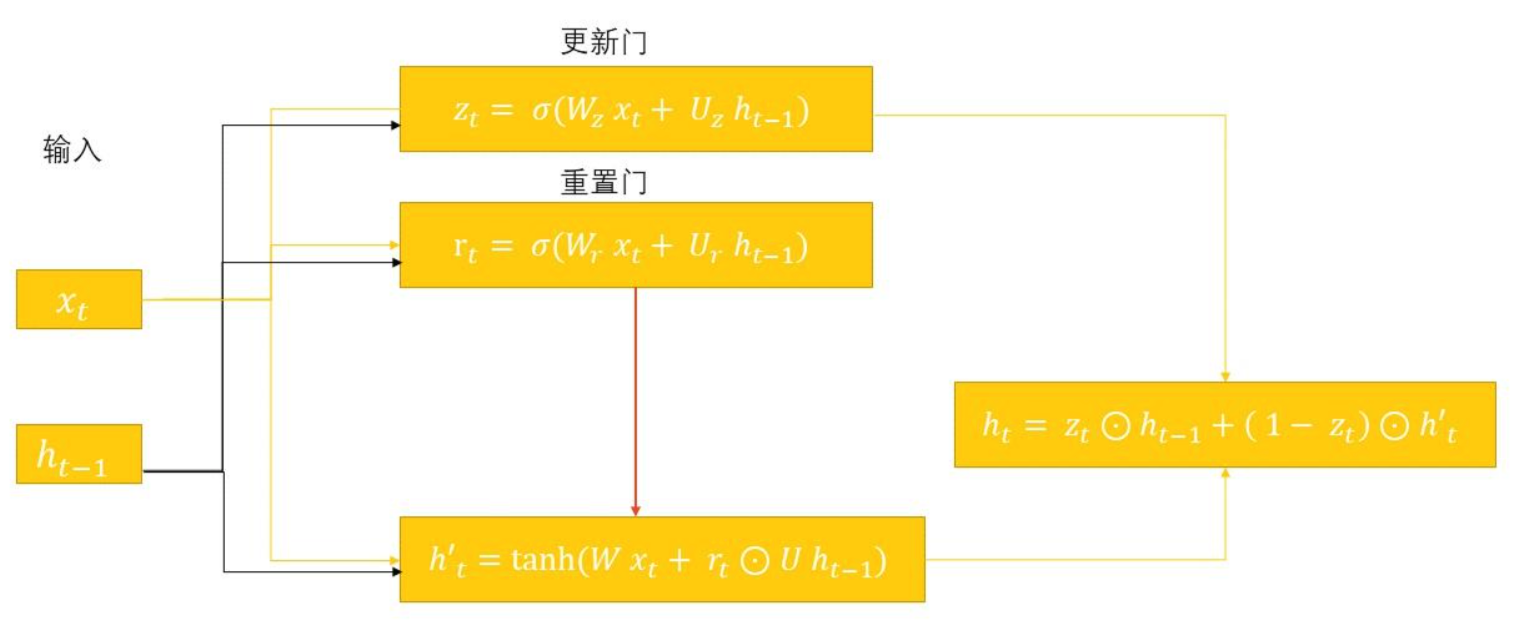
- 更新门(Update Gate):决定了应该在多大程度上保留前一个时间步的信息,以及在多大程度上接收新生成的信息。 它类似于 LSTM 中遗忘门和输入门的组合。
z_t = σ(W_z * [h_t-1, x_t] + b_z)
- 重置门(Reset Gate):决定了在计算新的候选隐藏状态时,应该忽略多少过去的信息。 如果重置门的输出接近 0,那么模型在计算候选状态时将主要依赖于当前输入 x_t。
r_t = σ(W_r * [h_t-1, x_t] + b_r)
- 候选隐藏状态与最终隐藏状态:首先,使用重置门计算一个候选隐藏状态 h̃_t 重置门 r_t 作用于 h_{t-1},控制了前一状态对候选状态的影响。然后,更新门 z_t 在 h_{t-1} 和 h̃_t 之间进行线性插值,以产生最终的隐藏状态 h_t。
h̃_t = tanh(W_h * [r_t * h_t-1, x_t] + b_h)
h_t = (1 - z_t) * h_t-1 + z_t * h̃_t
当 z_t 接近 1 时,新的隐藏状态 h_t 主要由候选状态 h̃_t 构成;当 z_t 接近 0 时,新的隐藏状态 h_t 则几乎完全保留了前一个状态 h_{t-1}。这种机制使得 GRU 也能有效地捕捉长期依赖。
使用 PyTorch 实现一个单层的 GRU
import torch
import torch.nn as nn
import torch.optim as optim

# ---------------------- 1. 定义最简单层GRU(替换原LSTM) ----------------------
class SimpleGRU(nn.Module):
    def __init__(self, input_dim, hidden_dim, output_dim):
        super(SimpleGRU, self).__init__()
        # GRU核心参数:2个门(更新门z、重置门r)+ 候选隐藏状态h~
        # 权重初始化用*0.1避免梯度爆炸,偏置初始化为0(GRU最佳实践)
        # 1. 更新门(z_t):融合遗忘门+输入门,控制旧/新信息的保留比例
        self.W_xz = nn.Parameter(torch.randn(hidden_dim, input_dim) * 0.1)  # 输入→更新门
        self.W_hz = nn.Parameter(torch.randn(hidden_dim, hidden_dim) * 0.1) # 隐藏→更新门
        self.b_z = nn.Parameter(torch.zeros(hidden_dim, 1))
        # 2. 重置门(r_t):控制计算候选状态时,忽略多少过去的隐藏状态
        self.W_xr = nn.Parameter(torch.randn(hidden_dim, input_dim) * 0.1)  # 输入→重置门
        self.W_hr = nn.Parameter(torch.randn(hidden_dim, hidden_dim) * 0.1) # 隐藏→重置门
        self.b_r = nn.Parameter(torch.zeros(hidden_dim, 1))
        # 3. 候选隐藏状态(h̃_t):生成待融合的新隐藏状态
        self.W_xh = nn.Parameter(torch.randn(hidden_dim, input_dim) * 0.1)  # 输入→候选隐藏
        self.W_hh = nn.Parameter(torch.randn(hidden_dim, hidden_dim) * 0.1) # 隐藏→候选隐藏
        self.b_h = nn.Parameter(torch.zeros(hidden_dim, 1))

        # 输出层参数(和原LSTM/RNN完全一致)
        self.W_hy = nn.Parameter(torch.randn(output_dim, hidden_dim) * 0.1)
        self.b_y = nn.Parameter(torch.zeros(output_dim, 1))

        # 维度记录
        self.input_dim = input_dim
        self.hidden_dim = hidden_dim
        self.output_dim = output_dim

    def forward(self, x_seq):
        """
        GRU前向传播(序列级分类:仅用最后一个时间步的隐藏状态输出)
        核心:仅维护隐藏状态h(GRU无细胞状态c,结构比LSTM更简洁)
        公式严格遵循你给出的定义:
        1. z_t = σ(W_z*[h_prev, x_t] + b_z) → 拆分后:z_t = σ(W_xz·x_t + W_hz·h_prev + b_z)
        2. r_t = σ(W_r*[h_prev, x_t] + b_r) → 拆分后:r_t = σ(W_xr·x_t + W_hr·h_prev + b_r)
        3. h̃_t = tanh(W_h*[r_t·h_prev, x_t] + b_h) → 拆分后:h̃_t = tanh(W_xh·x_t + W_hh·(r_t·h_prev) + b_h)
        4. h_t = (1-z_t)·h_prev + z_t·h̃_t
        """
        # 初始化隐藏状态h0(全0,GRU无细胞状态c)
        h_prev = torch.zeros(self.hidden_dim, 1)

        # 逐时间步更新GRU隐藏状态
        for t in range(x_seq.shape[0]):
            x_t = x_seq[t].unsqueeze(1)  # [输入维度, 1],适配矩阵乘法

            # ========== 1. 计算更新门(z_t):sigmoid激活,输出0~1 ==========
            # z_t越接近1:越倾向于使用新的候选状态h̃_t;越接近0:越倾向于保留旧状态h_prev
            z_t = torch.sigmoid(self.W_xz @ x_t + self.W_hz @ h_prev + self.b_z)

            # ========== 2. 计算重置门(r_t):sigmoid激活,输出0~1 ==========
            # r_t越接近0:越忽略旧状态h_prev,仅用当前输入x_t计算候选状态;越接近1:越保留旧状态
            r_t = torch.sigmoid(self.W_xr @ x_t + self.W_hr @ h_prev + self.b_r)

            # ========== 3. 计算候选隐藏状态(h̃_t):tanh激活,输出-1~1 ==========
            # 核心:重置门r_t按元素乘h_prev,控制旧状态对候选状态的影响
            h_tilde = torch.tanh(self.W_xh @ x_t + self.W_hh @ (r_t * h_prev) + self.b_h)

            # ========== 4. 计算最终隐藏状态(h_t):线性插值融合旧/新状态 ==========
            h_t = (1 - z_t) * h_prev + z_t * h_tilde

            # 传递隐藏状态到下一个时间步
            h_prev = h_t

        # 序列级分类:用最后一个时间步的隐藏状态计算输出(和原LSTM/RNN逻辑一致)
        y_final = self.W_hy @ h_prev + self.b_y
        y_final = torch.log_softmax(y_final, dim=0)  # 二分类对数概率输出
        return y_final, h_prev

# ---------------------- 2. 数据准备(和原代码完全一致) ----------------------
vocab = {
    "电影": 0, "好看": 1, "饭菜": 2, "难吃": 3,
    "天气": 4, "糟糕": 5, "音乐": 6, "好听": 7,
    "剧情": 8, "一般": 9, "但": 10, "演技": 11, "好": 12,
    "难看": 13, "好吃": 14, "心情": 15, "分量": 16, "少": 17
}
vocab_size = len(vocab)

train_data = [
    ("电影 好看", 1),       # 正面
    ("饭菜 难吃", 0),       # 负面
    ("天气 糟糕", 0),       # 负面
    ("音乐 好听", 1),       # 正面
    ("电影 难看", 0),       # 负面
    ("饭菜 好吃", 1)        # 正面
]

def text2onehot(text):
    words = text.split()
    onehot_seq = []
    for word in words:
        onehot = torch.zeros(vocab_size)
        if word in vocab:
            onehot[vocab[word]] = 1.0
        onehot_seq.append(onehot)
    return torch.stack(onehot_seq)

# ---------------------- 3. 模型初始化与训练配置(仅修改模型类名) ----------------------
input_dim = vocab_size
hidden_dim = 4
output_dim = 2
model = SimpleGRU(input_dim, hidden_dim, output_dim)  # 核心修改:SimpleLSTM→SimpleGRU

criterion = nn.NLLLoss()
optimizer = optim.SGD(model.parameters(), lr=0.1)

# ---------------------- 4. 训练过程(和原代码完全一致) ----------------------
epochs = 1000
for epoch in range(epochs):
    total_loss = 0.0
    for text, label in train_data:
        x_seq = text2onehot(text)
        y_true = torch.tensor([label])

        y_pred, _ = model(x_seq)
        y_pred_reshaped = y_pred.squeeze(1).reshape(1, 2)
        loss = criterion(y_pred_reshaped, y_true)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_loss += loss.item()

    if (epoch + 1) % 100 == 0:
        print(f"Epoch {epoch+1}, Loss: {total_loss/len(train_data):.4f}")

# ---------------------- 5. 测试(和原代码完全一致,GRU效果≈LSTM且更简洁) ----------------------
def predict(text):
    model.eval()
    with torch.no_grad():
        x_seq = text2onehot(text)
        y_pred, _ = model(x_seq)
        y_pred_reshaped = y_pred.squeeze(1).reshape(1, 2)
        pred_label = torch.argmax(y_pred_reshaped).item()
        emotion = "正面" if pred_label == 1 else "负面"
        return f"文本:{text} → 预测情感:{emotion}(标签:{pred_label})"

# 5.1 基础示例
print("\n===== 基础示例(极短简单文本) =====")
print(predict("电影 好看"))   # 预期:正面
print(predict("饭菜 难吃"))   # 预期:负面
print(predict("音乐 好听"))   # 预期:正面

# 5.2 复杂示例(GRU能正确分类,效果和LSTM相当,结构更简洁)
print("\n===== 复杂示例(长/含矛盾语义文本) =====")
print(predict("电影 剧情 一般 但 演技 好"))  # GRU:正面
print(predict("天气 糟糕 但 心情 好"))        # GRU:正面
print(predict("饭菜 好吃 但 分量 少"))        # GRU:负面
LSTM v.s. GRU
LSTM 解决了 RNN 因长期依赖带来的梯度消失和梯度爆炸问题,但是 LSTM 有三个不同的门,参数较多,训练起来比较困难。而 GRU 只含有两个门控结构,结构更为简单,参数更少,收敛速度更快。但因为 GRU 的参数更小所以理论上精度和表达能力会稍差于 LSTM。
LSTM 和 GRU 的适用场景不同:
- 长文本或复杂依赖:当数据涉及较长的文本,或任务需要理解复杂的上下文依赖时,LSTM 的强大记忆能力可以发挥优势。例如,处理长篇文章的情感分析、机器翻译等任务。例如:我们分析的是一篇长篇博客文章,其中前半部分描述了一个积极的事件,而后半部分充满了负面情感。要准确捕捉这种情感转变,LSTM 可能是更好的选择,因为它能够通过遗忘门和记忆单元,逐步积累并更新情感信息,从而做出更精确的情感判断。
- 短文本或实时性要求:如果你处理的是短文本,如推特、简短评论,或需模型快速响应,GRU 通常是更好的选择。它的计算效率更高,且在短期依赖场景下表现优异。例如:在分析推特或短句子的情感时,GRU的效率优势更加明显。GRU能快速处理短文本的情感特征,并及时提供预测结果,这对实时分析推特流的情感趋势尤其重要。
在某些场景下,可以尝试混合使用 LSTM 和 GRU,取长补短。例如:在情感分析任务中,如果希望获得高效且准确的模型,可以考虑使用 GRU 处理短文本情感,而使用 LSTM 处理长篇文本情感。通过这种组合方式,可以兼顾速度和准确性,提升整体模型表现。
另外,除了适用场景之外,在选择 LSTM 或 GRU 时,需要考虑以下因素:
- 任务复杂度:如果任务需要处理长期依赖关系,LSTM 可能更适合。而如果任务相对简单,GRU 的表现也可以达到满意水平。
- 计算效率:GRU 相较于 LSTM 具有更少的参数和更简洁的结构,因此在计算效率方面更优。
- 数据规模:对于大规模数据,LSTM 可能更适合,因为它具有更强的表达能力。而对于小规模数据,GRU 的表现也可以达到满意水平。
至今为止,GRU 和 LSTM 在序列处理场景中的价值已经得到了验证,它们两者各有优缺点。理解它们的区别和适用场景,能够帮助你在不同任务中做出更优的选择。
RNN Encoder–Decoder
需求:很多任务需要 “两条不同序列、长度不等” 的映射
现实中大量序列任务,输入和输出是两条不同的序列,且长度天然不相等,例如:
- 机器翻译:“我爱中国”(4 字) → “I love China”(3 词),源语言、目标语言不同,长度也不同。
- 文本摘要:原文长,摘要短。
- 对话系统:问题和回答长度各异。
方案一:单个 RNN 的自回归模型
单个 RNN 的自回归模型,可以把输入和输出拼成一条连续的流,让模型 “边读边续写”,每步输出回喂为下一步输入,直到结束符 EOS。例如翻译可以写成:
我 爱 中 国 <sep> I love China <EOS>
模型读完前半段(源句),接着往下 “续写” 出后半段(译文)。输出长度由续写决定,不再受输入长度约束,所以它确实能做不等长了。
这也正是后文 GPT / Decoder-Only 的思想原型。但在 RNN 时代,这条路有 3 个硬伤:
- 记忆瓶颈:整段源句的信息,只能挤在 “一条边读边写、还不断被后续生成覆盖” 的隐状态里。源句稍长,RNN 就因梯度消失记不住开头 —— 读到译文一半,源句前半已经忘了。
- 无法双向理解输入:自回归只能从左到右因果地读,生成第一个译文词时,还没 “看全” 整个源句。而理解一句话,往往需要结合它后面的词。
- 两条异质序列被硬塞进一条同质流:源语言和目标语言本是两套词表、两种规律,强行塞进一个模型、一条隐状态里,不够自然。
# -*- coding: utf-8 -*-
import torch
import torch.nn as nn
import torch.optim as optim
from torch.optim.lr_scheduler import ReduceLROnPlateau
import random
import numpy as np

# ---------------------- 1. 纯两层RNN(优化隐藏层+正则化) ----------------------
class ImprovedTwoLayerRNN(nn.Module):
    def __init__(self, input_dim, hidden_dim1, hidden_dim2, output_dim, dropout_rate=0.3, weight_decay=1e-4):
        super().__init__()
        # 正交初始化
        def orthogonal_init(w):
            nn.init.orthogonal_(w.data)

        # 第一层RNN(增大隐藏层维度)
        self.W_xh1 = nn.Parameter(torch.randn(hidden_dim1, input_dim))
        self.W_hh1 = nn.Parameter(torch.randn(hidden_dim1, hidden_dim1))
        self.b_h1 = nn.Parameter(torch.zeros(hidden_dim1, 1))
        orthogonal_init(self.W_xh1)
        orthogonal_init(self.W_hh1)

        # 第二层RNN
        self.W_h1h2 = nn.Parameter(torch.randn(hidden_dim2, hidden_dim1))
        self.W_hh2 = nn.Parameter(torch.randn(hidden_dim2, hidden_dim2))
        self.b_h2 = nn.Parameter(torch.zeros(hidden_dim2, 1))
        orthogonal_init(self.W_h1h2)
        orthogonal_init(self.W_hh2)

        # 输出层
        self.W_hy2 = nn.Parameter(torch.randn(output_dim, hidden_dim2))
        self.b_y2 = nn.Parameter(torch.zeros(output_dim, 1))
        orthogonal_init(self.W_hy2)

        # 增强正则化
        self.dropout = nn.Dropout(dropout_rate)
        self.weight_decay = weight_decay

    def forward(self, x_seq):
        h1 = torch.zeros(self.W_hh1.shape[0], 1)
        h2 = torch.zeros(self.W_hh2.shape[0], 1)
        all_preds = []

        for t in range(x_seq.shape[0]):
            x_t = x_seq[t].unsqueeze(1)

            # 第一层RNN(归一化+Dropout)
            h1 = torch.tanh(torch.matmul(self.W_hh1, h1) + torch.matmul(self.W_xh1, x_t) + self.b_h1)
            h1 = h1 / torch.norm(h1)
            h1 = self.dropout(h1)

            # 第二层RNN
            h2 = torch.tanh(torch.matmul(self.W_hh2, h2) + torch.matmul(self.W_h1h2, h1) + self.b_h2)
            h2 = h2 / torch.norm(h2)
            h2 = self.dropout(h2)

            # 输出层
            y_t = torch.matmul(self.W_hy2, h2) + self.b_y2
            y_t = torch.log_softmax(y_t.squeeze(1), dim=0)
            all_preds.append(y_t)

        return torch.stack(all_preds, dim=0), (h1, h2)

# ---------------------- 2. 扩充数据集(20首五言绝句) ----------------------
poetry_corpus = [
    # 原有8首
    "床前明月光,疑是地上霜",
    "举头望明月,低头思故乡",
    "白日依山尽,黄河入海流",
    "欲穷千里目,更上一层楼",
    "春眠不觉晓,处处闻啼鸟",
    "夜来风雨声,花落知多少",
    "千山鸟飞绝,万径人踪灭",
    "孤舟蓑笠翁,独钓寒江雪",
    # 新增12首(统一五言+逗号分隔格式)
    "松下问童子,言师采药去",
    "只在此山中,云深不知处",
    "红豆生南国,春来发几枝",
    "愿君多采撷,此物最相思",
    "慈母手中线,游子身上衣",
    "临行密密缝,意恐迟迟归",
    "锄禾日当午,汗滴禾下土",
    "谁知盘中餐,粒粒皆辛苦",
    "鹅鹅鹅,曲项向天歌",  # 兼容短句
    "白毛浮绿水,红掌拨清波",
    "小时不识月,呼作白玉盘",
    "又疑瑶台镜,飞在青云端"
]

# 字符映射(去重+排序)
chars = sorted(list(set("".join(poetry_corpus))))
char2idx = {c:i for i,c in enumerate(chars)}
idx2char = {i:c for i,c in enumerate(chars)}
vocab_size = len(chars)

# One-Hot编码
def text2onehot(text):
    onehot = []
    for c in text:
        vec = torch.zeros(vocab_size)
        if c in char2idx:
            vec[char2idx[c]] = 1.0
        onehot.append(vec)
    return torch.stack(onehot)

# 构建训练数据
train_data = []
for poem in poetry_corpus:
    if len(poem) < 2:
        continue
    x = text2onehot(poem[:-1])
    y = torch.tensor([char2idx[c] for c in poem[1:]])
    train_data.append((x, y))

# ---------------------- 3. 训练配置(优化策略) ----------------------
input_dim = vocab_size
hidden_dim1 = 32  # 增大隐藏层
hidden_dim2 = 16
output_dim = vocab_size

model = ImprovedTwoLayerRNN(input_dim, hidden_dim1, hidden_dim2, output_dim)
criterion = nn.NLLLoss()
# 增加权重衰减(L2正则)
optimizer = optim.Adam(model.parameters(), lr=0.005, weight_decay=1e-4)
scheduler = ReduceLROnPlateau(optimizer, mode='min', factor=0.5, patience=80)

# ---------------------- 4. 训练过程(控制epoch+早停) ----------------------
epochs = 800  # 减少epoch,避免过拟合
best_loss = float('inf')
best_model_state = None
last_lr = optimizer.param_groups[0]['lr']
patience = 100  # 早停耐心值
no_improve_epoch = 0

for epoch in range(epochs):
    total_loss = 0.0
    model.train()

    for x_seq, y_seq in train_data:
        preds, _ = model(x_seq)
        loss = criterion(preds, y_seq)

        optimizer.zero_grad()
        loss.backward()
        torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
        optimizer.step()

        total_loss += loss.item()

    avg_loss = total_loss / len(train_data)
    scheduler.step(avg_loss)

    # 手动打印学习率变化
    current_lr = optimizer.param_groups[0]['lr']
    if current_lr != last_lr:
        print(f"Epoch {epoch+1}: 学习率从 {last_lr:.6f} 调整为 {current_lr:.6f}")
        last_lr = current_lr

    # 保存最优模型+早停
    if avg_loss < best_loss:
        best_loss = avg_loss
        best_model_state = model.state_dict().copy()
        no_improve_epoch = 0
    else:
        no_improve_epoch += 1
        if no_improve_epoch >= patience:
            print(f"早停:Epoch {epoch+1},损失连续{patience}轮未下降")
            break

    # 每100轮打印
    if (epoch+1) % 100 == 0:
        print(f"Epoch {epoch+1} | Avg Loss: {avg_loss:.4f} | Best Loss: {best_loss:.4f}")

# 加载最优模型
if best_model_state is not None:
    model.load_state_dict(best_model_state)

# ---------------------- 5. 生成函数(逐步注释 + 打印,看清自回归推理全过程) ----------------------
def generate_text(prefix, max_len=8, temp=0.7, top_p=0.9, verbose=True, show_full_yt=False):
    """
    这是"字符级语言模型"的自回归续写(注意:doublernn 是单模型续写,不是
    Encoder-Decoder;prefix 的作用是"预热"隐状态,之后逐字往下续)。

    推理分两个阶段:
      阶段A【预热】:把 prefix 整个喂进模型,得到"读完 prefix 后"的隐状态 (h1,h2),
                    当作续写的起始记忆。(只要隐状态,不要 prefix 自己的预测)
      阶段B【自回归】:上一个字 → 走一步 RNN → 下一个字的概率分布 → 温度缩放 →
                    top-p 采样 → 选出下一个字 → 回喂当输入,循环到够长。
    """
    model.eval()  # eval 模式下 dropout 变"直通",所以下面的 model.dropout(...) 其实不生效
    with torch.no_grad():
        # ===== 阶段A:预热——把 prefix 读一遍,拿到起始隐状态 =====
        prefix_seq = text2onehot(prefix)
        preds, (h1, h2) = model(prefix_seq)   # preds 用不上,只要读完 prefix 后的 (h1,h2)
        generated = list(prefix)
        hidden_norms = [(h1.norm().item(), h2.norm().item())] # 是一个列表,记录了生成过程中每一步隐状态向量的"长度"。目的:监控隐状态的幅度随时间步怎么变化。这是观察 RNN 梯度消失/信息衰减的一个常用探针——如果隐状态长度一路缩向 0,说明"记忆在褪色";如果爆涨,说明数值失控。你笔记(2)里讲的梯度消失,在这里就能用范数变化"看"到。但在这份代码里,它其实没用(诚实提醒)。
        if verbose:
            print(f"\n{'='*64}\n【开始生成】prefix='{prefix}'  目标长度={max_len}  温度={temp}  top_p={top_p}")
            print(f"阶段A预热:读完 prefix 后隐状态范数 h1={h1.norm():.3f}, h2={h2.norm():.3f}")
            print('-'*64)

        # ===== 阶段B:自回归逐字生成 =====
        step = 0
        while len(generated) < max_len:
            step += 1
            # (1) 取"上一个已生成的字"作为本步输入
            last_char = generated[-1]
            if last_char not in char2idx:                 # 兜底:没见过的字就随机换一个
                last_char = random.choice(chars)
            x_t = text2onehot(last_char)[0].unsqueeze(1)   # → one-hot 列向量,形状 [vocab, 1]

            # (2) 手写 RNN 前向:走一个时间步(两层)
            h1 = torch.tanh(torch.matmul(model.W_hh1, h1) + torch.matmul(model.W_xh1, x_t) + model.b_h1)
            h1 = h1 / torch.norm(h1)                       # 作者设计:隐状态归一化到单位长度
            h1 = model.dropout(h1)                         # eval 下等于什么都不做
            h2 = torch.tanh(torch.matmul(model.W_hh2, h2) + torch.matmul(model.W_h1h2, h1) + model.b_h2)
            h2 = h2 / torch.norm(h2)
            h2 = model.dropout(h2)
            hidden_norms.append((h1.norm().item(), h2.norm().item()))

            # (3) 输出层:隐状态 h2 → 词表原始打分(logits) → 温度缩放 → softmax 概率
            logits = (torch.matmul(model.W_hy2, h2) + model.b_y2).squeeze(1)  # 形状 [vocab, 1]。得到每个词一个原始分 (logit)
            y_t = logits / temp                    # 温度缩放:<1 更尖锐(确定),>1 更平坦(随机)
            probs = torch.softmax(y_t, dim=0)      # 变成整个词表上的概率分布(全为正、加起来=1)

            # (4) Top-P(核)采样:概率降序 → 累计 → 累计刚达 top_p 就截断,只在这批候选里采样
            sorted_probs, sorted_idx = torch.sort(probs, descending=True)  # 概率从高到低排
            cum_probs = torch.cumsum(sorted_probs, dim=0)                  # 前缀累计概率
            mask = cum_probs < top_p               # 累计还没到 top_p 的位置都保留
            mask[0] = True                         # 至少保留概率最高的那个字
            selected_idx = sorted_idx[mask]        # 核集合:入选候选字的索引
            selected_probs = sorted_probs[mask] / sorted_probs[mask].sum()  # 核内重新归一化(重新凑成和=1)
            next_idx = np.random.choice(selected_idx.numpy(), p=selected_probs.numpy())  # 在核内按概率掷骰子
            next_char = idx2char[next_idx]

            # ---- 打印本步全过程:logits → 概率 → 累计 → 核裁剪 → 采样 ----
            if verbose:
                topk = min(6, len(sorted_idx))
                sorted_yt = y_t[sorted_idx]        # 按概率排序后对应的 y_t(就是喂进 softmax 的分数)
                nsize = len(selected_idx)
                print(f"\n第{step}步 ┃ 输入'{last_char}'   (temp={temp}, top_p={top_p})")

                # 可选:把完整的 y_t 向量整条打印出来(按词表顺序,长度 = vocab_size)
                if show_full_yt:
                    print(f"   [完整 y_t 向量,共 {y_t.shape[0]} 维,每个词表位置一个分数]")
                    for i in range(y_t.shape[0]):
                        end = "\n" if (i + 1) % 6 == 0 else "  "
                        print(f"{idx2char[i]}={y_t[i].item():6.2f}", end=end)
                    print(f"\n   (原始张量:y_t = {y_t.numpy().round(2)})")

                print(f"   排名 字   打分y_t   概率probs  累计cumsum  是否入核")
                for i in range(topk):
                    ch = idx2char[int(sorted_idx[i])]
                    inn = "✓ 入核" if i < nsize else "✗ 砍掉(累计已达top_p)"
                    print(f"   {i+1:>2}  {ch}   {sorted_yt[i].item():>7.2f}  "
                          f"{sorted_probs[i].item():>7.3f}   {cum_probs[i].item():>7.3f}    {inn}")
                if len(sorted_idx) > topk:
                    print(f"   ...(其余 {len(sorted_idx)-topk} 个字概率更低,省略)")
                nucleus = "".join(idx2char[int(i)] for i in selected_idx.numpy())
                print(f"   → 核集合(共{nsize}字):「{nucleus}」→ 组内重新归一化后掷骰子 → 选中 '{next_char}'  (h2范数={h2.norm():.2f})")

            # (5) 去重小技巧:与上一个字相同、或连续逗号,就跳过本次结果、重新采样
            if generated[-1] == next_char or (next_char == "," and generated[-1] == ","):
                if verbose:
                    print(f"      ⚠ '{next_char}'与上一个字重复,跳过、重采(隐状态已前进一步)")
                continue

            # (6) 追加,并把它作为下一步的输入 —— 这就是自回归的"回喂"
            generated.append(next_char)

        if verbose:
            print('-'*64)
            print(f"【生成完成】{''.join(generated)}\n{'='*64}")
        return "".join(generated), hidden_norms

# ---------------------- 6. 测试:看清一次完整的推理过程 ----------------------
print("\n\n" + "#"*64)
print("#  完整 y_t 向量演示(max_len=3,只走2步,打印整条 y_t 向量)")
print("#"*64)
generate_text("床前", max_len=3, temp=0.7, top_p=0.9, verbose=True, show_full_yt=True)

print("\n\n" + "#"*64)
print("#  详细过程A:低温 temp=0.7(模型很确定,核集合常常只有1个字)")
print("#"*64)
generate_text("床前", max_len=8, temp=0.7, top_p=0.9, verbose=True)

print("\n\n" + "#"*64)
print("#  详细过程B:高温 temp=1.5(分布被压平,核集合会包含多个字,能看清 top_p 截断)")
print("#"*64)
generate_text("床前", max_len=8, temp=1.5, top_p=0.9, verbose=True)

print("\n\n" + "#"*64)
print("#  批量生成(关闭详细打印,只看结果)")
print("#"*64)
for p in ["举头", "白日", "春眠", "松下", "红豆"]:
    gen, _ = generate_text(p, max_len=8, temp=0.7, top_p=0.9, verbose=False)
    print(f"前缀:{p} → 生成:{gen}")

print("\n===== 长序列测试(纯RNN仍有局限,观察隐状态范数变化) =====")
gen, norms = generate_text("床前明月光", max_len=15, temp=0.7, top_p=0.9, verbose=False)
print(f"前缀:床前明月光 → 生成:{gen}")
print(f"隐藏状态范数变化:{norms[0][0]:.2f} → {norms[-1][0]:.2f}")
执行输出:
Epoch 100 | Avg Loss: 2.0308 | Best Loss: 2.0308
Epoch 200 | Avg Loss: 1.2707 | Best Loss: 1.2707
Epoch 300 | Avg Loss: 1.0020 | Best Loss: 1.0007
Epoch 400 | Avg Loss: 0.9018 | Best Loss: 0.7962
Epoch 477: 学习率从 0.005000 调整为 0.002500
Epoch 500 | Avg Loss: 0.8118 | Best Loss: 0.7789
Epoch 600: 学习率从 0.002500 调整为 0.001250
Epoch 600 | Avg Loss: 0.8059 | Best Loss: 0.7320
早停:Epoch 619,损失连续100轮未下降


################################################################
#  完整 y_t 向量演示(max_len=3,只走2步,打印整条 y_t 向量)
################################################################

================================================================
【开始生成】prefix='床前'  目标长度=3  温度=0.7  top_p=0.9
阶段A预热:读完 prefix 后隐状态范数 h1=1.000, h2=1.000
----------------------------------------------------------------

第1步 ┃ 输入'前'   (temp=0.7, top_p=0.9)
   [完整 y_t 向量,共 158 维,每个词表位置一个分数]
一= -1.62  万= -2.91  上= -0.82  下= -3.35  不=  3.56  中=  0.44
临= -1.48  举= -1.48  乡=  3.93  云=  2.80  人= -3.43  低= -1.04
作=  0.33  依=  1.25  光=  3.13  入= -0.82  几=  1.23  前= -1.10
千=  5.49  午=  1.26  南=  1.74  去=  1.99  又= -1.48  发=  1.90
只= -1.48  台= -2.10  向=  2.07  君= -1.91  呼= -1.09  啼= -2.45
国= -2.11  土=  5.14  在= -6.62  地= -6.21  声= -1.87  处=  1.58
多=  3.06  夜= -1.48  天=  1.32  头= -4.34  子= -2.02  孤= -1.48
密=  4.14  寒= -1.08  小= -1.48  少= -0.37  尽= -0.70  层= -2.25
山=  2.35  师= -1.38  床= -1.48  归= -0.66  当=  1.10  径= -2.13
思=  4.39  恐= -6.62  意= -0.21  愿= -1.48  慈= -1.48  手=  3.32
拨= -1.93  掌= -6.38  撷= -2.16  故=  0.41  日=  0.47  时=  1.71
明= 11.42  春=  1.73  是=  1.39  晓= -1.62  曲= -0.06  更= -2.95
最=  0.49  月=  1.86  望=  5.12  来= -2.93  松= -1.48  枝=  1.79
楼=  5.55  欲= -1.48  歌=  4.34  此= -0.34  母= -4.11  毛=  0.90
水= -4.06  汗= -2.37  江= -0.27  河= -5.45  波= -2.43  流=  1.24
浮=  3.06  海=  1.51  深= -1.21  清= -1.83  游= -2.13  滴= -2.35
灭=  5.30  物= -0.52  独=  1.05  玉=  1.91  瑶= -0.53  生= -4.20
疑=  1.75  白= -3.39  皆= -1.02  盘=  1.81  目= -1.53  相= -0.65
眠= -0.45  知=  2.53  禾=  0.92  穷= -1.97  童= -1.63  端= -1.00
笠=  0.28  粒= -1.29  红= -1.77  线= -0.12  绝= -5.68  绿=  3.12
缝=  3.35  翁= -5.39  舟= -3.44  花= -1.66  苦=  3.23  药= -2.00
落=  0.98  蓑=  3.88  行= -3.62  衣= -1.27  觉=  1.06  言= -0.63
识=  2.99  谁= -1.48  豆= -5.57  踪= -0.49  身= -1.09  辛=  0.46
迟=  0.67  采=  1.74  里= -0.01  钓=  1.91  锄= -1.48  镜=  2.33
问=  5.42  闻=  1.02  雨= -2.98  雪= -0.56  霜= -1.56  青= -1.34
项=  0.67  风=  1.66  飞=  4.84  餐= -1.86  鸟=  1.93  鹅= -4.43
黄= -0.87  ,=  3.63
   (原始张量:y_t = [-1.620e+00 -2.910e+00 -8.200e-01 -3.350e+00  3.560e+00  4.400e-01
 -1.480e+00 -1.480e+00  3.930e+00  2.800e+00 -3.430e+00 -1.040e+00
  3.300e-01  1.250e+00  3.130e+00 -8.200e-01  1.230e+00 -1.100e+00
  5.490e+00  1.260e+00  1.740e+00  1.990e+00 -1.480e+00  1.900e+00
 -1.480e+00 -2.100e+00  2.070e+00 -1.910e+00 -1.090e+00 -2.450e+00
 -2.110e+00  5.140e+00 -6.620e+00 -6.210e+00 -1.870e+00  1.580e+00
  3.060e+00 -1.480e+00  1.320e+00 -4.340e+00 -2.020e+00 -1.480e+00
  4.140e+00 -1.080e+00 -1.480e+00 -3.700e-01 -7.000e-01 -2.250e+00
  2.350e+00 -1.380e+00 -1.480e+00 -6.600e-01  1.100e+00 -2.130e+00
  4.390e+00 -6.620e+00 -2.100e-01 -1.480e+00 -1.480e+00  3.320e+00
 -1.930e+00 -6.380e+00 -2.160e+00  4.100e-01  4.700e-01  1.710e+00
  1.142e+01  1.730e+00  1.390e+00 -1.620e+00 -6.000e-02 -2.950e+00
  4.900e-01  1.860e+00  5.120e+00 -2.930e+00 -1.480e+00  1.790e+00
  5.550e+00 -1.480e+00  4.340e+00 -3.400e-01 -4.110e+00  9.000e-01
 -4.060e+00 -2.370e+00 -2.700e-01 -5.450e+00 -2.430e+00  1.240e+00
  3.060e+00  1.510e+00 -1.210e+00 -1.830e+00 -2.130e+00 -2.350e+00
  5.300e+00 -5.200e-01  1.050e+00  1.910e+00 -5.300e-01 -4.200e+00
  1.750e+00 -3.390e+00 -1.020e+00  1.810e+00 -1.530e+00 -6.500e-01
 -4.500e-01  2.530e+00  9.200e-01 -1.970e+00 -1.630e+00 -1.000e+00
  2.800e-01 -1.290e+00 -1.770e+00 -1.200e-01 -5.680e+00  3.120e+00
  3.350e+00 -5.390e+00 -3.440e+00 -1.660e+00  3.230e+00 -2.000e+00
  9.800e-01  3.880e+00 -3.620e+00 -1.270e+00  1.060e+00 -6.300e-01
  2.990e+00 -1.480e+00 -5.570e+00 -4.900e-01 -1.090e+00  4.600e-01
  6.700e-01  1.740e+00 -1.000e-02  1.910e+00 -1.480e+00  2.330e+00
  5.420e+00  1.020e+00 -2.980e+00 -5.600e-01 -1.560e+00 -1.340e+00
  6.700e-01  1.660e+00  4.840e+00 -1.860e+00  1.930e+00 -4.430e+00
 -8.700e-01  3.630e+00])
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  明     11.42    0.976     0.976    ✓ 入核
    2  楼      5.55    0.003     0.979    ✗ 砍掉(累计已达top_p)
    3  千      5.49    0.003     0.982    ✗ 砍掉(累计已达top_p)
    4  问      5.42    0.002     0.984    ✗ 砍掉(累计已达top_p)
    5  灭      5.30    0.002     0.986    ✗ 砍掉(累计已达top_p)
    6  土      5.14    0.002     0.988    ✗ 砍掉(累计已达top_p)
   ...(其余 152 个字概率更低,省略)
   → 核集合(共1字):「明」→ 组内重新归一化后掷骰子 → 选中 '明'  (h2范数=1.00)
----------------------------------------------------------------
【生成完成】床前明
================================================================


################################################################
#  详细过程A:低温 temp=0.7(模型很确定,核集合常常只有1个字)
################################################################

================================================================
【开始生成】prefix='床前'  目标长度=8  温度=0.7  top_p=0.9
阶段A预热:读完 prefix 后隐状态范数 h1=1.000, h2=1.000
----------------------------------------------------------------

第1步 ┃ 输入'前'   (temp=0.7, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  明     11.42    0.976     0.976    ✓ 入核
    2  楼      5.55    0.003     0.979    ✗ 砍掉(累计已达top_p)
    3  千      5.49    0.003     0.982    ✗ 砍掉(累计已达top_p)
    4  问      5.42    0.002     0.984    ✗ 砍掉(累计已达top_p)
    5  灭      5.30    0.002     0.986    ✗ 砍掉(累计已达top_p)
    6  土      5.14    0.002     0.988    ✗ 砍掉(累计已达top_p)
   ...(其余 152 个字概率更低,省略)
   → 核集合(共1字):「明」→ 组内重新归一化后掷骰子 → 选中 '明'  (h2范数=1.00)

第2步 ┃ 输入'明'   (temp=0.7, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  月     12.83    0.996     0.996    ✓ 入核
    2  目      5.82    0.001     0.997    ✗ 砍掉(累计已达top_p)
    3  乡      4.90    0.000     0.997    ✗ 砍掉(累计已达top_p)
    4  最      4.83    0.000     0.997    ✗ 砍掉(累计已达top_p)
    5  花      4.75    0.000     0.998    ✗ 砍掉(累计已达top_p)
    6  绿      4.48    0.000     0.998    ✗ 砍掉(累计已达top_p)
   ...(其余 152 个字概率更低,省略)
   → 核集合(共1字):「月」→ 组内重新归一化后掷骰子 → 选中 '月'  (h2范数=1.00)

第3步 ┃ 输入'月'   (temp=0.7, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  ,     11.34    0.571     0.571    ✓ 入核
    2  光     11.03    0.418     0.990    ✗ 砍掉(累计已达top_p)
    3  声      5.02    0.001     0.991    ✗ 砍掉(累计已达top_p)
    4  缝      4.53    0.001     0.991    ✗ 砍掉(累计已达top_p)
    5  月      4.47    0.001     0.992    ✗ 砍掉(累计已达top_p)
    6  中      4.40    0.001     0.993    ✗ 砍掉(累计已达top_p)
   ...(其余 152 个字概率更低,省略)
   → 核集合(共1字):「,」→ 组内重新归一化后掷骰子 → 选中 ','  (h2范数=1.00)

第4步 ┃ 输入','   (temp=0.7, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  低      9.93    0.454     0.454    ✓ 入核
    2  呼      9.87    0.430     0.884    ✓ 入核
    3  更      7.62    0.045     0.929    ✗ 砍掉(累计已达top_p)
    4  花      6.82    0.020     0.950    ✗ 砍掉(累计已达top_p)
    5  游      6.45    0.014     0.964    ✗ 砍掉(累计已达top_p)
    6  飞      5.29    0.004     0.968    ✗ 砍掉(累计已达top_p)
   ...(其余 152 个字概率更低,省略)
   → 核集合(共2字):「低呼」→ 组内重新归一化后掷骰子 → 选中 '呼'  (h2范数=1.00)

第5步 ┃ 输入'呼'   (temp=0.7, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  作     10.80    0.934     0.934    ✓ 入核
    2  滴      7.09    0.023     0.957    ✗ 砍掉(累计已达top_p)
    3  寒      5.83    0.006     0.963    ✗ 砍掉(累计已达top_p)
    4  时      5.61    0.005     0.968    ✗ 砍掉(累计已达top_p)
    5  踪      5.59    0.005     0.974    ✗ 砍掉(累计已达top_p)
    6  项      5.53    0.005     0.978    ✗ 砍掉(累计已达top_p)
   ...(其余 152 个字概率更低,省略)
   → 核集合(共1字):「作」→ 组内重新归一化后掷骰子 → 选中 '作'  (h2范数=1.00)

第6步 ┃ 输入'作'   (temp=0.7, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  白     10.77    0.943     0.943    ✓ 入核
    2  更      6.04    0.008     0.952    ✗ 砍掉(累计已达top_p)
    3  地      6.01    0.008     0.960    ✗ 砍掉(累计已达top_p)
    4  母      5.95    0.008     0.968    ✗ 砍掉(累计已达top_p)
    5  笠      5.60    0.005     0.973    ✗ 砍掉(累计已达top_p)
    6  汗      4.97    0.003     0.976    ✗ 砍掉(累计已达top_p)
   ...(其余 152 个字概率更低,省略)
   → 核集合(共1字):「白」→ 组内重新归一化后掷骰子 → 选中 '白'  (h2范数=1.00)
----------------------------------------------------------------
【生成完成】床前明月,呼作白
================================================================


################################################################
#  详细过程B:高温 temp=1.5(分布被压平,核集合会包含多个字,能看清 top_p 截断)
################################################################

================================================================
【开始生成】prefix='床前'  目标长度=8  温度=1.5  top_p=0.9
阶段A预热:读完 prefix 后隐状态范数 h1=1.000, h2=1.000
----------------------------------------------------------------

第1步 ┃ 输入'前'   (temp=1.5, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  明      5.33    0.415     0.415    ✓ 入核
    2  楼      2.59    0.027     0.442    ✓ 入核
    3  千      2.56    0.026     0.468    ✓ 入核
    4  问      2.53    0.025     0.493    ✓ 入核
    5  灭      2.47    0.024     0.517    ✓ 入核
    6  土      2.40    0.022     0.539    ✓ 入核
   ...(其余 152 个字概率更低,省略)
   → 核集合(共60字):「明楼千问灭土望飞思歌密乡蓑,不缝手苦光绿多浮识云知山镜向去鸟钓玉发月盘枝疑采南春时风处海是天午依流几当觉独闻落禾毛项迟最」→ 组内重新归一化后掷骰子 → 选中 '明'  (h2范数=1.00)

第2步 ┃ 输入'明'   (temp=1.5, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  月      5.99    0.598     0.598    ✓ 入核
    2  目      2.72    0.023     0.621    ✓ 入核
    3  乡      2.29    0.015     0.635    ✓ 入核
    4  最      2.25    0.014     0.650    ✓ 入核
    5  花      2.22    0.014     0.664    ✓ 入核
    6  绿      2.09    0.012     0.676    ✓ 入核
   ...(其余 152 个字概率更低,省略)
   → 核集合(共53字):「月目乡最花绿童径中处知飞禾绝线南光雪端黄午意盘日问晓尽土灭镜落寒在觉低向身餐曲粒声游闻台是浮蓑缝呼,识独恐」→ 组内重新归一化后掷骰子 → 选中 '月'  (h2范数=1.00)

第3步 ┃ 输入'月'   (temp=1.5, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  ,      5.29    0.309     0.309    ✓ 入核
    2  光      5.15    0.267     0.576    ✓ 入核
    3  声      2.34    0.016     0.592    ✓ 入核
    4  缝      2.11    0.013     0.605    ✓ 入核
    5  月      2.09    0.013     0.618    ✓ 入核
    6  中      2.05    0.012     0.630    ✓ 入核
   ...(其余 152 个字概率更低,省略)
   → 核集合(共48字):「,光声缝月中作尽子云项镜上踪撷餐明当药枝土线处粒鹅问水乡灭相皆花目在楼密盘绿南人依绝钓归手曲少身」→ 组内重新归一化后掷骰子 → 选中 '光'  (h2范数=1.00)

第4步 ┃ 输入'光'   (temp=1.5, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  ,      7.54    0.875     0.875    ✓ 入核
    2  光      2.67    0.007     0.882    ✓ 入核
    3  身      2.37    0.005     0.887    ✓ 入核
    4  曲      2.37    0.005     0.892    ✓ 入核
    5  线      2.35    0.005     0.897    ✓ 入核
    6  鹅      2.34    0.005     0.902    ✗ 砍掉(累计已达top_p)
   ...(其余 152 个字概率更低,省略)
   → 核集合(共5字):「,光身曲线」→ 组内重新归一化后掷骰子 → 选中 ','  (h2范数=1.00)

第5步 ┃ 输入','   (temp=1.5, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  疑      5.31    0.356     0.356    ✓ 入核
    2  春      3.66    0.068     0.425    ✓ 入核
    3  红      3.51    0.059     0.483    ✓ 入核
    4  黄      3.20    0.043     0.526    ✓ 入核
    5  云      2.92    0.032     0.559    ✓ 入核
    6  曲      2.89    0.031     0.590    ✓ 入核
   ...(其余 152 个字概率更低,省略)
   → 核集合(共53字):「疑春红黄云曲意万,呼低言处游此归楼钓独飞花作汗入层更粒雪深踪闻蓑乡时千多头端海掌眠拨故辛几去是落灭河径来豆」→ 组内重新归一化后掷骰子 → 选中 '疑'  (h2范数=1.00)

第6步 ┃ 输入'疑'   (temp=1.5, top_p=0.9)
   排名 字   打分y_t   概率probs  累计cumsum  是否入核
    1  是      4.74    0.253     0.253    ✓ 入核
    2  瑶      4.40    0.181     0.434    ✓ 入核
    3  物      2.68    0.032     0.466    ✓ 入核
    4  处      2.34    0.023     0.489    ✓ 入核
    5  里      1.90    0.015     0.504    ✓ 入核
    6  霜      1.77    0.013     0.517    ✓ 入核
   ...(其余 152 个字概率更低,省略)
   → 核集合(共67字):「是瑶物处里霜歌衣啼最绿项粒一黄闻南时在万灭枝掌禾乡盘白花作来觉山游绝不流径识午撷药滴钓恐清蓑楼海归意上笠辛更多汗目依拨落发浮疑春言踪豆」→ 组内重新归一化后掷骰子 → 选中 '花'  (h2范数=1.00)
----------------------------------------------------------------
【生成完成】床前明月光,疑花
================================================================


################################################################
#  批量生成(关闭详细打印,只看结果)
################################################################
前缀:举头 → 生成:举头思故乡身上衣
前缀:白日 → 生成:白日依山尽,黄河
前缀:春眠 → 生成:春眠不觉晓,处闻
前缀:松下 → 生成:松下土雨声,花落
前缀:红豆 → 生成:红豆生南国,疑是

===== 长序列测试(纯RNN仍有局限,观察隐状态范数变化) =====
前缀:床前明月光 → 生成:床前明月光,黄河入海流千山鸟飞
隐藏状态范数变化:1.00 → 1.00
方案二:RNN Encoder–Decoder
首先,下图展示了一个人类之间进行沟通的过程(Communication process),是一个经典的 Encoder–Decoder 抽象模型,它拆解了人类双向通信的完整闭环流程,包括:信源发起→编码→信道传递→解码→接收→响应→反馈→信源调整,同时受经验场和噪声两大关键因素影响,是传播学中经典的互动式通信模型。
在该抽象模型中,Encoder 和 Decoder 的解耦特性使得收发双方可以是任意的组合,即:收发双方可以使用完全不同的两种语言进行沟通。

2014 年,Bengio 在论文《Learning Phrase Representations using RNN Encoder–Decoder for Statistical Machine Translation》中提出了基于 RNN 的 Encoder–Decoder 模型。
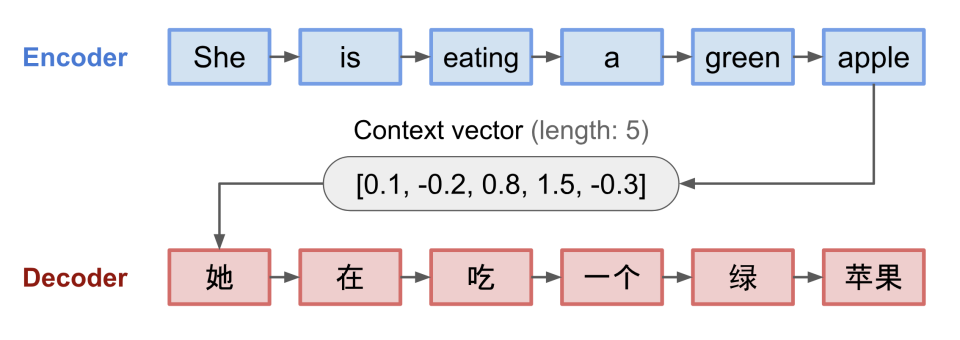
架构的灵感就来源于上述抽象模型,具体实现了语言翻译的本质,它将输出和输出分离为 2 个 RNN,并引入一个 “长度固定” 的隐状状态(Hidden state)向量 C 作为 Encoder 和 Decoder 之间的 “Channel(桥梁)”,以此来构建 N-1-M 的输入和输出不等长序列。满足了 “两个不同序列、长度不同” 的需求,比如:翻译场景中,英文句子长、中文句子短;摘要场景中,原文长、摘要短等等。
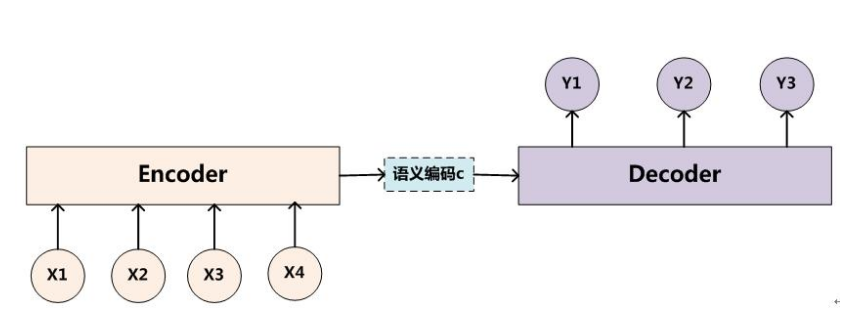
RNN Encoder-Decoder 解决了 RNN 自回归模型的硬伤,在 RNN 时代,它是唯一能 “干净地把一条输入序列,映射成另一条长度独立的输出序列” 的方案。

值得一提的是,单 RNN 模型自回归的两个硬伤,到了 Transformer 时代被彻底解决了:Self-Attention 让每个位置能直接访问前面所有位置(不再依赖会被覆盖的隐状态),大规模又提供了足够的容量。于是 “把输入输出拼成一条流” 的 Decoder-Only(GPT)反而成了主流。但这依赖的是 Transformer 而非 RNN。在纯 RNN 的框架下,Encoder–Decoder 仍是处理不等长序列映射的必然选择。
模型结构
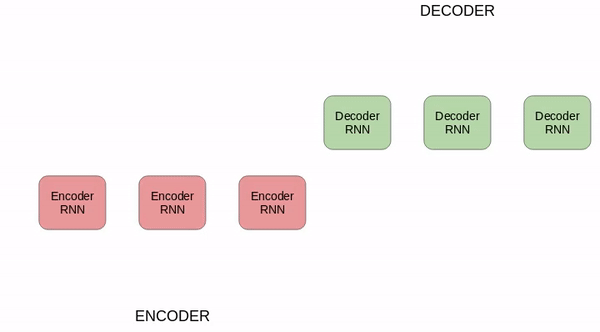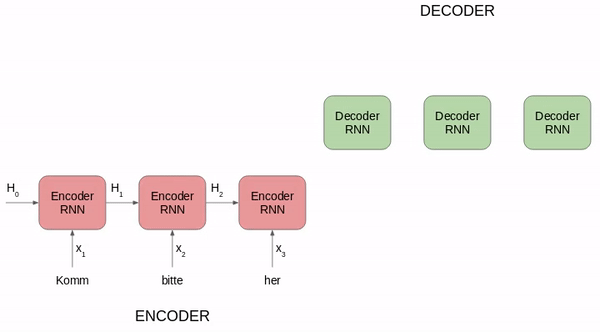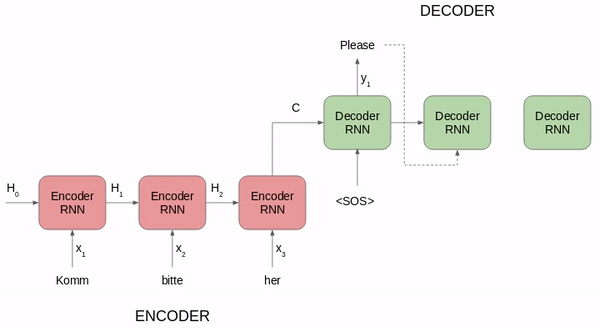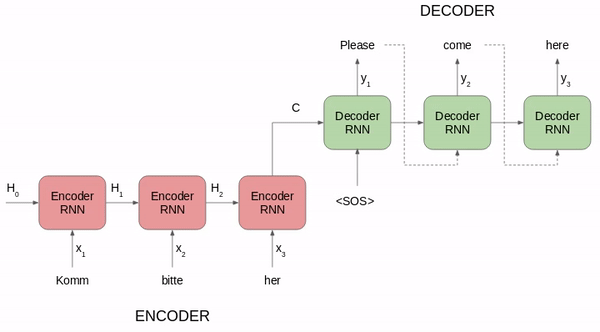
Encoder(编码器):把输入句子的所有语义信息压缩成一个固定长度的中间语义向量 C(Context 向量)中,C 向量是输入的浓缩摘要。
- Encoder 会对输入句子的每个词进行处理,处理每个词之后会产生一个隐藏状态 h_t。
- 从输入的第二个词开始,Encoder 每个时刻的输入都是上一个时间步的隐藏状态 h_t-1 和输入的新单词 x_t。
- Encoder 输出的最后一个时间步的隐藏状态就是编码了整个句子语义的语义上下文(Context),这是一个固定长度的高维特征向量 C,输入句子每个时间步的信息都包含在了这个上下文中。
Decoder(解码器):得到上下文信息向量 C 之后就可以开始自回归的生产输出序列,直到 EOS 结束,输出长度 M 与输入长度 N 无关。所谓自回归,即上一轮的输出还会作为下一轮的输入。
- 在每个时间步,Decoder 都是自回归的,即上一个时间步的输出 y_t−1 会作为当前时间步 t 的输入之一,生成当前时间步的字符 y_t。
- Decoder 最初的输入是中间语义上下文向量 C,Decoder 依据 C 计算出第一个输出词和新的隐藏状态,即 Decoder 的每个预测都受到先前输出词和隐藏状态的微妙影响。
- Decoder 接着用新的隐藏状态和第一个输出词作为联合输入来计算第二个输出词,以此类推,直到解码器产生一个 EOS(End Of Service,序列结束)标记或者达到预定序列长度的边界。
隐状状态(Hidden state)向量 C:是 Encoder 基于输入计算得到的,作为两个 RNN 之间唯一的信息通道。传递 Encoder 输入序列最后的 “历史记录” 到 Decoder。Decoder 自回归生成输出序列的每个元素时,隐藏状态都会参与计算。
推理过程
在文本生成场景中,RNN Encoder-Decoder 中的 Encoder 只会对输入的提示词进行计算一次,然后把定长向量 C 传递给 Decoder 再开始进行自回归。(输出可变长,不需要和输入长度一样。)
举例:输入 “你好吗”
【Encoder,只跑一次】
你 → 好 → 吗  ⟹  C  ← Encoder 读完 prompt,吐出 C,任务结束。

【Decoder,自回归循环】
C ⟹ 我 ⟹ 很 ⟹ 好 ⟹ <EOS>
值得注意的是,Encoder 一旦生成 C 之后就彻底退出了,后面整个自回归过程是 Decoder 自己完成的。Decoder 每生成每一个词时,手上能依赖的东西只有:
- 定长向量 C(输入提示词的 “浓缩摘要”)
- 它自己的隐状态 s_t(一路带着的记忆)
- 它自己上一步吐出的词(自回归喂进来的)
Decoder 因为不在需要回看 Encoder 的输入提示词,采用自回归的方式,所以 Encoder 和 Decoder 实现了 “可变长” 的生成。
但缺陷是,当输入提示词越长/越复杂,定长向量 C 就扛不住了,而 Decoder 又无法 “回看原文” 补救。这使得 RNN Encoder-Decoder 模型可处理的序列长度有限。直到 RNN-Attention Encoder-Decoder 模型解决了定长向量 C 的问题,让 Decoder 每一步生成都能 “回看原文(Encoder 的全部隐状态)”,并替代了向量 C。
示例
# -*- coding: utf-8 -*-
"""
从零实现 RNN Encoder-Decoder(vanilla Seq2Seq,无 Attention)

任务:给"上句" → 生成"下句"(如 "床前明月光" → "疑是地上霜"),这是一个真正的
      seq2seq(源序列 ≠ 目标序列),用来把下面几个概念落到可运行的代码上:

  1) Encoder 只把"上句"读一遍,压成一个【定长向量 C】(← 问题①瓶颈的现场)
  2) C 作为 Decoder 的初始隐状态传过去(Encoder 交完 C 就退场,不再参与)
  3) Decoder 从 <BOS> 开始【自回归】逐字生成,直到吐出 <EOS>
  4) 训练用 teacher forcing(喂标准答案),推理喂模型自己上一步的输出

代码风格沿用本目录 doublernn.py:手写 nn.Parameter、列向量约定
(hidden,1)、逐时间步 for 循环、tanh。刻意不用 nn.RNN,方便逐行看清数据流。
"""
import torch
import torch.nn as nn
import torch.optim as optim
import numpy as np

torch.manual_seed(0)
np.random.seed(0)

# ---------------------- 1. 语料:拆成 (上句, 下句) 对 ----------------------
poetry_corpus = [
    "床前明月光,疑是地上霜", "举头望明月,低头思故乡",
    "白日依山尽,黄河入海流", "欲穷千里目,更上一层楼",
    "春眠不觉晓,处处闻啼鸟", "夜来风雨声,花落知多少",
    "千山鸟飞绝,万径人踪灭", "孤舟蓑笠翁,独钓寒江雪",
    "松下问童子,言师采药去", "只在此山中,云深不知处",
    "红豆生南国,春来发几枝", "愿君多采撷,此物最相思",
    "慈母手中线,游子身上衣", "临行密密缝,意恐迟迟归",
    "锄禾日当午,汗滴禾下土", "谁知盘中餐,粒粒皆辛苦",
    "白毛浮绿水,红掌拨清波", "小时不识月,呼作白玉盘",
    "又疑瑶台镜,飞在青云端", "野火烧不尽,春风吹又生",
]

pairs = []  # [(src上句, tgt下句), ...]
for poem in poetry_corpus:
    if "," not in poem:
        continue
    src, tgt = poem.split(",")[:2]
    if src and tgt:
        pairs.append((src, tgt))

# ---------------------- 2. 词汇表(含特殊符号 <BOS>/<EOS>) ----------------------
BOS, EOS = "<BOS>", "<EOS>"          # Decoder 的启动符 / 停止符
_chars = set()
for s, t in pairs:
    _chars.update(s)
    _chars.update(t)
vocab = [BOS, EOS] + sorted(_chars)   # 索引 0=<BOS>, 1=<EOS>
char2idx = {c: i for i, c in enumerate(vocab)}
idx2char = {i: c for i, c in enumerate(vocab)}
vocab_size = len(vocab)
BOS_ID, EOS_ID = char2idx[BOS], char2idx[EOS]

def onehot(token):
    """把一个 token(字或特殊符)转成列向量 (vocab_size, 1)。"""
    vec = torch.zeros(vocab_size, 1)
    vec[char2idx[token], 0] = 1.0
    return vec


# ---------------------- 3. Encoder(从零手写单层 RNN) ----------------------
class Encoder(nn.Module):
    """读完整个"上句",把最后一个隐状态当作定长向量 C 返回。"""
    def __init__(self, input_dim, hidden_dim):
        super().__init__()
        self.W_xh = nn.Parameter(torch.empty(hidden_dim, input_dim))
        self.W_hh = nn.Parameter(torch.empty(hidden_dim, hidden_dim))
        self.b_h = nn.Parameter(torch.zeros(hidden_dim, 1))
        nn.init.orthogonal_(self.W_xh)   # 正交初始化,缓解梯度问题(与 doublernn 一致)
        nn.init.orthogonal_(self.W_hh)
        self.hidden_dim = hidden_dim

    def forward(self, src_tokens):
        h = torch.zeros(self.hidden_dim, 1)          # 初始隐状态全 0
        for ch in src_tokens:                        # 逐字读入
            x = onehot(ch)
            h = torch.tanh(self.W_hh @ h + self.W_xh @ x + self.b_h)
        return h                                     # h == C,整句"上句"的浓缩摘要


# ---------------------- 4. Decoder(从零手写单层 RNN + 输出层) ----------------------
class Decoder(nn.Module):
    """从 C 出发,自回归地逐字生成"下句"。"""
    def __init__(self, input_dim, hidden_dim, output_dim):
        super().__init__()
        self.W_xh = nn.Parameter(torch.empty(hidden_dim, input_dim))
        self.W_hh = nn.Parameter(torch.empty(hidden_dim, hidden_dim))
        self.b_h = nn.Parameter(torch.zeros(hidden_dim, 1))
        self.W_hy = nn.Parameter(torch.empty(output_dim, hidden_dim))  # 隐状态→词表
        self.b_y = nn.Parameter(torch.zeros(output_dim, 1))
        nn.init.orthogonal_(self.W_xh)
        nn.init.orthogonal_(self.W_hh)
        nn.init.orthogonal_(self.W_hy)

    def step(self, x, s_prev):
        """走一个时间步:输入上一个词 x 和上一步状态 s_prev,输出新状态与 log 概率。"""
        s = torch.tanh(self.W_hh @ s_prev + self.W_xh @ x + self.b_h)
        logits = self.W_hy @ s + self.b_y            # (vocab_size, 1)
        logp = torch.log_softmax(logits.squeeze(1), dim=0)
        return s, logp

# ---------------------- 5. 组装模型与训练配置 ----------------------
HIDDEN = 64                      # 隐藏状态的长度,也是 C 的长度。编码器与解码器隐藏维度保持一致,才能直接 s_0 = C
encoder = Encoder(vocab_size, HIDDEN)
decoder = Decoder(vocab_size, HIDDEN, vocab_size)

criterion = nn.NLLLoss()         # 配合 log_softmax
params = list(encoder.parameters()) + list(decoder.parameters())
optimizer = optim.Adam(params, lr=0.01)


def run_teacher_forcing(src, tgt):
    """训练时的一次前向:返回该样本的平均 loss(用 teacher forcing)。"""
    C = encoder(src)                                  # ① 编码:上句 → C
    s = C                                             # ② 用 C 初始化 Decoder 状态

    # teacher forcing:Decoder 的输入是 [<BOS>, 下句各字],目标是 [下句各字, <EOS>]
    dec_inputs = [BOS] + list(tgt)
    dec_targets = [char2idx[c] for c in tgt] + [EOS_ID]

    logps = []
    for tok in dec_inputs:                            # ③ 逐步解码(喂标准答案)
        s, logp = decoder.step(onehot(tok), s)
        logps.append(logp)
    logps = torch.stack(logps, dim=0)                 # (len, vocab_size)
    targets = torch.tensor(dec_targets)
    return criterion(logps, targets)


# ---------------------- 6. 训练循环 ----------------------
print(f"样本对数量: {len(pairs)} | 词表大小: {vocab_size} | 隐藏维度: {HIDDEN}")
EPOCHS = 500
for epoch in range(EPOCHS):
    total = 0.0
    for src, tgt in pairs:
        loss = run_teacher_forcing(src, tgt)
        optimizer.zero_grad()
        loss.backward()
        torch.nn.utils.clip_grad_norm_(params, max_norm=2.0)  # 防梯度爆炸
        optimizer.step()
        total += loss.item()
    if (epoch + 1) % 50 == 0:
        print(f"Epoch {epoch+1:4d} | Avg Loss: {total/len(pairs):.4f}")

# ---------------------- 7. 推理:自回归生成(无 teacher forcing) ----------------------
@torch.no_grad()
def encode_verbose(src):
    """编码阶段(带打印):逐字读入,展示隐状态如何一步步更新,最后得到 C。"""
    encoder.eval()
    h = torch.zeros(encoder.hidden_dim, 1)
    print(f"  初始隐状态 h0 = 全0            (范数={h.norm():.3f})")
    for i, ch in enumerate(src):
        x = onehot(ch)
        h = torch.tanh(encoder.W_hh @ h + encoder.W_xh @ x + encoder.b_h)
        print(f"  读入第{i+1}字 '{ch}' → 隐状态更新 (范数={h.norm():.3f}, 前4维={h[:4,0].numpy().round(3)})")
    print(f"  ✅ 读完整句,最后这个隐状态就是 C(形状{tuple(h.shape)})")
    return h


@torch.no_grad()
def generate(src, max_len=12, greedy=True, temp=0.8, verbose=False, init_C=None, C_desc=None):
    """给"上句" src,自回归生成"下句"。init_C 可注入自定义 C(用于消融实验)。"""
    encoder.eval(); decoder.eval()
    C = encoder(list(src)) if init_C is None else init_C   # ① 编码得到瓶颈向量 C
    if verbose:
        print(f"[C = {C_desc or f'上句「{src}」的编码'}]  形状={tuple(C.shape)}, 范数={C.norm():.3f}")
        print(f"     C 前8维 = {C[:8,0].numpy().round(3)}")
    s = C                                # ② C 初始化解码状态(C 就是 Decoder 的起始记忆)
    prev = BOS                           # ③ 从 <BOS> 启动
    out = []
    for t in range(max_len):
        s, logp = decoder.step(onehot(prev), s)
        if greedy:
            nxt = int(torch.argmax(logp))
        else:
            probs = torch.softmax(logp / temp, dim=0)
            nxt = int(np.random.choice(vocab_size, p=probs.numpy()))
        if nxt == EOS_ID:                # ④ 吐出 <EOS> 就停
            if verbose: print(f"     第{t+1}步 → 生成 <EOS>,停止")
            break
        ch = idx2char[nxt]
        if verbose:
            src_of_state = "C(编码器压缩的上句记忆)" if t == 0 else f"上一步输出'{prev}'"
            p = float(torch.softmax(logp, dim=0)[nxt])
            print(f"     第{t+1}步: 状态来自{src_of_state} → 生成 '{ch}' (概率{p:.2f})")
        out.append(ch)
        prev = ch                        # ⑤ 把刚生成的字回喂为下一步输入(自回归)
    return "".join(out), C


# ---------------------- 8. 效果展示:把 C 的"内容"和"作用"看清楚 ----------------------
print("\n\n" + "="*64)
print("【A】编码阶段:上句被逐字读入,一步步压缩成定长向量 C")
print("="*64)
print("上句 '床前明月光':")
encode_verbose("床前明月光")

print("\n" + "="*64)
print("【B】解码阶段:C 作为 Decoder 的起始记忆,自回归逐字生成下句")
print("="*64)
gen, _ = generate("床前明月光", verbose=True)
print(f"     → 生成完成:{gen}")

print("\n" + "="*64)
print("【C】C 是定长的:不管上句多长,C 永远是 (HIDDEN,1),但内容随上句而变")
print("="*64)
for src in ["床前明月光", "红豆生南国", "锄禾日当午"]:
    with torch.no_grad():
        C = encoder(list(src))
    print(f"  '{src}'({len(src)}字)→ C形状{tuple(C.shape)}, 范数={C.norm():.3f}, 前6维={C[:6,0].numpy().round(2)}")

print("\n" + "="*64)
print("【D】C 的作用(消融实验):Decoder 只靠 C 获知'上句是什么'")
print("="*64)
with torch.no_grad():
    C_correct = encoder(list("床前明月光"))
    C_wrong   = encoder(list("红豆生南国"))
C_zero    = torch.zeros(HIDDEN, 1)
g1, _ = generate("", init_C=C_correct, C_desc="正确:来自'床前明月光'", verbose=True)
print(f"     → {g1}   (期望:疑是地上霜)")
g2, _ = generate("", init_C=C_wrong,   C_desc="偷换成'红豆生南国'的C")
print(f"  把 C 偷换成'红豆生南国'的 → 生成:{g2}   (下句跟着变成红豆的了!)")
g3, _ = generate("", init_C=C_zero,    C_desc="清零的C")
print(f"  把 C 清零(无任何上句信息)→ 生成:{g3}   (没有上句,退化成乱猜)")
print("\n结论:Decoder 全程没有直接接触上句原文,它对'上句是什么'的唯一了解就来自 C。")
print("      换掉 C,输出就跟着变——这证明 C 是 Encoder 传给 Decoder 的、")
print("      承载整个上句语义的【唯一桥梁】,也正是 Attention 后来要打开的瓶颈①。")

print("\n" + "="*64)
print("【E】批量验证:给上句 → 生成下句(greedy,应复现训练对)")
print("="*64)
for src, tgt in pairs[:8]:
    gen, _ = generate(src)
    ok = "✅" if gen == tgt else "  "
    print(f"{ok} 上句: {src}  → 生成下句: {gen}   (真实: {tgt})")
执行输出:
样本对数量: 20 | 词表大小: 157 | 隐藏维度: 64
Epoch   50 | Avg Loss: 0.0051
Epoch  100 | Avg Loss: 0.0013
Epoch  150 | Avg Loss: 0.0006
Epoch  200 | Avg Loss: 0.0003
Epoch  250 | Avg Loss: 0.0002
Epoch  300 | Avg Loss: 0.0001
Epoch  350 | Avg Loss: 0.0000
Epoch  400 | Avg Loss: 0.0000
Epoch  450 | Avg Loss: 0.0000
Epoch  500 | Avg Loss: 0.0000


================================================================
【A】编码阶段:上句被逐字读入,一步步压缩成定长向量 C
================================================================
上句 '床前明月光':
  初始隐状态 h0 = 全0            (范数=0.000)
  读入第1字 '床' → 隐状态更新 (范数=2.114, 前4维=[-0.159  0.315 -0.231  0.118])
  读入第2字 '前' → 隐状态更新 (范数=5.244, 前4维=[-0.028 -0.685  0.854 -0.111])
  读入第3字 '明' → 隐状态更新 (范数=7.337, 前4维=[ 0.955  0.408  1.    -0.999])
  读入第4字 '月' → 隐状态更新 (范数=7.553, 前4维=[-0.999  1.     1.     0.832])
  读入第5字 '光' → 隐状态更新 (范数=7.453, 前4维=[ 0.924 -0.996  0.998 -0.992])
  ✅ 读完整句,最后这个隐状态就是 C(形状(64, 1))

================================================================
【B】解码阶段:C 作为 Decoder 的起始记忆,自回归逐字生成下句
================================================================
[C = 上句「床前明月光」的编码]  形状=(64, 1), 范数=7.453
     C 前8维 = [ 0.924 -0.996  0.998 -0.992 -1.    -0.447 -0.98  -1.   ]
     第1步: 状态来自C(编码器压缩的上句记忆) → 生成 '疑' (概率1.00)
     第2步: 状态来自上一步输出'疑' → 生成 '是' (概率1.00)
     第3步: 状态来自上一步输出'是' → 生成 '地' (概率1.00)
     第4步: 状态来自上一步输出'地' → 生成 '上' (概率1.00)
     第5步: 状态来自上一步输出'上' → 生成 '霜' (概率1.00)
     第6步 → 生成 <EOS>,停止
     → 生成完成:疑是地上霜

================================================================
【C】C 是定长的:不管上句多长,C 永远是 (HIDDEN,1),但内容随上句而变
================================================================
  '床前明月光'(5字)→ C形状(64, 1), 范数=7.453, 前6维=[ 0.92 -1.    1.   -0.99 -1.   -0.45]
  '红豆生南国'(5字)→ C形状(64, 1), 范数=7.299, 前6维=[-0.97  0.95 -0.85 -0.64 -1.   -0.93]
  '锄禾日当午'(5字)→ C形状(64, 1), 范数=7.467, 前6维=[ 1.   -0.97  0.75 -0.99 -1.   -0.97]

================================================================
【D】C 的作用(消融实验):Decoder 只靠 C 获知'上句是什么'
================================================================
[C = 正确:来自'床前明月光']  形状=(64, 1), 范数=7.453
     C 前8维 = [ 0.924 -0.996  0.998 -0.992 -1.    -0.447 -0.98  -1.   ]
     第1步: 状态来自C(编码器压缩的上句记忆) → 生成 '疑' (概率1.00)
     第2步: 状态来自上一步输出'疑' → 生成 '是' (概率1.00)
     第3步: 状态来自上一步输出'是' → 生成 '地' (概率1.00)
     第4步: 状态来自上一步输出'地' → 生成 '上' (概率1.00)
     第5步: 状态来自上一步输出'上' → 生成 '霜' (概率1.00)
     第6步 → 生成 <EOS>,停止
     → 疑是地上霜   (期望:疑是地上霜)
  把 C 偷换成'红豆生南国'的 → 生成:春来发几枝   (下句跟着变成红豆的了!)
  把 C 清零(无任何上句信息)→ 生成:云上一层楼   (没有上句,退化成乱猜)

结论:Decoder 全程没有直接接触上句原文,它对'上句是什么'的唯一了解就来自 C。
      换掉 C,输出就跟着变——这证明 C 是 Encoder 传给 Decoder 的、
      承载整个上句语义的【唯一桥梁】,也正是 Attention 后来要打开的瓶颈①。

================================================================
【E】批量验证:给上句 → 生成下句(greedy,应复现训练对)
================================================================
✅ 上句: 床前明月光  → 生成下句: 疑是地上霜   (真实: 疑是地上霜)
✅ 上句: 举头望明月  → 生成下句: 低头思故乡   (真实: 低头思故乡)
✅ 上句: 白日依山尽  → 生成下句: 黄河入海流   (真实: 黄河入海流)
✅ 上句: 欲穷千里目  → 生成下句: 更上一层楼   (真实: 更上一层楼)
✅ 上句: 春眠不觉晓  → 生成下句: 处处闻啼鸟   (真实: 处处闻啼鸟)
✅ 上句: 夜来风雨声  → 生成下句: 花落知多少   (真实: 花落知多少)
✅ 上句: 千山鸟飞绝  → 生成下句: 万径人踪灭   (真实: 万径人踪灭)
✅ 上句: 孤舟蓑笠翁  → 生成下句: 独钓寒江雪   (真实: 独钓寒江雪)
RNN Seq2Seq
在 Bengio 发布了 RNN Encoder–Decoder 之后不久(相隔数周),Google 也发布了论文《Sequence to Sequence Learning with Neural Networks》,提出了和 Encoder–Decoder 同源的 RNN Seq2Seq(Sequence to Sequence,序列到序列)架构。
可以将 Encoder–Decoder 理解为专用于 MT(Machine Translation,机器翻译)任务,而 Seq2Seq 则强调了其通用性,不仅仅用于 MT 领域,而是可以处理所有 Sequence to Sequence 的任务。或者说 Seq2Seq 验证了 Encoder–Decoder 架构在通用序列任务的适配性,让架构更具泛化性。
两者虽然有不同的作者,但他们提出了同源的思想和架构。后来,Seq2Seq 就成为此类架构的通称,而 Encoder–Decoder 架构的内核被纳入 Seq2Seq 的概念中,行业不再区分二者,统称 “Seq2Seq(Encoder–Decoder)模型”。
现如今,几乎所有的 NLP 任务都可以视为 Seq2Seq 任务,例如:文本分类任务,可以视为输出长度为 1 的目标序列;词性标注任务,可以视为输出与输入序列等长的目标序列。

RNN Encoder–Decoder 的致命缺陷
Transformer 出现之前,处理文本序列信息主要依靠的是 RNN Encoder–Decoder 模型。但 RNN Encoder–Decoder 却有 3 个难以弥补的缺陷:
- 定长向量 C 瓶颈:Encoder 和 Decoder 通过定长向量 C 来传递上下文语义信息,所以 C 的大小决定了可处理序列的长度。这是一个瓶颈,例如:Encoder 早期的上下文语义信息会被后期信息覆盖掉,最终使得 Decoder 无法获取早期信息。
- 无法并行计算:RNN 隐藏状态 h_t = f(h_{t-1}, x_t) 决定了第 t 步必须等第 t-1 步算完。序列有 n 个词,就得顺序走 n 步,没法利用 GPU 的并行能力。使得训练长文本语料时周期长、算力利用率低。
- 长程依赖 / 梯度消失:尽管 LSTM/GRU 用门控搞了条 “加法通路” 来缓解,但路径长度仍然是 O(n),只是衰减慢了,没根治。当序列长度超过数百词时,早期信息还是会被逐步稀释,模型难以捕捉长距离语义关联。
如下图所示,BLEU(Bilingual Evaluation Understudy)是一种自动评价机器翻译质量的指标,得分一般在 0~100 之间。得分越高,表示机器翻译结果与参考翻译越接近,质量越好。可见 RNN 随着 Sentence Length 的加大而减分。
上述 RNN 的致命缺陷直到 Attention 和 Transformer 架构提出后才得到了完全的解决。
- RNN-Attention 解决了问题 1;
- Transformer 继续解决了问题 2、3。
更多推荐

 7
 0
- 0


 已为社区贡献4条内容

所有评论(0)