
【CS336】|3-Transformer架构详解
3 transformer架构
以CS336课程为基础
☝️ 参考b站博主:炮哥带你学
☝️ Transformer算法原理与实战-课程链接
😄学习目标
- 熟悉各个模块的原理,及面试常见问题
- 数据流通时,形状是如何变化的?能口述下图结构
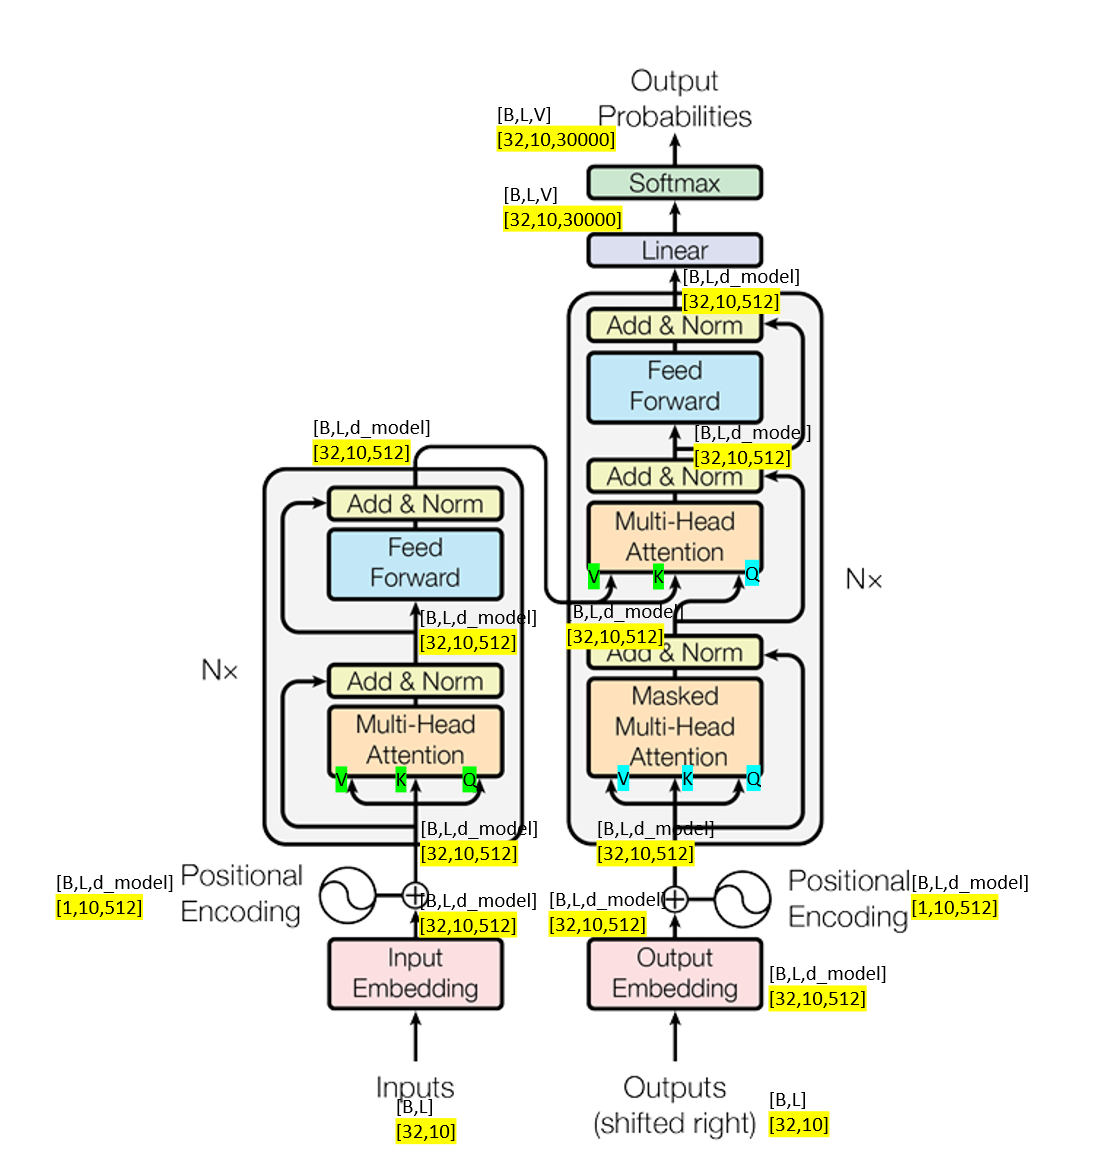
为更加具体,清晰展示各个模块中数据形状的变化,规定以下超参数:
- Batch Size(B)=32
- Seq Length(L)=10 【一句话的tokens】
- Embedding Dim(d_model)=512 【每个token的向量维度】
- Vocab Size(V)=30000 【词表大小,即词表的总tokens】
- Head(h)=8 【多头注意力的头数】
3.1 输入层-词嵌入(Input/Output Embedding)
-
核心:用多维向量,给每个Token附上语义信息
-
在论文中,维度Embedding Dim(d_model) = 512
-
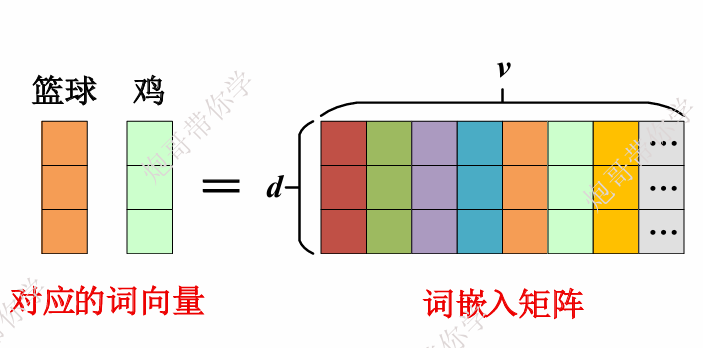
每一个
token(即每一个词)都有对应的词向量,维度为d_model -
词表大小为V,即共有V个token
-
所有的
词向量拼接,构成了词嵌入矩阵,大小为[V,d_modle]
❓面试常见问题
-
Embedding 层和 One-Hot 有什么区别?
- One-Hot: 稀疏、维度极其巨大(30000维)、无法表示词之间的相似度(正交)。
- Embedding: 稠密、维度低(512维)、可学习(语义相似的词在空间中距离更近)
-
Embedding 层的参数量怎么算?
- 公式: v × d v×d v×d
- 例子: 30 , 000 × 512 = 15 , 360 , 000 30,000 \times 512 = 15,360,000 30,000×512=15,360,000 (约 1500 万参数)
3.2 输入层-位置编码(Positional Encoding)
-
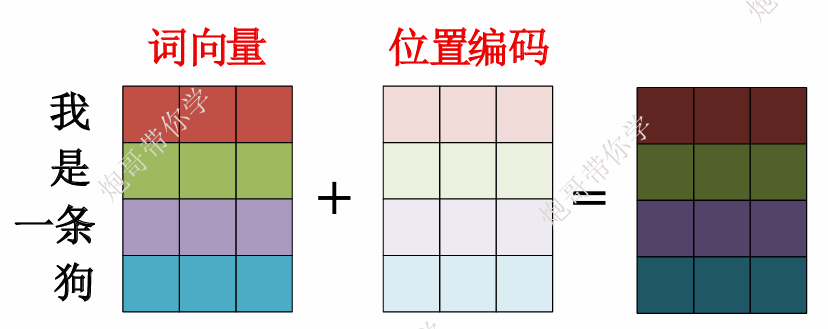
Input = Embedding ( T o k e n ) + Positional Encoding ( P o s ) \text{Input} = \text{Embedding}(Token) + \text{Positional Encoding}(Pos) Input=Embedding(Token)+Positional Encoding(Pos)
-
基于三角函数的编码公式,让位置编码具有周期性和相对位置推导能力
- d d d: 词向量的维度
- i = 0 , 1 , . . . d 2 − 1 i=0,1,...\frac{d}{2}-1 i=0,1,...2d−1
- p o s pos pos:指当前token在序列中的第几个位置
P E ( p o s , 2 i ) = sin ( p o s 10000 2 i d ) PE(pos, 2i) = \sin \left( \frac{pos}{10000^{\frac{2i}{d}}} \right) PE(pos,2i)=sin(10000d2ipos)
P E ( p o s , 2 i + 1 ) = cos ( p o s 10000 2 i d ) PE(pos, 2i+1) = \cos \left( \frac{pos}{10000^{\frac{2i}{d}}} \right) PE(pos,2i+1)=cos(10000d2ipos)
-
例子:“我 是 一 条 狗”位置索引 p o s = 0 , 1 , 2 , 3 pos = 0,1,2,3 pos=0,1,2,3,维度 d = 3 d=3 d=3 时:
-
p o s = 0 ( " 我 " ) pos = 0("我") pos=0("我"): 0.000000 , 1.000000 , 0.000000 0.000000, 1.000000, 0.000000 0.000000,1.000000,0.000000
-
p o s = 1 ( " 是 " ) pos = 1("是") pos=1("是"): 0.841471 , 0.540302 , 0.002154 0.841471, 0.540302, 0.002154 0.841471,0.540302,0.002154
-
p o s = 2 ( " 一条 " ) pos = 2("一条") pos=2("一条"): 0.909297 , − 0.416147 , 0.004309 0.909297, -0.416147, 0.004309 0.909297,−0.416147,0.004309
-
p o s = 3 ( " 狗 " ) pos = 3("狗") pos=3("狗"): 0.141120 , − 0.989992 , 0.006463 0.141120, -0.989992, 0.006463 0.141120,−0.989992,0.006463
-
3.3 多头注意力机制(Multi-Head Attention)
⛵️重点
- 核心公式(Q/K/V)
- 理解掩码Mask(填充掩码Padding Mask、因果掩码Causal Mask)的作用
- 理解编码器中“多头注意力机制”
- 理解解码器中“带因果掩码的多头注意力机制”、“多头交叉注意力机制”
3.3.1 Attention(注意力机制)
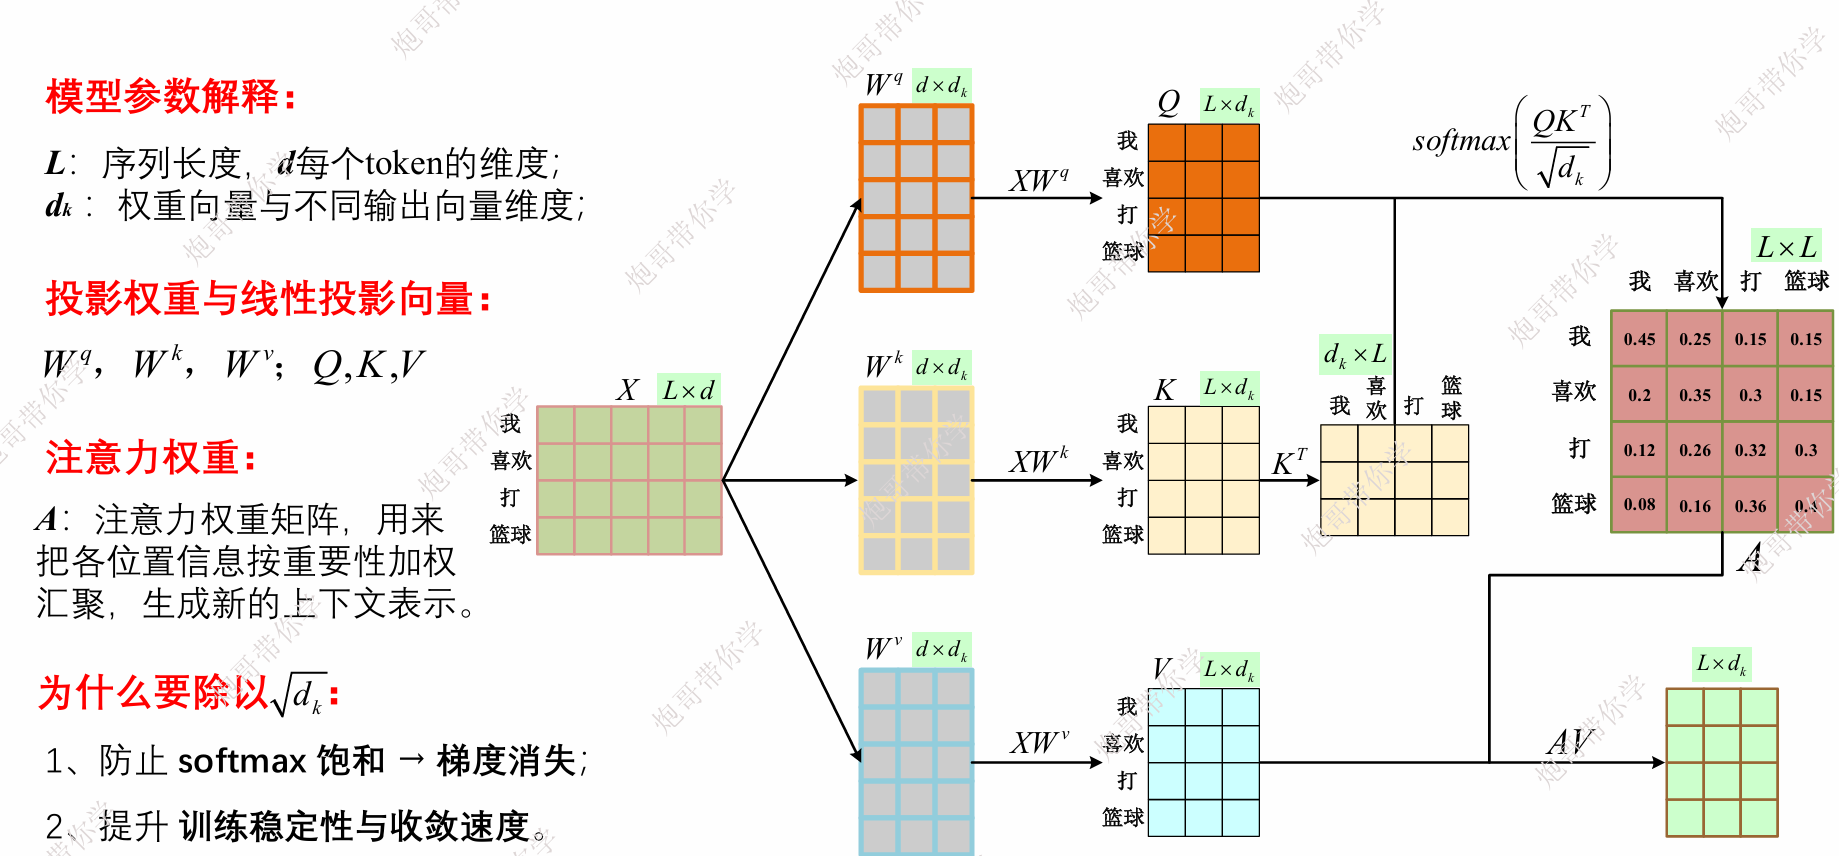
- 核心公式:
Attention
(
Q
,
K
,
V
)
=
softmax
(
Q
K
T
d
k
)
V
\text{Attention}(Q, K, V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V
Attention(Q,K,V)=softmax(dkQKT)V
- s c r o e = Q K T scroe=QK^T scroe=QKT,用 Q Q Q与 K K K作点积算相似度,记为分数 s c o r e score score
- Q Q Q (Query - 查询): 你手里的便利贴(“我想找关于 AI 的书”)
- K K K (Key - 索引): 书脊上的标签(“计算机科学”、“烹饪”、“历史”)
- V V V (Value - 内容): 书里的具体内容
- 为什么要有
d
k
\sqrt{d_k}
dk
- 原因: 防止点积结果过大。如果数值太大,Softmax 函数会进入“饱和区”(梯度几乎为 0),导致反向传播时梯度消失,模型练不动。
-
Softmax
(
x
i
)
=
e
x
i
∑
j
e
x
j
\text{Softmax}(x_i) = \frac{e^{x_i}}{\sum_{j} e^{x_j}}
Softmax(xi)=∑jexjexi
- Softmax 是一个归一化函数。它把一堆杂乱无章、有正有负的“原始分数 (Logits)”,瞬间变成一套总和为 1 的“概率分布”。
3.3.2 Multi-Head (多头)
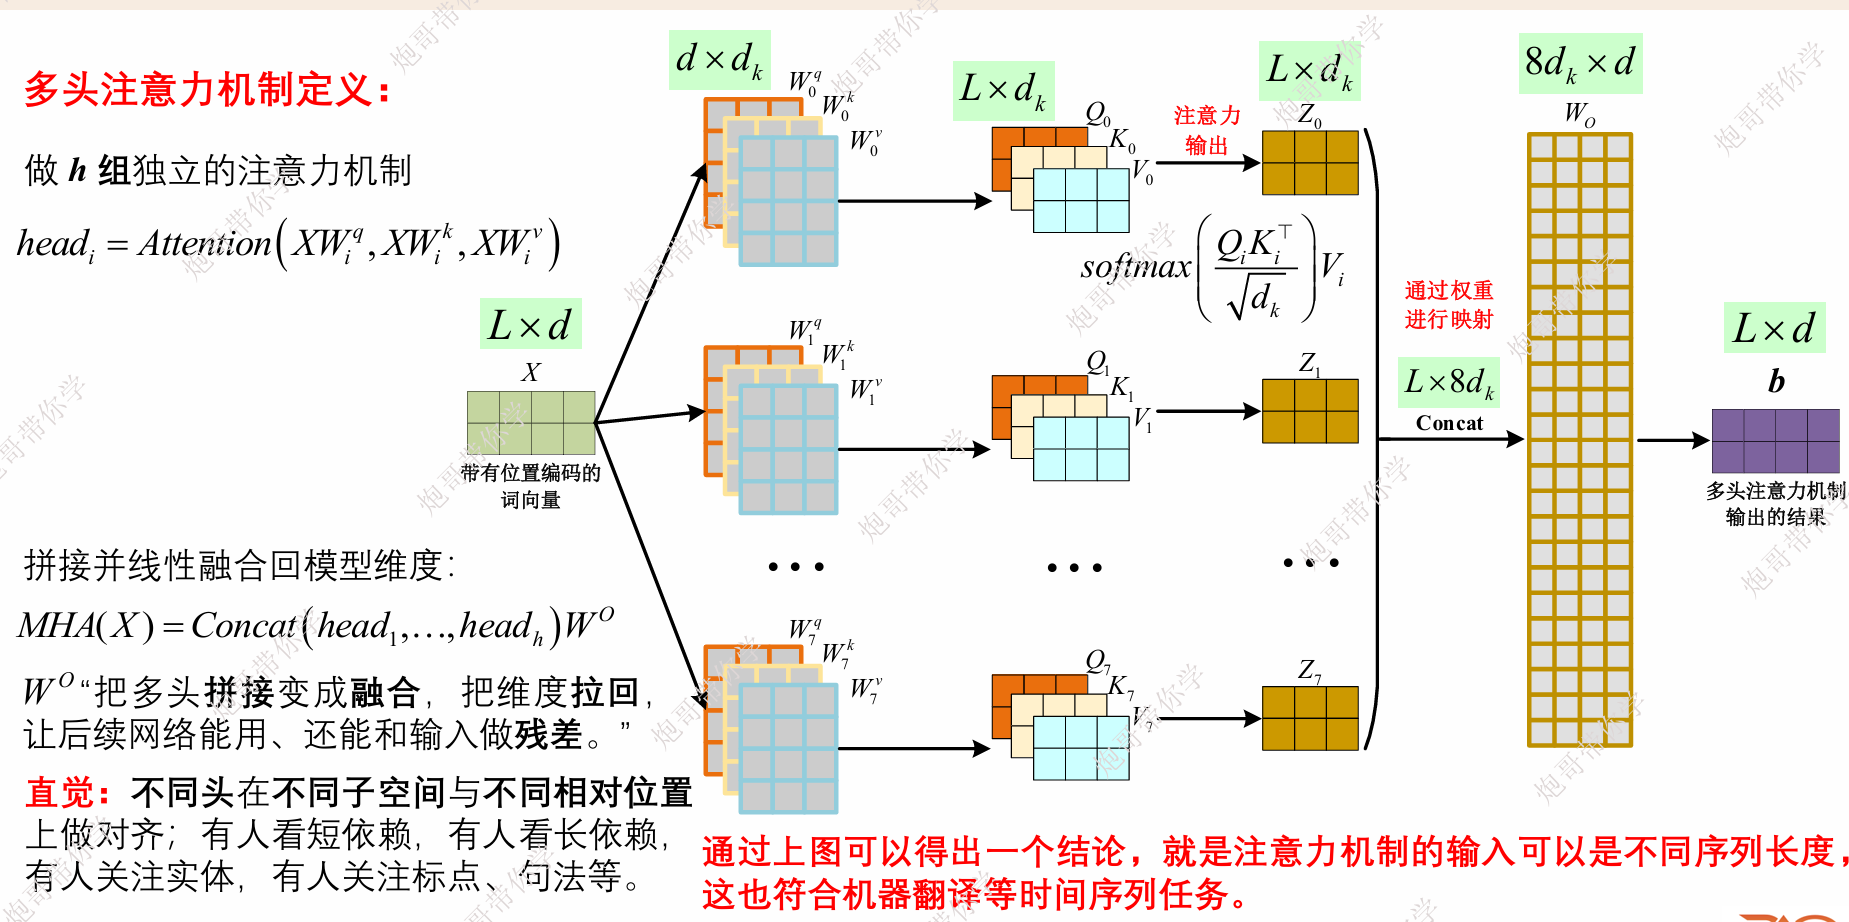
😭 理解数据维度变换
假设 B = 32 , L = 10 , D m o d e l = 512 , H e a d s = 8 B=32, L=10, D_{model}=512, Heads=8 B=32,L=10,Dmodel=512,Heads=8。每个头维度 d k = 512 / 8 = 64 d_k = 512/8 = 64 dk=512/8=64。
-
Linear Projection ( Q , K , V Q, K, V Q,K,V):
- 输入
[32, 10, 512]经过三个不同的线性层。 - 形状不变:
[32, 10, 512]。
- 输入
-
Split Heads (拆头):
- 把 512 拆成 8 × 64 8 \times 64 8×64。
- Shape:
[32, 10, 8, 64]。
-
Transpose (转置):
- 把 Heads 维度移到前面,让每个头独立计算。
- Shape:
[32, 8, 10, 64](Batch, Heads, Seq, Dim)。
-
Attention Score:
- Q × K T Q \times K^T Q×KT
- Result:
[32, 8, 10, 10](注意最后是 10 × 10 10 \times 10 10×10 的矩阵,代表词与词的关系)。
-
Concat (拼接):
- 计算完并转置回来:
[32, 10, 8, 64]。 - 拼起来:
[32, 10, 512]。 - 拼接方式:

- 计算完并转置回来:
-
Final Linear:
- 混合各头的信息:
[32, 10, 512]。
- 混合各头的信息:
3.3.3 Mask (掩码)
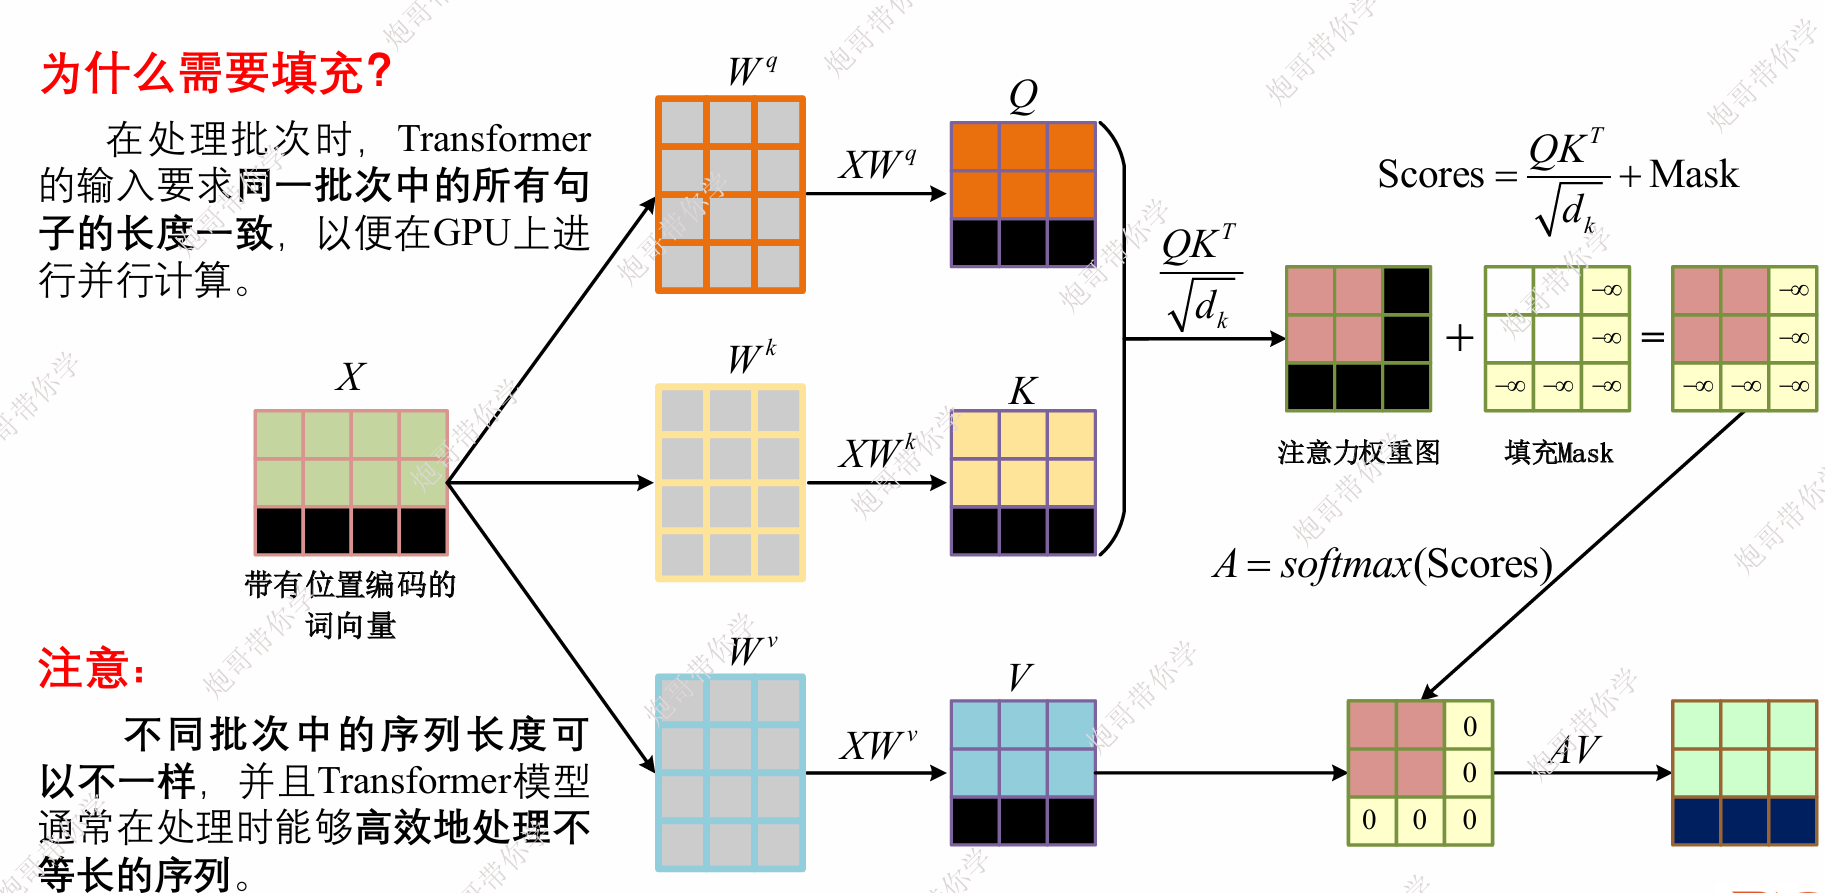
😕 在 Attention 计算中,有些东西是不能看的,我们需要用 Mask 把它们的注意力分数设为 − ∞ -\infty −∞ (Softmax 后变成 0)
3.3.3.1 Padding Mask (填充掩码)
- 场景: 在同一批次中的所有句子的长度要求一致(token数相同),句子长短不一,短句子后面补了
0。 - 目的: 不让 Attention 关注到这些没有意义的
0。 - 应用:
Encoder和Decoder都要用。
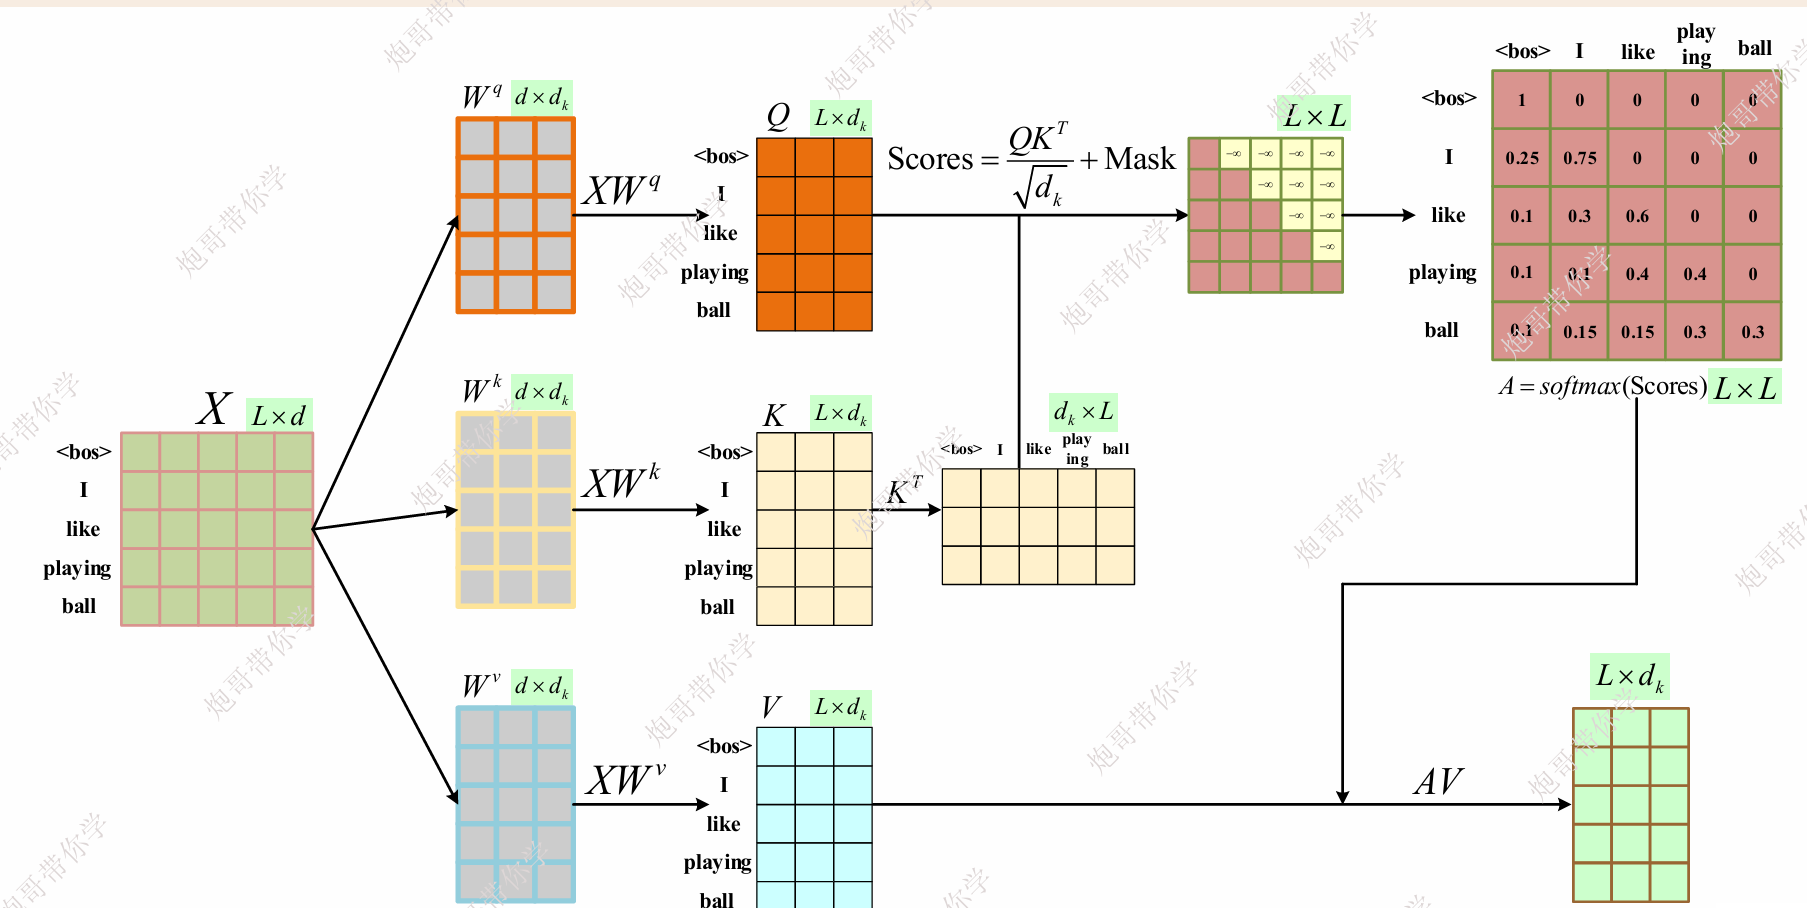
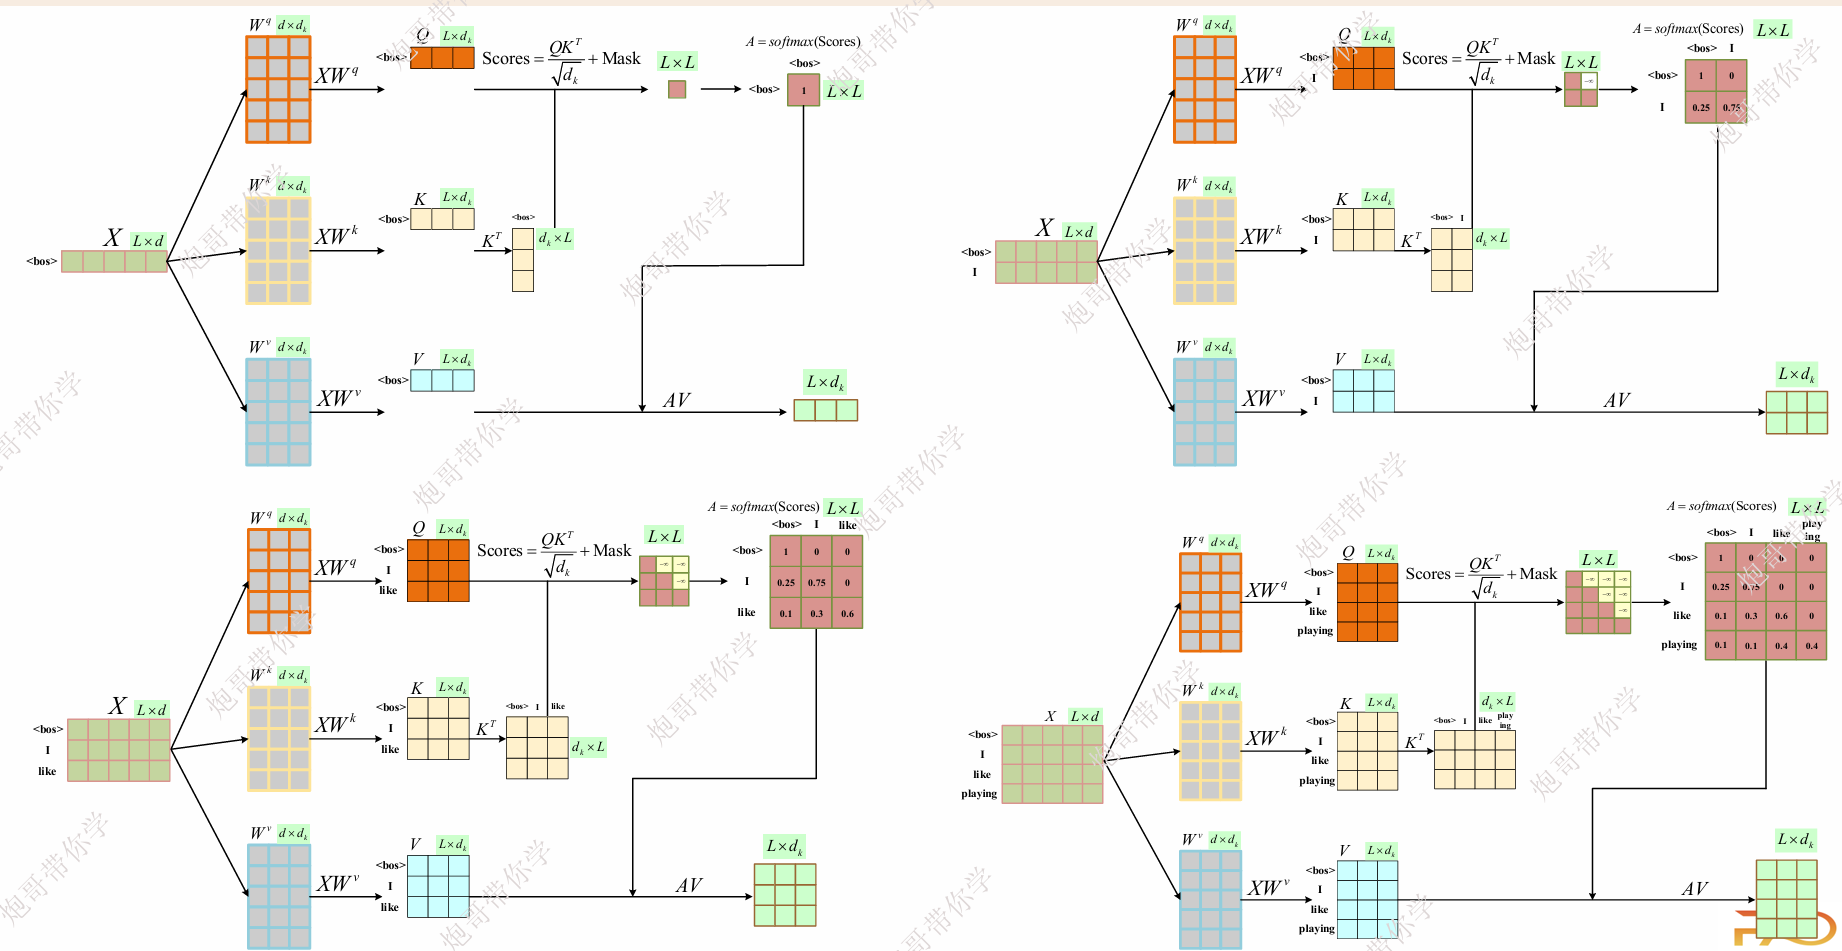
3.3.3.2 Causal Mask (因果掩码)
-
场景: 在并行计算的同时,强行保留串行的因果逻辑
-
目的: 训练 Decoder 时,预测第 i i i 个词,只能看 0 0 0 到 i − 1 i-1 i−1 的词,绝对不能偷看 i + 1 i+1 i+1 及其后面的词。
- 训练时:我们手里拿着“标准答案”(比如整句翻译结果)。
- 作弊风险:如果我们把标准答案一股脑喂给解码器,模型在预测第 2 个词时,如果不加掩码,它就能通过 Self-Attention 直接“偷看”到第 3 个词是什么。
- 后果:模型会学会“抄答案”,而不是“学语法和语义”。一到考试(推理)时,没有答案可抄,模型就废了。
-
形状: 一个上三角矩阵(全为 − ∞ -∞ −∞)。
-
应用: 仅用于
Decoder 的第一层Attention (Masked Self-Attention)。 -
**例子:**假设我们要训练模型把 “I love AI” 翻译成 “我爱AI”。
-
标准答案 (Ground Truth):
<s> 我 爱 AI <eos> -
解码器输入 (Decoder Input):
<s> 我 爱 AI(注意向右平移了一位) -
当前位置 此时模型看到了什么? 掩码遮住了什么?(Future) 模型应该预测什么? 第 0 步 <s>我,爱,AI(全黑掉)我 第 1 步 <s>,我爱,AI(黑掉)爱 第 2 步 <s>,我,爱AI(黑掉)AI 第 3 步 <s>,我,爱,AI<eos>(实际上是 Padding)
-
(1)训练过程
(2)推理过程
3.3.4 Cross-Attention(交叉注意力机制)
- 位于解码器的第二层
- 与注意力机制相同,唯一不同的是Q、K、V的来源
- Q来自解码器
- K、V来自编码器
❓面试常见问题
- Transformer 的解码器里有两层 Attention,有什么区别?
- 第一层 (Masked Self-Attention): Q,K,V 都来自 Decoder 自己。加了 Causal Mask。作用是理解已生成的译文。
- 第二层 (Cross-Attention): Q 来自 Decoder,K,V 来自 Encoder。只加 Padding Mask。作用是对齐原文和译文。
3.4 Feed-Forward Networks (FFN)(前馈神经网络)
😆如果说 Attention 是在“看”(收集上下文信息),那么 FFN 就是在“想”(消化和整合这些信息)。 它对序列中的每一个位置 (Token) 独立地进行处理,且用的是同一套参数。
(1)FFN 的结构—三明治结构
就是两层全连接层(Linear),中间夹一个非线性激活函数。
(2)FFN中的维度变化
【Transformer 的 FFN 有一个标志性的**“先膨胀,后压缩”**设计】
输入: [Batch, Seq_Len, 512] (
d
m
o
d
e
l
d_{model}
dmodel)
第一层 (膨胀): 映射到 4 倍宽度的维度。
- 维度变化: 512 → 2048 512 \to 2048 512→2048 ( d f f d_{ff} dff)
- 作用:把数据投射到高维空间,让特征更容易被区分(解缠)。
激活函数: ReLU (原始)
第二层 (压缩): 映射回原来的维度。
- 维度变化: 2048 → 512 2048 \to 512 2048→512 ( d m o d e l d_{model} dmodel)
- 作用:把提取好的特征压缩回来,方便传给下一层。
输出: [Batch, Seq_Len, 512]
(3)核心公式
FFN ( x ) = Activation ( x W 1 + b 1 ) W 2 + b 2 \text{FFN}(x) = \text{Activation}(xW_1+b_1)W_2+b_2 FFN(x)=Activation(xW1+b1)W2+b2
- A c t i v a t i o n Activation Activation为激活函数,Transformer 使用的是ReLU
- W W W为权重, b b b为偏置
3.5 Add & Norm(残差连接与层归一化)
☺️一句话定义: 它俩是深度学习的“稳定器”和“高速公路”。
- Add: 建立信息直通车,防止信息在深层网络中丢失。
- Norm: 统一数据分布,让模型训练得又快又稳。
3.5.1 Add: Residual Connection (残差连接)
核心公式: Output = x + SubLayer ( x ) \text{Output} = x + \text{SubLayer}(x) Output=x+SubLayer(x)
-
x x x: 上一层的原始输入(原汁原味的信息)。
-
SubLayer ( x ) \text{SubLayer}(x) SubLayer(x): 这一层计算出的新特征(Attention 或 FFN 的结果)。
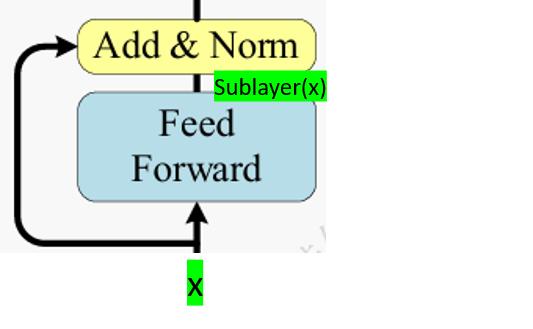
上图为transformer架构中每一个Block中的最后子层,对应到上述残差连接的核心公式
x为经过Attention后的结果-
S
u
b
L
a
y
e
r
(
x
)
SubLayer(x)
SubLayer(x)为经过
Feed-Forward Network (FFN)后的结果
❓面试常见问题
- 残差连接为什么要相加?(Why Add?)
- 解决梯度消失 : 在反向传播时,梯度通常是连乘的(越乘越小)。有了加法,梯度可以直接通过 x x x 这条路(导数为 1)毫无损耗地传回前面的层。
- 兜底机制: 如果这一层(SubLayer)学得很烂或者没用,模型可以简单地把权重设为 0,这样输出就等于 x x x(恒等映射)。这保证了加了一层至少不会比不加更差。
3.5.2 Norm: Layer Normalization (层归一化)
在计算机视觉 (CV) 里我们常用 Batch Norm,但在 自然语言处理(NLP) 里我们用 Layer Norm。
- 层归一化(Layer Norm)
- 归一化对象:每个样本的每一层(特征维度)进行归一化
- 计算方式:对单个样本的每一层的所有神经元进行归一化
- 核心公式:
LayerNorm
(
x
)
=
x
−
μ
σ
+
ϵ
⋅
γ
+
β
\text{LayerNorm}(x) = \frac{x - \mu}{\sigma + \epsilon} \cdot \gamma + \beta
LayerNorm(x)=σ+ϵx−μ⋅γ+β
- μ \mu μ (均值): 这一个词向量里 512 个数的平均值。
- ** σ \sigma σ **(方差): 这一个词向量里 512 个数的标准差。
- ϵ \epsilon ϵ: 一个极小的数,防止除以 0。
❓面试常见问题
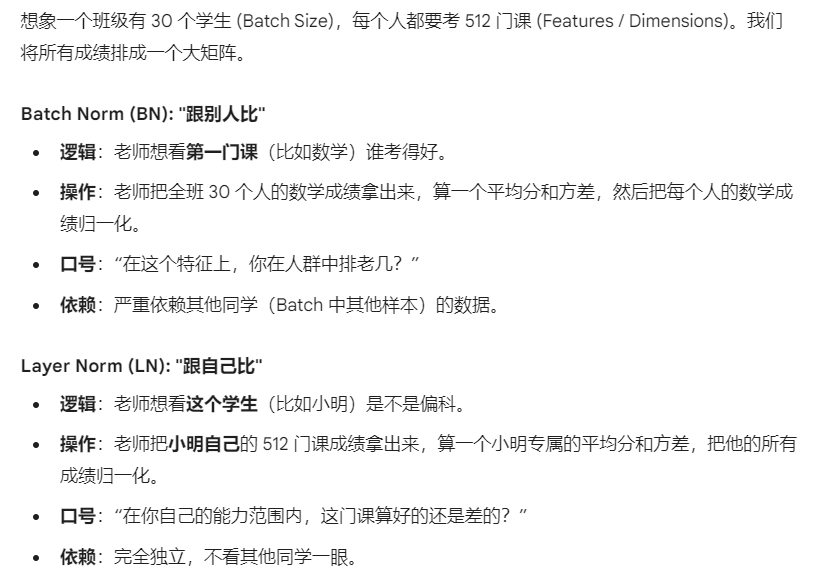
- Batch Norm和Layer Norm的区别是什么?
- 简单来说:Batch Norm (BN) 是“竖着切”(对一个特征),Layer Norm (LN) 是“横着切”(对所有特征)。
- 用学生的考试成绩来直观比喻
3.6 整体架构
😴重点
- 以输入数据
[32, 10]且词嵌入向量维度为512为例,疏通整个架构中数据的维度变化 - Block是什么?
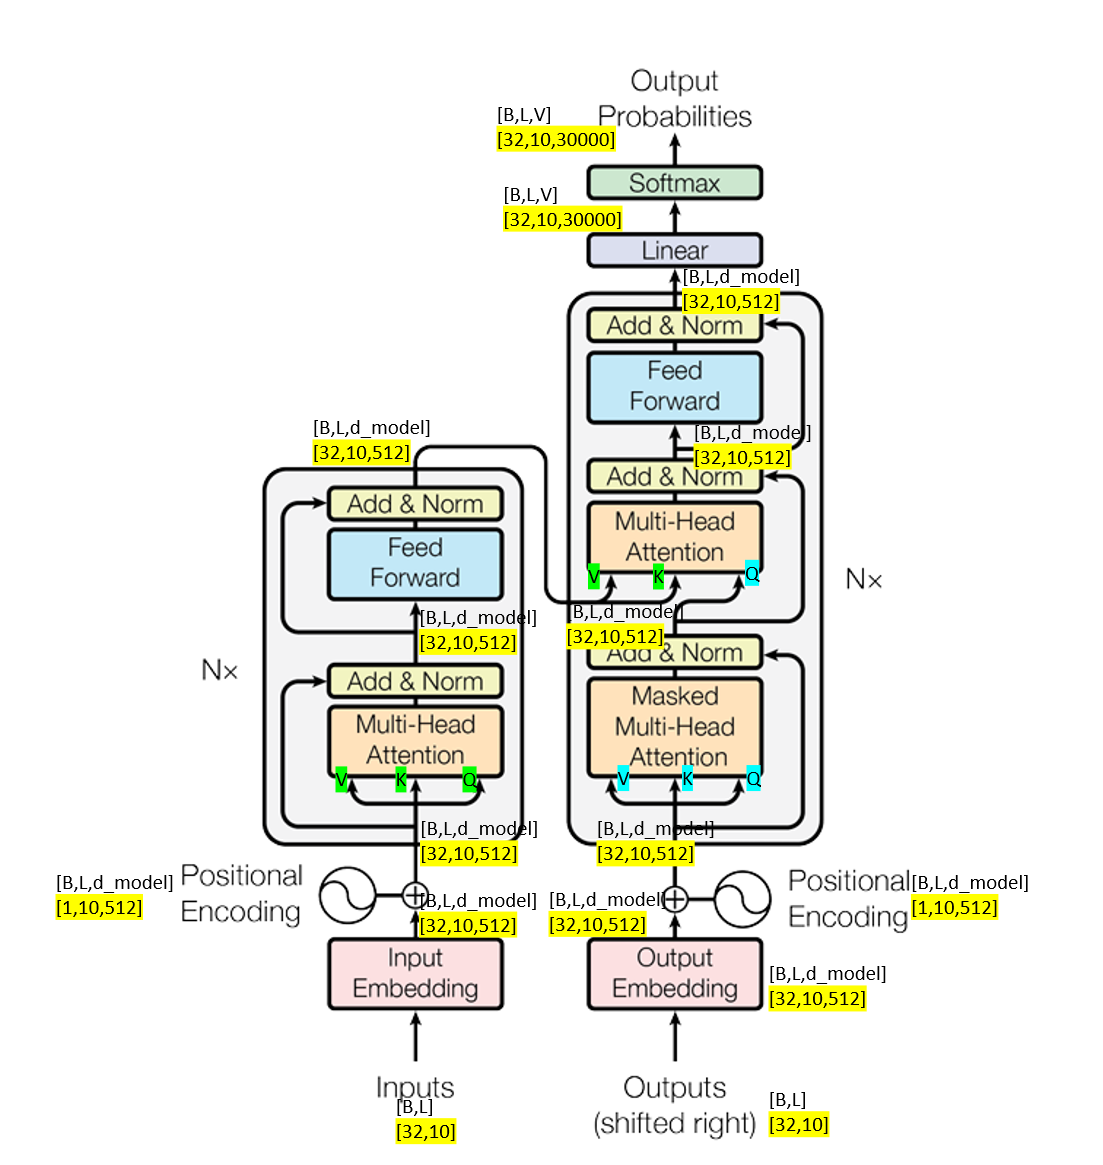
一个Block由三部分组成:Attention + FFN + Add & Norm
- Encoder Block
- Decoder Block
1️⃣Encoder Block (2 个子层) [它是用来“理解”输入的]
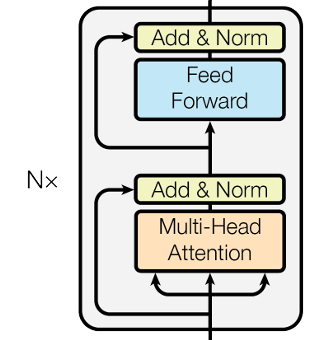
-
Sub-layer 1: Multi-Head Self-Attention + Add & Norm
-
Sub-layer 2: Feed-Forward Network (FFN) + Add & Norm
2️⃣Decoder Block (3 个子层) [它是用来“生成”输出的]
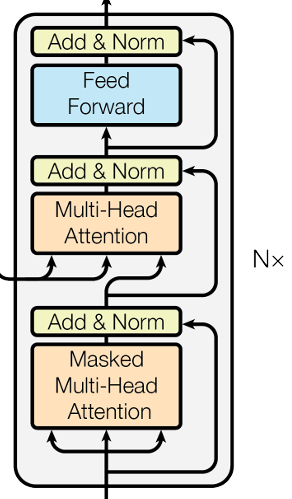
-
Sub-layer 1: Masked Self-Attention + Add & Norm
- 注意:这里带 Mask,防偷看。
-
Sub-layer 2: Cross-Attention + Add & Norm
- 注意:这里连接 Encoder 的输出 (K, V)。
-
Sub-layer 3: Feed-Forward Network (FFN) + Add & Norm
更多推荐


 17
 0
- 0


 已为社区贡献4条内容

所有评论(0)