
拿捏 3 个超参数,让大模型训练效果原地起飞!
·
还在为大模型训练效果差、稳定性低头疼?学习率、训练轮数、批次大小堪称训练黄金三角,选对参数区间,轻松打通模型训练任督二脉!
Learning Rate (学习率)、Number of Epochs (训练轮数)、Batch Size (批次大小)是深度学习(特别是大模型微调/训练)中最核心的三个超参数。设置得好,模型聪明又稳定;设置不好,模型可能“学傻了”或者“根本学不会”。
以下是针对大模型训练(尤其是微调,如 LoRA、全量微调)的详细设置指南:
1. Learning Rate (学习率)
定义:模型每次更新参数时“步子迈多大”。
- 太大了:模型会像无头苍蝇一样乱撞,损失函数(Loss)不下降反而震荡,甚至报错(NaN),导致模型学废了。
- 太小了:模型学得极慢,像蜗牛爬,可能训练结束了还没收敛,或者陷入局部最优解。
✅ 如何设置:
- 全量微调 (Full Fine-tuning):通常需要很小,建议 1e-5 (0.00001) 到 5e-5 (0.00005)。
- LoRA / QLoRA 微调:因为只训练很少的参数,步子可以迈大一点,通常建议 1e-4 (0.0001) 到 3e-4 (0.0003)。
- 预训练 (Pre-training):通常较大,但在微调阶段绝不能用预训练的学习率。
💡 经验法则:
如果不确定,先从 2e-4 (0.0002) 开始(针对 LoRA),或者 2e-5(针对全量)。如果 Loss 震荡不降,就减小 10 倍;如果 Loss 降得太慢,就增大一点。
2. Number of Epochs (训练轮数)
定义:模型把所有训练数据“从头到尾看几遍”。
- 太少了 (Underfitting):书还没看完就上考场,模型没学会知识。
- 太多了 (Overfitting):书背得滚瓜烂熟,但只会死记硬背,遇到新题(测试集)就不会做了,泛化能力变差。
✅ 如何设置:
- 数据量很大 (几十万条以上):通常 1 个 Epoch 就够了。大模型记忆力很强,看一遍就能记住很多。
- 数据量中等 (几千到几万条):通常 3 个 Epoch 是黄金标准。
- 数据量很小 (几百条):可能需要 5-10 个 Epoch,甚至更多,迫使模型反复榨取数据里的规律。
💡 经验法则:
大多数微调任务,3 Epochs 是最安全的默认值。如果你发现模型开始复读机或者胡言乱语,说明训练过头了,减少 Epoch。
3. Batch Size (批次大小)
定义:模型一次“一口气”吃多少条数据再进行一次参数更新。
- 太大了:
- 优点:训练速度快,梯度估算准确,训练稳定。
- 缺点:显存容易爆 (OOM)。这是显存杀手。
- 太小了:
- 优点:省显存。
- 缺点:训练慢,且因为每次只看几条数据,梯度方向不稳定,Loss 曲线会像心电图一样剧烈抖动,难以收敛。
✅ 如何设置:
这完全取决于你的显卡显存 (GPU Memory)。
- 显存很大 (A100/H100/L40S):可以设 32, 64, 甚至 128。
- 显存一般 (3090/4090/A10):通常设 4, 8, 或 16。
- 显存很小:只能设 1 或 2。
💡 关键技巧 (Gradient Accumulation 梯度累积):
如果你的显卡只能跑 Batch Size = 1,但你希望达到 Batch Size = 64 的稳定效果,可以设置 梯度累积步数 (Gradient Accumulation Steps)。
- 公式:
实际 Batch Size = 单卡 Batch Size * 梯度累积步数 * 显卡数量 - 例子:你设 Batch Size = 2,梯度累积 = 16,那么模型实际上是攒够了 32 条数据才更新一次参数。这样既省显存,又能保证训练效果。
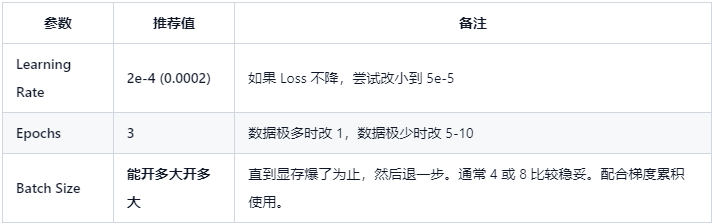
🚀 总结推荐配置 (抄作业版)
假设你在做 LoRA 微调(最常见的场景):
更多推荐


 16
 0
- 0


 已为社区贡献6条内容

所有评论(0)