
大语言模型系统:【CMU 11-868】课程学习笔记01——大模型介绍(Introduction to LLM)
大语言模型系统:【CMU 11-868】课程学习笔记01——大模型介绍(Introduction to LLM)
前言
【CMU 11-868】课程面向研究生开设,聚焦“从算法到工程”的大语言模型系统构建全过程。课程内容包括但不限于:
- GPU 编程与自动微分:掌握 CUDA kernel 调用、并行编程基础,以及深度学习框架设计原理
- 模型训练与分布式系统:学习高效的训练算法、通信优化(ZeRO、FlashAttention)、分布式训练框架(DDP、GPipe、Megatron-LM)。
- 模型压缩与加速:量化(GPTQ)、稀疏化(MoE)、编译技术(JAX、Triton)、以及推理时的服务化设计(vLLM、CacheGen)。
- 前沿技术与系统实践:涵盖检索增强生成(RAG)、多模态 LLM、RLHF 系统,以及端到端的在线维护和监控。
一、大语言模型的能力(Capabilities of LLMs)
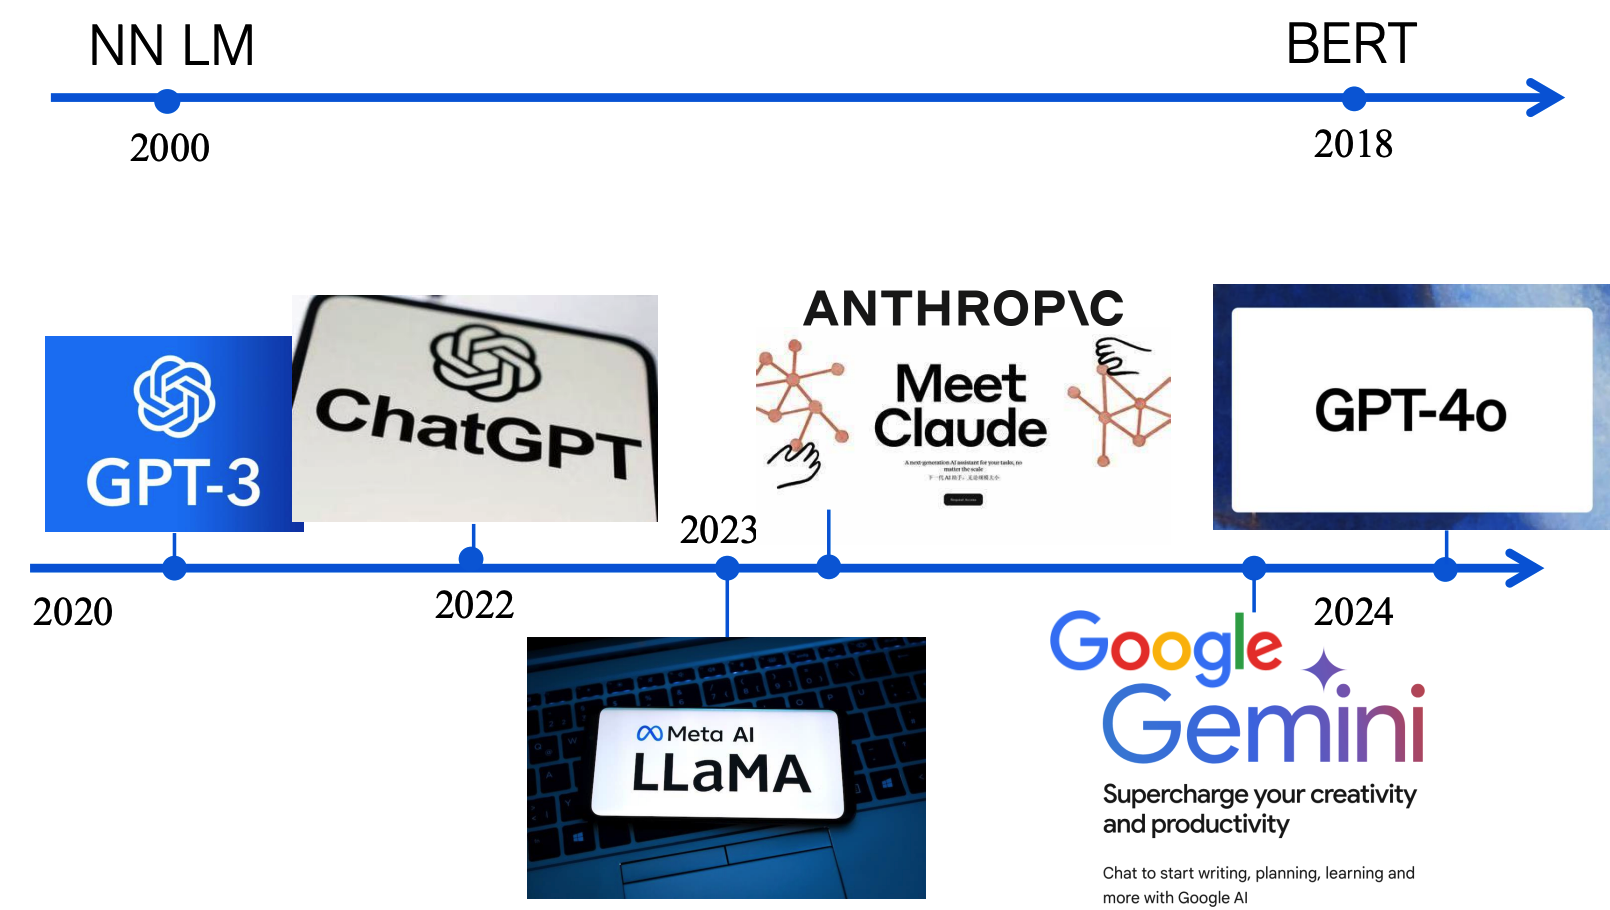
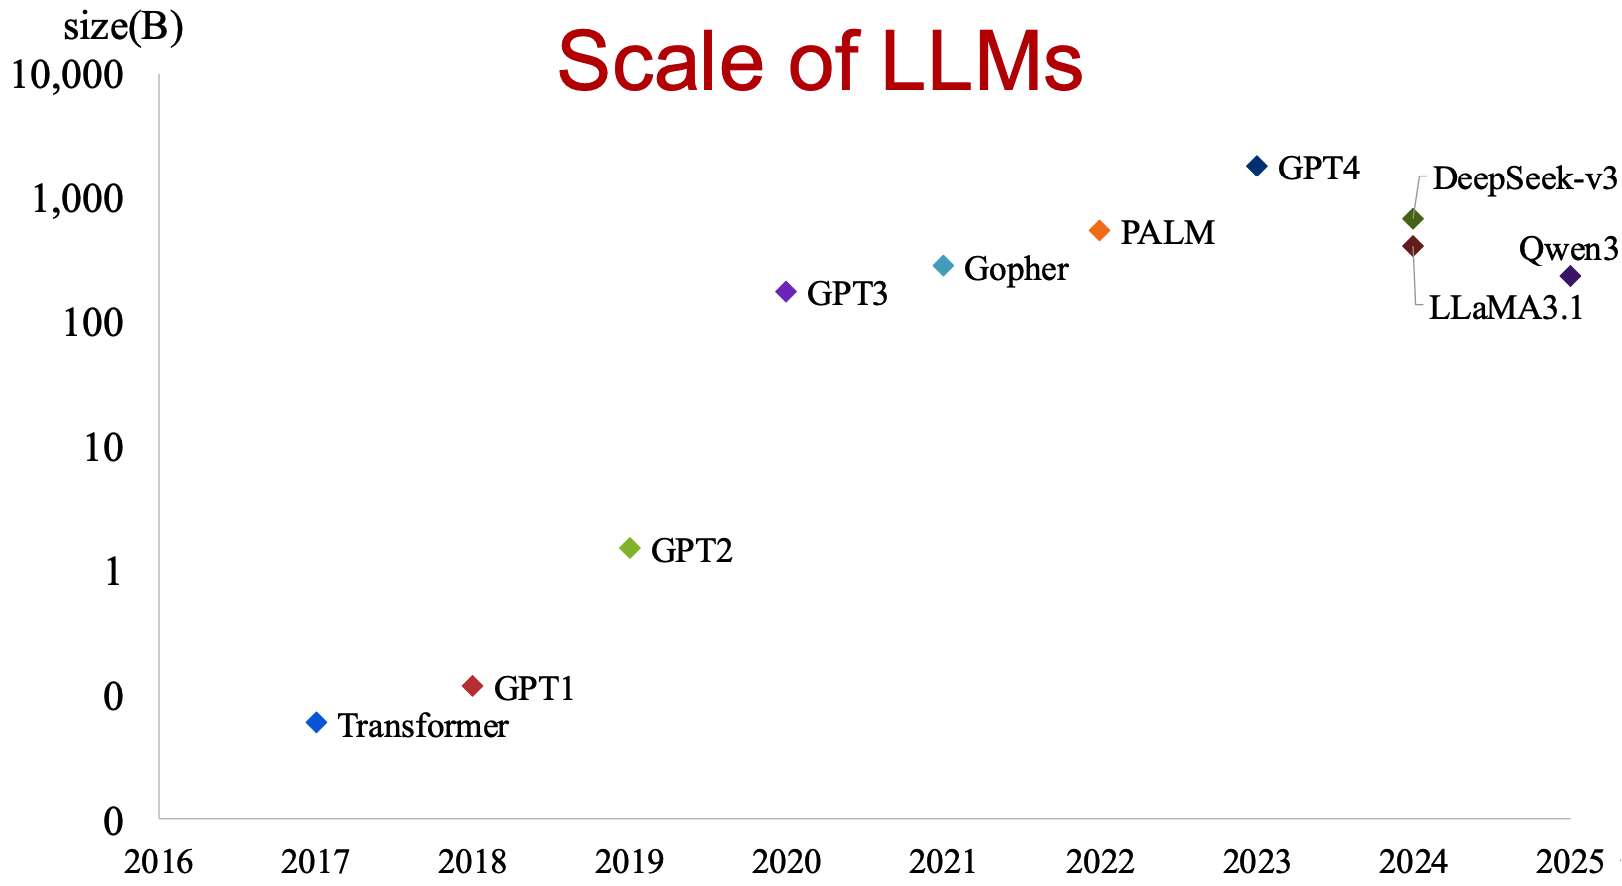
大模型的发展历程和规模增长趋势如下图所示:
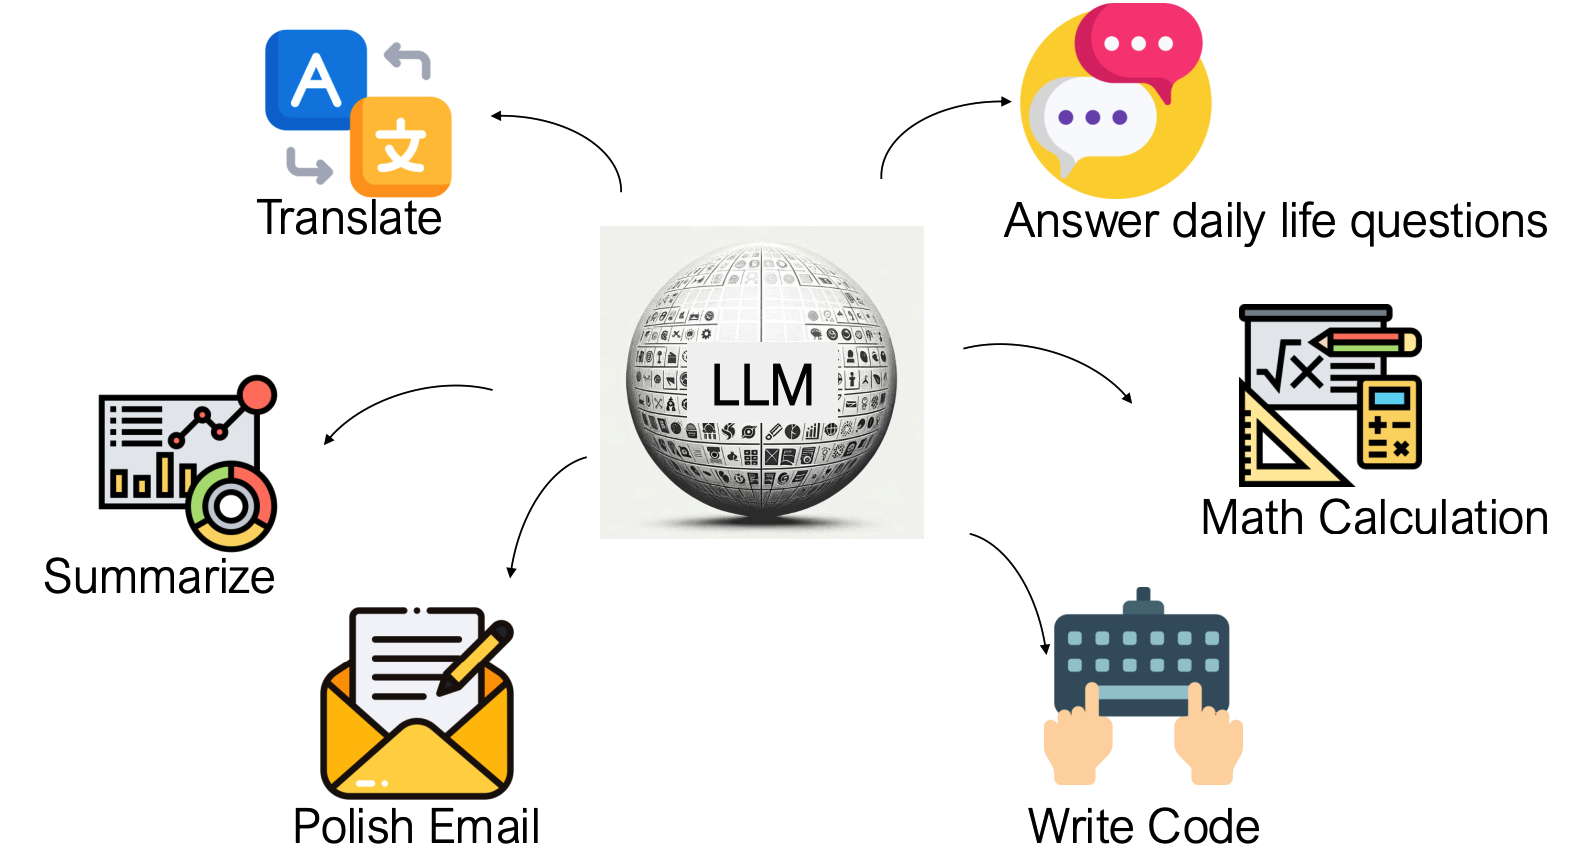
LLM的能力包括翻译、总结、回答日常问题、数学计算、润色邮件、编写代码等 。
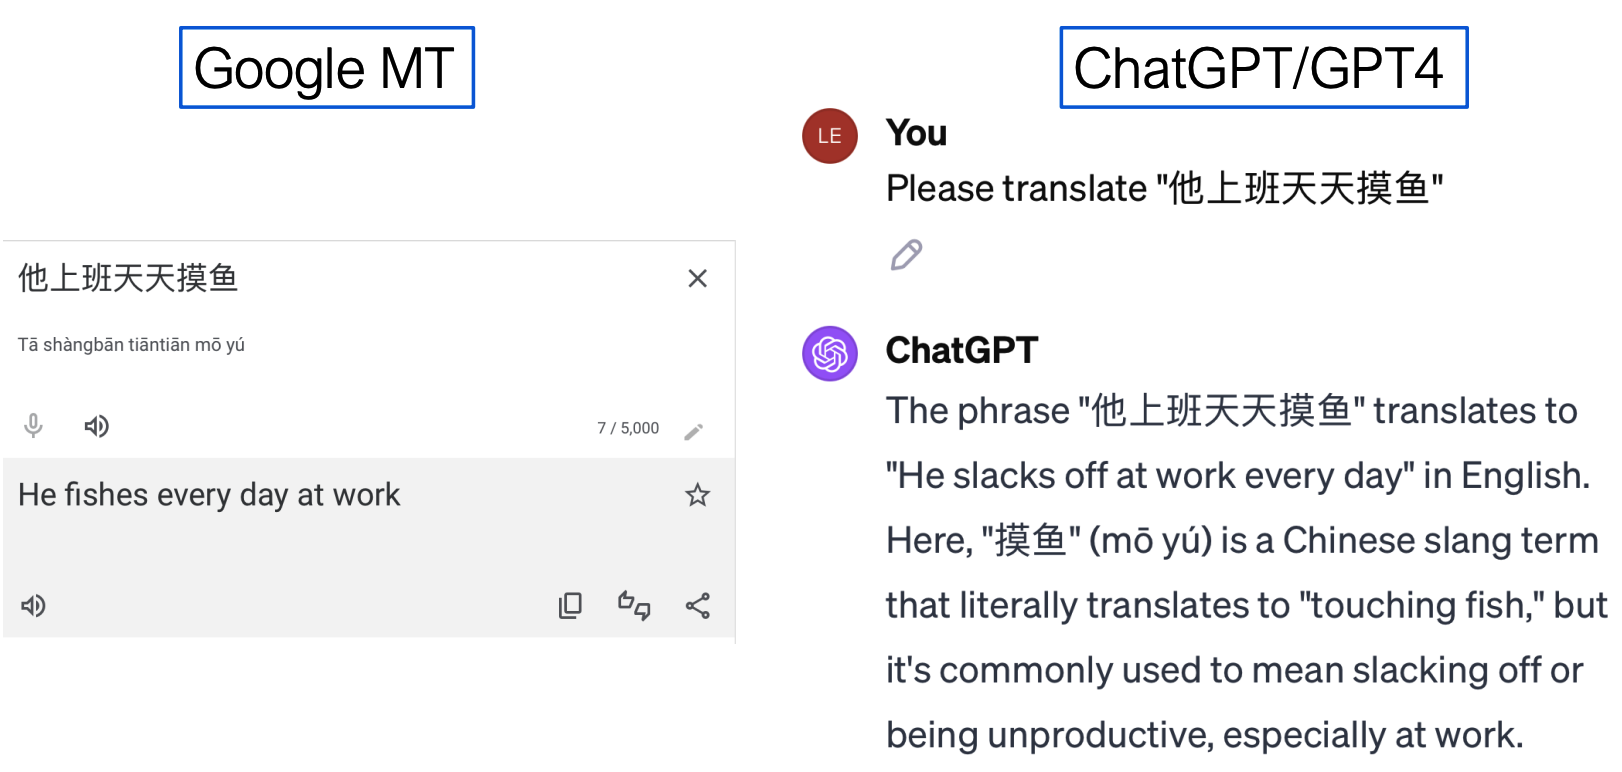
1️⃣ 翻译(Translation)
2️⃣ 模仿用户风格(ChatBot to Mimic a User)
使用微信(WhatsApp)聊天数据进行训练(大约 10 条聊天记录就足够了),耗时约几个小时,生成模仿用户风格的回复。
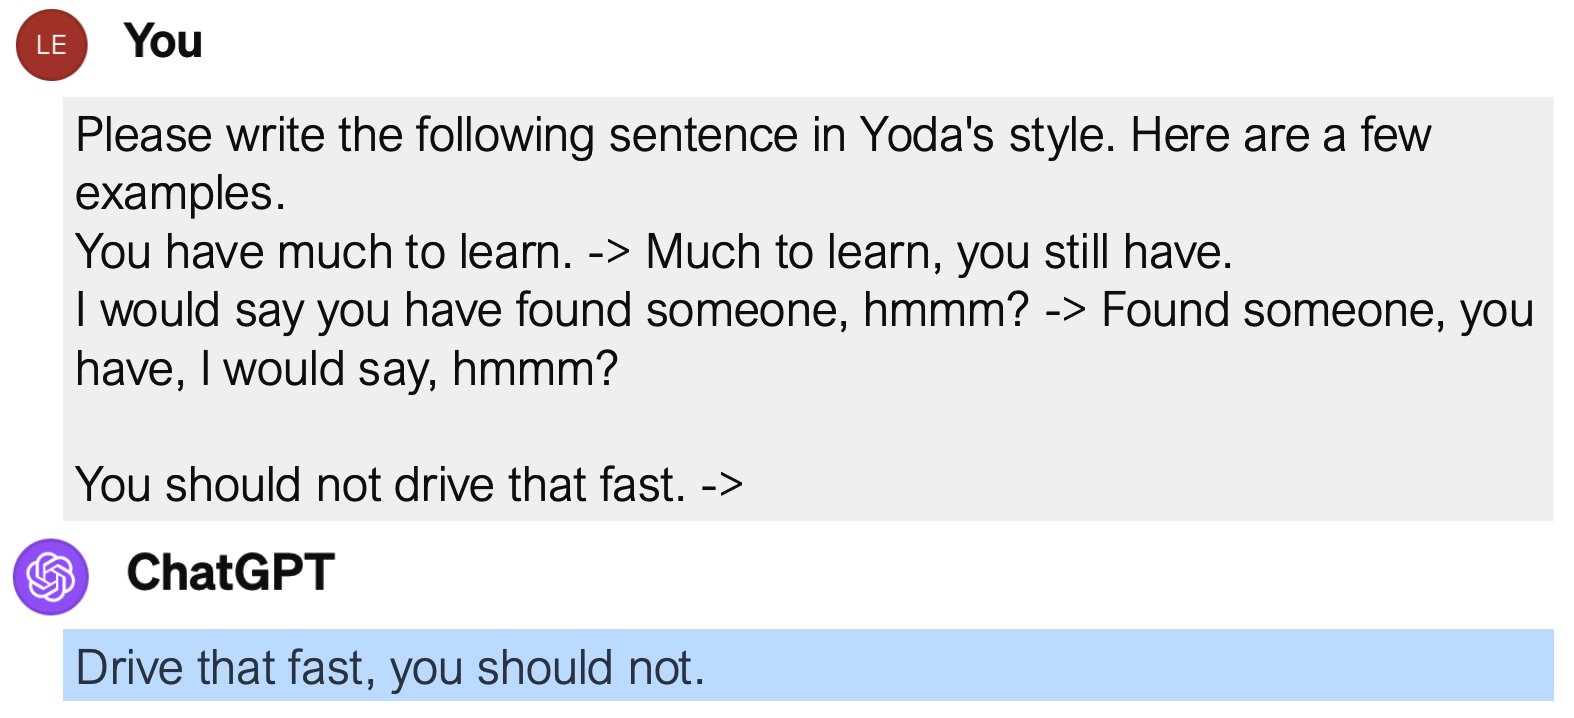
3️⃣ 风格重写(Rewrite Text with Style)
- Q:请用尤达的风格写下这句话。这里有几个例子。
你还有很多要学的。-> 还有很多要学的,你仍然有。
我会说你找到人了,嗯?-> 找到人了,你已经,我会说,嗯?
你不应该开那么快。->- A:开那么快,你不应该。
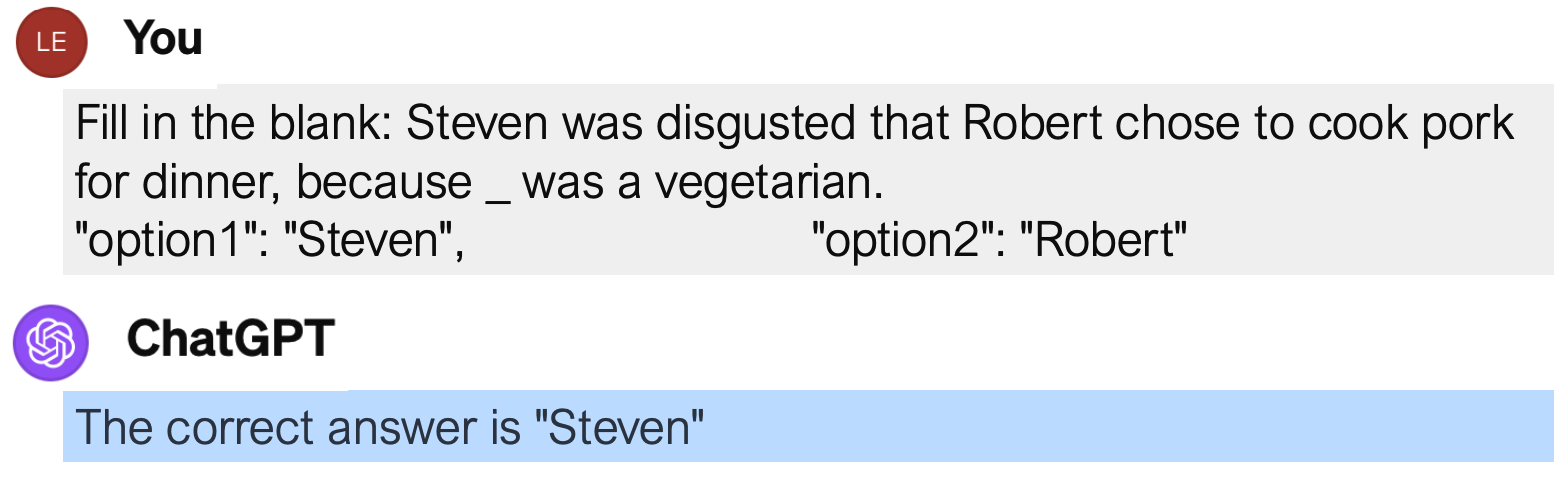
4️⃣ 常识推理(Commonsense Reasoning)
- Q:填空:史蒂文对罗伯特选择做猪肉当晚餐感到厌恶,因为___是个素食主义者。
“选项1”: “史蒂文”, “选项2”: “罗伯特”- A:正确答案是“史蒂文”。
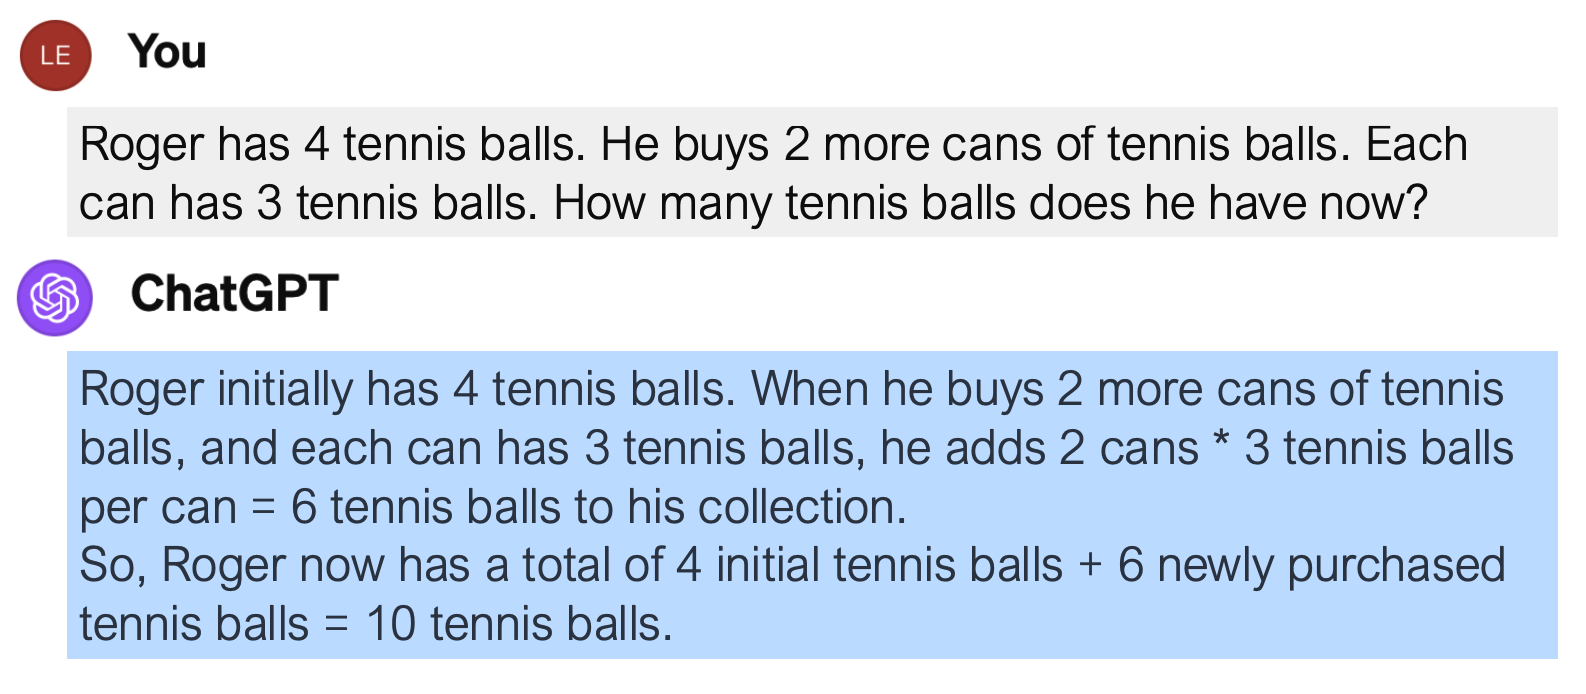
5️⃣ 数学推理(Math Reasoning)
- Q:罗杰有4个网球。他又买了2罐网球。每罐有3个网球。他现在有多少个网球?
- A:罗杰最初有4个网球。当他再买2罐网球,且每罐有3个网球时,他的收藏就增加了2罐×每罐3个网球=6个网球。
所以,罗杰现在总共有4个初始网球+6个新购买的网球=10个网球。
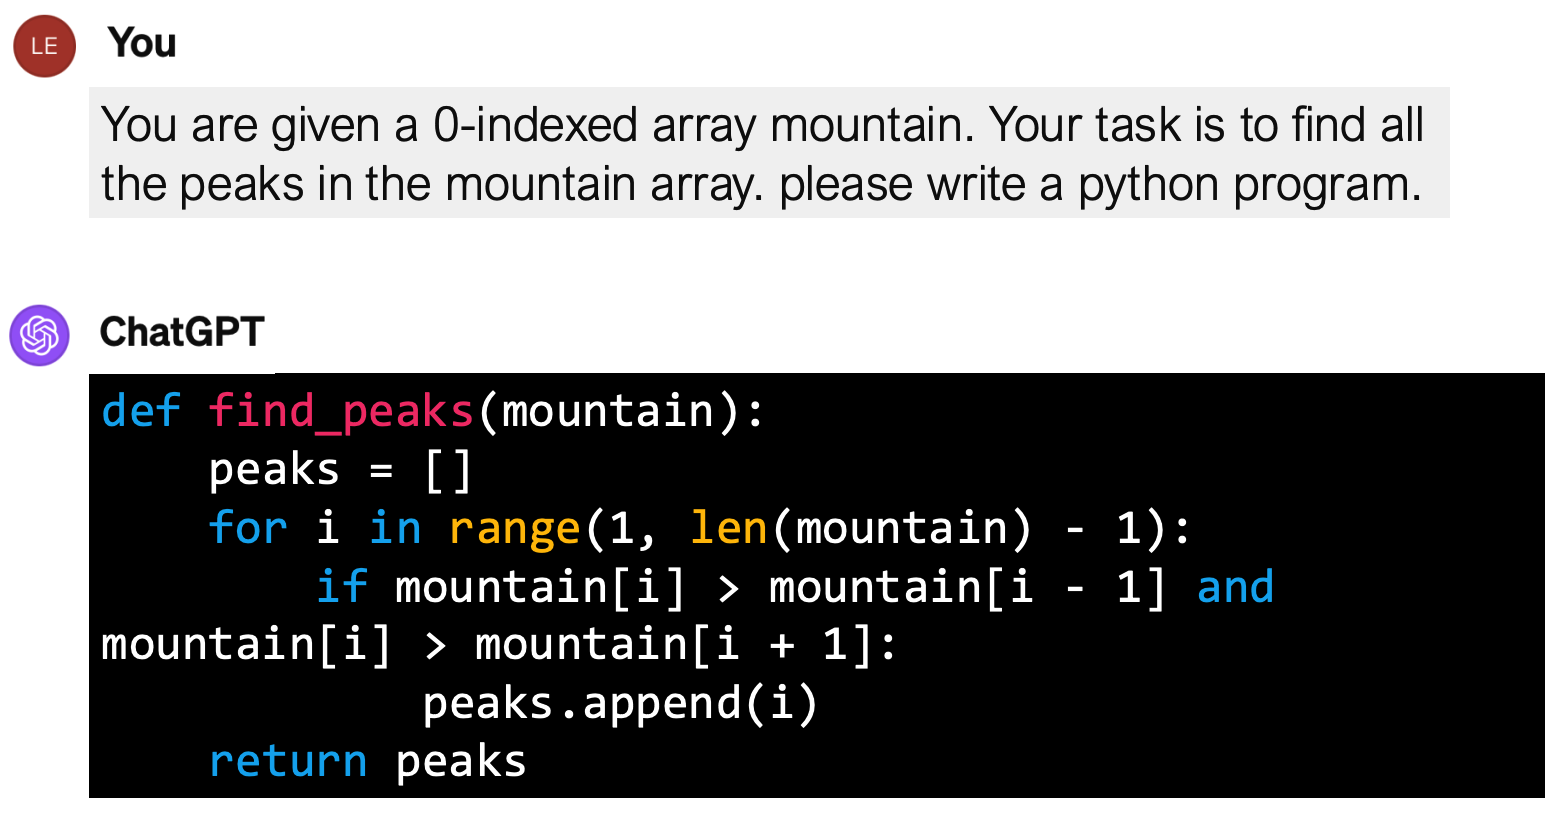
6️⃣ 写代码(Write code)
Q:给你一个0索引的山脉数组mountain。你的任务是找出这个山脉数组中的所有峰值。请编写一个Python程序。
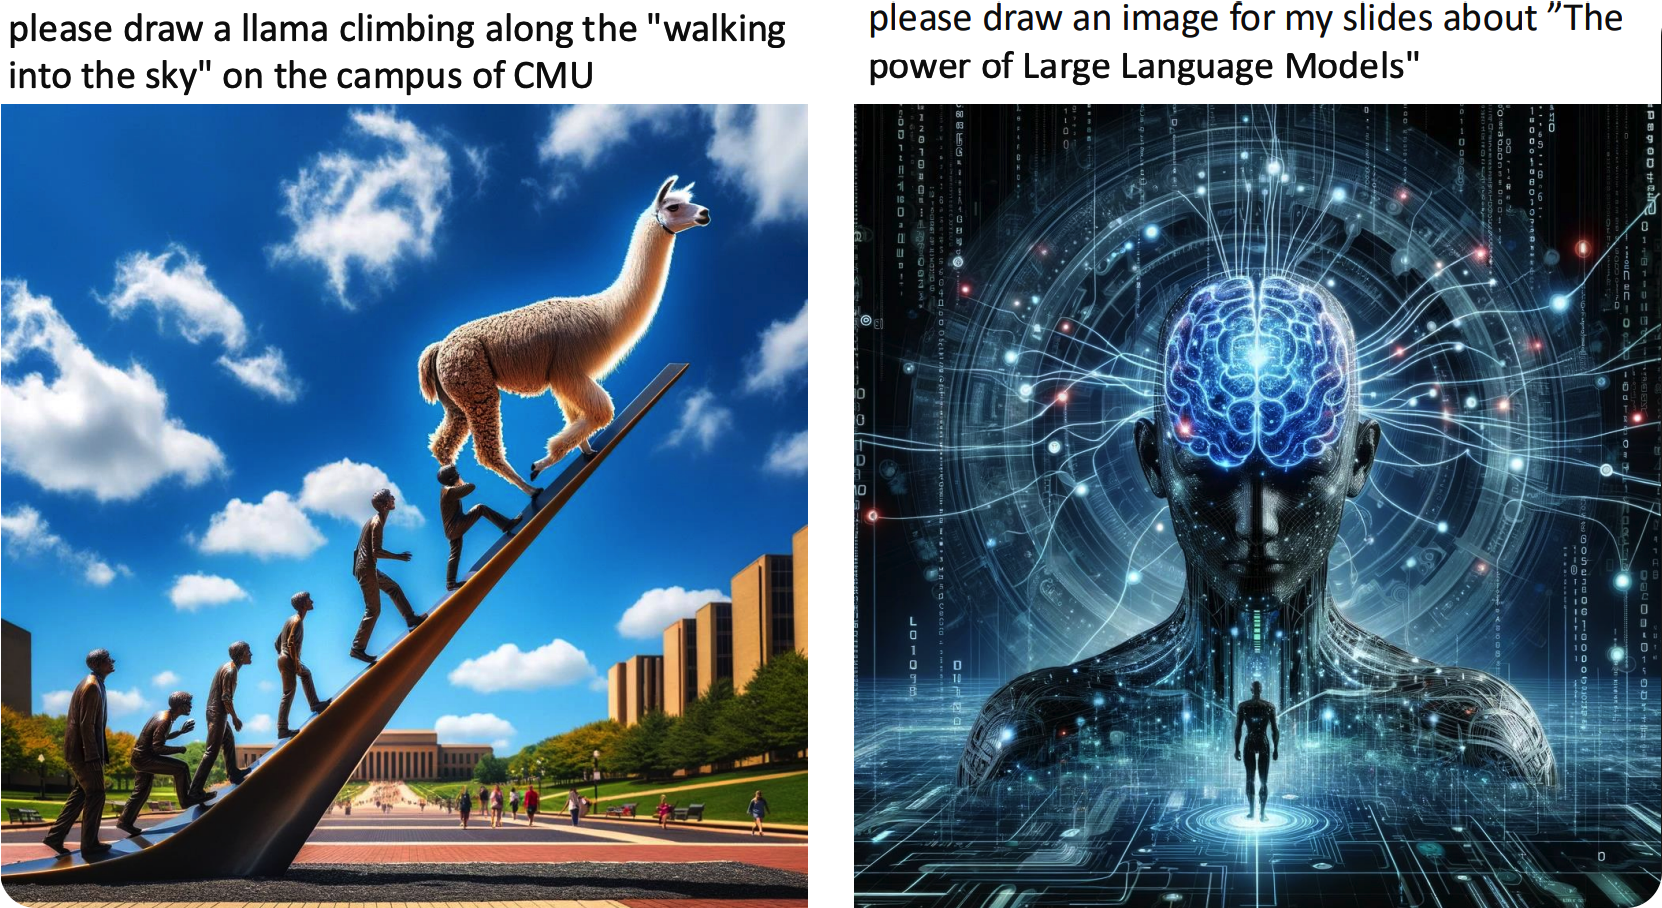
7️⃣ 图像生成(Image Generation)
二、数学基础(Mathematical Foundations)
2.1 概率模型(Probability Model)
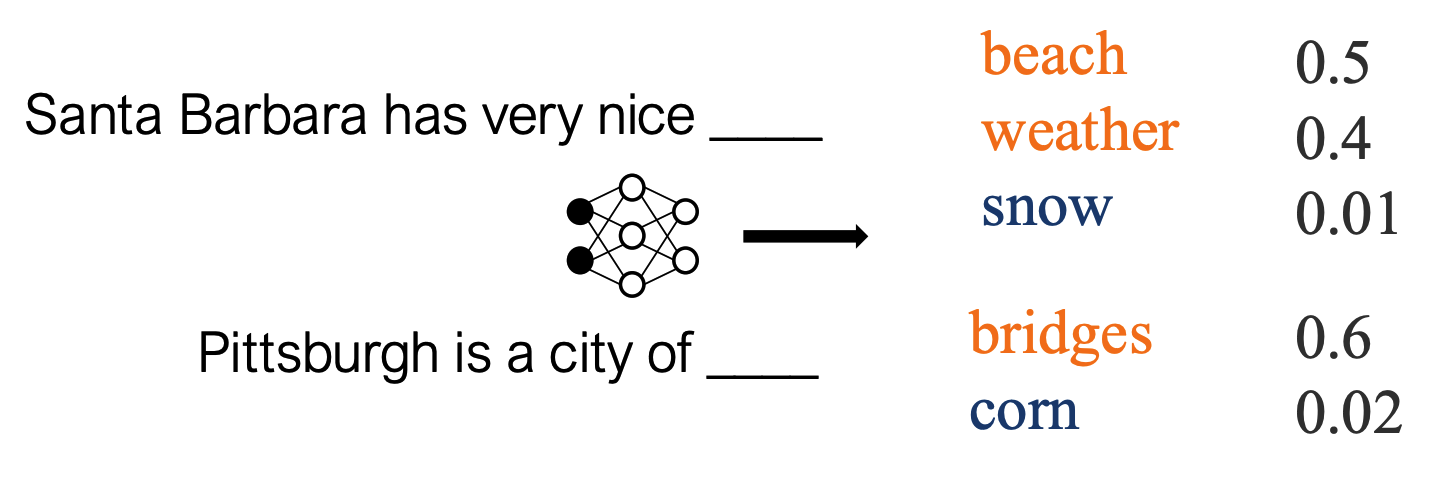
1️⃣ 下一个Token预测概率(Probability Model for Next Token)
语言模型本质上是计算下一个Token的条件概率:
P ( next word y t ∣ Prompt x , previous words y 1 : t − 1 ) P(\text{next word } y_t | \text{Prompt } x, \text{previous words } y_{1:t-1}) P(next word yt∣Prompt x,previous words y1:t−1)
2️⃣ 语言模型的数学原理(Mathematics of Language Model)
整个序列的概率是各步条件概率的乘积 。
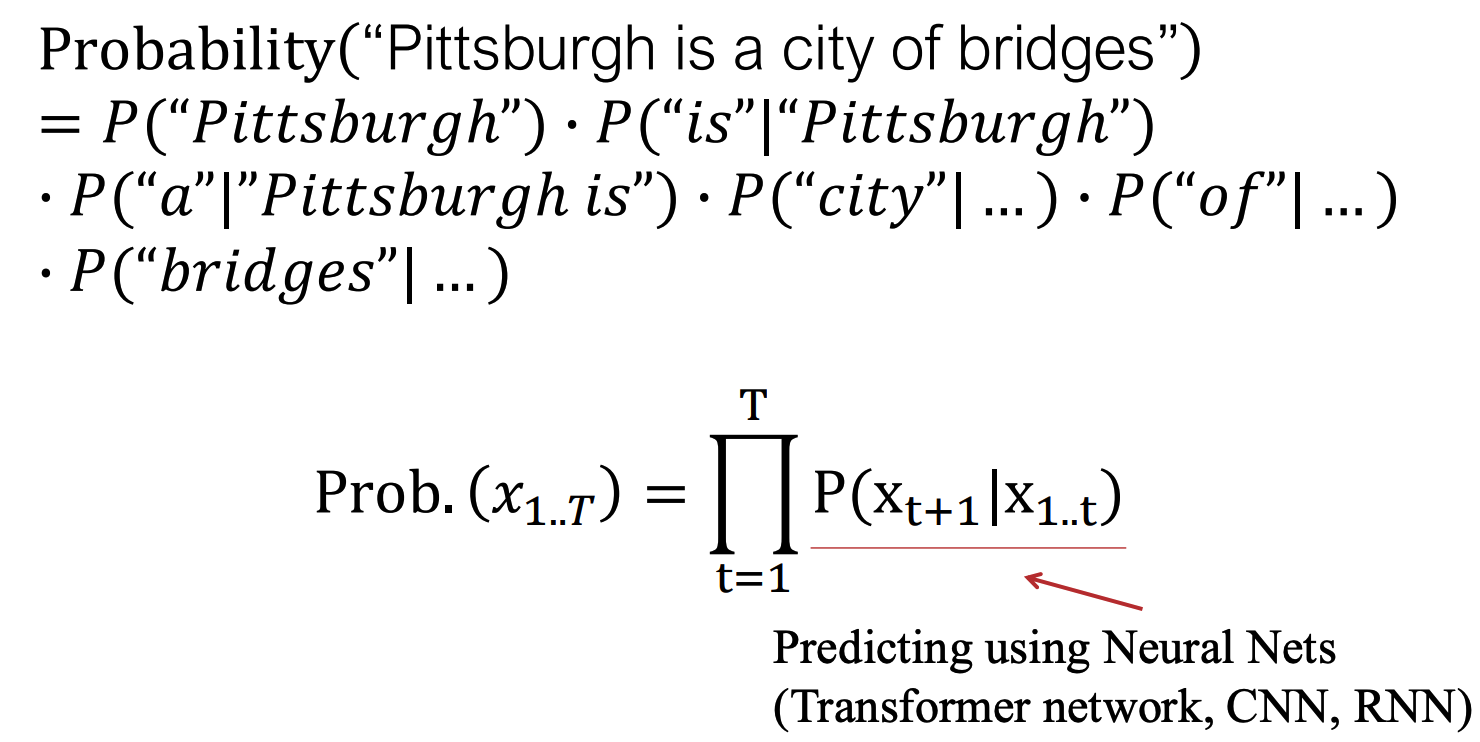
3️⃣ ChatGPT改变AI格局的原因(Why is ChatGPT changing AI landscape)
- 在超大规模原始数据(3000亿个标记)上进行预训练 + 少量人类反馈;
- 遵循指令——通过自然指令即可轻松使用;
- 上下文学习——通过在使用时展示几个示例,能很好地泛化到多种任务。
2.2 语言模型类型(Type of Language Models)
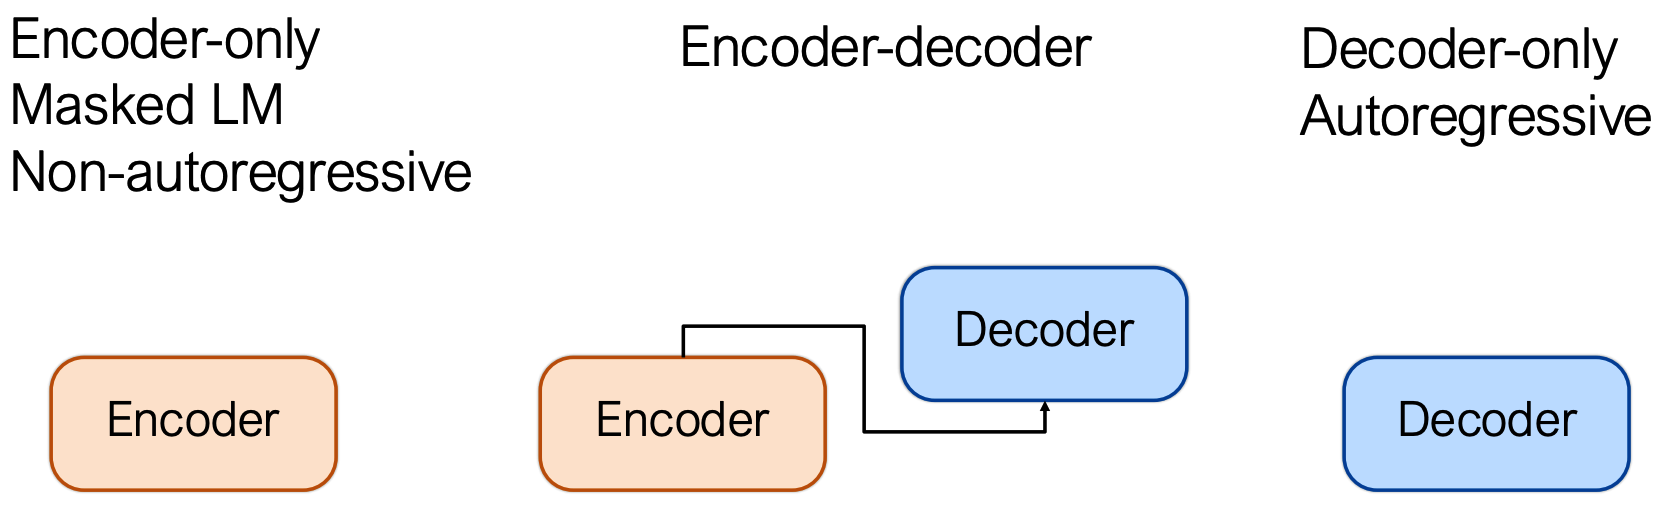
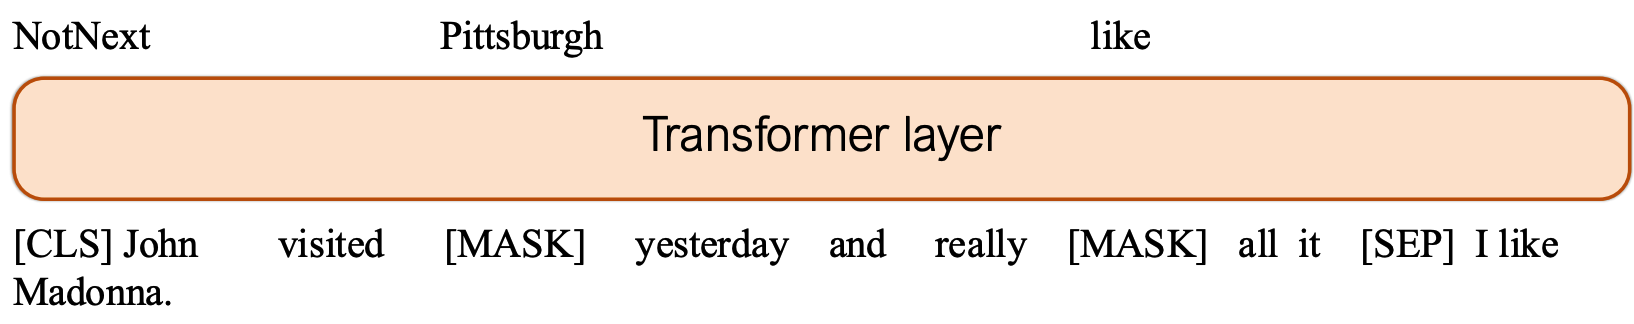
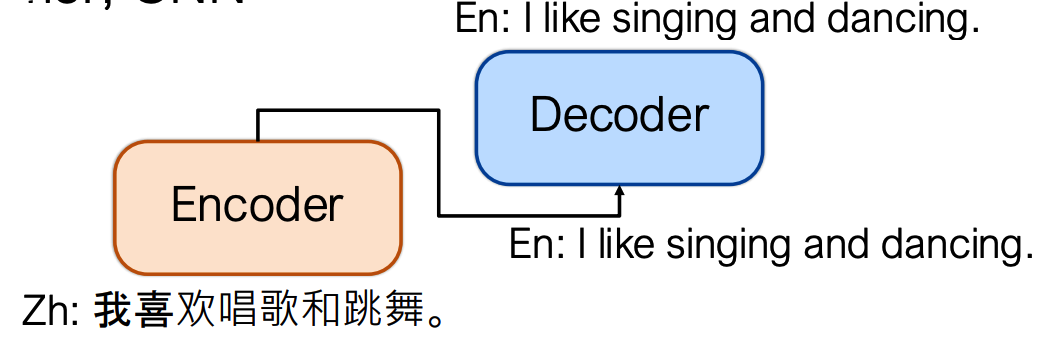
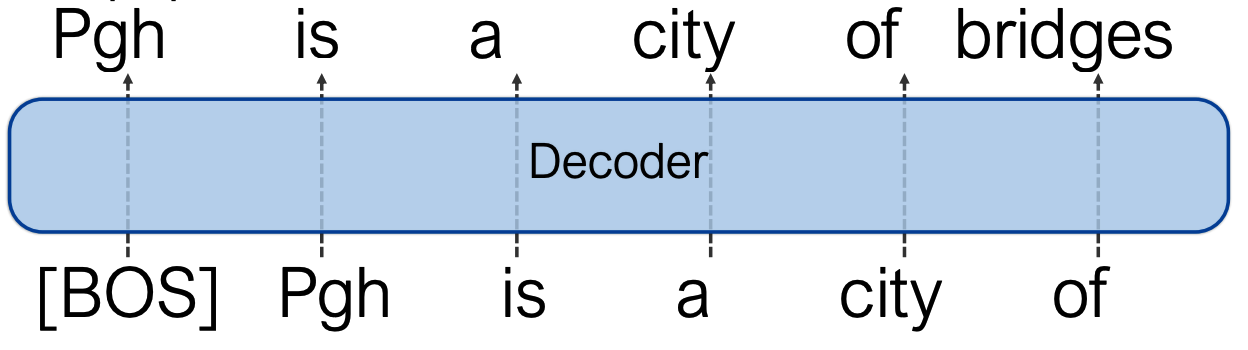
语言模型类型可以分为:仅编码器(Encoder-only)、编码-解码器(Encoder-Decoder)和仅解码器(Decoder-only)。其中仅编码器是非自回归的掩码语言模型(Non-autoregressive,Masked LM),仅解码器是自回归模型(Autoregressive)。
1️⃣ 仅编码器语言模型(Encoder-only Language Model)
- 掩码预测:BERT P ( x m a s k ∣ x ) P(x_{mask } | x) P(xmask∣x);
- 也可用于生成语言,例如:NAT、REDER(可逆双工模型)。
2️⃣ 编码器-解码器语言模型(Encoder-Decoder Language Model)
- 对概率 P ( Y ∣ X ) P(Y | X) P(Y∣X) 进行建模;
- 编码器可以选择双向长短期记忆网络(Bi-LSTM)、Transformer、卷积神经网络(CNN);
- 解码器可以选择长短期记忆网络(LSTM)、Transformer或非自回归Transformer,卷积神经网络。
3️⃣ 仅解码器语言模型(Decoder-only Language Model)
- 因果语言模型: P ( X ) = ∏ n = 1 N P ( x n ∣ x 1.. n − 1 ) P(X)=\prod_{n=1}^{N} P(x_{n} | x_{1 . . n-1}) P(X)=∏n=1NP(xn∣x1..n−1);
- 模型选择:Transformer或(单向)LSTM;
- 最受欢迎的大语言模型架构。
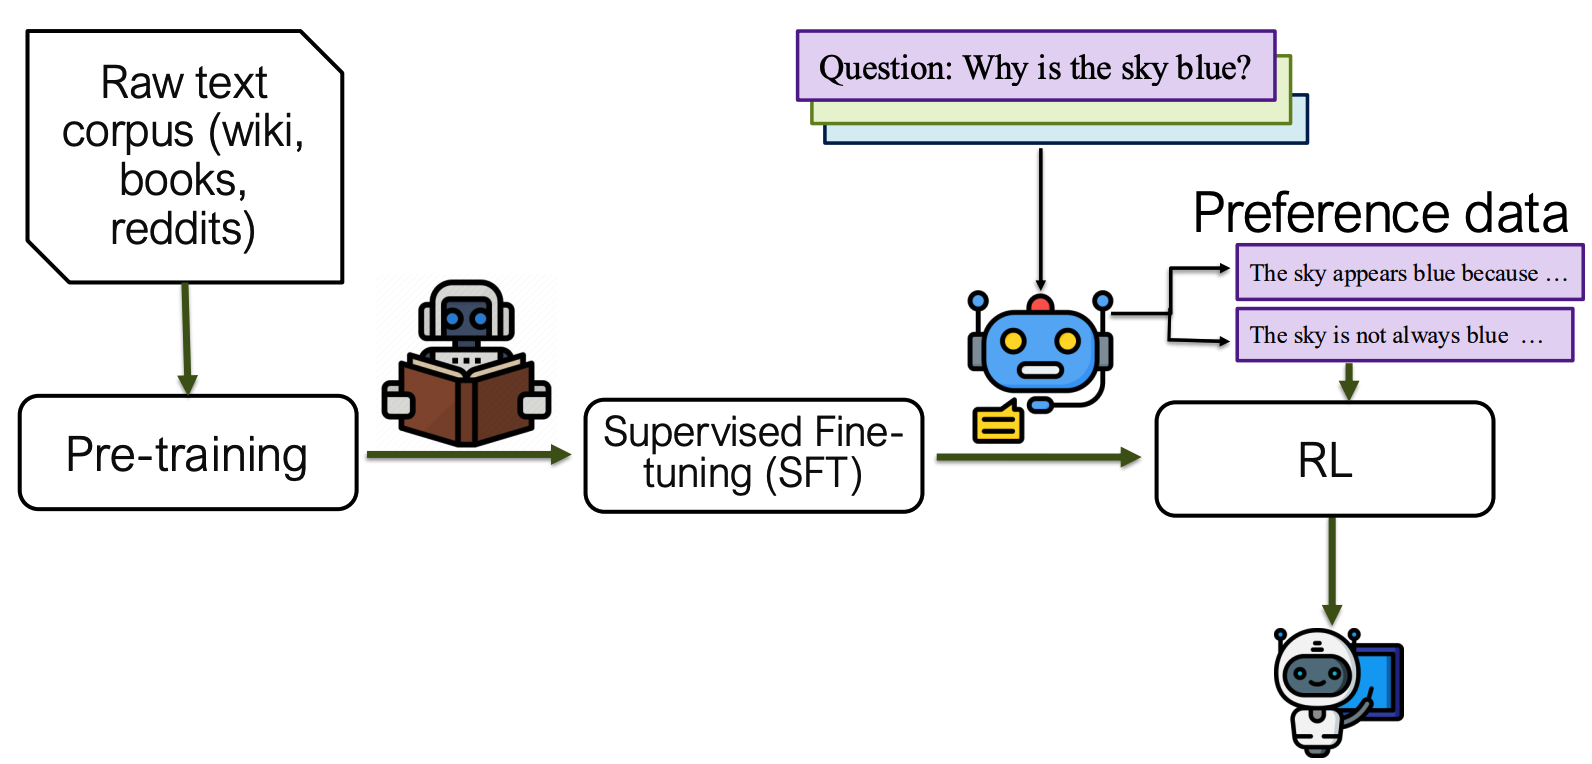
2.3 LLM学习框架(LLM Learning Framework)
- 预训练 (Pre-training):使用海量原始文本(Wiki, 书籍, Reddit等),追求数据量大且质量高 。
- 监督微调 (SFT):使用问答对等指令数据 。
- 强化学习 (RL):使用偏好数据(Preference data)进行对齐。
1️⃣ 语言模型的预训练(Pre-training of Language Models)
- 数据:原始文本语料库
- 数据量越大越好,通常从网络上爬取;
- 质量很重要:维基百科、书籍、经过筛选的Reddit帖子;
- 模型架构设计
- 稀疏注意力(Sparse Attention)、混合专家模型(MoE)等;
- 训练损失
- 用于下一个token预测的交叉熵损失。
2️⃣ 训练目标(Training Objective)
- 交叉熵损失: C E = − 1 N ∑ n = 1 N l o g P θ ( x n ∣ x < n ) CE=-\frac{1}{N} \sum_{n=1}^{N} log P_{\theta}(x_n | x_{<n}) CE=−N1∑n=1NlogPθ(xn∣x<n)
- 核心目标:最小化下一个 token 预测的损失值
3️⃣ 语言模型性能的衡量(Measuring Performance of Language Model)
- 基础指标
- 困惑度(Perplexity):用于开放式生成, P P L = e x p − 1 N ∑ n = 1 N l o g P L M ( x n ∣ x < n ) PPL=exp -\frac{1}{N} \sum_{n=1}^{N} log P_{LM}(x_n | x_{<n}) PPL=exp−N1∑n=1NlogPLM(xn∣x<n),值越低性能越好(例:GPT-3 零样本在 PTB 数据集上为 20.5)
- 参考型指标
- 经典指标:BLEU、ROUGE(基于 n-gram 匹配)
- 现代模型型指标:SEScore2、COMET、BLEURT、InstructScore(可解释性)
- 下游任务指标
- 命名实体识别:F1 分数
- 问答任务:准确率、匹配率
- 代码生成:pass-rate @k
- 检索任务:NDCG
- 翻译任务:COMET/SEScore2/BLEU
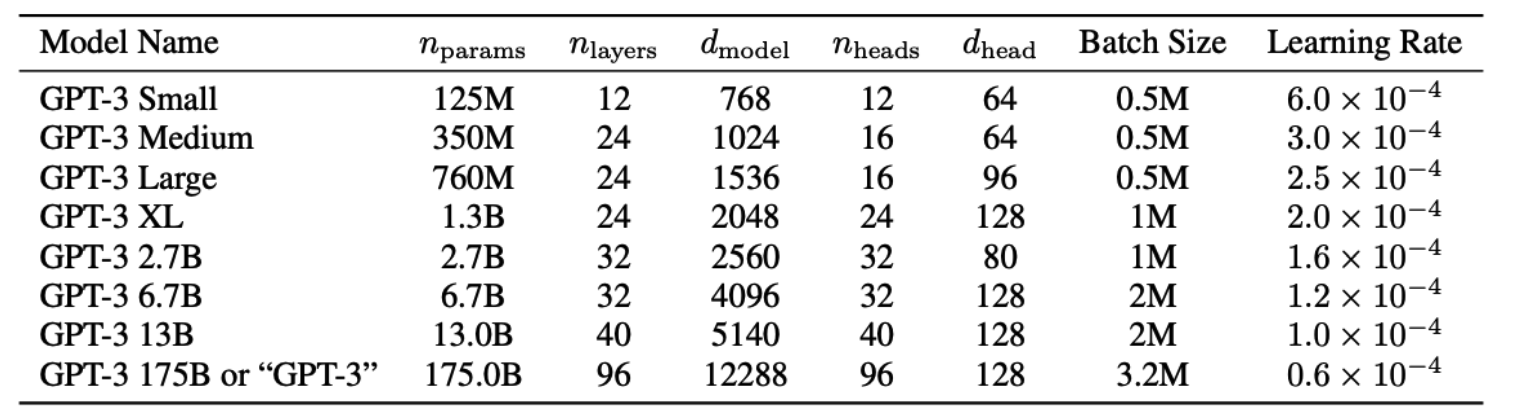
4️⃣ LLM性能表现(Performance of LLM)
模型规模(参数量)和数据量都很重要,二者共同决定性能 。
三、大语言模型系统中的挑战(Challenges in LLM Systems)
1️⃣ 现代大语言模型(Modern LLMs)
- 通用型(Generalist):将所有 AI 任务转化为基于 token 的序列生成任务
- 可指令性(Instructibility):交互式系统,支持自然语言或无限指令
- 智能体属性(Agentic):调用外部工具、执行动作、接收反馈
2️⃣ 大语言模型的系统设计(System Design for LLM)
- 关键系统问题:使用更少的资源(GPU/内存/电力)更快地在更大的数据集上计算(训练/推理)更大的大语言模型;
- 恰当的抽象:设计有用的构建块,向应用程序开发人员隐藏复杂性——不同级别的计算;
- 权衡:基本限制和主要成功指标是什么?
3️⃣ 语言模型中的计算(Computation in Language Models)
- 通用网络层:
- 多头注意力(Multi-head Attention)
- 层归一化(Layer Norm)
- Dropout
- 线性层
- 非线性激活(Tanh/RELU/GELU)
- Softmax
- 低级别算子:
- 矩阵 / 张量乘法
- 归约(求和、平均)
- 映射(逐元素应用)
- 内存移动
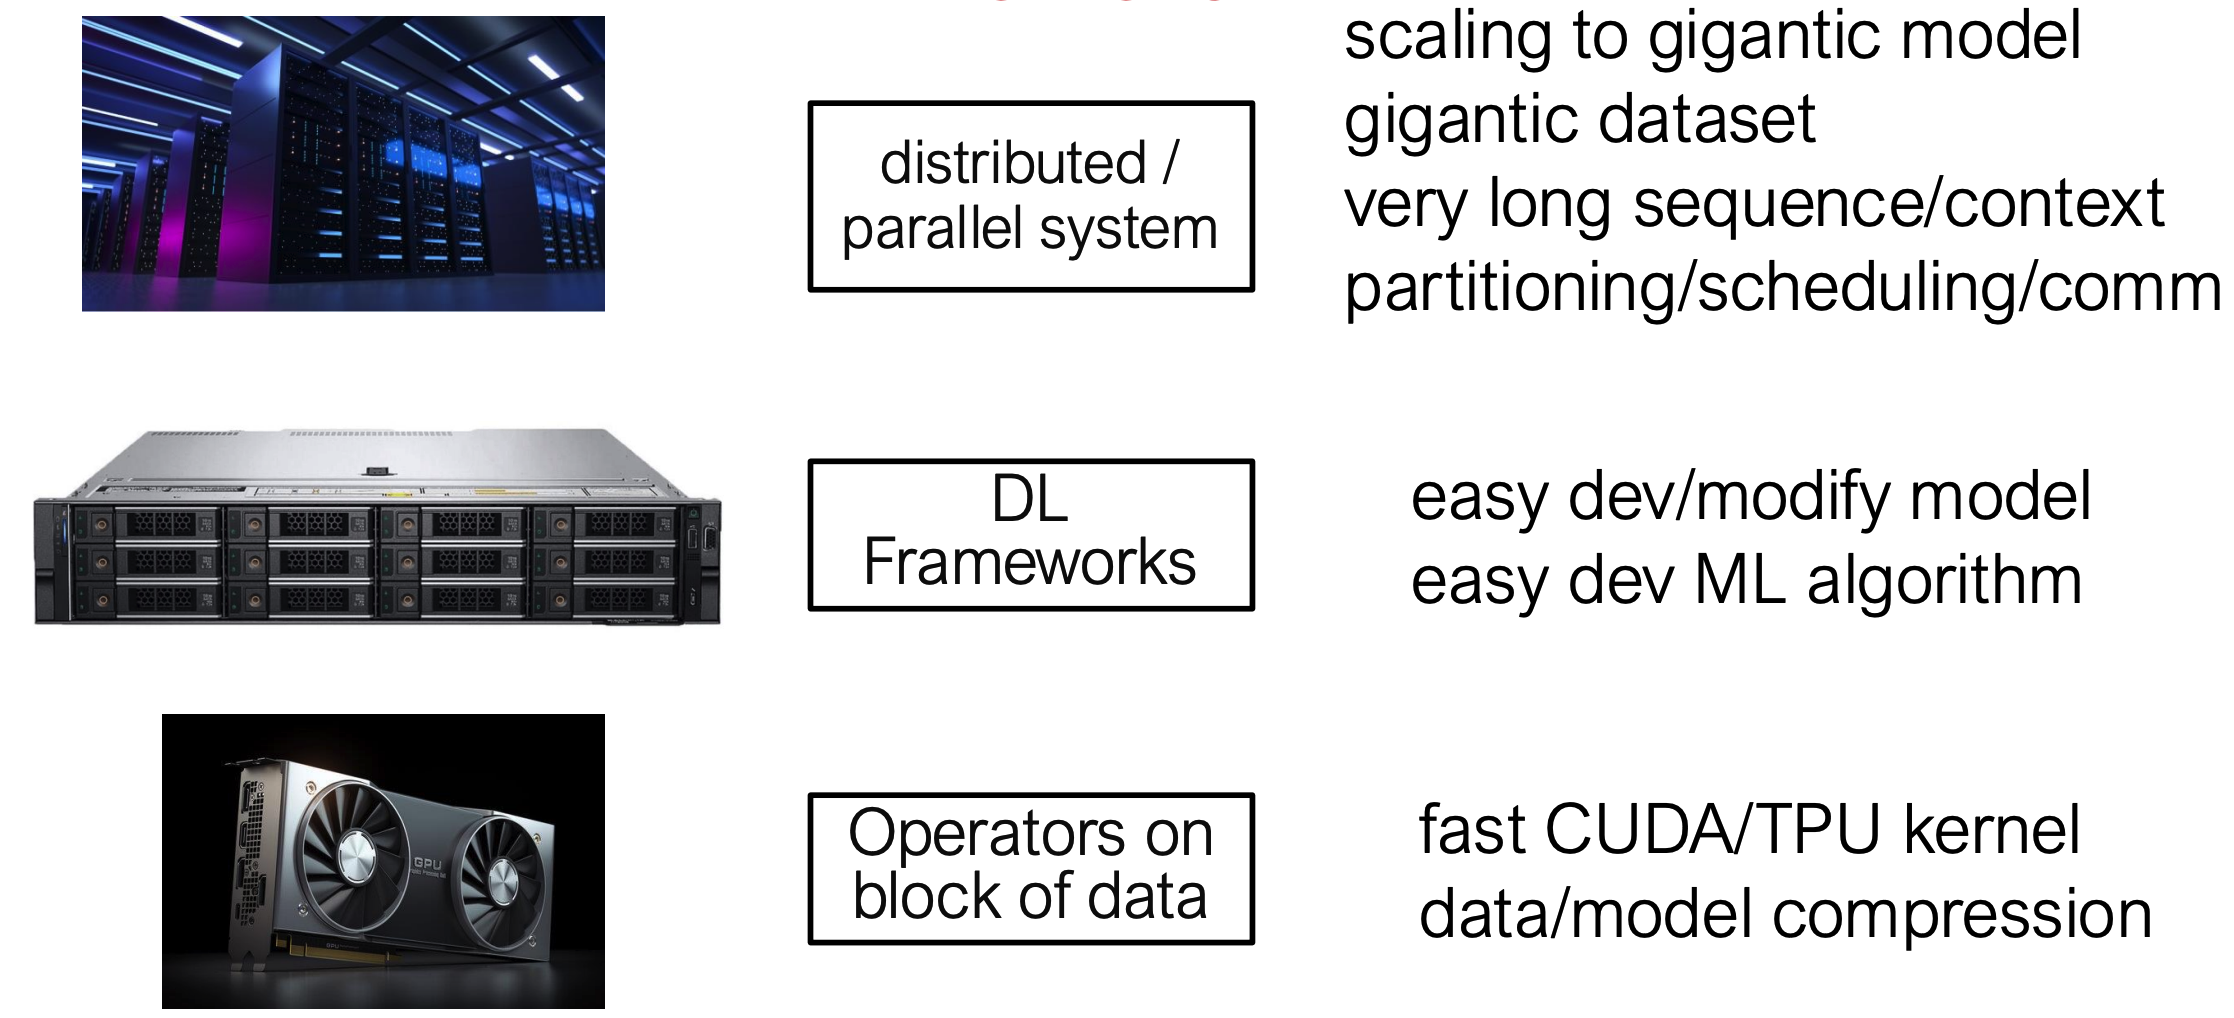
4️⃣ 不同抽象层次的系统挑战(System Challenges at Different Abstraction Levels)
| 抽象层次 | 核心挑战 | 优化方向 |
|---|---|---|
| 分布式 / 并行系统 | 超大规模模型、数据集、长序列的分区 / 调度 / 通信 | 并行策略优化、通信效率提升 |
| DL 框架 | 便捷开发 / 修改模型、快速实现 ML 算法 | 模块化设计、接口简化 |
| 数据块算子 | 计算速度、数据 / 模型压缩 | 快速 CUDA/TPU 内核、压缩算法 |
5️⃣ 大语言模型需要模型-算法-系统协同设计(LLM needs Model-Algorithm-System Co-design)
- 缩放就是你所需要的一切!—— 向上缩放和向下缩放
- 联合设计:模型架构、训练/推理算法、软件优化(分区、调度、数据移动、延迟隐藏)、硬件加速(设备特定指令)
6️⃣ 计算与数据传输(Computation versus Data Transfer)
- 仅让计算速度快是不够的;
- 数据传输需要时间;
- 大型模型有很多参数:跨设备/节点传输参数/梯度可能会花费更多时间;
- 批量数据样本与单个序列采样;
- 长上下文大语言模型需要大的工作内存;
7️⃣ 编程模型(Programming Models)
- 上层:将模型集成到产品系统,跟踪并提升产品质量;
- 中层:构建模型训练与推理软件,流式数据流处理;
- 下层:构建 GPU 内核、编译器等底层组件;
- 核心要求:抽象设计需解放程序员(如无需关注性能或故障),同时支持广泛应用场景。
四、课程安排(Logistics)
这部分主要是对课程的介绍和安排,不涉及具体知识点,因此省略。
更多推荐



 11
 0
- 0


 已为社区贡献2条内容

所有评论(0)