
【LLM】第二章:HuggingFace入门+大模型初体验
【LLM】第二章:HuggingFace入门学习
说明:学习大模型,会使用HuggingFace是必备的,因为HuggingFace是AI大模型的平台。HuggingFace之于大模型,就像pytorch之于神经网络一样。所以本章我们先入门一下HuggingFace的基本操作。
一、HuggingFace概述
HuggingFace是一个提供开源预训练模型和相关工具链的平台,目前已经是一个完整的AI开发生态系统,支持NLP、计算机视觉、语音处理、多模态任务等多个领域。我们使用HF可以简化预训练模型的使用,加速项目的开发和落地。HF生态系统主要由两个核心部分组成:
1、HuggingFace Hub,是一个提供托管和分享模型、数据集、各种AI应用的开源平台。
(1)HuggingFace官网地址:https://huggingface.co/ 官网我们国内一般访问不了。
(2)国内镜像地址:HF-Mirror 我们一般用这个镜像地址。
(3)国内类似的网站还有比如:ModelScope
2、HuggingFace上的重点库(Libraries)
HF提供了一套围绕预训练模型构建的工具库,覆盖从数据处理到模型训练与推理的完整流程。我们只需要重点学习下面3个库即可:
(1)Transformers库:用于加载、使用各种微调方法训练模型、保存预训练模型。支持数百种预训练模型,用于只需要from_pretrained()直接加载公开模型,就可以进行训练和推理。
(2)Tokenizers库:用于将文本转化为模型输入的工具。比如文本分词、编码(token ID)、处理特殊符号、填充(padding)、attention mask、句子对标记(token type ID)等,我们一般称为分词器。
由于每个模型,它的特殊符号、输入格式都不一样,所以每个模型都有其对应的Tokenizer,我们一般加载model的时候,也加载其tokenizer。
(3)Datasets库:用于加载和处理数据集的工具库。支持在线仓库、本地文件加载数据、数据清洗、编码、切分等预处理操作。处理后的数据可直接用于模型训练。
3、安装工具
首先先安装这3个包:pip install transformers datasets tokenizers
本篇重点演示如何使用这些工具。
二、预训练模型的加载
1、下载预训练模型
如果你是window系统,你需要在你的环境变量中添加HF_ENDPOINT="https://hf-mirror.com" ,如下图所示: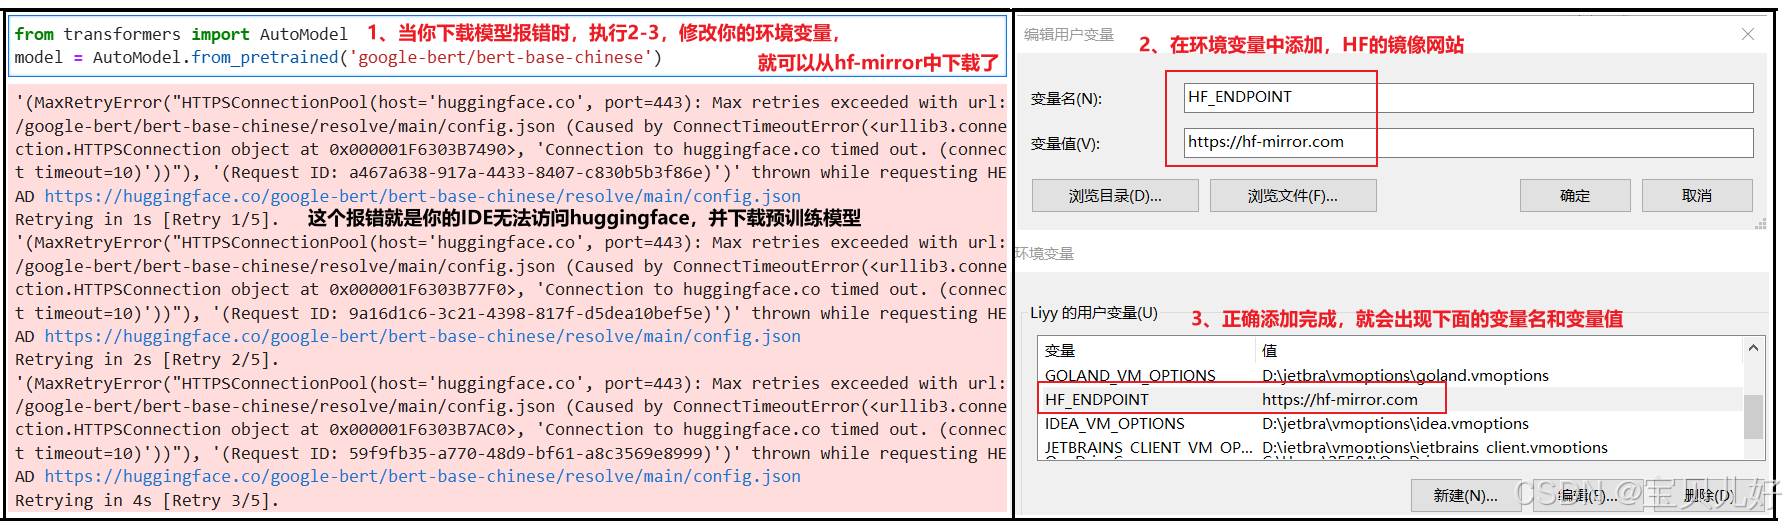 这样AutoModel会根据模型名称,从hf-mirror上下载所需的模型权重和模型的配置文件,这些文件默认下载到~/.cache/huggingface/hub/下面。下次你再加载的时候,就会直接先从缓存中读取,不再联网下载了。
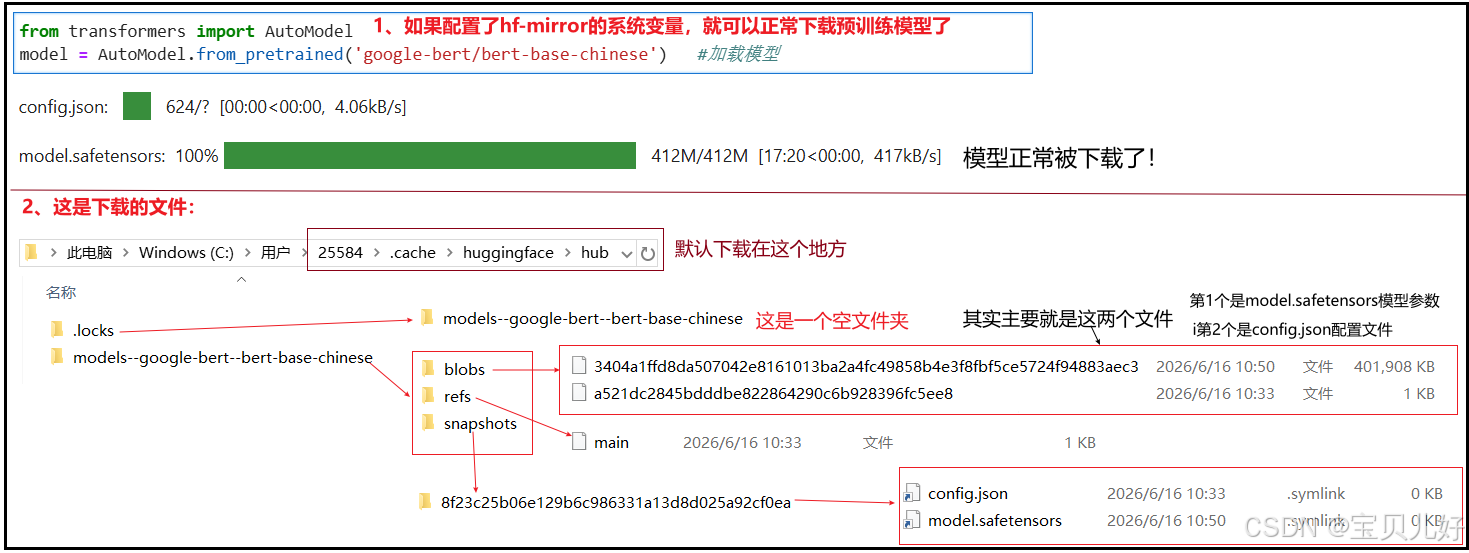
这是我们下载完毕的bert-base预训练模型: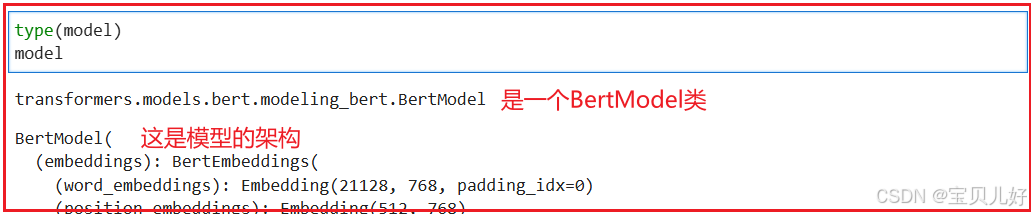
2、加载本地已有的预训练模型
假如我们本地就已经有bert-base和其对应的配置文件了,我们只需要加载一下即可: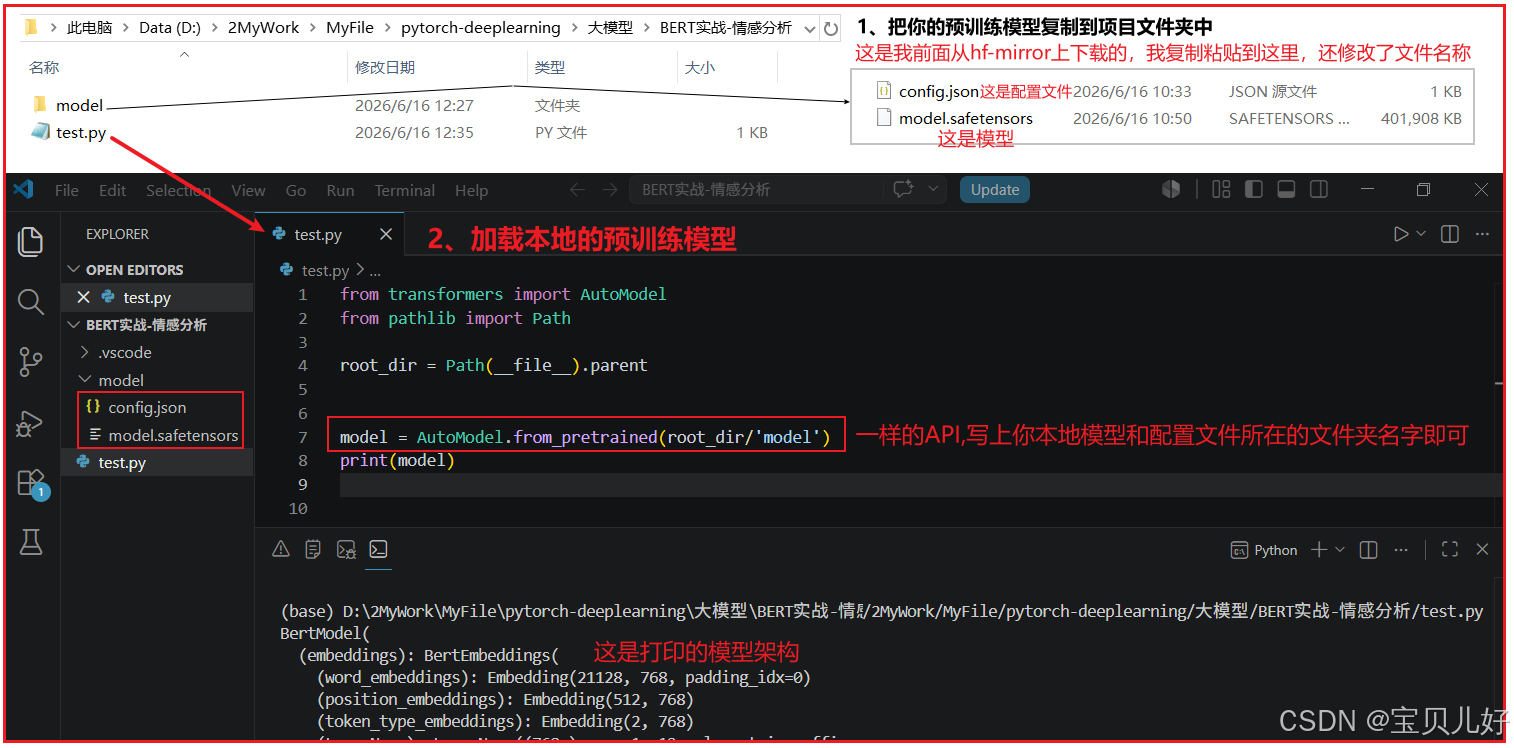
3、添加带任务头(Task Head)的大模型
(1)上面的AutoModel只是加载预训练的主干结构,我们想把模型迁移到具体的下游任务上,我们还得添加适配具体任务的输出层,也就是我们通常说的任务头(Task Head) 。 Transforms也提供了添加具体任务头的类: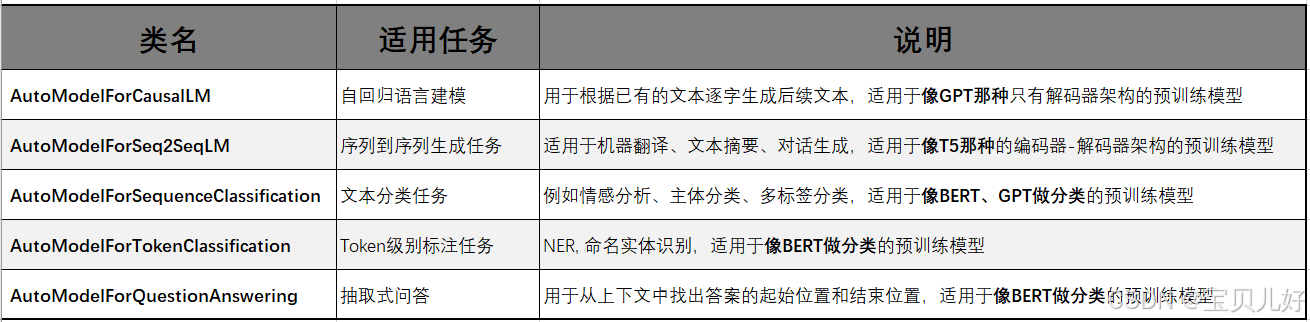 这样模型就可以直接用于分类、命名实体识别、问答等任务的训练和推理了。
(2)示例:用AutoModelForSequenceClassification直接加载带任务头的bert-base预训练模型: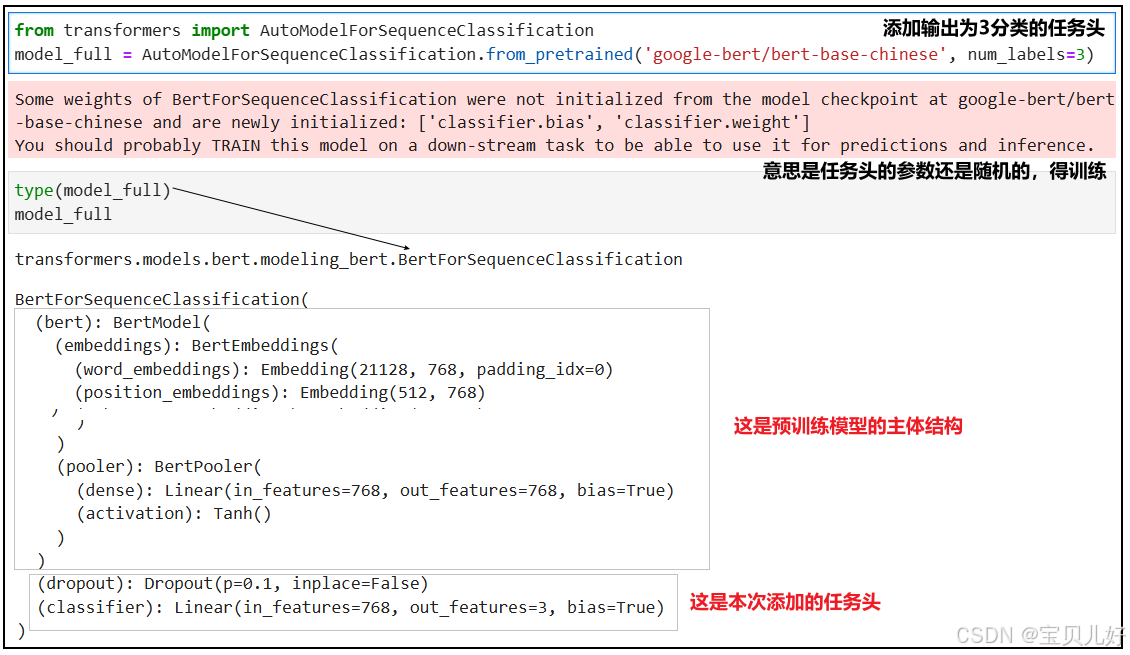
三、简单体验一下HF上的大模型
就是我们先在线访问几个大模型,体验一下效果。然后再下载几个大模型到本地,体验一下本地运行的效果。最后我们再用HF微调框架,本地微调一个模型。
(一)使用Inference API在线访问大模型,并进行推理
Hugging Face Inference API,无服务器推理API,就是HF的云端模型调用接口,用户只需要发一条http请求给HF云端服务器,云端运行模型推理服务,并把结果返回用户。所以运行下面的代码,首先你要保证你可以通畅地访问HF。
1、匿名在线访问hf上的中文GPT2模型(uer/gpt2-chinese-cluecorpussmall),让模型续写
import requests
API_URL = "https://api-inference.huggingface.co/models/uer/gpt2-chinese-cluecorpussmall"
re = requests.post(API_URL, json={'inputs':'你好,hugging face!'})
re
re.json()
2、非匿名在线访问hf上的英文gpt2模型(models--gpt2),让其续写
得使用API_TOKEN,API_TOKEN是你注册HF网站的时候免费获得的,也是你身份的标志。
import requests
API_URL = "https://api-inference.huggingface.co/models/gpt2"   #英文模型
API_TOKEN = "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"  #这里是你注册hf时,hf会给你生成一个身份串
headers = {"Authorization":f"Bearer {API_TOKEN}"}  #header就是你的用户名和API_TOKEN

response = requests.post(API_URL, headers=headers, json={'inputs':'你好,hugging face!'})
response
response.json()
3、pipeline也可以远程调用HF的Inference API
HF的pipeline工具就是用来进行端到端推理的,所以pipeline不仅可以本地推理也可以远程推理。但它只适用hf平台的模型,其他平台的模型就不一定了。
from transformers import pipeline
API_TOKEN = "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"    #这是你注册时的api token
generator = pipeline('text-generation', model='gpt2', use_auth_token=API_TOKEN)   #英文GPT2模型
output = generator('你好,hugging face!', max_length=50)
output
说明:上面访问的gpt2都是一个续写模型,就是我们先写个开头:你好,hugging face!,模型顺着这句话继续续写。当然模型续写的内容也不一定是我想要的内容!所以一般我们都不会在线访问大模型,不实用。
如果我们想让gpt2写一些我们想要的内容,比如对联、古诗词、或者小说等内容。此时在线访问的方式是得不到我们想要的结果的。此时我们就需要把gpt2下载到本地,然后用本地的对联、古诗词、或者小说等语料微调模型,训练完毕后,调用本地的这个模型进行推理,才能生成我们想要的内容。
(二)把模型下载到本地,本地调用并进行推理
1、将模型(gpt2-chinese-cluecorpussmall)下载到本地,直接用pipeline进行文本生成
from transformers import pipeline

model_path = 'D:\BigModels\gpt2\models--uer--gpt2-chinese-cluecorpussmall\snapshots\c2c0249d8a2731f269414cc3b22dff021f8e07a3'
#已经下载到本地的大模型,而且路径已经不在~/.cache中的大模型,
#此时加载模型的路径一定要在snapshots下能看到config.json文件的目录下加载,才能顺利加载并推理
generator = pipeline(task='text-generation', model=model_path)
generator

prompt = '你好,hugging face!'
output = generator(prompt, max_new_tokens=100)
output
2、将模型(gpt2-chinese-cluecorpussmall)下载到本地,用AutoModelForCausalLM、AutoTokenizer进行个性化设置推理
说明:我想让模型做续写任务的,如果你用AutoModel,加载的模型就会有一层任务头层报参数没有初始化,此时就没法推理了。所以这里我们调用AutoModelForCausalLM接口。
from transformers import AutoModelForCausalLM, AutoTokenizer,pipeline
model_path = 'D:\BigModels\gpt2\models--uer--gpt2-chinese-cluecorpussmall\snapshots\c2c0249d8a2731f269414cc3b22dff021f8e07a3'
model = AutoModelForCausalLM.from_pretrained(model_path)   ##只要传入地址就加载成功了
tokenizer = AutoTokenizer.from_pretrained(model_path)

#用Pipeline实例化一个生成器
generator = pipeline('text-generation', model=model, tokenizer=tokenizer)

#用更多的参数调整模型的输出效果
prompt = '你好,hugging face!'
output = generator(prompt,
                   max_new_tokens=100,
                   num_return_sequences=3,
                   truncation=True,
                   temperature=0.7,
                   top_k=50,
                   top_p=0.9,
                   clean_up_tokenization_spaces=False)
output
参数说明:
(1)“你好,hugging face!”:这是生成文本的输入种子文本,也叫prompt,也叫硬提示词 ,模型会根据这个种子文本生成后续的文本。GPT2默认就是一个续写模型。
(2)max_length:指定生成文本的最大长度。这里的100表示生成的文本最多包含100个标记(tokens)。
(3)num_return_sequences: 指定返回多少个独立生成的文本序列。这里的3表示生成并返回3段文本。
(4)truncation: 是否截断输入文本以适应模型的最大输入长度。如果=true,超出模型最大输入长度的部分就被截断;如果=false,可能会出现模型无法处理过程输入而出现报错情况。
(5)temperature: 控制生成文本的随机性。值越低,倾向选择概率较高的词,生成的文本越保守;值越高,倾向选择更多不同的词,生成的文本更多样。我们一般设置为0.7,既不保守也不激进。
(6)top_k: 表示模型在每一步生成时,仅从概率最高的K个词中选择下一个词。=50表示模型在生成每个词时只考虑概率最高的前50个候选词,从而减少生成不太可能的词的概率。
(7)top_p: 该参数又称核采样,用于进一步限制模型生成时的词汇选择范围。它会选择一组累计概率达到p的词汇,模型只会从这个概率集合中采样。=0.9表示模型只会在累计可能性的90%的词汇中选择。
(8)clean_up_tokenization_spaces:表示生成的文本中是否清理分词时引入的空格。=true表示清除空格;=false表示保留原样。默认值是false。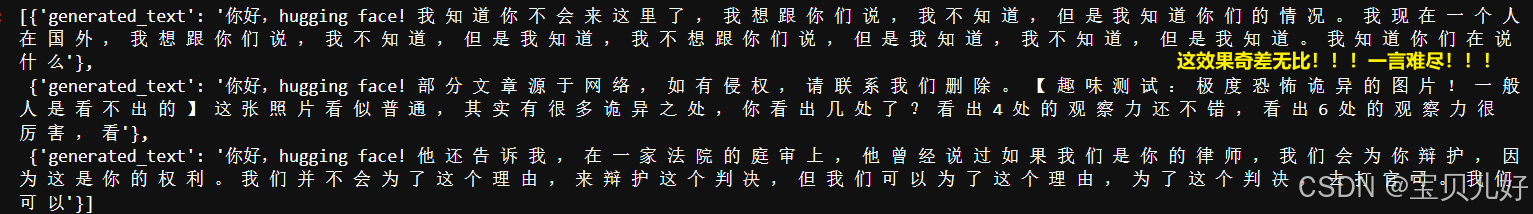
3、用roberta-wwm-ext模型,做分类任务,不训练,直接推理
hfl/chinese-roberta-wwm-ext是哈工大发布一个大模型,是RoBERTa的一个变种,去掉NSP(下一句预测),而且特别针对中文进行了优化。所以是一款中文效果很强的预训练模型,适合做中文NLP任务的基座模型。
“wwm”代表“word-level whole word masking”,就是在预训练过程中采用了整词掩码(Whole Word Masking, WWM)策略,不是单独掩码一个汉字,而是掩住一个词语,这更贴合中文语义。
“ext”是extended的意思,扩展数据集,语料不仅有维基百科,还加入了大量新闻、网页等中文文本,训练数据量更大。
from transformers import AutoModel, AutoTokenizer, AutoModelForSequenceClassification
from sklearn.metrics import accuracy_score, f1_score

#在线下载模型和相应的tokenizer,下载的文件都在本地的~/cache目录下
model = AutoModelForSequenceClassification.from_pretrained('hfl/chinese-roberta-wwm-ext',num_labels=3) #第一个参数是模型名,第二个是3分类
tokenizer = AutoTokenizer.from_pretrained('hfl/chinese-roberta-wwm-ext')

#准备数据
df = pd.DataFrame([{'text':'这个产品真的很好用', 'label':0},
                   {'text':'还可以吧,没有特别惊喜', 'label':1},
                   {'text':'非常失望,再也不会买了', 'label':2},
                   {'text':'非常喜欢这个设计', 'label':0},
                   {'text':'一般般,没太多感觉', 'label':1},
                   {'text':'服务太差了', 'label':2}])

inputs = tokenizer(df['text'].tolist(), padding=True, truncation=True, max_length=128, return_tensors='pt')
labels = torch.tensor(df['label'].tolist())

#不训练,直接推理
#model.eval()
with torch.no_grad():
    outputs = model(**inputs)
    print(outputs)
    predictions = torch.argmax(outputs.logits, dim=1)
    print(predictions)
acc = accuracy_score(labels, predictions)
f1 = f1_score(labels, predictions, average='macro')
acc, f1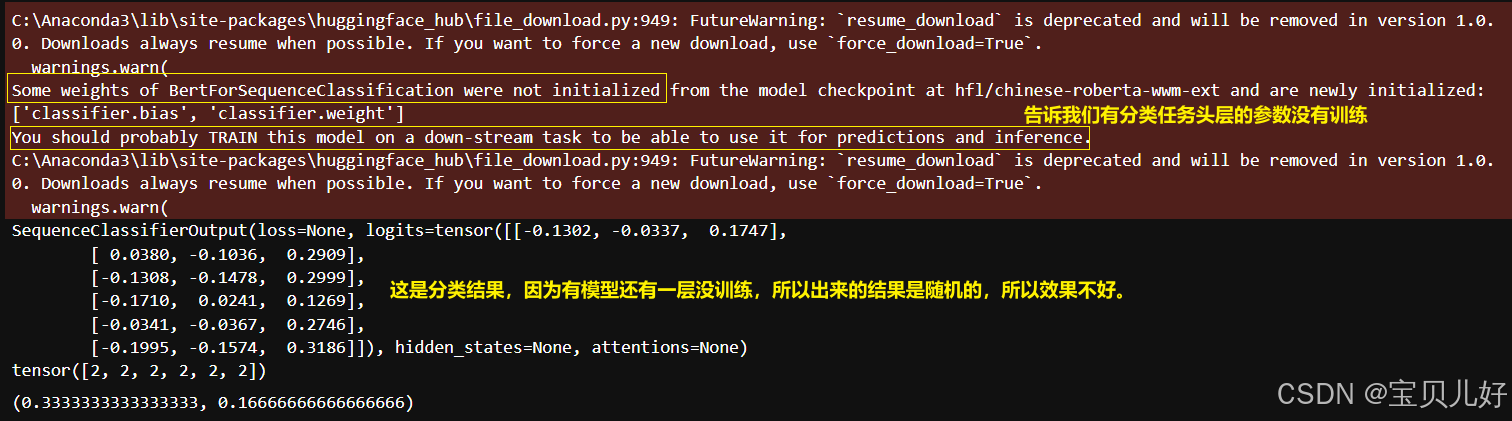
(三)把模型下载到本地,用FH框架本地微调roberta-wwm-ext大模型
下面代码是在HF框架下微调hfl/chinese-roberta-wwm-ext大模型,做二分类任务。
from transformers import AutoModel, AutoTokenizer, AutoModelForSequenceClassification
from sklearn.metrics import accuracy_score, f1_score
from datasets import load_dataset
from transformers import TrainingArguments, Trainer

#下载模型和相应的tokenizer
model = AutoModelForSequenceClassification.from_pretrained('hfl/chinese-roberta-wwm-ext',num_labels=2) #下载到~/cacha中了
tokenizer = AutoTokenizer.from_pretrained('hfl/chinese-roberta-wwm-ext')

#准备数据
dataset = load_dataset('csv', data_files=str('D:\pytorch-data\online_shopping_10_cats.csv'))   #是一个二分类数据集
dataset1 = dataset['train'].remove_columns('cat')   #删除不需要的列
dataset2 = dataset1.filter(lambda x:x['review'] is not None)   #删除一行空行

def preprocess(sample):
    return tokenizer(sample['review'], truncation=True,
                     padding='max_length', max_length=128)

encoded_dataset = dataset2.map(preprocess)
encoded_dataset

#定义训练参数
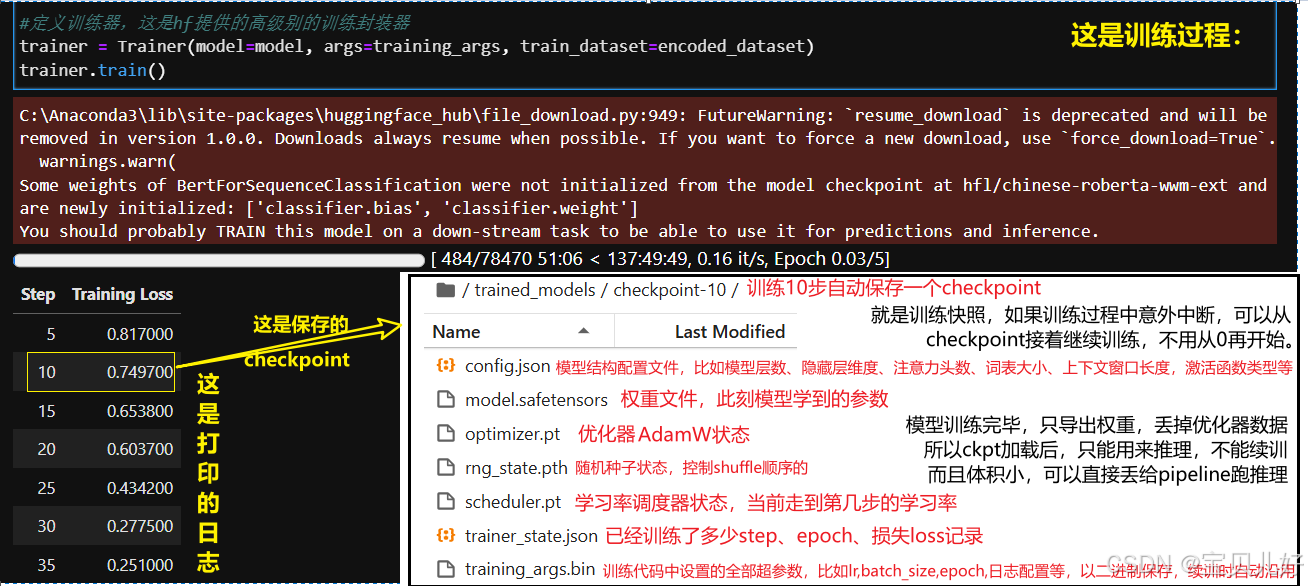
training_args = TrainingArguments(output_dir='./trained_models', #模型保存的目录
                                  per_device_train_batch_size=4, #batch大小
                                  num_train_epochs=5, #训练几个epoch
                                  logging_steps=5, #每隔5步打印一次日志,   就是训练5个batch就打印一次
                                  save_steps=10)   #每隔10步保存一次模型检查点checkpoint,  1个batch权重更新1次,就是1步step

#定义训练器,这是hf提供的高级别的训练封装器
trainer = Trainer(model=model, args=training_args, train_dataset=encoded_dataset)
trainer.train()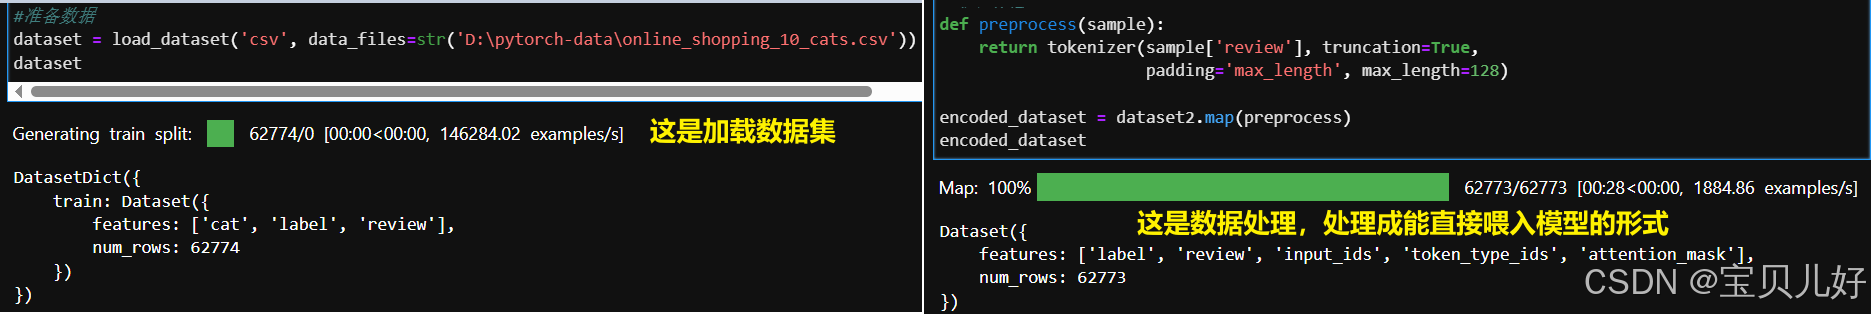
(四)用roberta-base-chinese-extractive-qa,本地搭建问答模型,用pipeline测试效果
roberta-base-chinese-extractive-qa是在roberta-wwm-ext底座之上,用阅读理解数据集微调得到的成品问答模型。
extractive,抽取式阅读理解问答。抽取式QA和生成式问答模型不一样!抽取式问答的答案必须在原文中,模型不自己造新答案。是token级别的分类任务。抽取式轻量、速度快、显存需求小。GPT\Qwen\Llama等都是生成式大模型。
# 将模型roberta-base-chinese-extractive-qa下载到本地,搭建问答系统,也就是阅读理解,直接用pipeline推理
from transformers import AutoModel, AutoModelForQuestionAnswering, AutoTokenizer,pipeline

#model_path = 'https:/api-inference.huggingface.co/models/uer/roberta-base-chinese-extractive-qa' #这个地址可以在线下载模型
model_path = r'D:\BigModels\roberta\models--uer--roberta-base-chinese-extractive-qa\snapshots\9b02143727b9c4655d18b43a69fc39d5eb3ddd53'

model = AutoModelForQuestionAnswering.from_pretrained(model_path)  #本地模型加载
tokenizer = AutoTokenizer.from_pretrained(model_path)

#用Pipeline实例化一个qa_pipeline
qa_pipeline = pipeline('question-answering', model=model, tokenizer=tokenizer)

#定义问题与上下文
QA_input = {'question':'hugging face是什么?',
            'context':'hugging face是一个自然语言处理平台,是一款AI开发工具。'}
answer = qa_pipeline(QA_input)
answer
四、Tokenizer的加载和使用
1、在线加载Tokenizer
在Transformers库中,AutoTokenizer类是用于加载与指定模型配套的分词器,该类可以根据模型名称自动选择并实例化正确的分词器类型,比如BertTokenizer、GPT2Tokenizer、T5Tokenizer等。下面示例如何加载bert-base配套的分词器: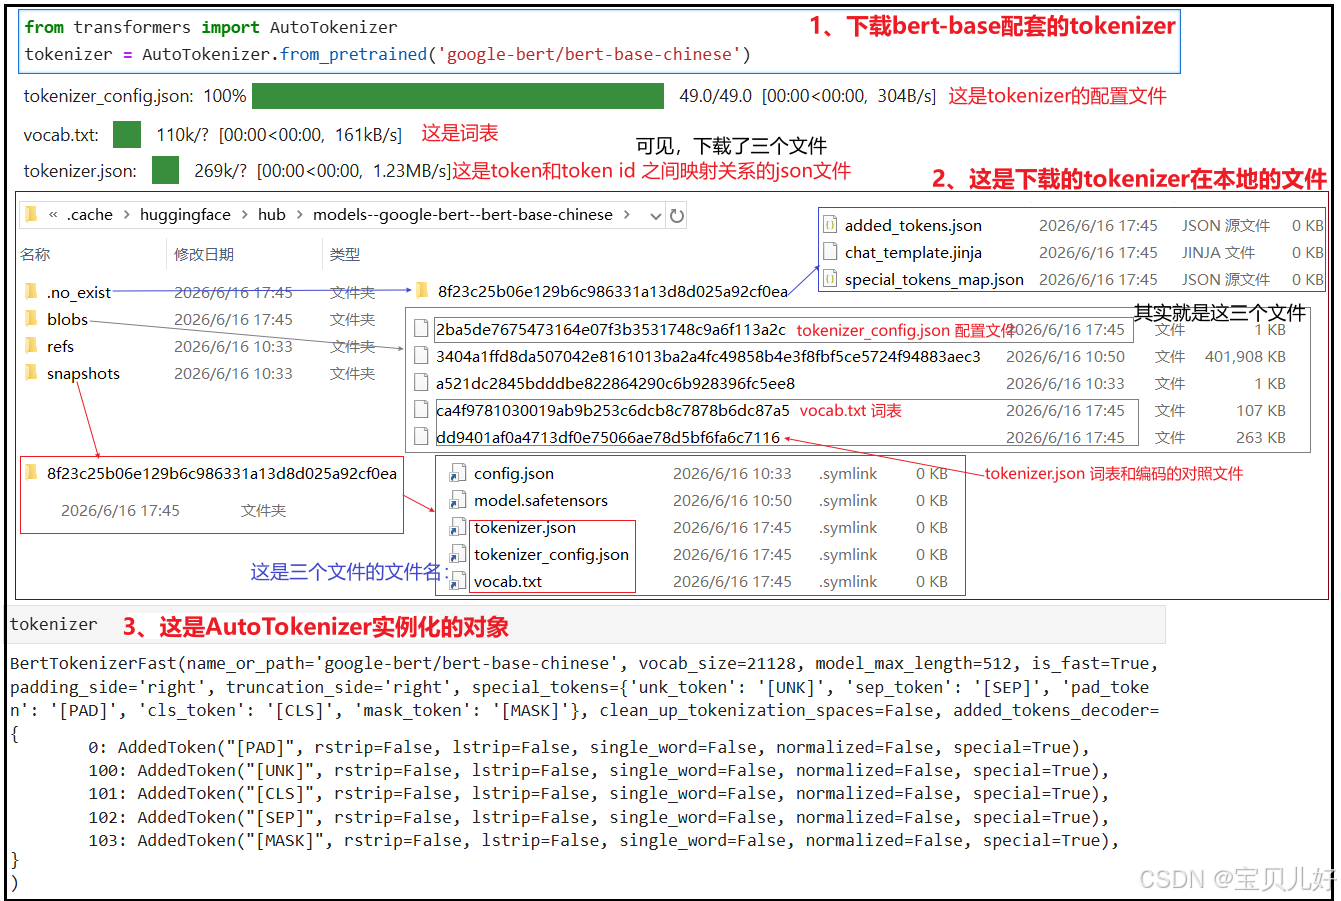 可见,AutoTokenizer会帮我们下载词表、tokenizer的配置文件、token和id之间对应关系的文件这3个文件,文件保存路径和AutoModel一样。下载完毕后,AutoTokenizer就根据词表和配置文件实例化一个Tokenizer对象。
2、离线加载Tokenizer
当我们自己本地就有词表和配置文件,我们就可以从本地路径加载: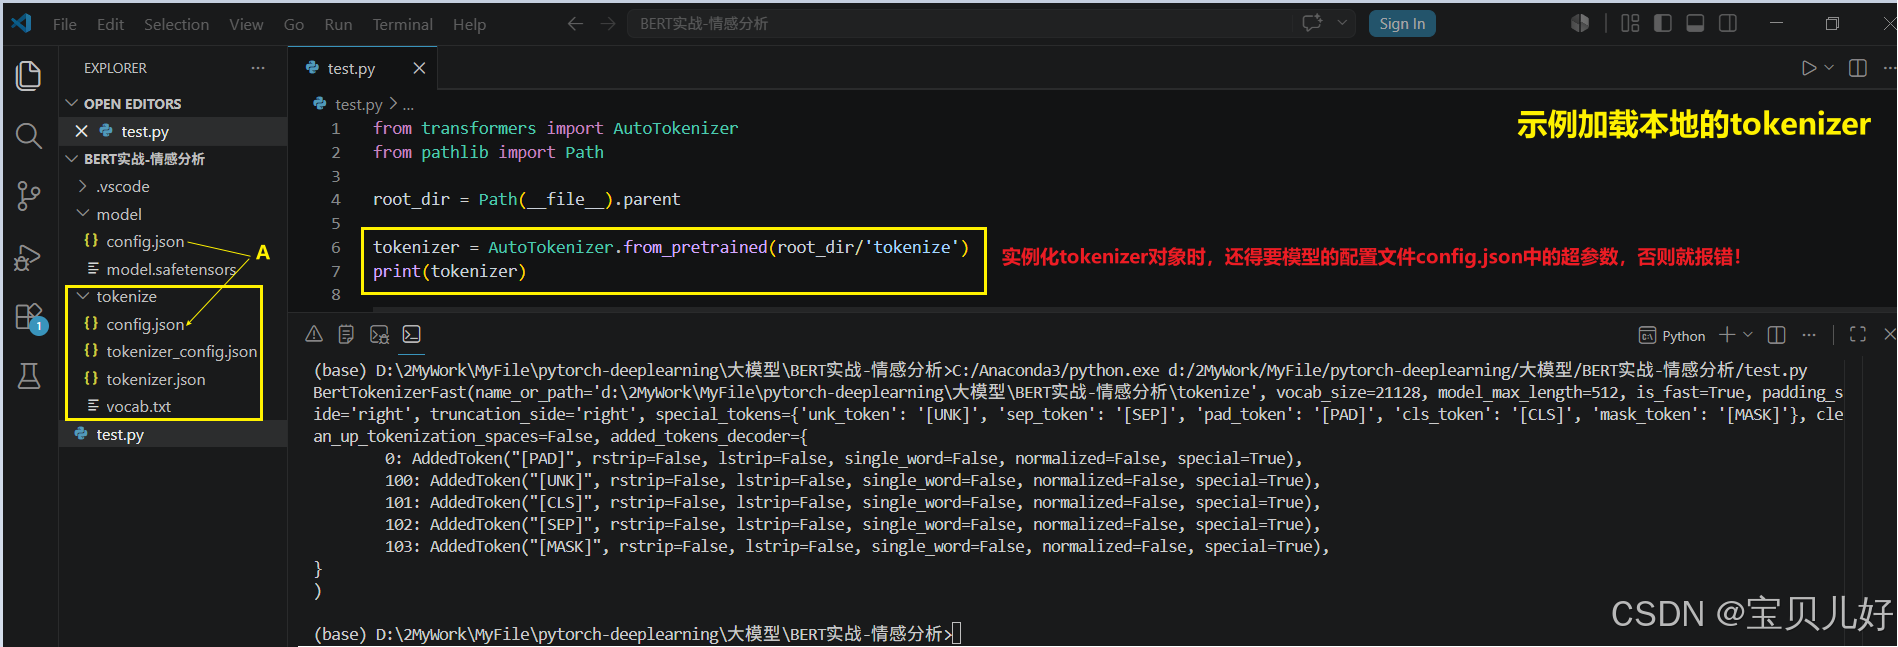
3、Tokenizer的使用
(1)字词切分
不同模型采用的分词算法是不一样的!欲知详情请参考:【NLP】第二章:分词算法BPE、WordPiece、Unigram、分词工具jieba_nlp分词策略-CSDN博客
所以不同的分词算法-->导致词的切分不同-->导致词表不同-->导致词的编码不同-->导致不同的词id。
也所以不同模型配套着不同的Tokenizer。不同的Tokenizer就会把你喂入模型的文本切分成不同的token。
也所以不同模型就对应不同的词id映射。也就是同一个词,BERT预训练模型对应的id可能是100,而T5模型的id可能就是1000。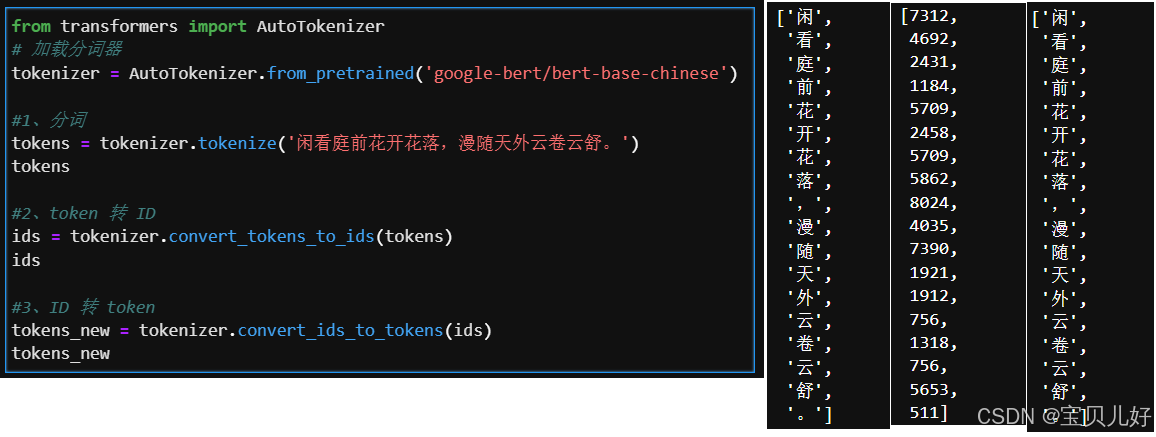
(2)编码(encode)
编码是词id+特殊token后的编码。比如你给Tokenizer一句文本,它分词-->按照词表将词转id-->再自动添加如[CLS]和[SEP]等特殊token,或者进行添加padding、truncate等操作。
重点1:不同模型使用的特殊token都不一样,所以你使用哪个模型,你要配套使用它对应的词表,这样就不会弄错特殊token。
重点2:padding和truncate是截断和补齐的意思,就是超过规定长度的文本要被截断,小于规定长度的文本要被补齐。不同模型支持不同的文本长度,这些超参数都放在配置文件中,所以要使用配套的tokenizer文件。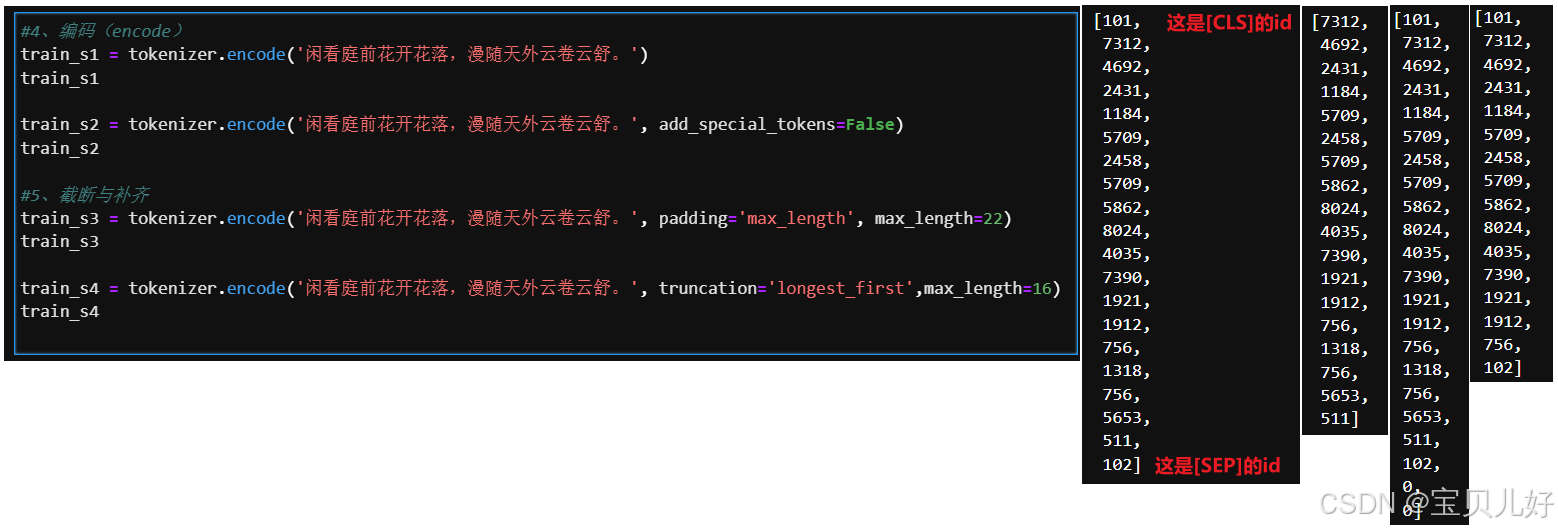 说明:这些api的功能很多,所以参数的逻辑也很多,我上面的示例仅仅是冰山一角,想要知道更多的个性化操作,最好自己查阅这个tokenizer的文档,文档里面有各种参数的详细说明。
(3)解码(decode)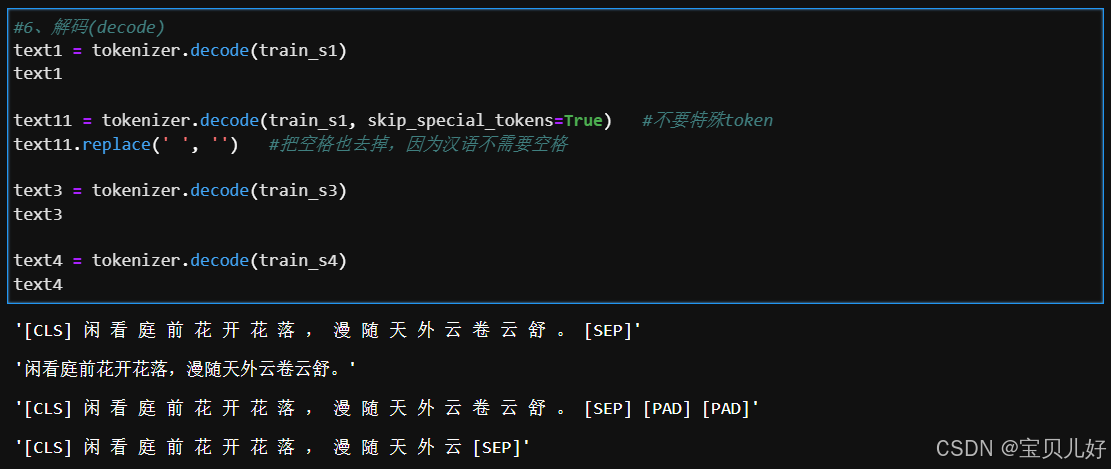
(4)直接构造模型所需的输入:tokenizer()方法
tokenizer()方法是最有用的一个API。tokenizer()底层调用的是__call__方法,这个方法打包了分词、转id、添加特殊token、padding和truncate操作、辅助输入各种mask等。所以它生成的序列可以直接喂入模型。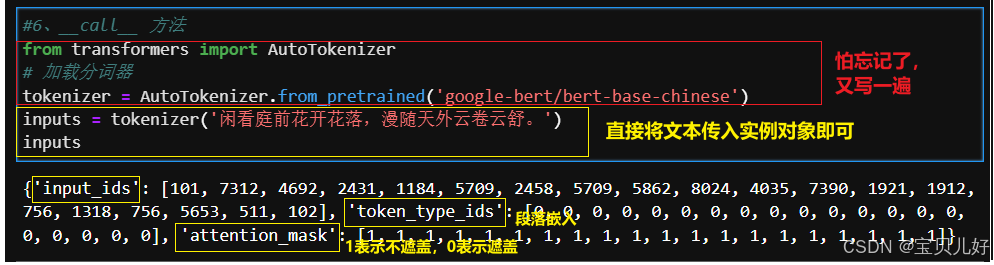 这种是输入单个句子的情况。返回三个对象,一个是添加了特殊token的序列id,一个是BERT的段落嵌入id,一个是注意力模型中的mask,BERT的注意力模型是不需要mask的,所以都是1,1表示不遮盖。
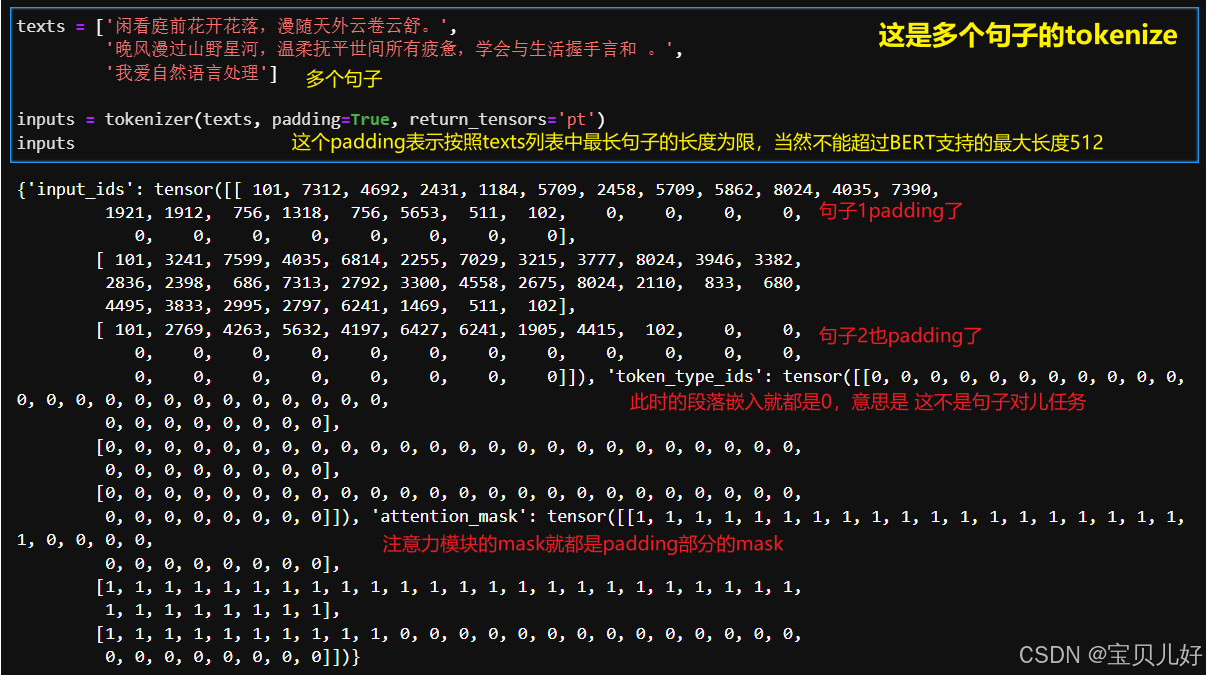
我们再看看句子对儿和一个batch的句子的情况: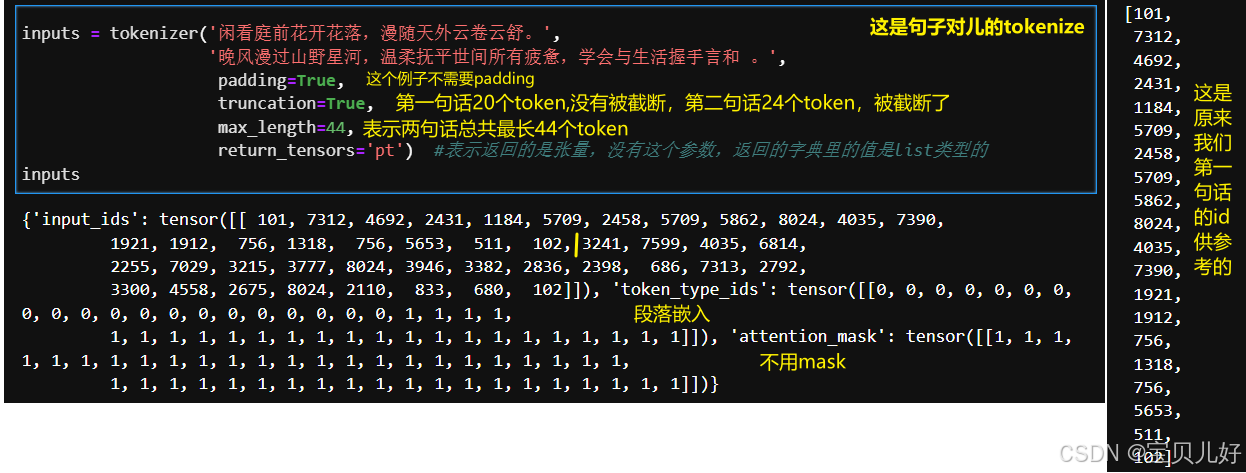
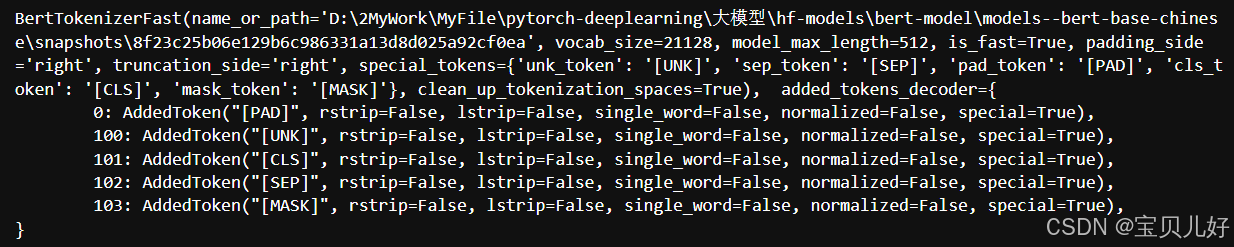
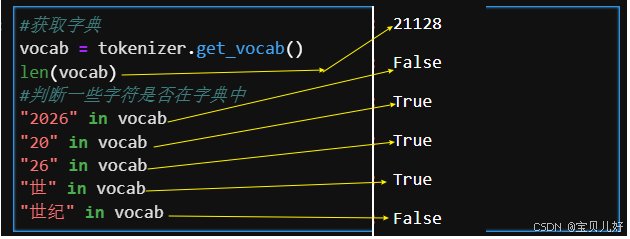
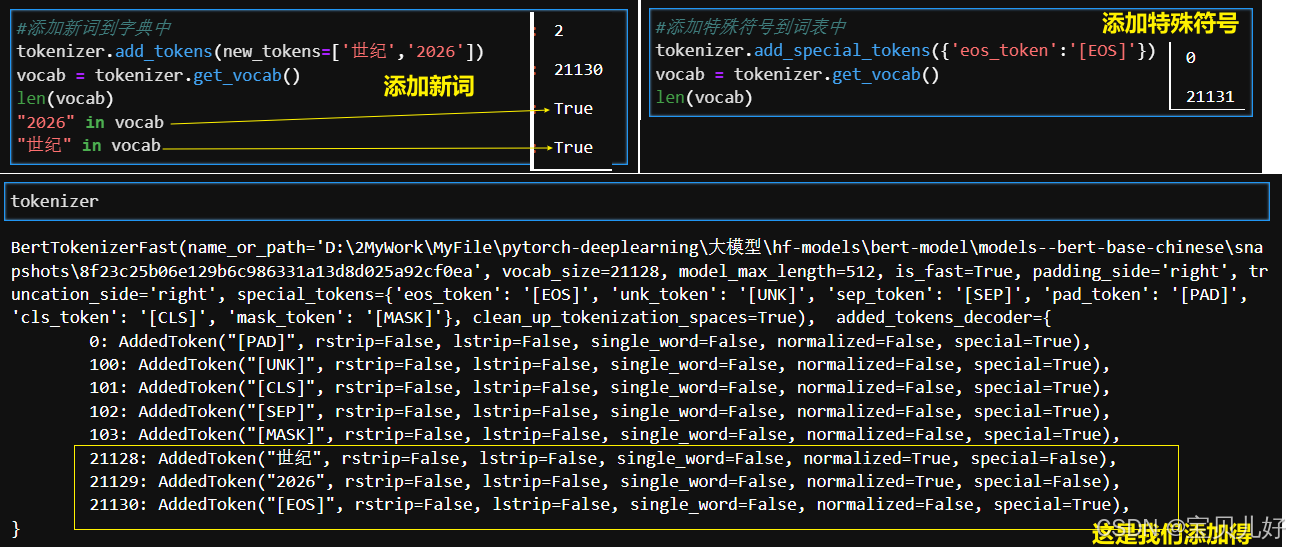
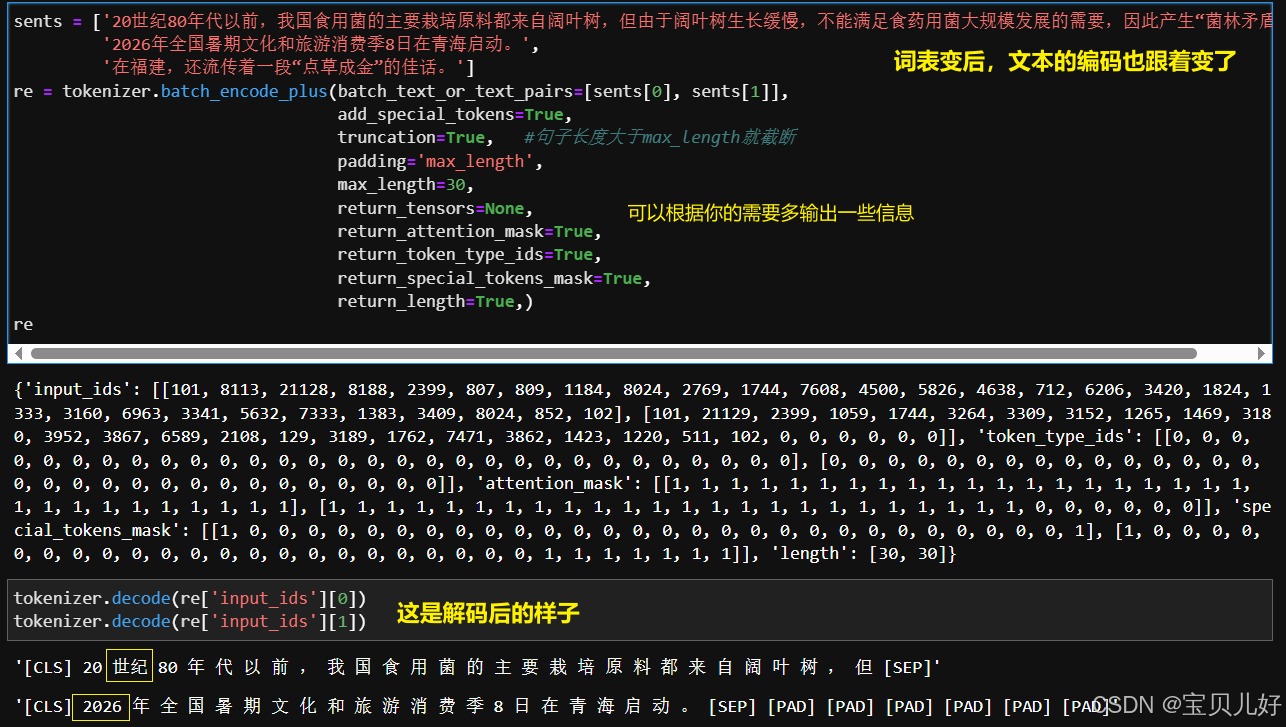
4、自定义字典
五、分词器和模型的配合使用方式
1、我们先看看BERT预训练模型的输出
import torch
from transformers import AutoModel
from transformers import AutoTokenizer
#这是我要测试的数据
texts = ['闲看庭前花开花落,漫随天外云卷云舒。',
'晚风漫过山野星河,温柔抚平世间所有疲惫,学会与生活握手言和 。',
'我爱自然语言处理']
#加载模型
model = AutoModel.from_pretrained('google-bert/bert-base-chinese')
#加载分词器
tokenizer = AutoTokenizer.from_pretrained('google-bert/bert-base-chinese')
#测试数据在BERT主体模型中前向传播一次
inputs = tokenizer(texts, padding=True, return_tensors='pt')
with torch.no_grad():
output1 = model(**inputs)
output1.last_hidden_state.shape
output1.pooler_output.shape
output1 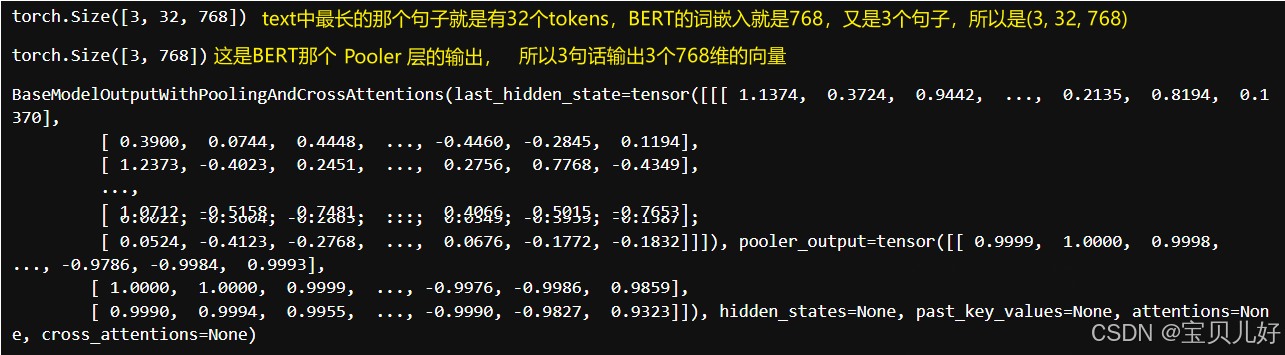
2、再看看带任务头的BERT的输出
import torch
from transformers import AutoModel, AutoTokenizer, AutoModelForSequenceClassification
#这是我要测试的数据
texts = ['闲看庭前花开花落,漫随天外云卷云舒。',
'晚风漫过山野星河,温柔抚平世间所有疲惫,学会与生活握手言和 。',
'我爱自然语言处理']
#加载模型
model = AutoModel.from_pretrained('google-bert/bert-base-chinese')
#被BERT预训练模型添加一个5分类的任务头
model_full = AutoModelForSequenceClassification.from_pretrained('google-bert/bert-base-chinese', num_labels=5)
#加载分词器
tokenizer = AutoTokenizer.from_pretrained('google-bert/bert-base-chinese')
#测试数据前向传播一次
inputs = tokenizer(texts, padding=True, return_tensors='pt')
with torch.no_grad():
output2 = model_full(**inputs)
output2 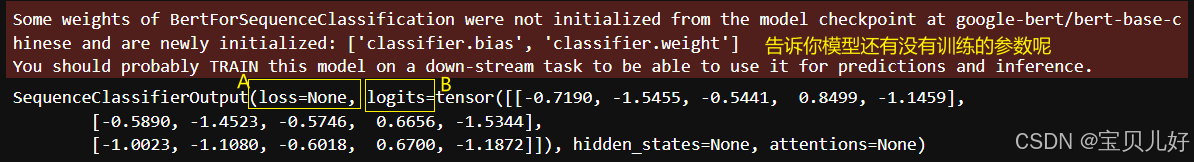 A、B处:因为大模型和我们深度学习的模型不太一样,大模型包装得更多,大模型的输出直接就是loss!意思是你还得给大模型传标答,这样大模型在前向传播后,自动就帮你计算了loss,你连loss计算都省了!因为这个示例中我没有传标答,所以loss=None,但是大模型还是给我返回了logits,logits是最后任务头线性层的输出,所以有正有负。下面我们看看给模型传入Label的情况:
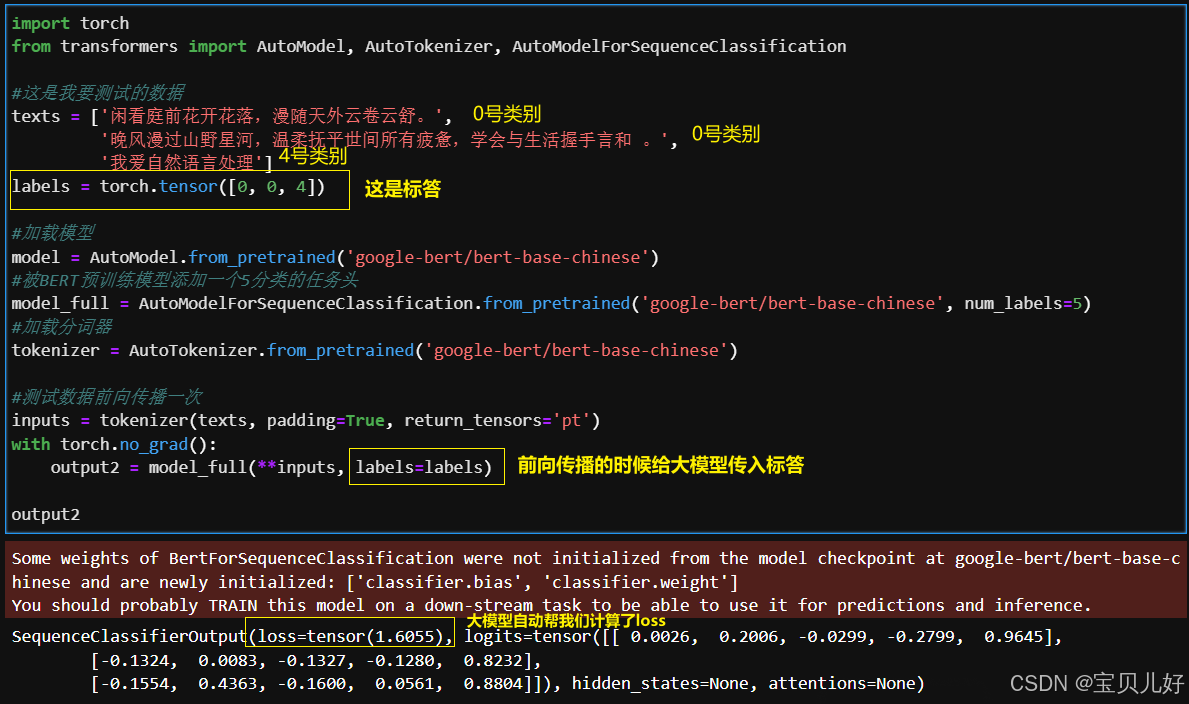
那么,大模型究竟是怎么计算loss的呢?多分类任务自然是交叉熵损失了,下面我手动给大家验证一下: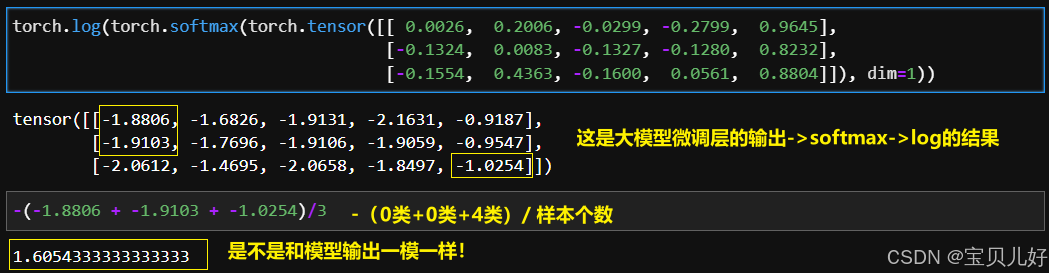 可见大模型计算的是样本的平均损失!如果连这个损失都不明白怎么计算的同学,说明基础太差,相关知识点可以参考这篇博文中最后的补充知识点:【LLM】第四章:项目实操案例:文本情感分析_llm训练实例-CSDN博客
也可以参考我之前的基础系列:https://blog.csdn.net/friday1203/category_12824284.html?spm=1001.2014.3001.5482
六、Datasets库
datasets是hf提供的一个轻量级数据处理库。它是原始数据和hf中的tokenizer之间的承接件。主要功能有:
读取hf中的开源线上数据集;
读取本地的线下数据集;
字段筛选:就是数据清洗,比如筛选列,筛选空行等数据清洗工作;
批量映射,就是.map()方法,后面会有详细介绍;
训练集、验证集的划分,就是.train_test_split()方法。
1、安装datasets库
pip install datasets
2、自制数据集
from datasets import Dataset
data_dic = {'text':['闲看庭前花开花落,漫随天外云卷云舒。',
'晚风漫过山野星河,温柔抚平世间所有疲惫,学会与生活握手言和 。',
'我爱自然语言处理'],
'label':[0, 1, 1]}
dataset = Dataset.from_dict(data_dic)
dataset 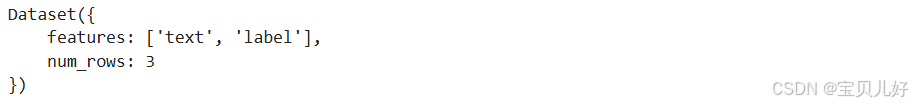
3、加载本地数据集:load_dataset()接口
说明:本地数据来源是使用之前的情感分析案例 【NLP】第八章:项目实操案例:文本情感分析-CSDN博客 中的数据为例的。
datasets库提供了统一的接口load_dataset(),支持CSV、JSON、Parquet三种格式,并允许一次加载一个或多个文件。其中,Parquet是一种列式存储文件,是大数据领域中常见的存储方式。
dataset = load_dataset('json', data_files=路径或字典),load_dataset的参数说明:
第1个参数可选:'csv'、'json'、'parquet'
第2个参数dta_files=路径或字典。
(1)示例1:加载本地的多个CSV文件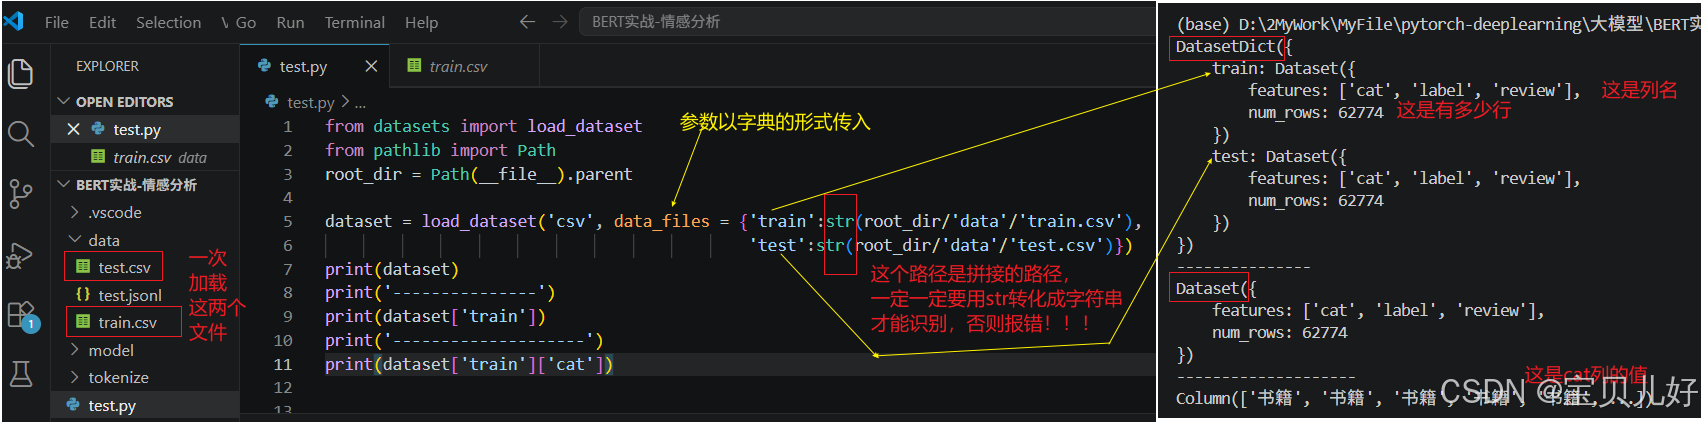
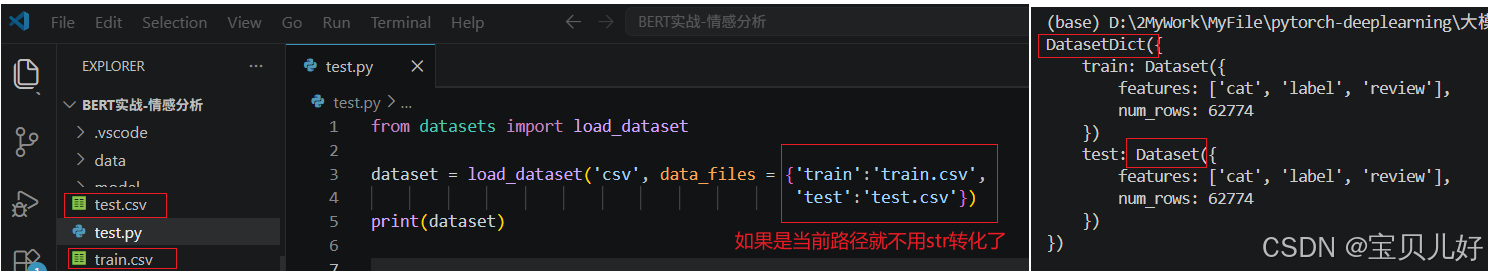 说明:上面是以csv格式文件为例,json文件也是同理。
(2)示例2:加载本地的、单个的、CSV或者JSON文件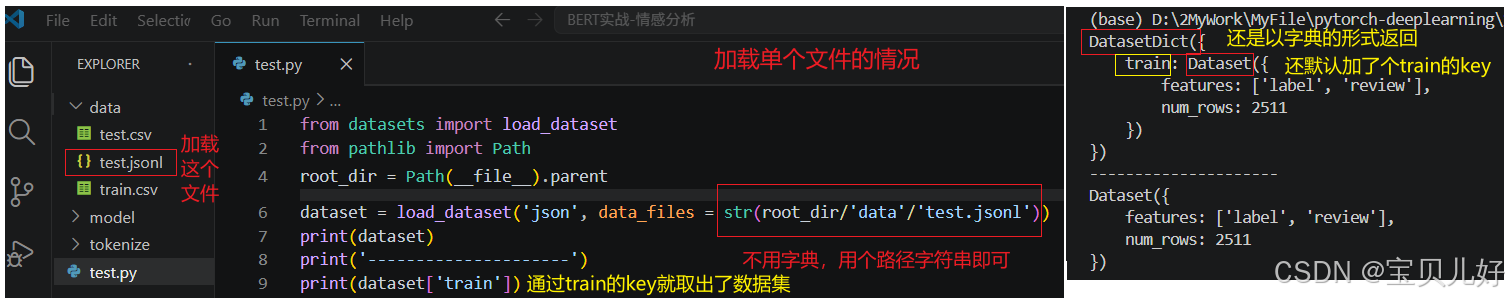 说明:加载单个文件,返回的还是一个字典对象。
(3)示例3:抽样加载部分数据
当原始语料太多,要加载很长时间时,可以先加载部分数据: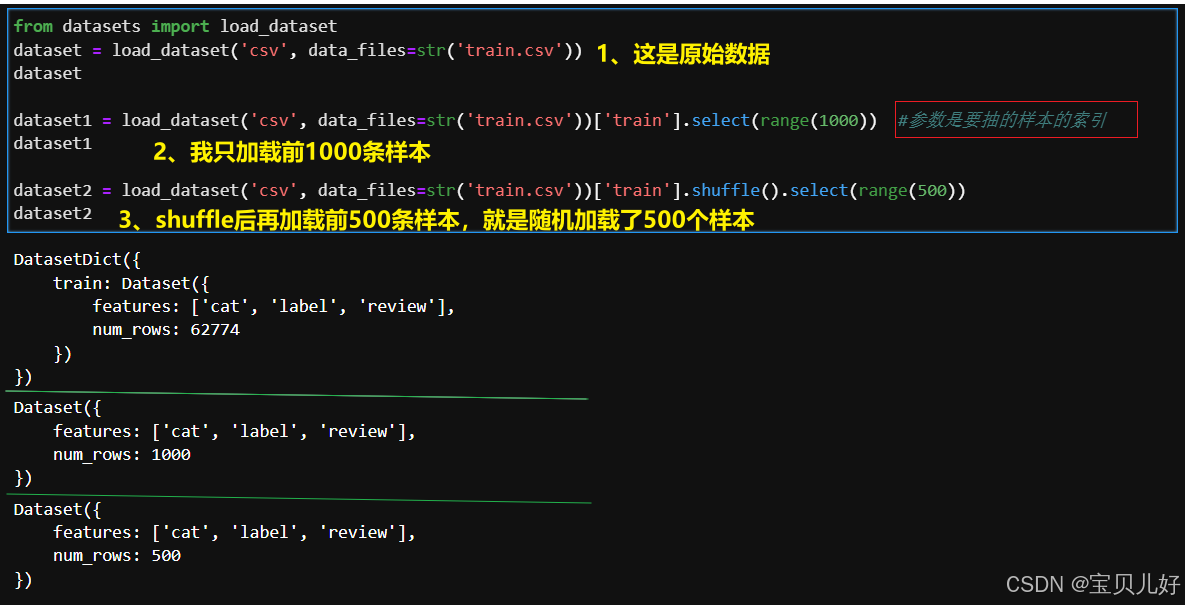
(4)小结:
一是,参数data_files的值是字符串形式的路径。所以如果你的文件就在当前路径下,你直接写文件名即可。但是如果你的文件在别的路径下,此时你得把你拼接的路径用str转化一下。
二是,load_dataset()接口默认的就是加载多个文件,所以加载单文件返回的也是一个字典。
三是,当原始数据太大,我们想要部分数据测试时,可以用shuffle+select加载部分数据。
4、DatasetDict对象和Dataset对象
从上面例子中我们可以看出,load_dataset返回的是DatasetDict对象,DatasetDict对象是一个字典。字典中每个元素的值都是一个Dataset对象,这个Dataset对象是HuggingFace datasets库中的Dataset对象,和我们torch.utils.data中的Dataset不是一个东西!和pandas中的DataFrame也不是一个东西!它也是一个二维表格数据,但是是按列组织数据的!如果想查看表格形式的数据,可以使用Dataset对象的内置方法将其转化为pandas的DataFrame格式查看: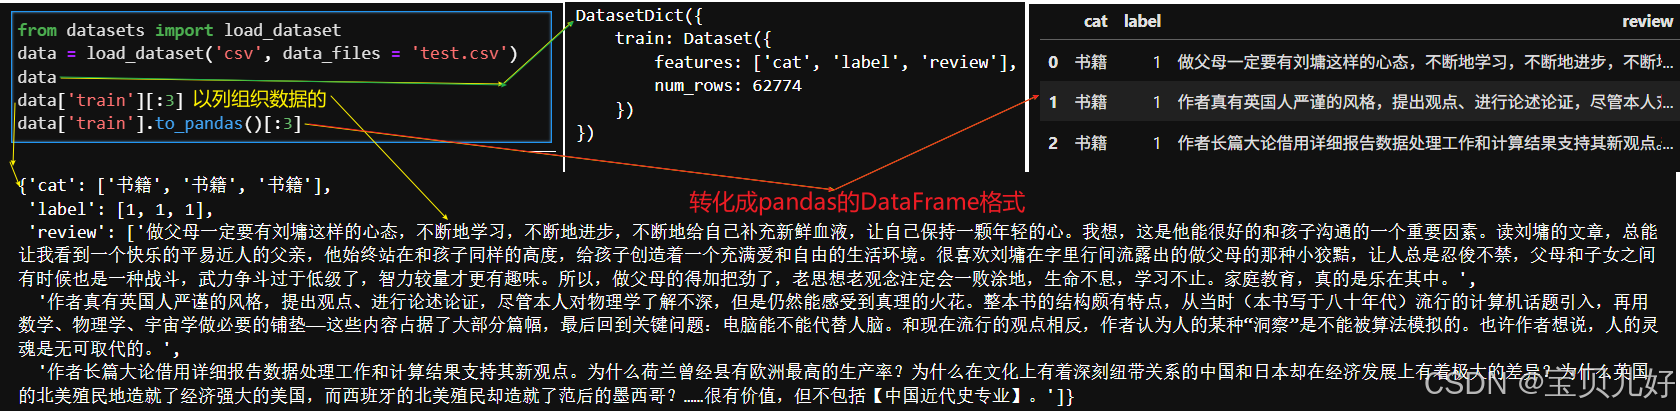
5、加载hf上的开源数据集
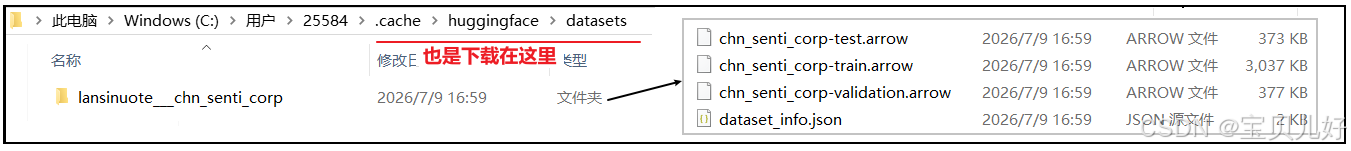
hf提供了大量的开源数据集,涵盖文本分类、问答、翻译、摘要等任务。你首先登录到hf-mirror,然后找到dataset,然后找到你要的数据集,然后从网站上下载到本地,然后用load_datase读取即可。
当然你也可以在线下载,下面是一个示例: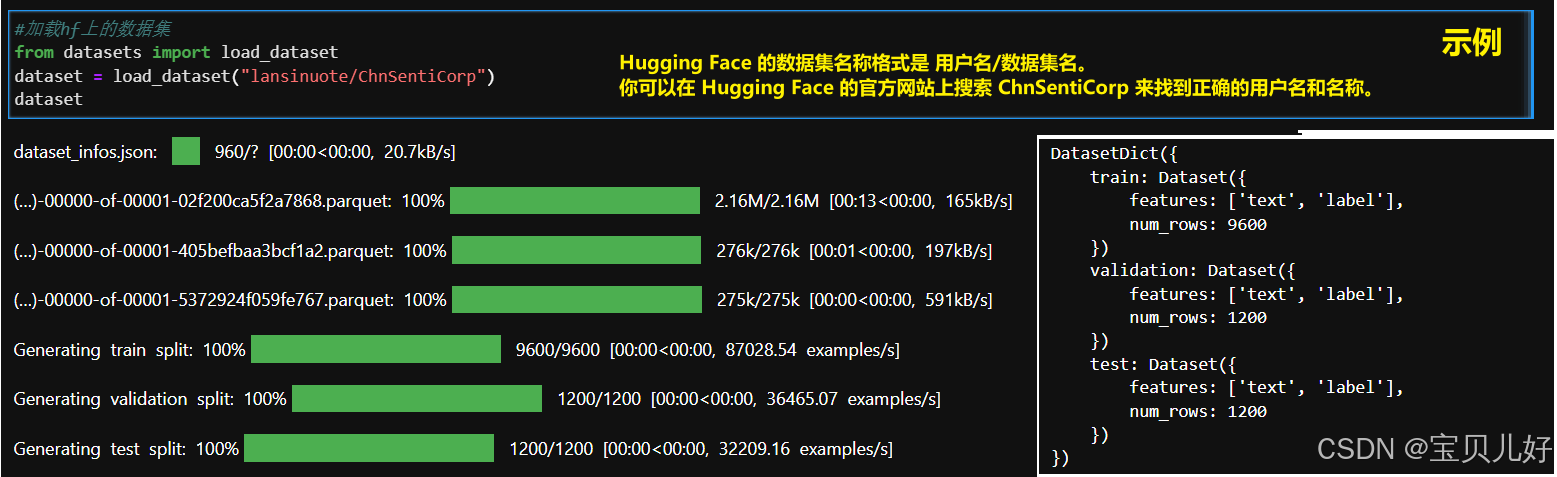
6、预处理数据集
预处理指数据清洗,比如删除某行、过滤样本、划分子集、转张量类型等操作。
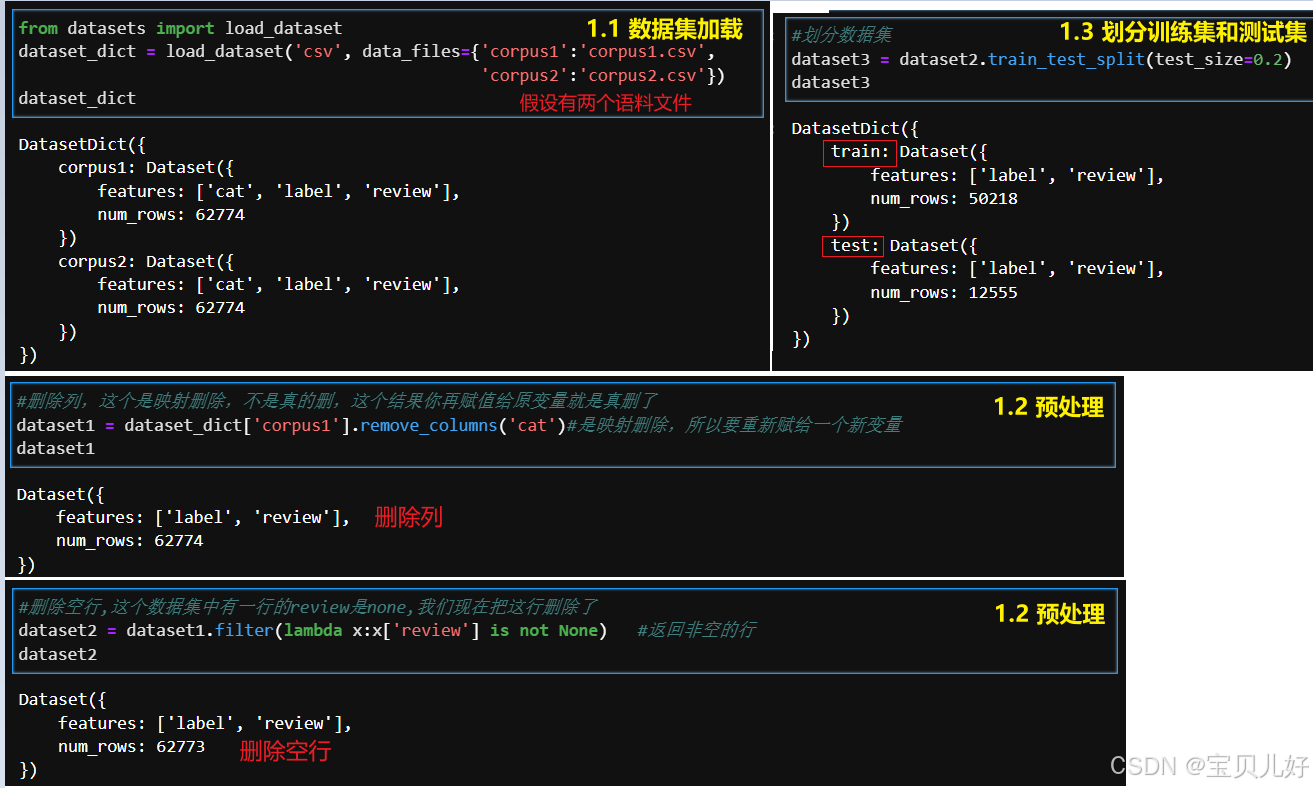
(1)删除列、过滤行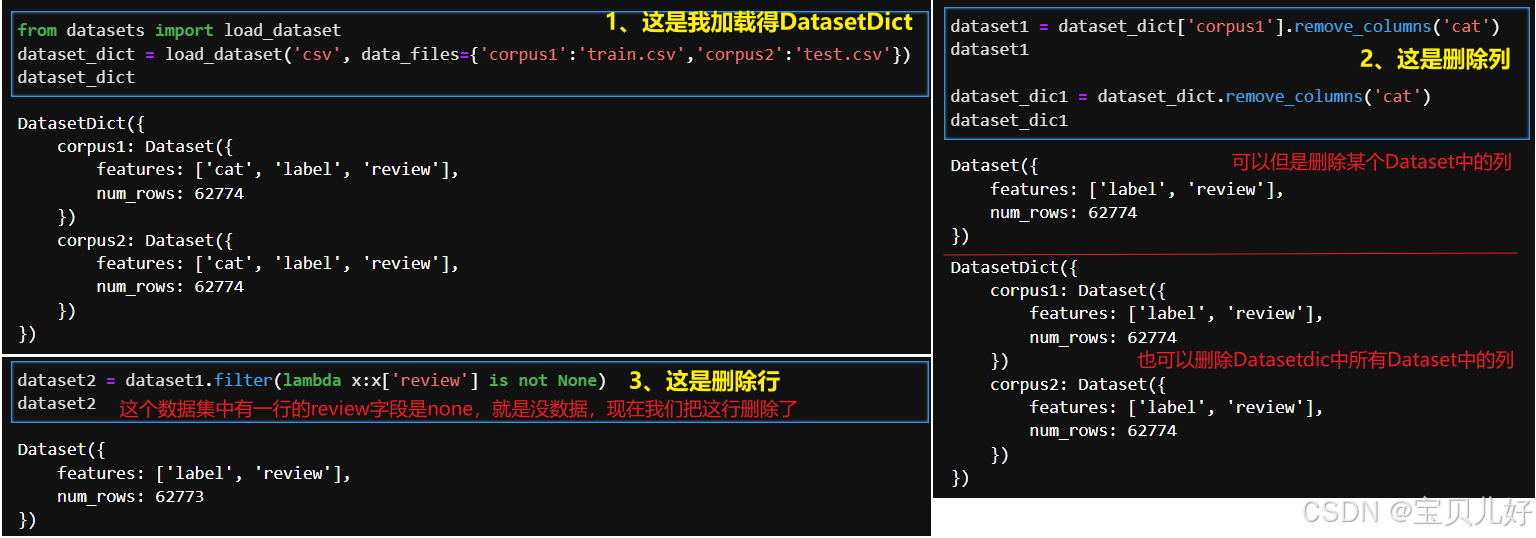 说明:数据清洗操作都是映射操作,就是删除不是真删除,只是映射删除,所以你的操作结果要再赋值给一个新变量,新变量才是删除后的数据。
(2)划分数据集
当数据集中的样本是均衡时,就用下面示例的简单分法: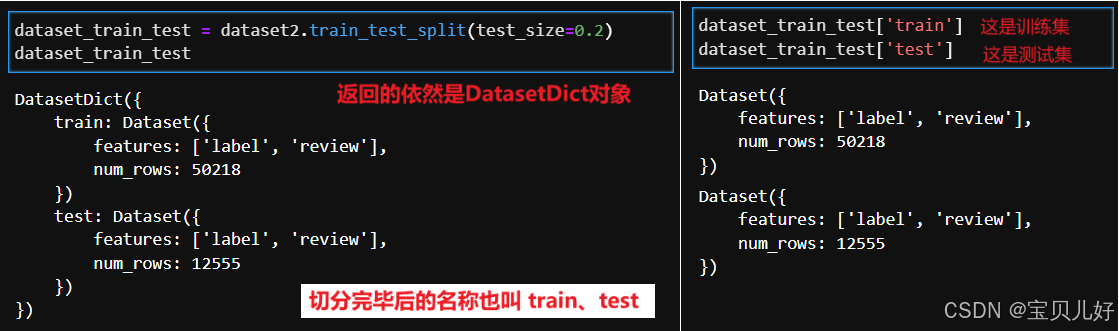 说明:划分数据集只能针对一个个dataframe进行split,不能在DatasetDict上split。
当我们数据集的样本不均衡时,我们希望随机划分训练集和测试集时,能按照标签列的分布来划分时: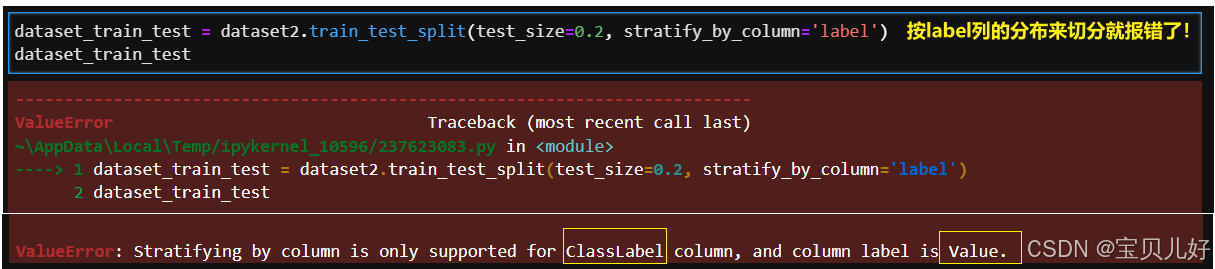 报错的原因是Dataset对象中的各个字段的数据类型引起的。所以下面详细讲解一下Dataset对象的类型。
(3)Dataset对象的数据类型
前面我们已经说过,Dataset对象是一个按列组织的表格数据。既然是表格数据,又是按列保存的,那每列的数据类型就得规定明确。那我们如何查看各列的数据类型呢?使用Dataset对象的.features方法来查看: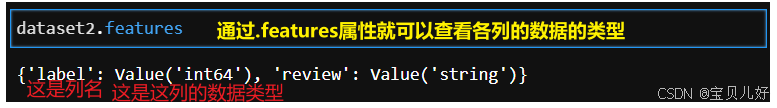
Dataset对象的.features方法返回值是表格数据的各个字段的类型,它是表格每列数据在计算机底层的保存格式。但是上图示例的数据有点简单,其实不仅有上图示例中的Value类型,还有比如ClassLabel格式,比如下面例子: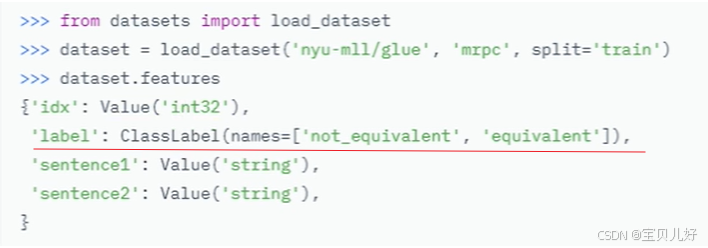
意思就是Dataset有一列,它的值都是'equivalent'和'not_equivalent',或者说,Dataset中有一列数据,一般都是标签列,但是这个标签列不是0123...这种类别编号的值,而是有限个文本格式的值,比如这个例子中的等价、不等价这种标签。
datasets库作为大模型的配套库,它是支持这种文本表示的标签的,这种列就是ClassLabel类型。相反,datasets却是不支持标答是0123...的这种列的,因为大模型能返回自然语言答案,会显得更智能一些,所以它会维护一份编码和文本类型的词表,直接返回用户文本。
但是又因为训练模型还得用数字类型的标答,所以datasets会在底层自动把文本转换成数字编码,并且维护一份ClassLabel.int2str()和ClassLabel.str2int(),将来我们用模型推理时,就非常方便将结果转换成文本。下面示例如何强制将我们label列的数据类型从value转化成ClassLabel类型: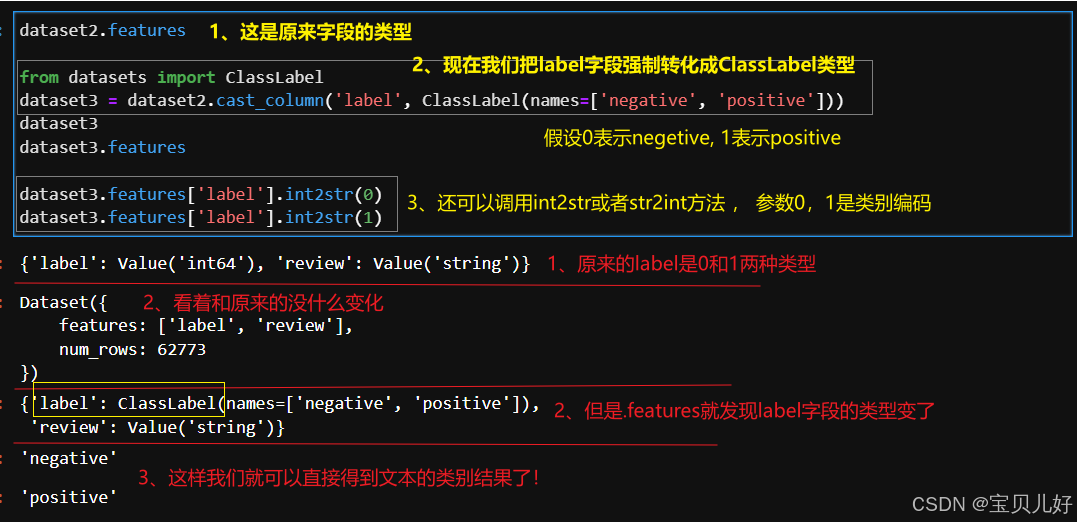
强制转换后,我们再用label列的分布来随机切分训练集和测试集,就不会报错了: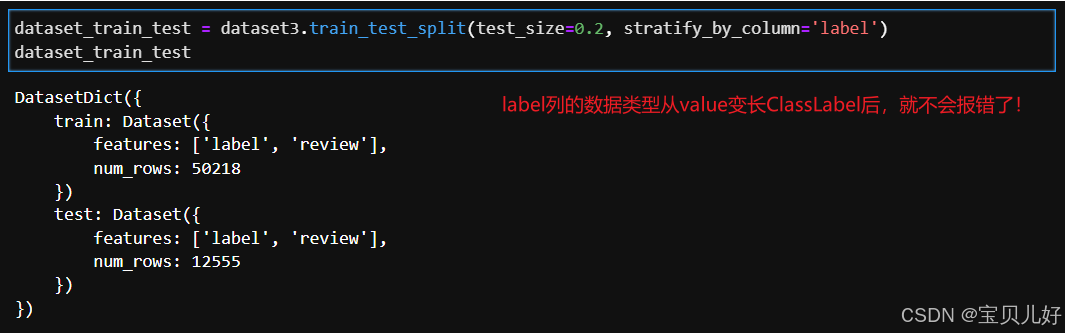
七、Datasets和Tokenizer的联合使用:Datasets.map()方法编码样本
前面讲的Dataset是加载原始数据、清洗原始数据、划分数据集等操作。这些操作完成后,就该使用分词器Tokenizer,把数据集中的样本进行分词、编码、添加特殊token、padding和截断、解码等操作了。所以此时就涉及到Datasets和Tokenizer的搭配使用。
Datasets.map()方法支持对整个数据集中的每一条样本或每一批样本进行tokenize处理。将该方法与tokenizer配合,就可以将原始文本样本编码成模型可用的输入格式,比如BERT模型要求的input_ids、attention_mask、token_type_ids格式。
Datasets.map()的语法: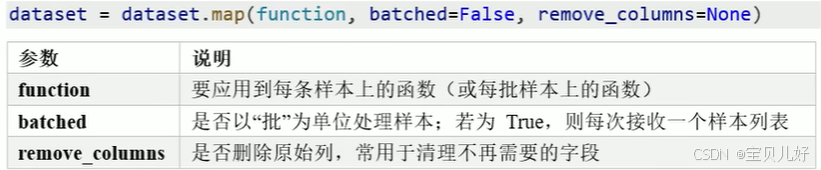
说明:上面的参数只是几个最重要的参数,其实.map()方法还有很多参数,大家最好是去看看文档。下面是示例:
1、准备工作:数据集加载-->预处理-->划分训练集和测试集
2、对DatasetDict对象进行tokenize示例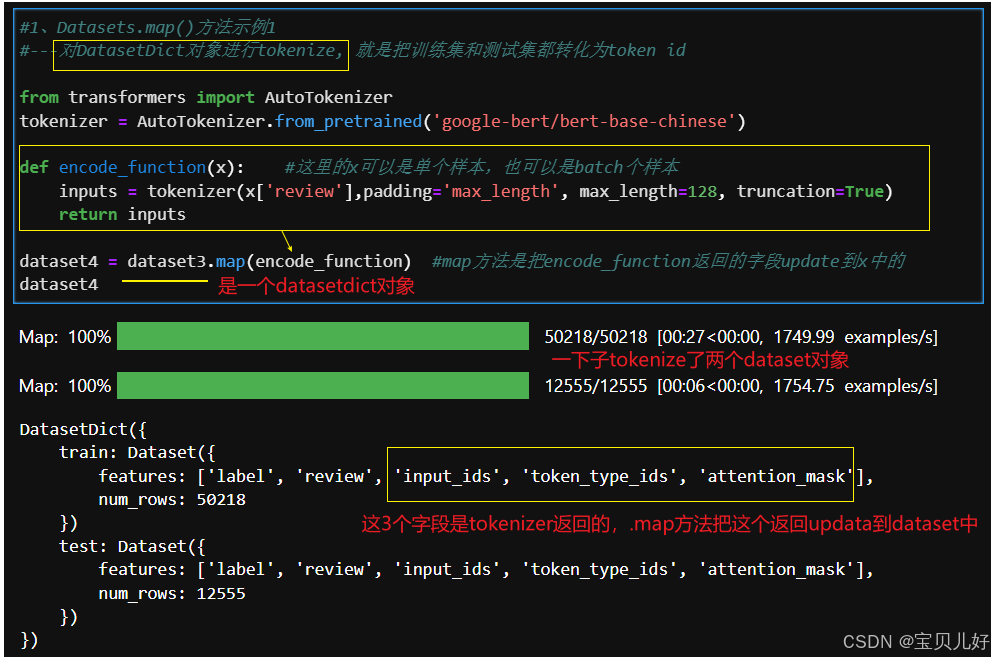
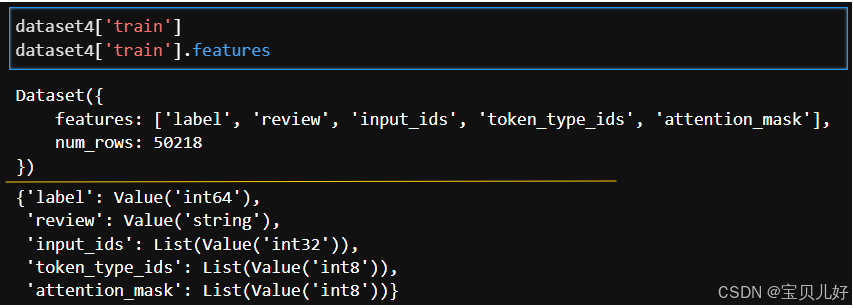 一次性批量处理了2个Dataset对象。.map()方法将其function参数的返回值updata到dataset3中。就是如果dataset3中如果有function返回的列,就不添加,如果没有就添加。所以返回值dataset4中变长5个字段。
3、对Dataset对象、批量的tokenize示例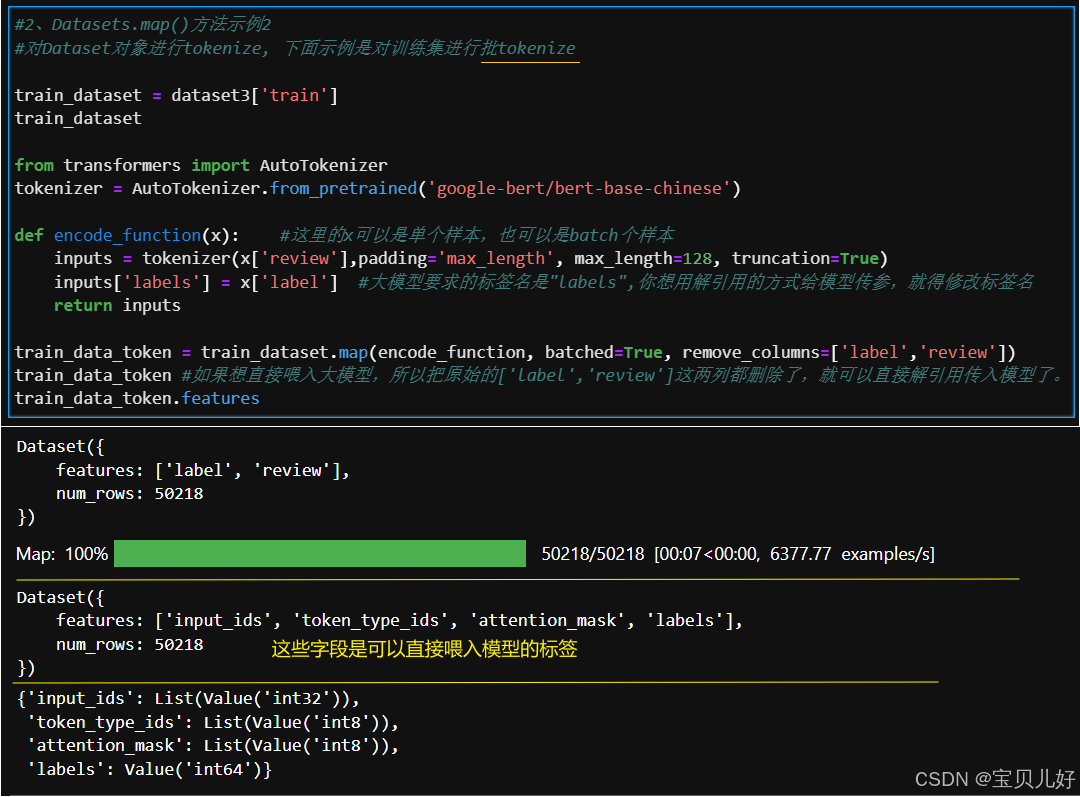 批处理就是一次性处理完毕Dataset对象中的所有样本。这种场景适用于训练阶段。
4、对Dataset对象、单个样本的tokenize示例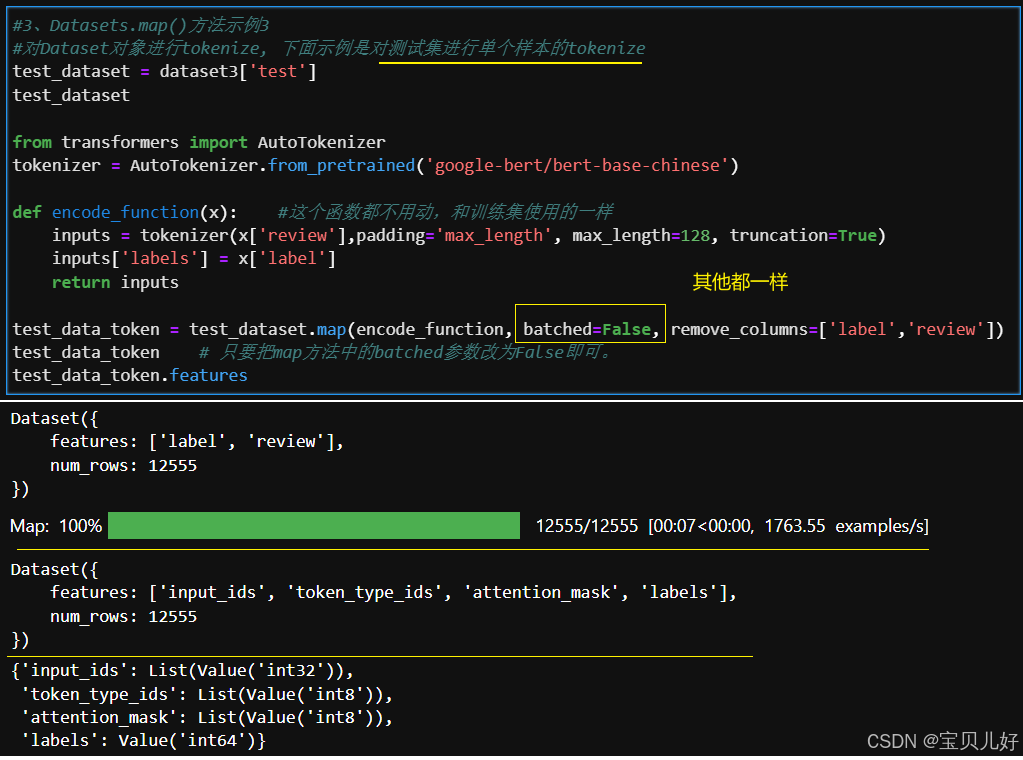 这种底层是对Dataset对象中样本,一个个进行tokenize。这种场景适用于测试阶段。
八、保存和加载DatasetDict、Dataset对象
我们在数据预处理和tokenizer的过程中,生成很多DatasetDict对象和Dataset对象,这些数据都是可以保存到本地,以供后续训练或复用,避免重复处理。Datasets提供了下面几种保存方式,适用于不同场景: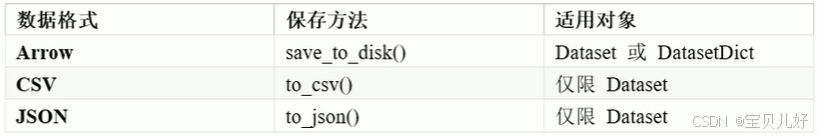
1、Arrow格式数据的保存和加载:.save_to_disk()和load_from_disk()
HuggingFace官方推荐的数据持久化方式是Arrow格式,既支持单个Dataset也支持多个子集的DatasetDict对象。
Arrow格式的性能比较高,是一个二进制文件的格式。而CSV和JSON文件都是文本文件得格式,所以我们打开csv文件或者json文件,我们都是认识文件中的字符的。而二进制文件我们人类是看不懂的,是计算机认识的符号。所以如果你追求性能就选择Arrow格式,如果你追求可读性就用CSV或者JSON格式。
(1)下图是如何将DatasetDict保存成Arrow格式的示例: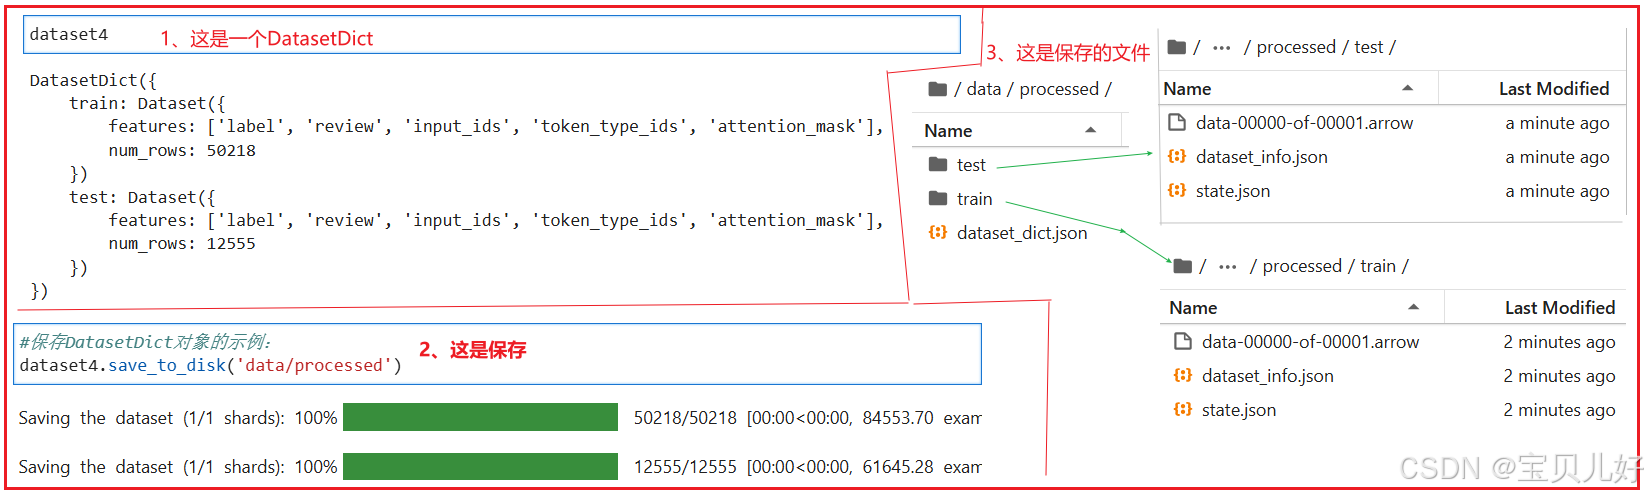 保存用.save_to_disk('路径')即可,连文件名都不需要,自动就保存成2个文件夹。
(2)下图是如何加载多个Arrow格式文件的示例: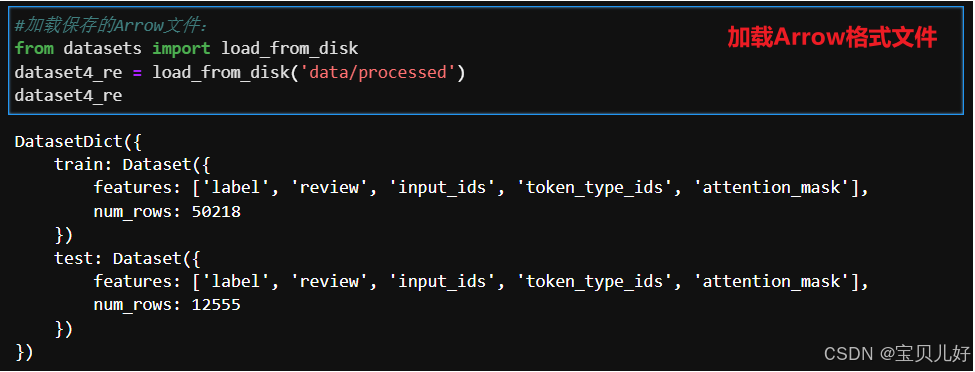 注意文件名路径写到processed层即可,此时加载的就是DatasetDict对象,就是加载两个文件。
(3)下图是如何加载单个Arrow格式文件的示例: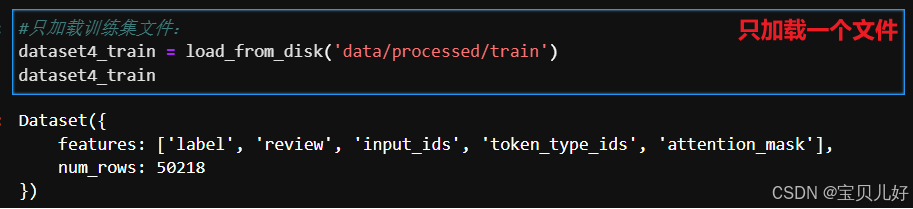 说明:
load_dataset是在线调用dataset,需要保持网络畅通,它会先在cache目录中检查是否有文件,如果有就加载,如果没有就在线下载并加载。而且load_datase可以加载多种格式的数据。
load_from_disk是本地调用dataset,并且加载的数据集格式必须是datasets格式的数据集,就是HF自己的数据格式。
2、.to_csv()和.to_json()方法
.to_csv()或.to_json()方法都只适用于单个Dataset不支持DatasetDict: 而要加载csv文件或者json文件,就用datasets.load_dataset('csv/json', data_files=路径或字典),详见大标题六中的load_dataset()接口讲解。
九、Datasets和torch.utils.data.DataLoader的联合使用
数据预处理完毕、tokenize完毕,数据就可以喂入模型进行正向传播了。但是在模型训练过程中,我们不是手动把数据送入模型的,我们还得借助pytorch中的DataLoader把数据按照batch送入模型进行正向传播-求损失-反向传播-求梯度-更新网络参数的。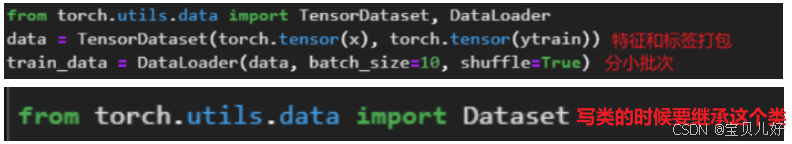
1、为什么非得DataLoader?
我们前面讲FNN的时候就论证过:模型训练时,一定要有适度的随机性,否则模型无法被训练,模型参数无法被更新!所以我们分小批次带入模型训练学习的时候,一定一定要是随机的小批次!不明白的同学可参考我的FNN博文:【深度学习】第六章:模型效果评估与优化_模型评估与优化-CSDN博客 ,里面有实验的小例子可以佐证。
而将训练样本随机分小批次的功能就是DataLoader的功能之一,所以在训练模型之前我们还得将数据和pytorch中的DataLoader进行无缝衔接。
经过预处理的、HF框架中的datasets.Dataset对象可以直接与pytorch中的DataLoader集成使用。虽然HF框架中的datasets.Dataset对象和torch.utils.data.Dataset类毫无关系,但由于实现了__len__()和__getitem__()这两个核心接口,所以能够被torch.utils.data.DataLoader正确识别并进行批量迭代。
2、.set_format()方法
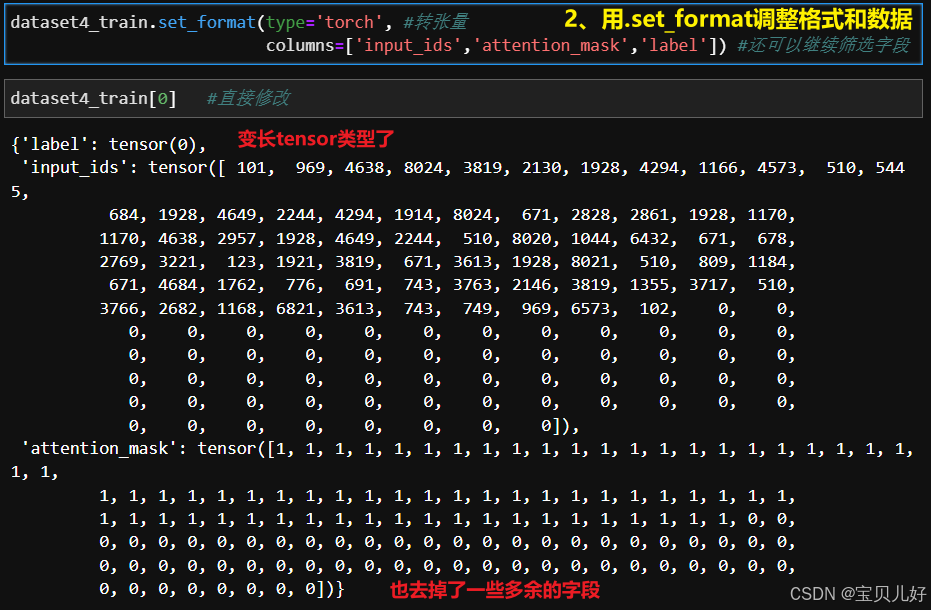
在使用前,需要通过.set_format()方法将指定字段转换为张量格式以适配模型输入,比如: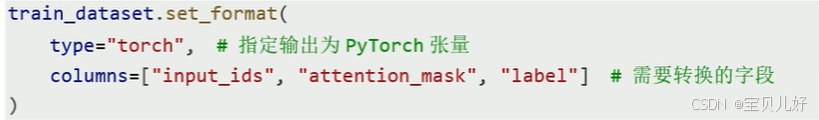 说明:该方法仅仅是通过__getitem__()(即通过Dataset[i])访问样本时返回格式,不会修改底层数据存储。
3、示例: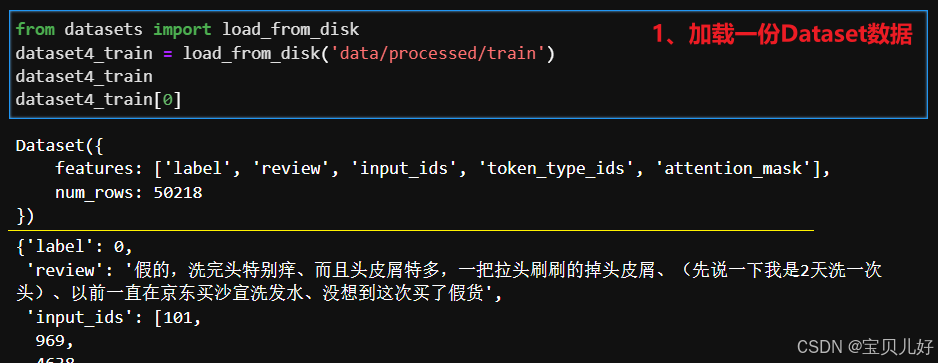
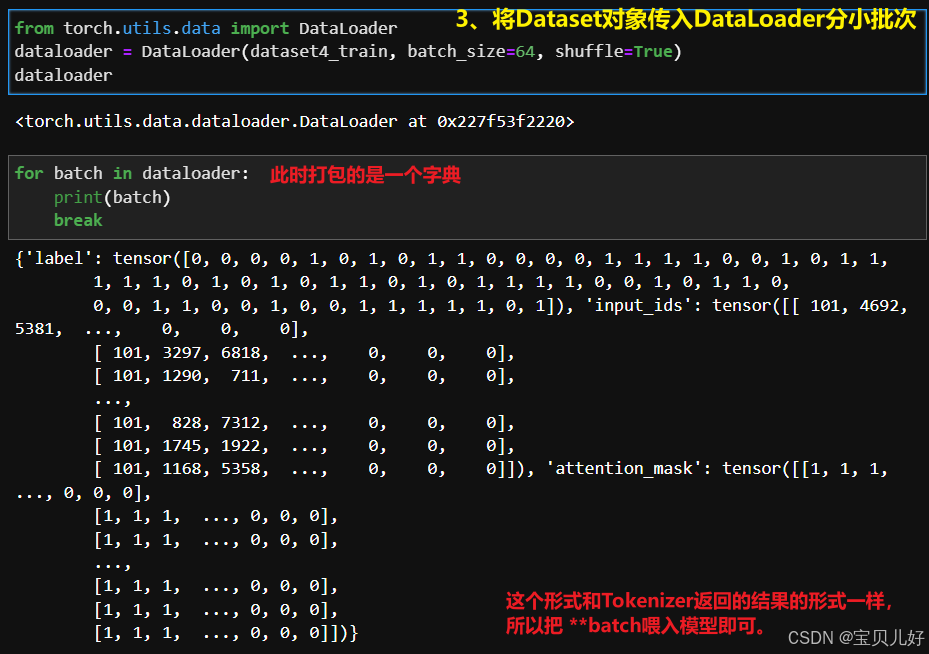
把上图中for训练中的batch,以解引用的方式给模型传参,即可顺利训练了。
4、用pytorch的dataset封装数据集
我们开发Ai应用时,主流的框架还是pytorch,所以这里再展示一下pytorch是怎样封装数据集的,封装数据集就是把数据集打包成模型可识别的数据结构,下面是pytorch的封装示例:
from torch.utils.data import Dataset
from datasets import load_dataset

class MyDataset(Dataset):
    def __init__(self, split):
        self.dataset = load_dataset('csv', data_files = {'train':'./train.csv', 'test':'./test.csv'})
        if split == 'train':
            self.dataset = self.dataset['train']
        elif split == 'test':
            self.dataset = self.dataset['test']
        else:
            print('数据集名称错误!')

    def __len__(self):
        return len(self.dataset)

    def __getitem__(self, item):
        text = self.dataset[item]['review']
        label = self.dataset[item]['label']
        return text, label
=======================本篇完。
更多推荐


 10
 0
- 0


 已为社区贡献2条内容

所有评论(0)