
计算机毕业设计选题推荐|【基于大数据的城市尾气排放数据可视化分析】Hadoop+Spark实战
精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
一、项目介绍
城市机动车保有量持续走高,尾气排放和空气质量问题更受关注,可排放、车辆结构、气象与区域差异等多类指标常散落在表格里,对比和排查起来费劲,管理与研究侧也缺少一套能把多维结果放到同一界面对照的工具。本文通过开发一个基于大数据的城市尾气排放数据可视化分析系统,用以帮助优化城市排放数据的多维展示与画像识别。
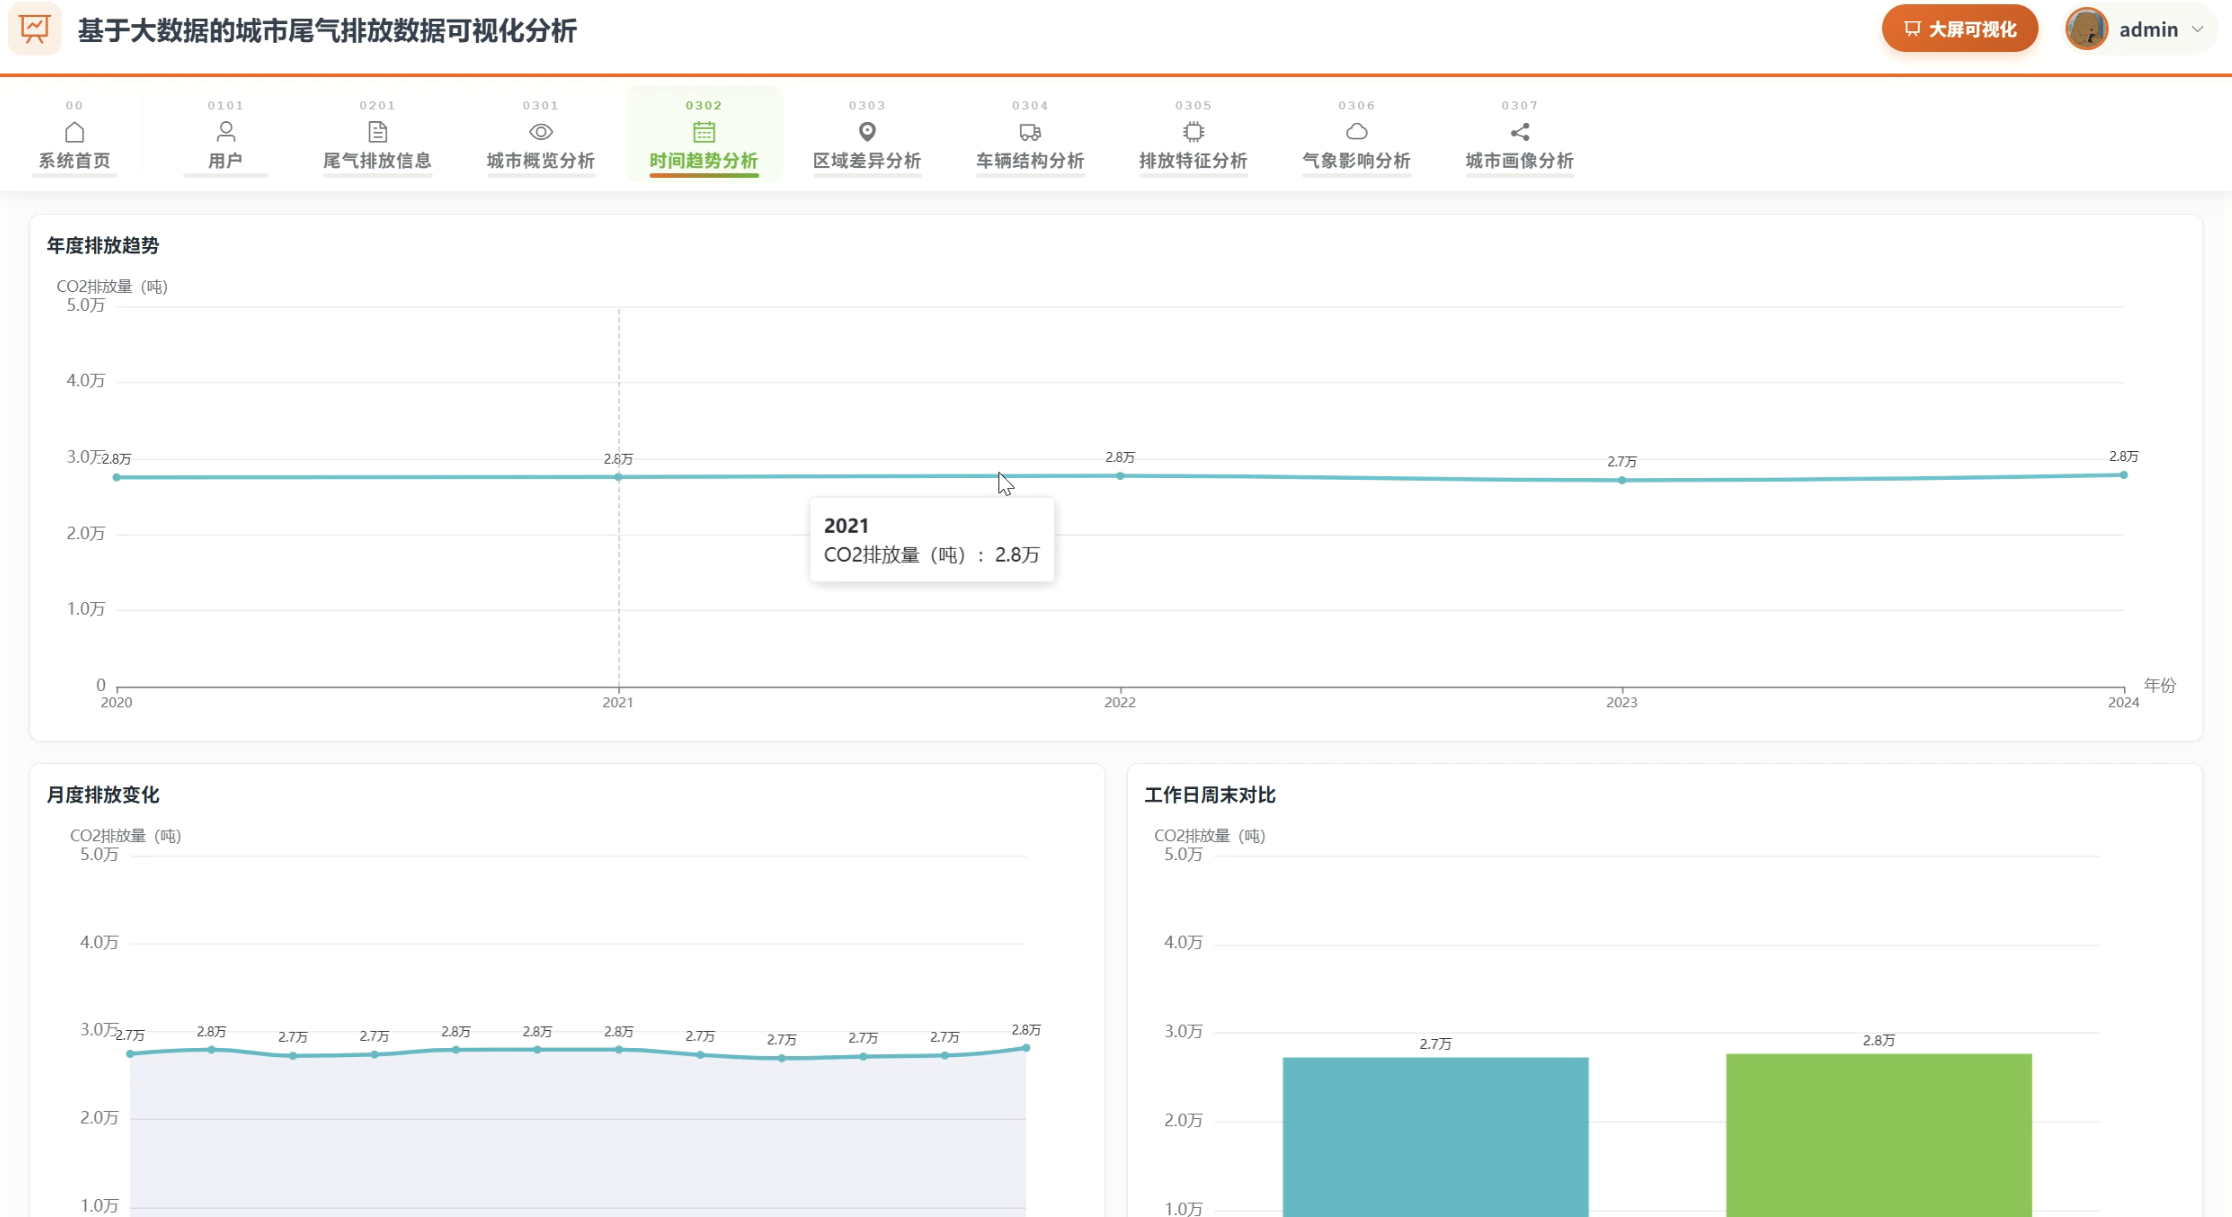
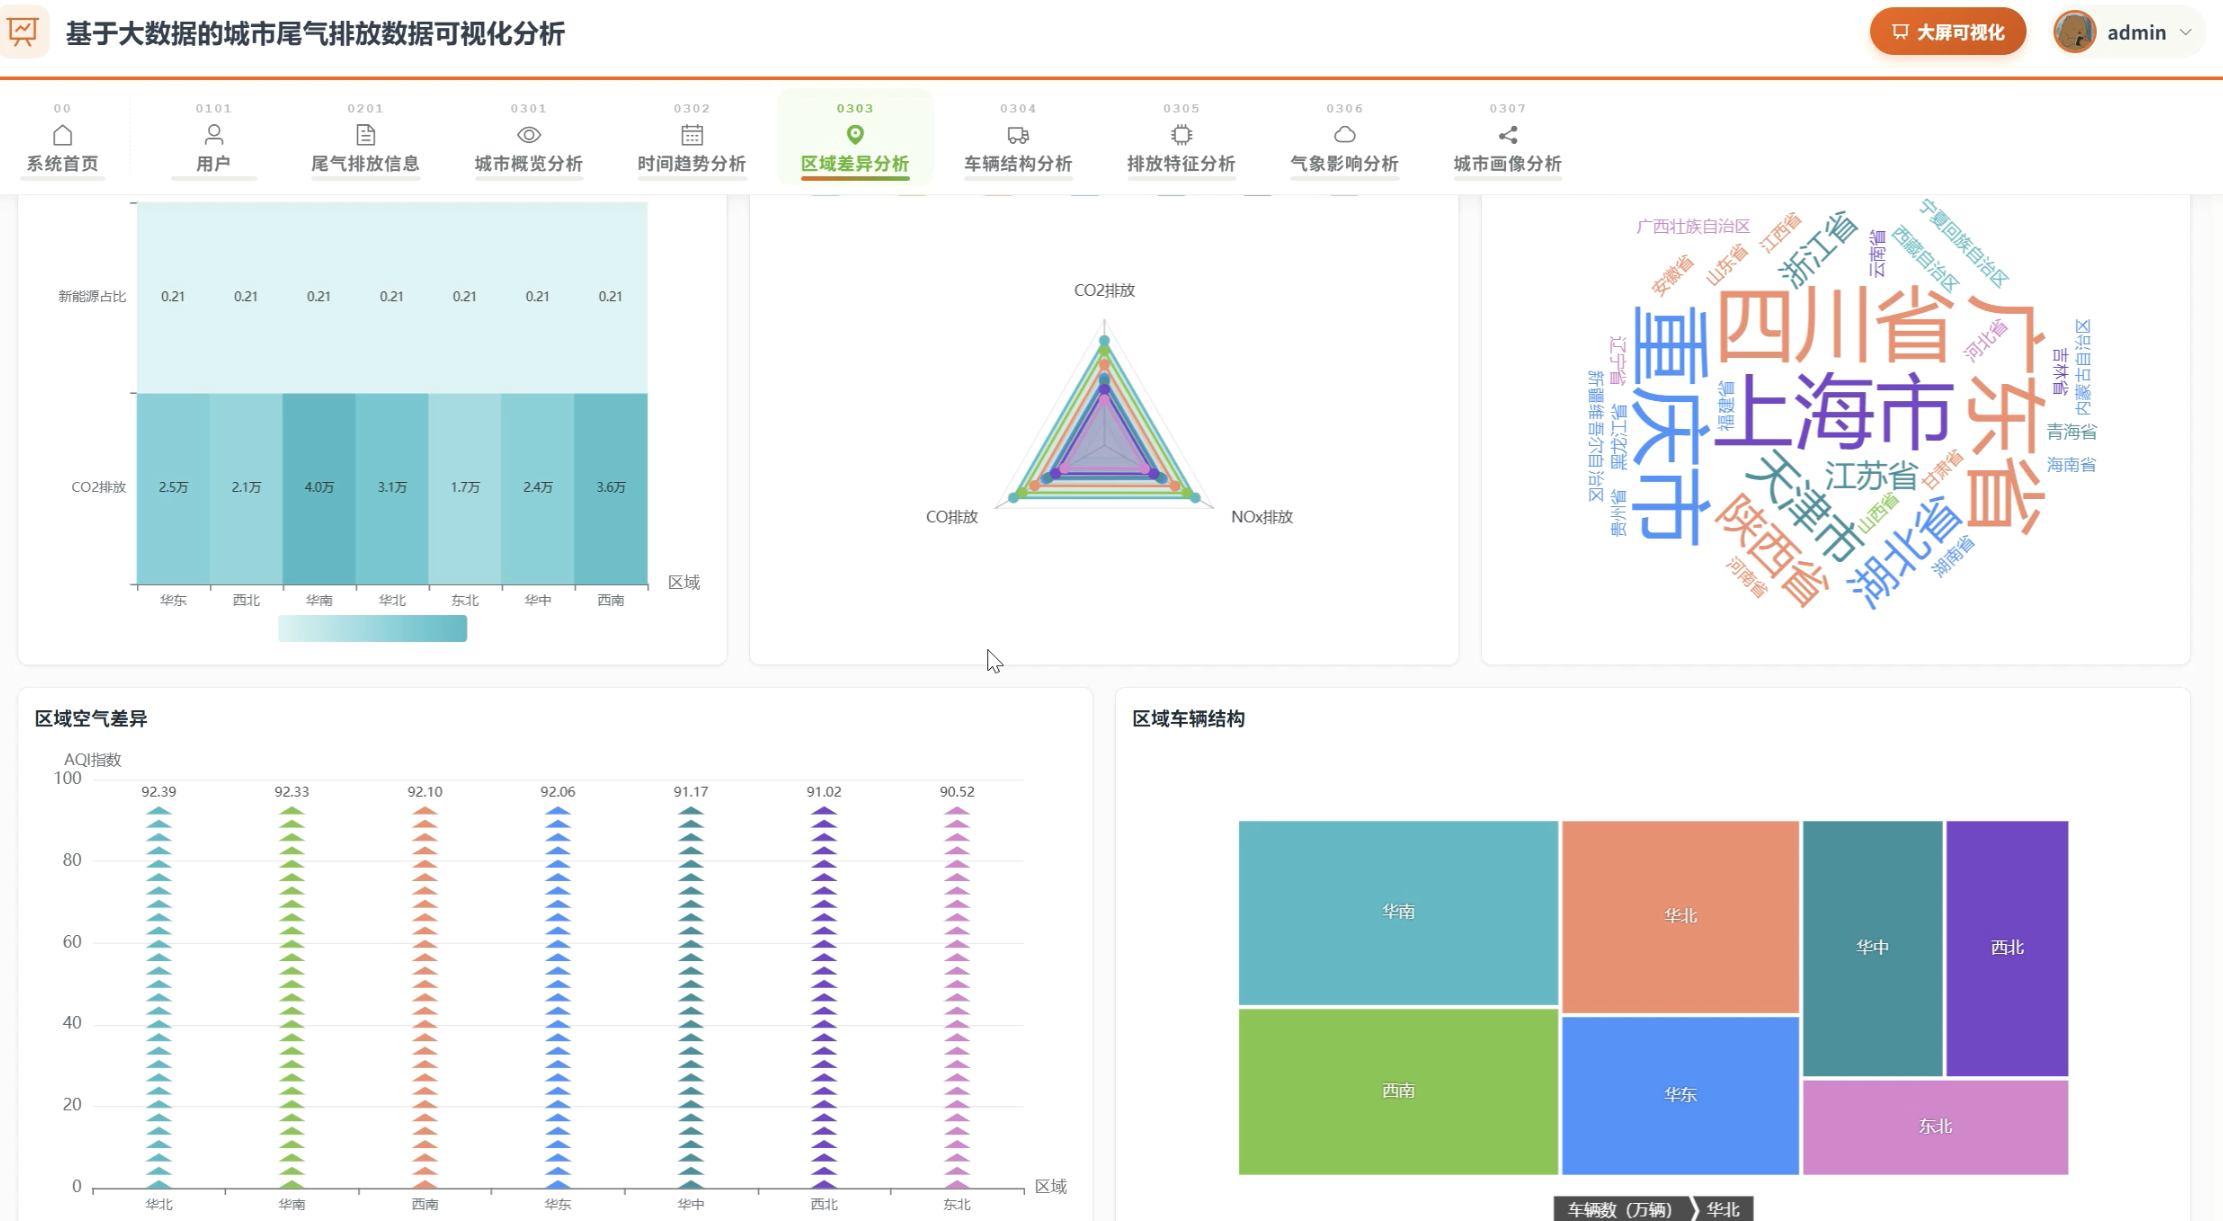
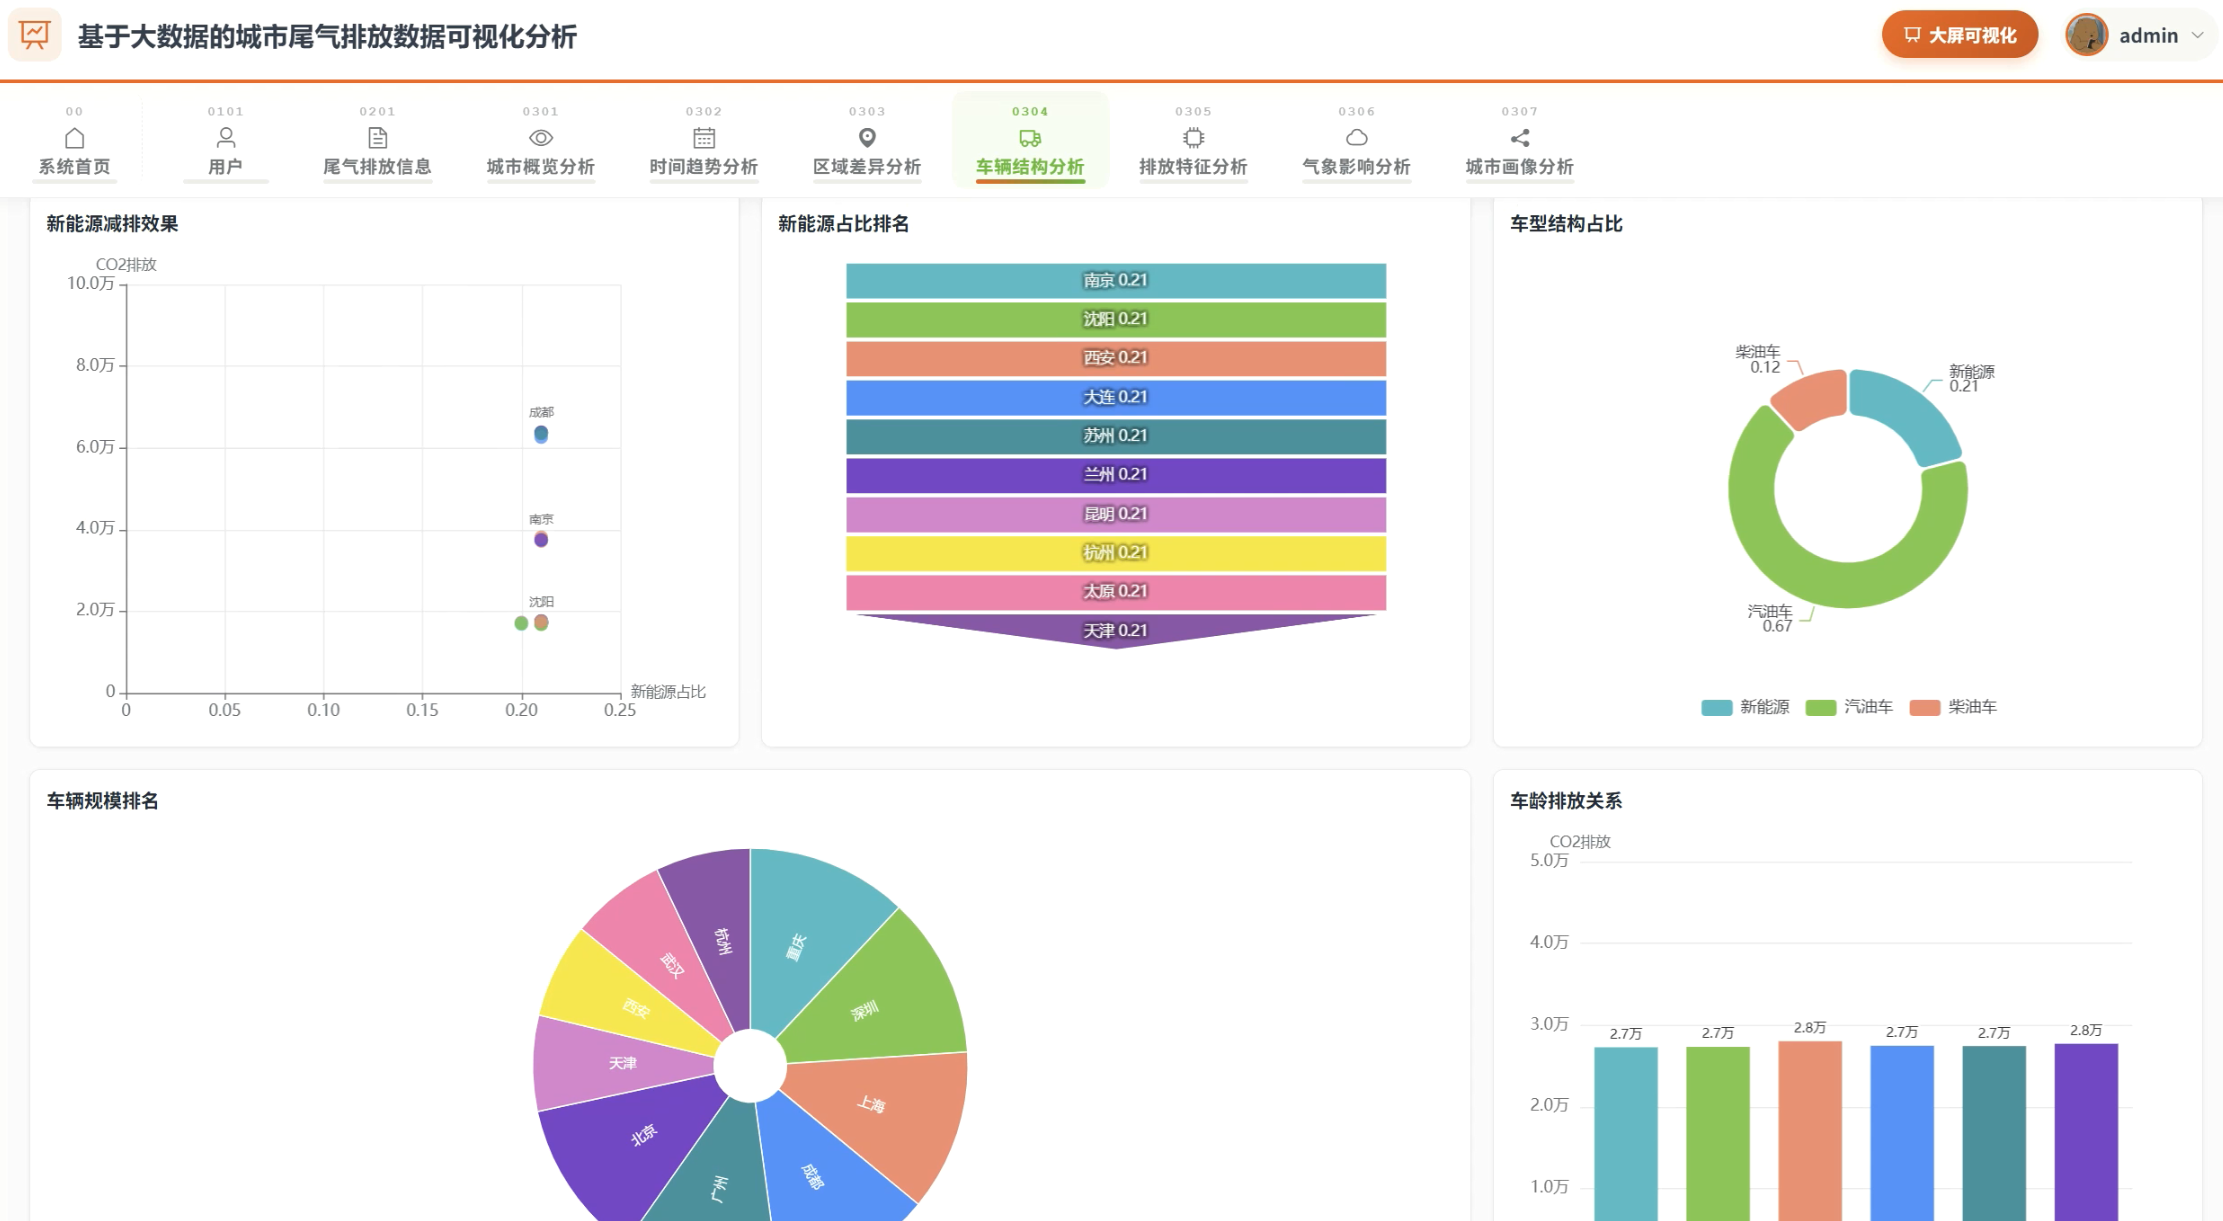
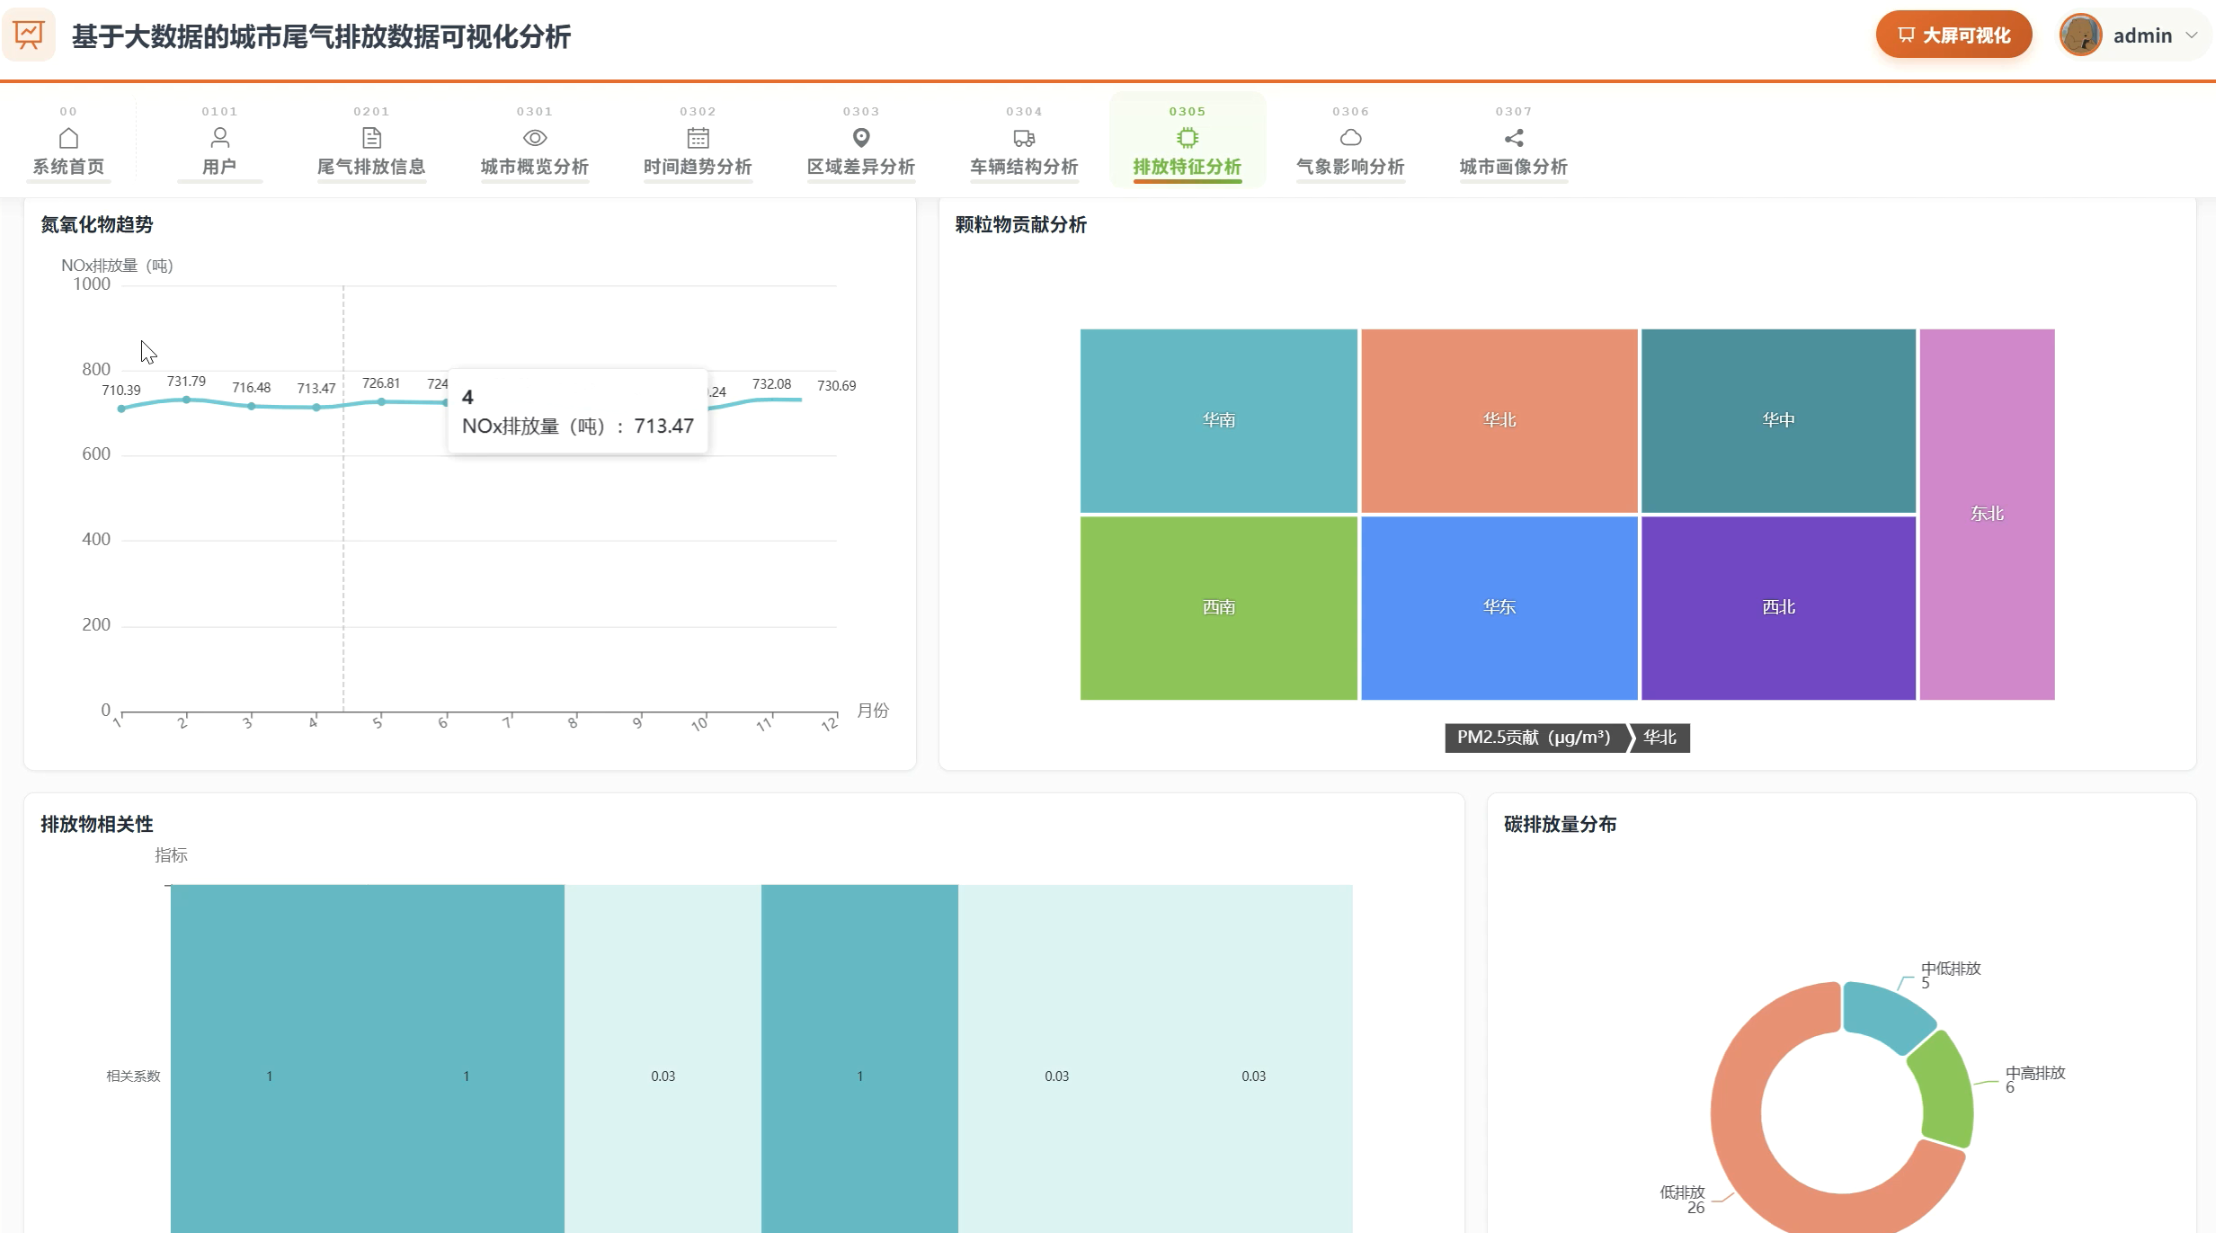
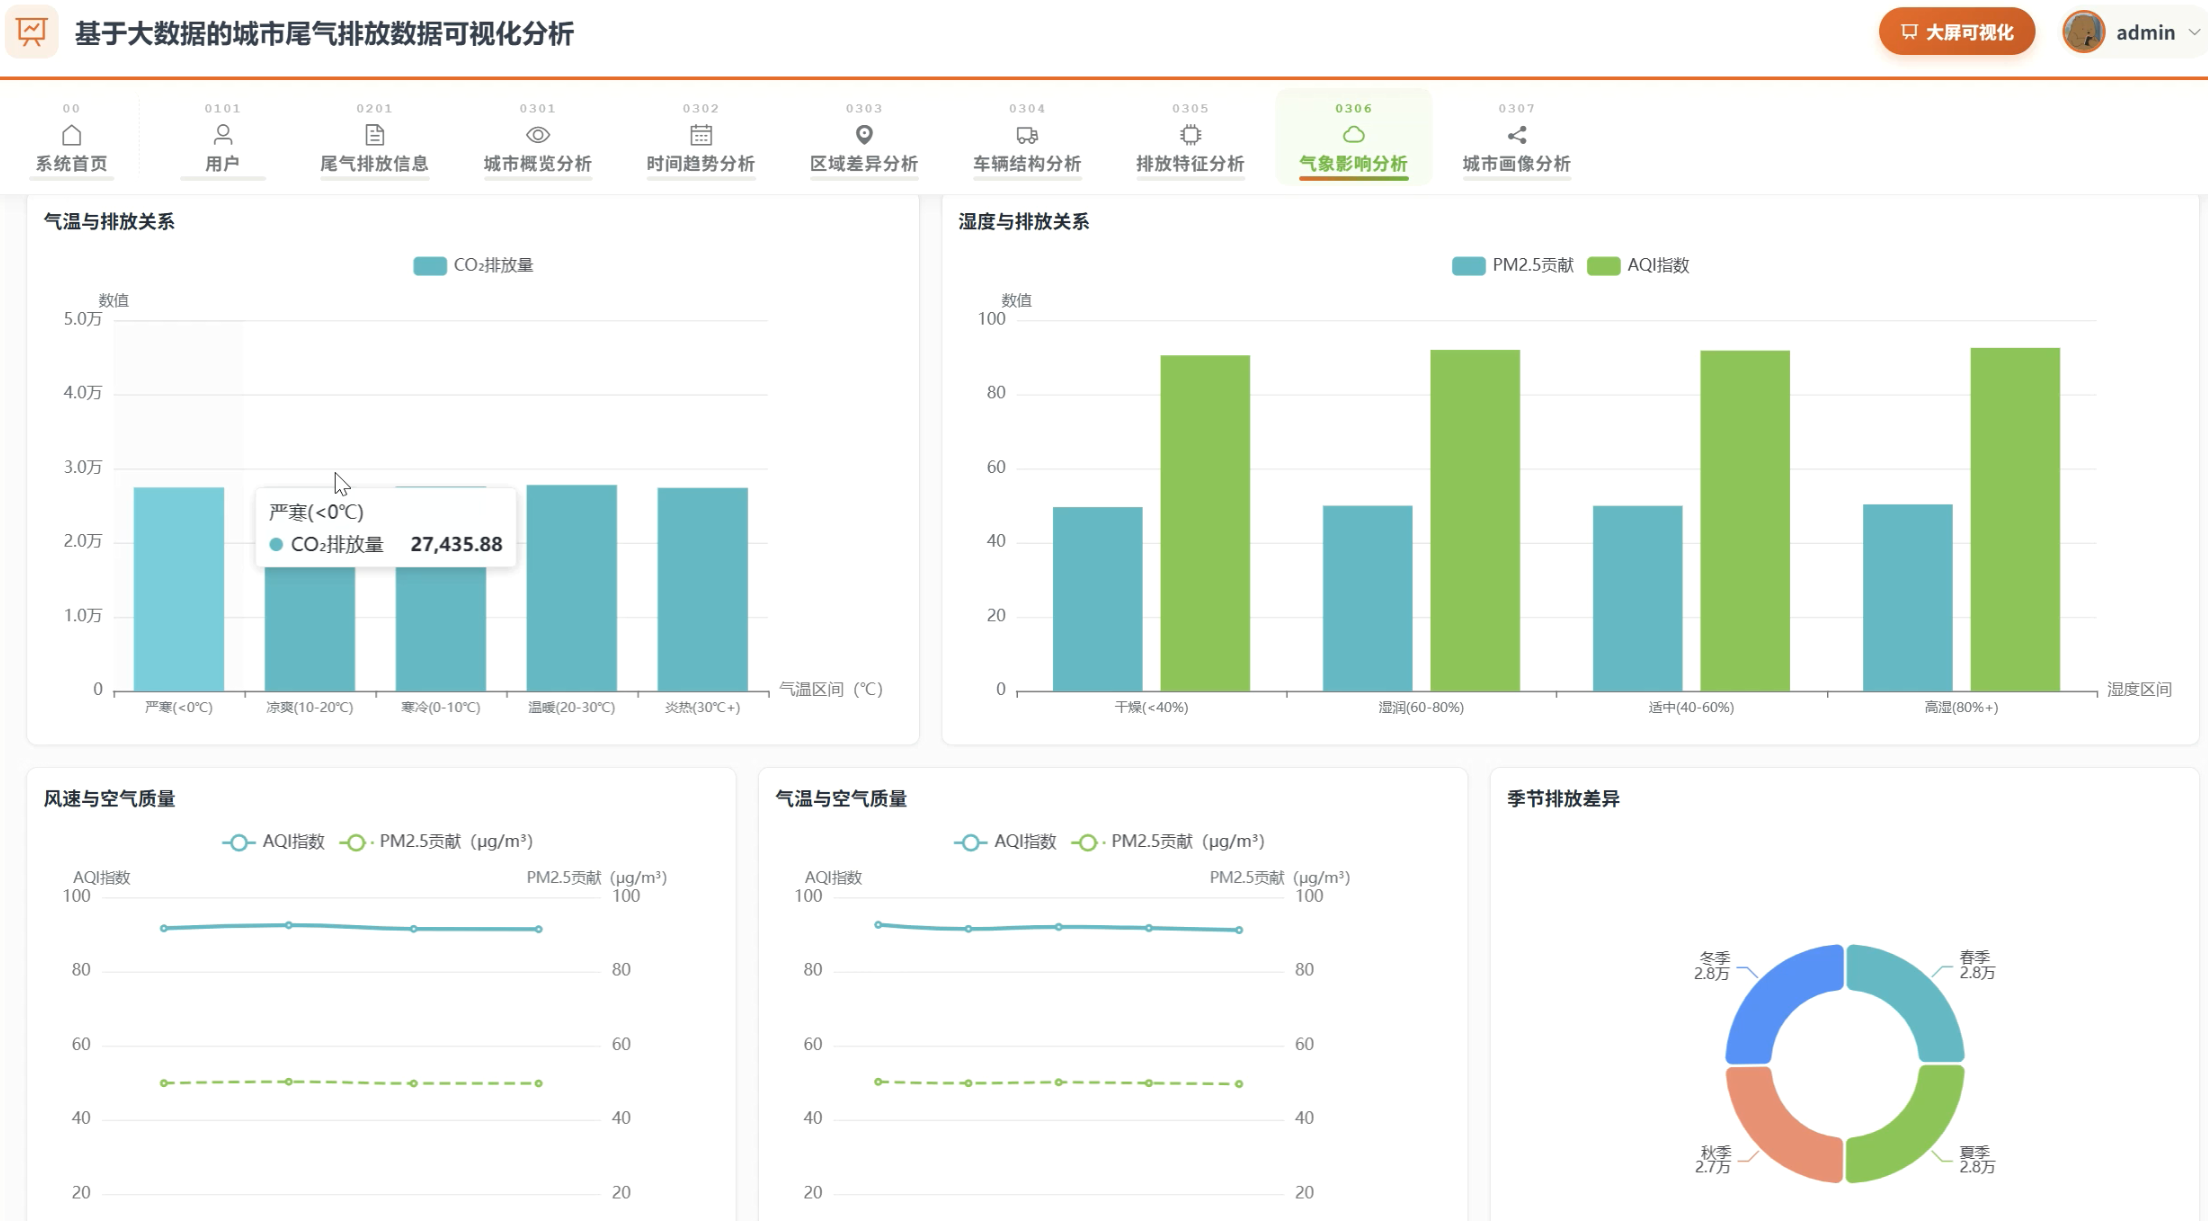
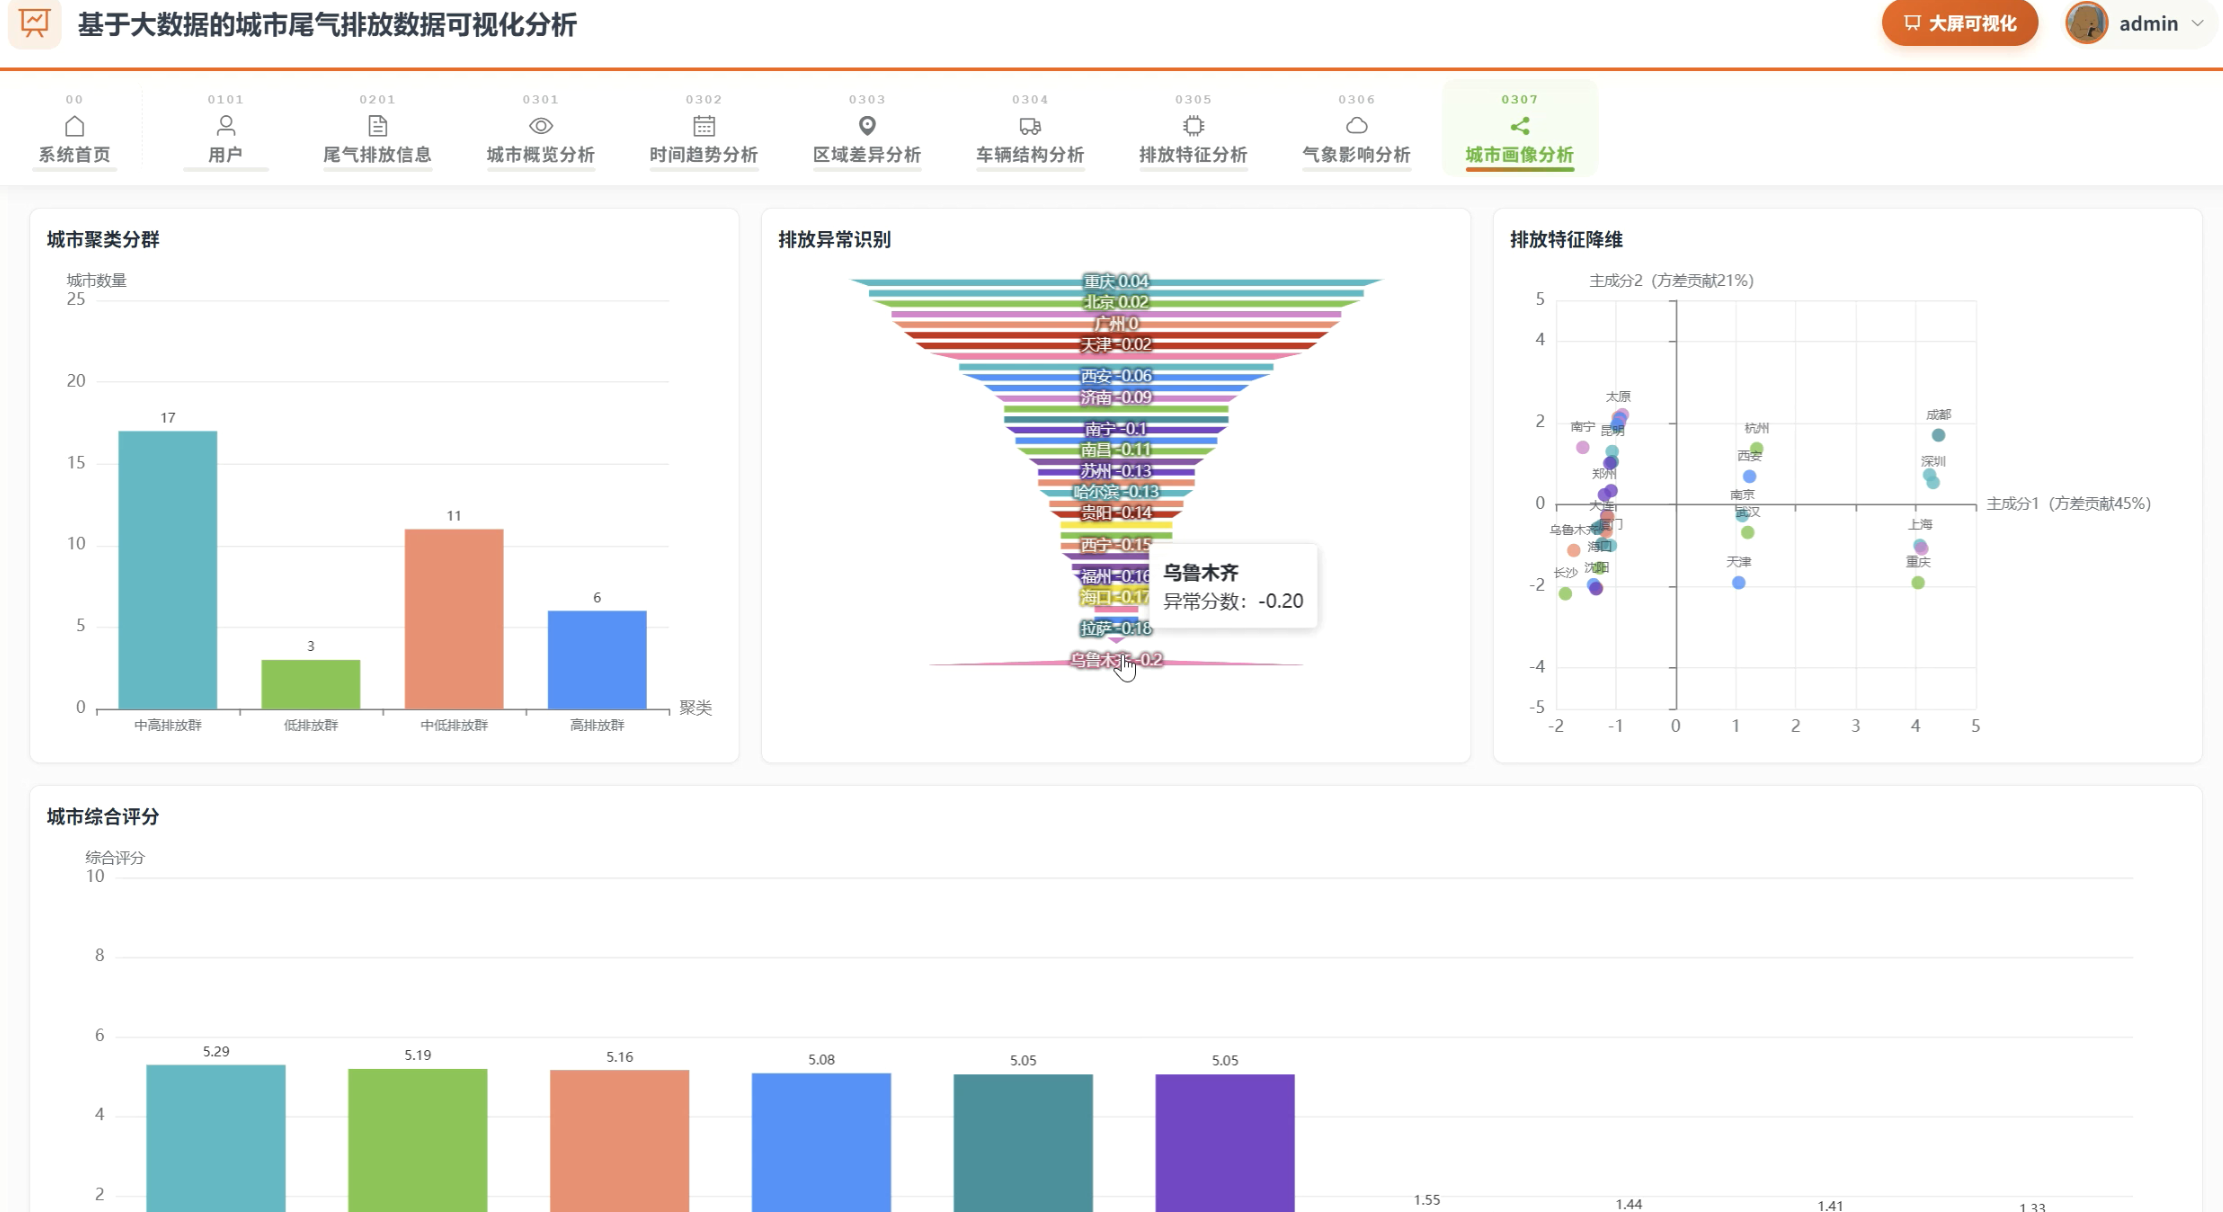
本系统采用 Hadoop、Spark 做存储与分布式聚合分析,用 Python 与 scikit-learn 做聚类和异常检测,后端为 Django,前端为 Vue 与 ECharts,结果写入 MySQL。功能上提供用户管理与尾气排放信息管理,并覆盖城市概览、时间趋势、区域差异、车辆结构、排放特征、气象影响、城市画像七类可视化分析,另配可视化大屏集中看关键结果。
经过系统测试,本系统能满足管理员维护账号与排放明细、查看七维分析与大屏总览的需求,也能满足普通用户查阅排放信息与分析结果的需求,对城市尾气相关的数据对照与毕业设计实践有参考意义。
二、视频展示
计算机毕业设计选题推荐|基于大数据的城市尾气排放数据可视化
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
- scikit-learn(K-Means、Isolation Forest、PCA)
四、系统展示
登录模块: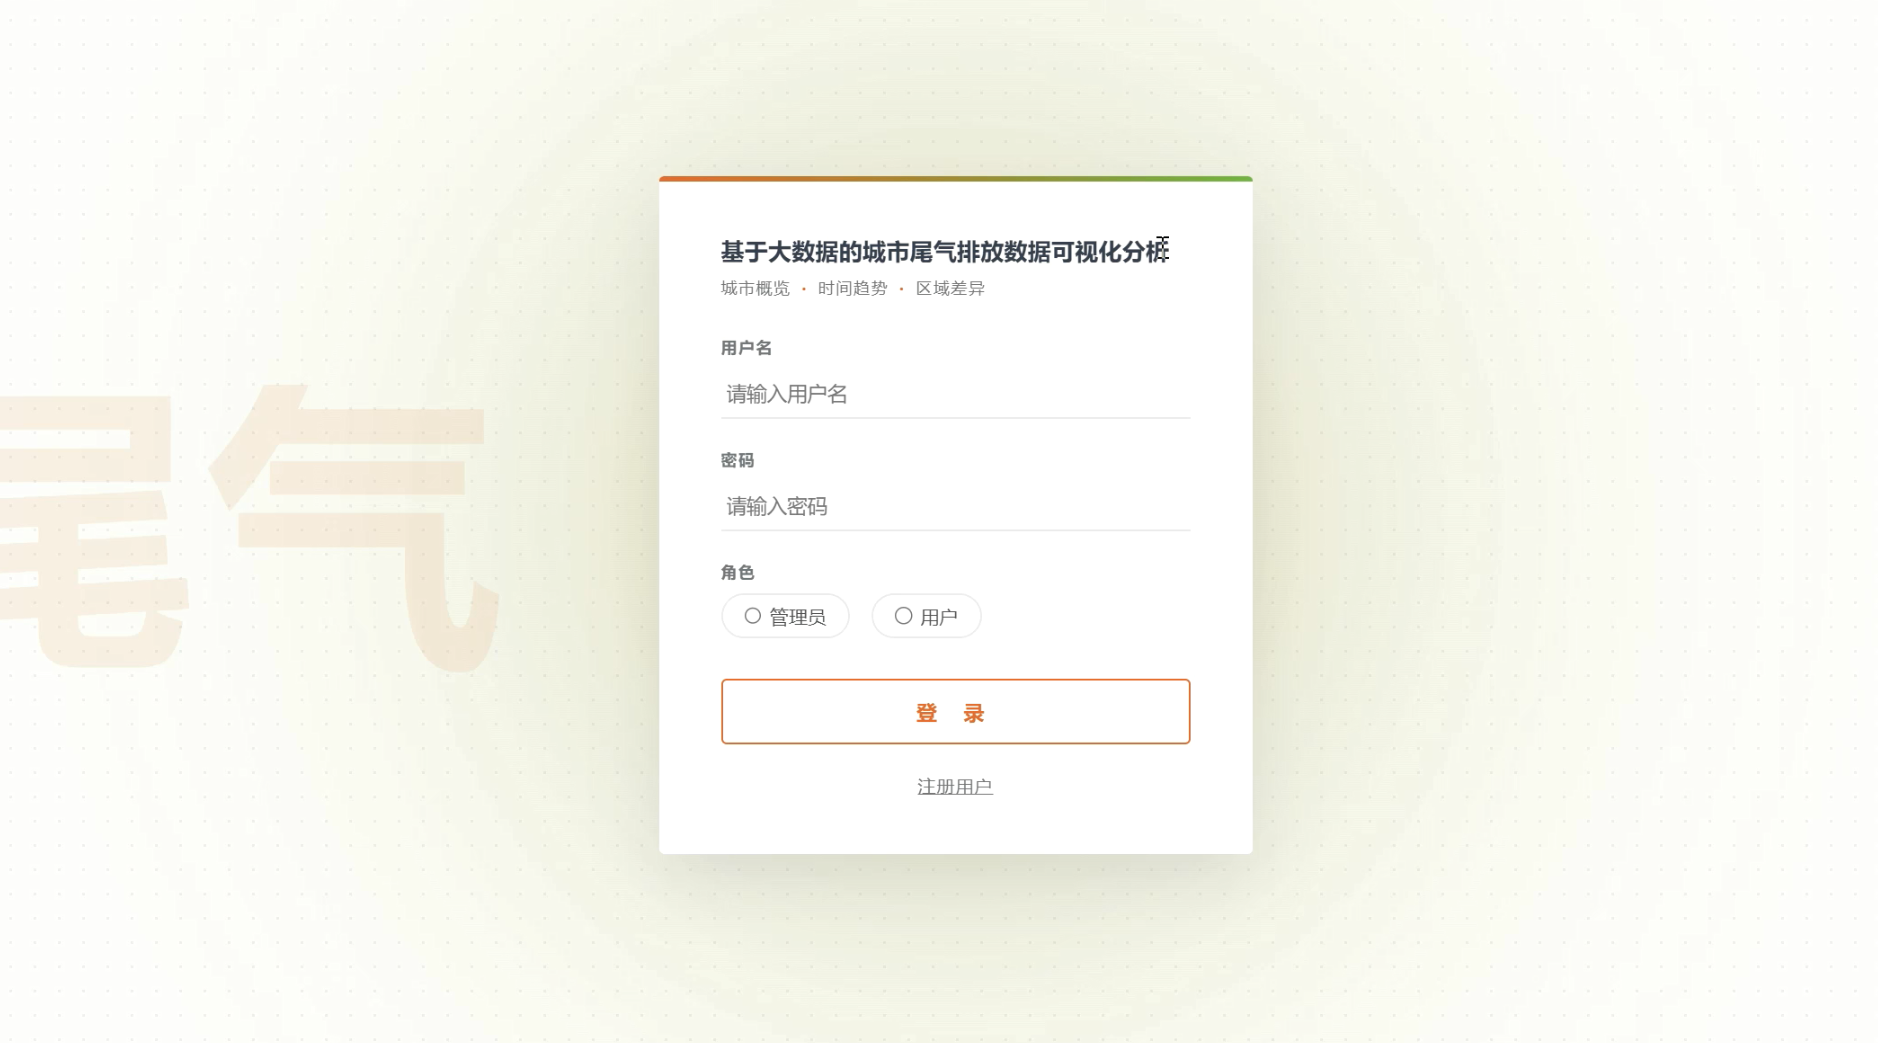
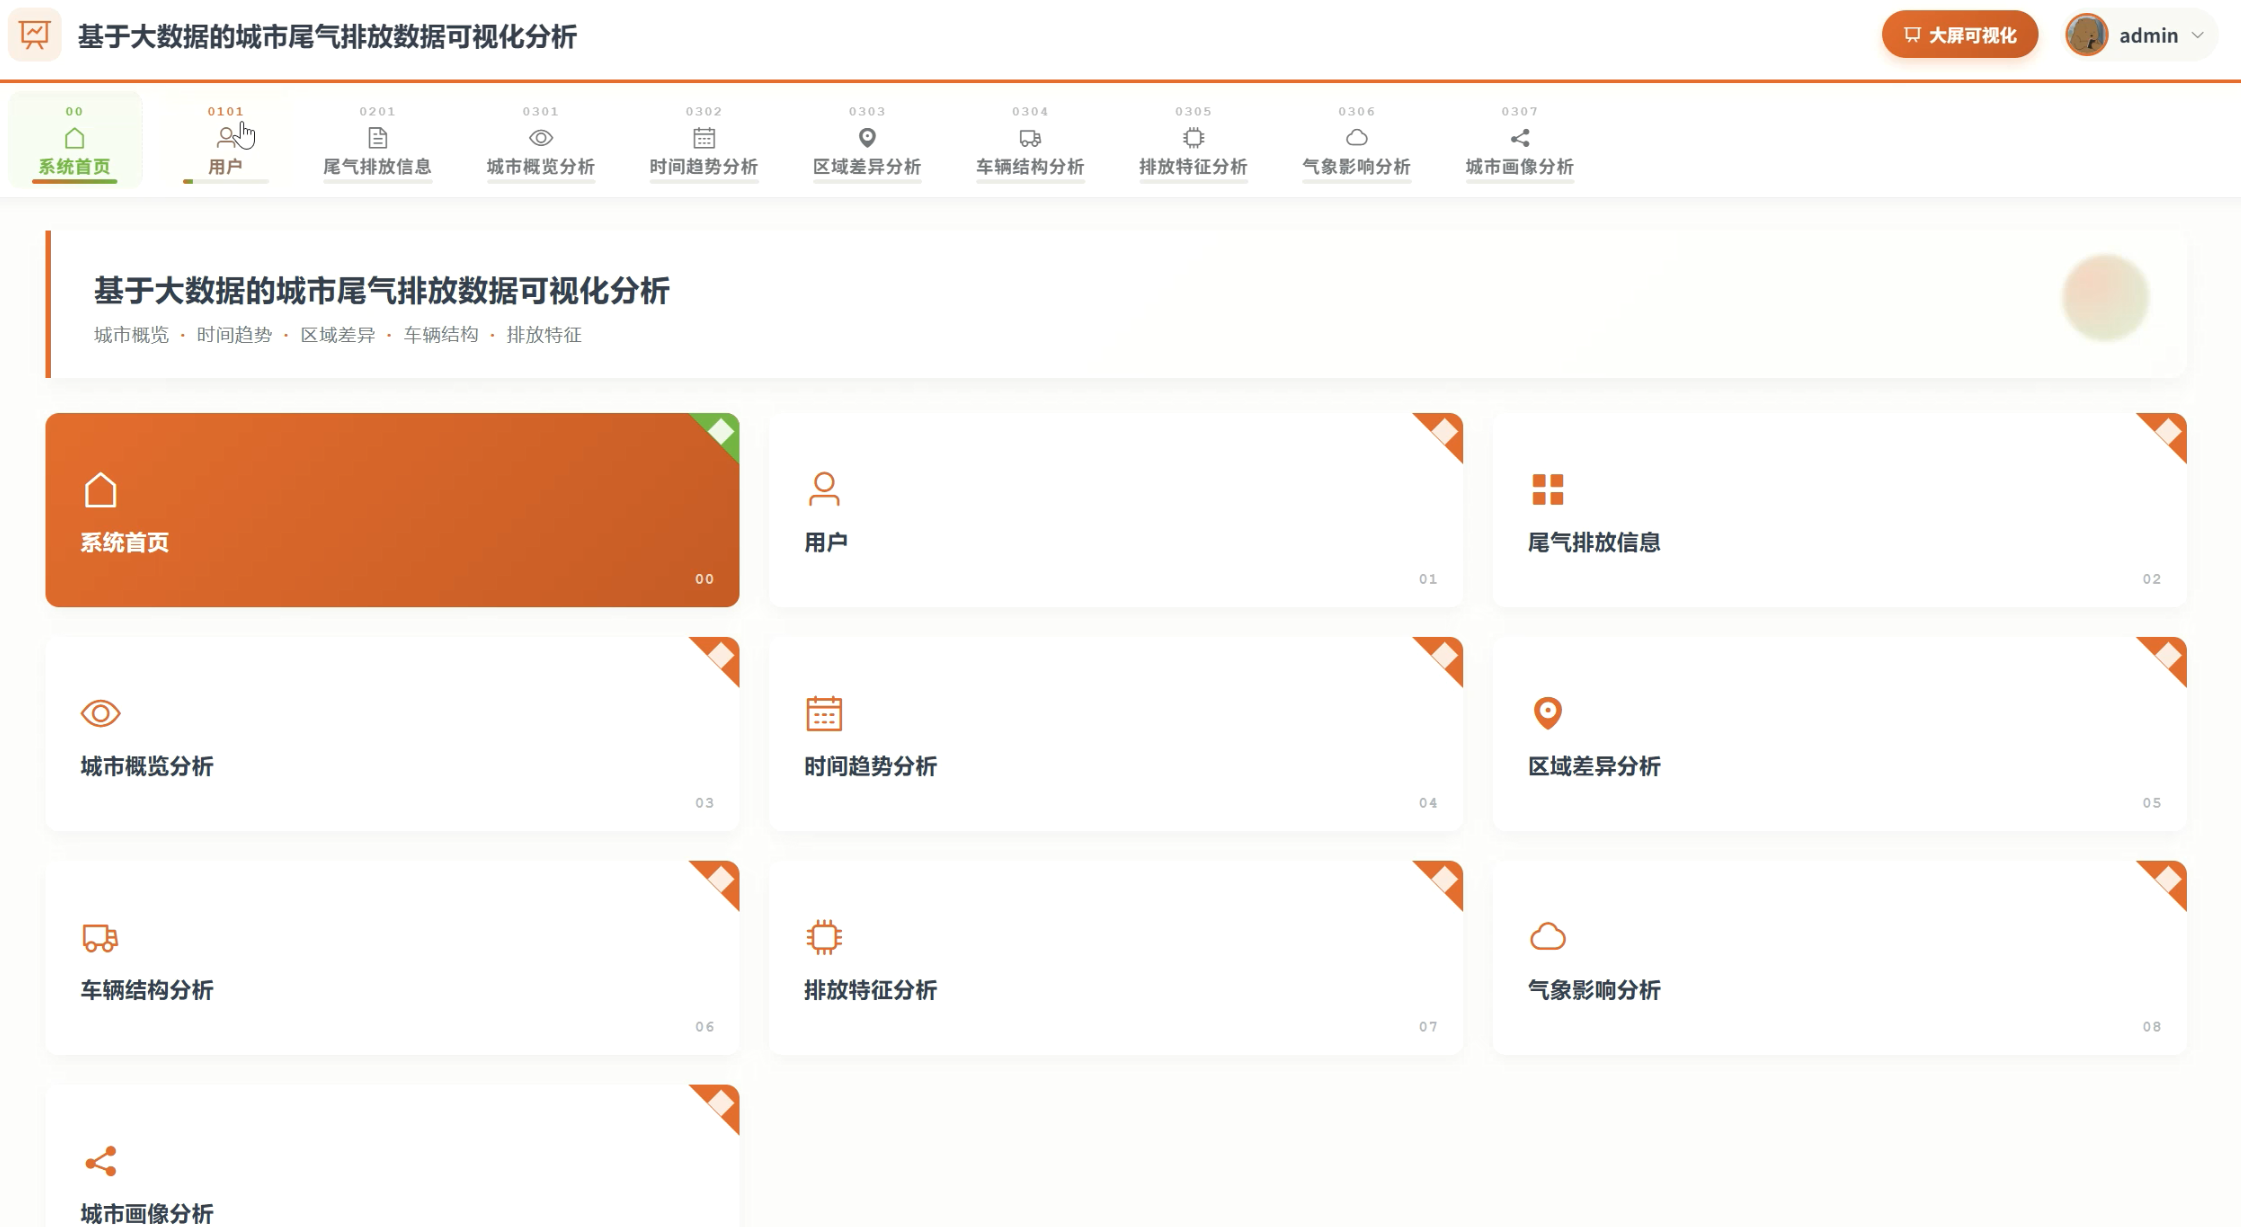
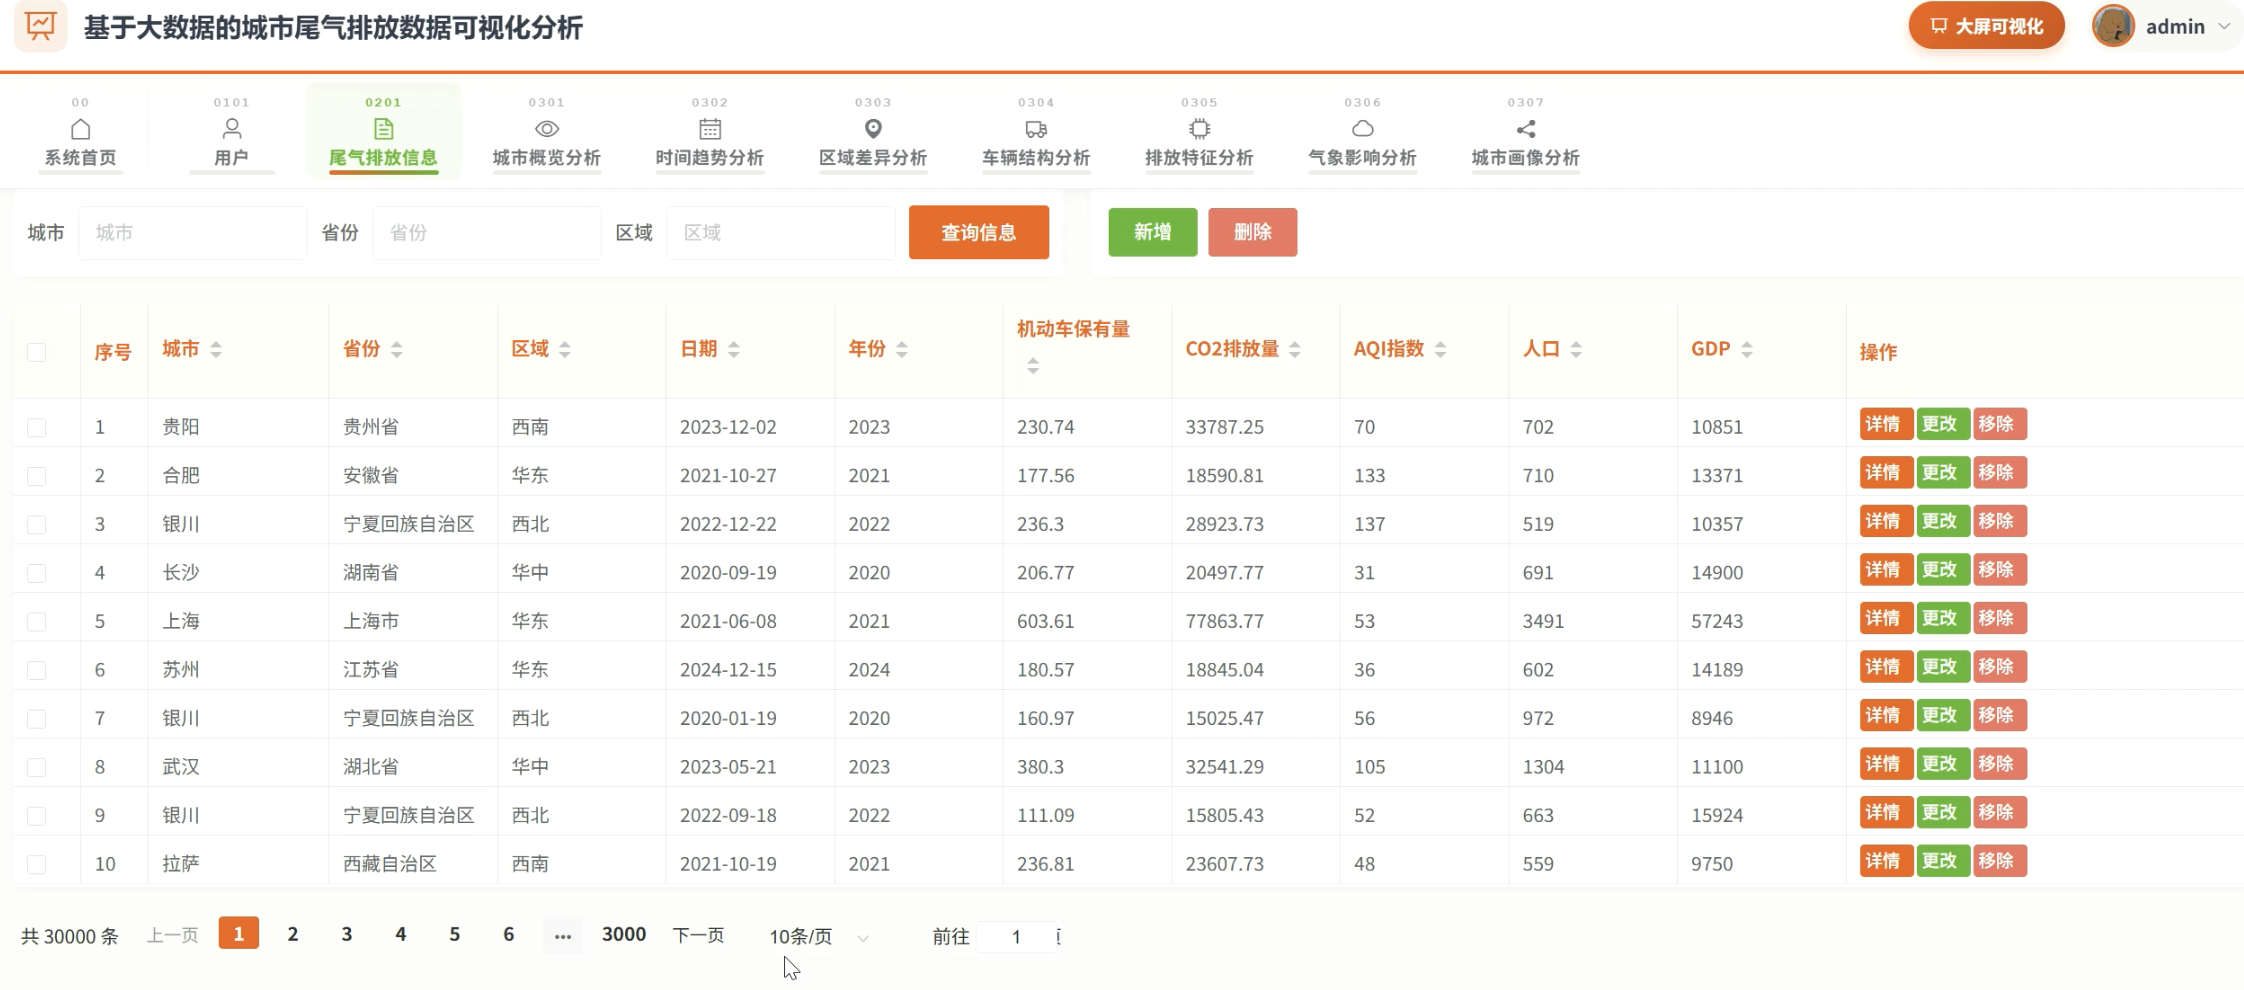
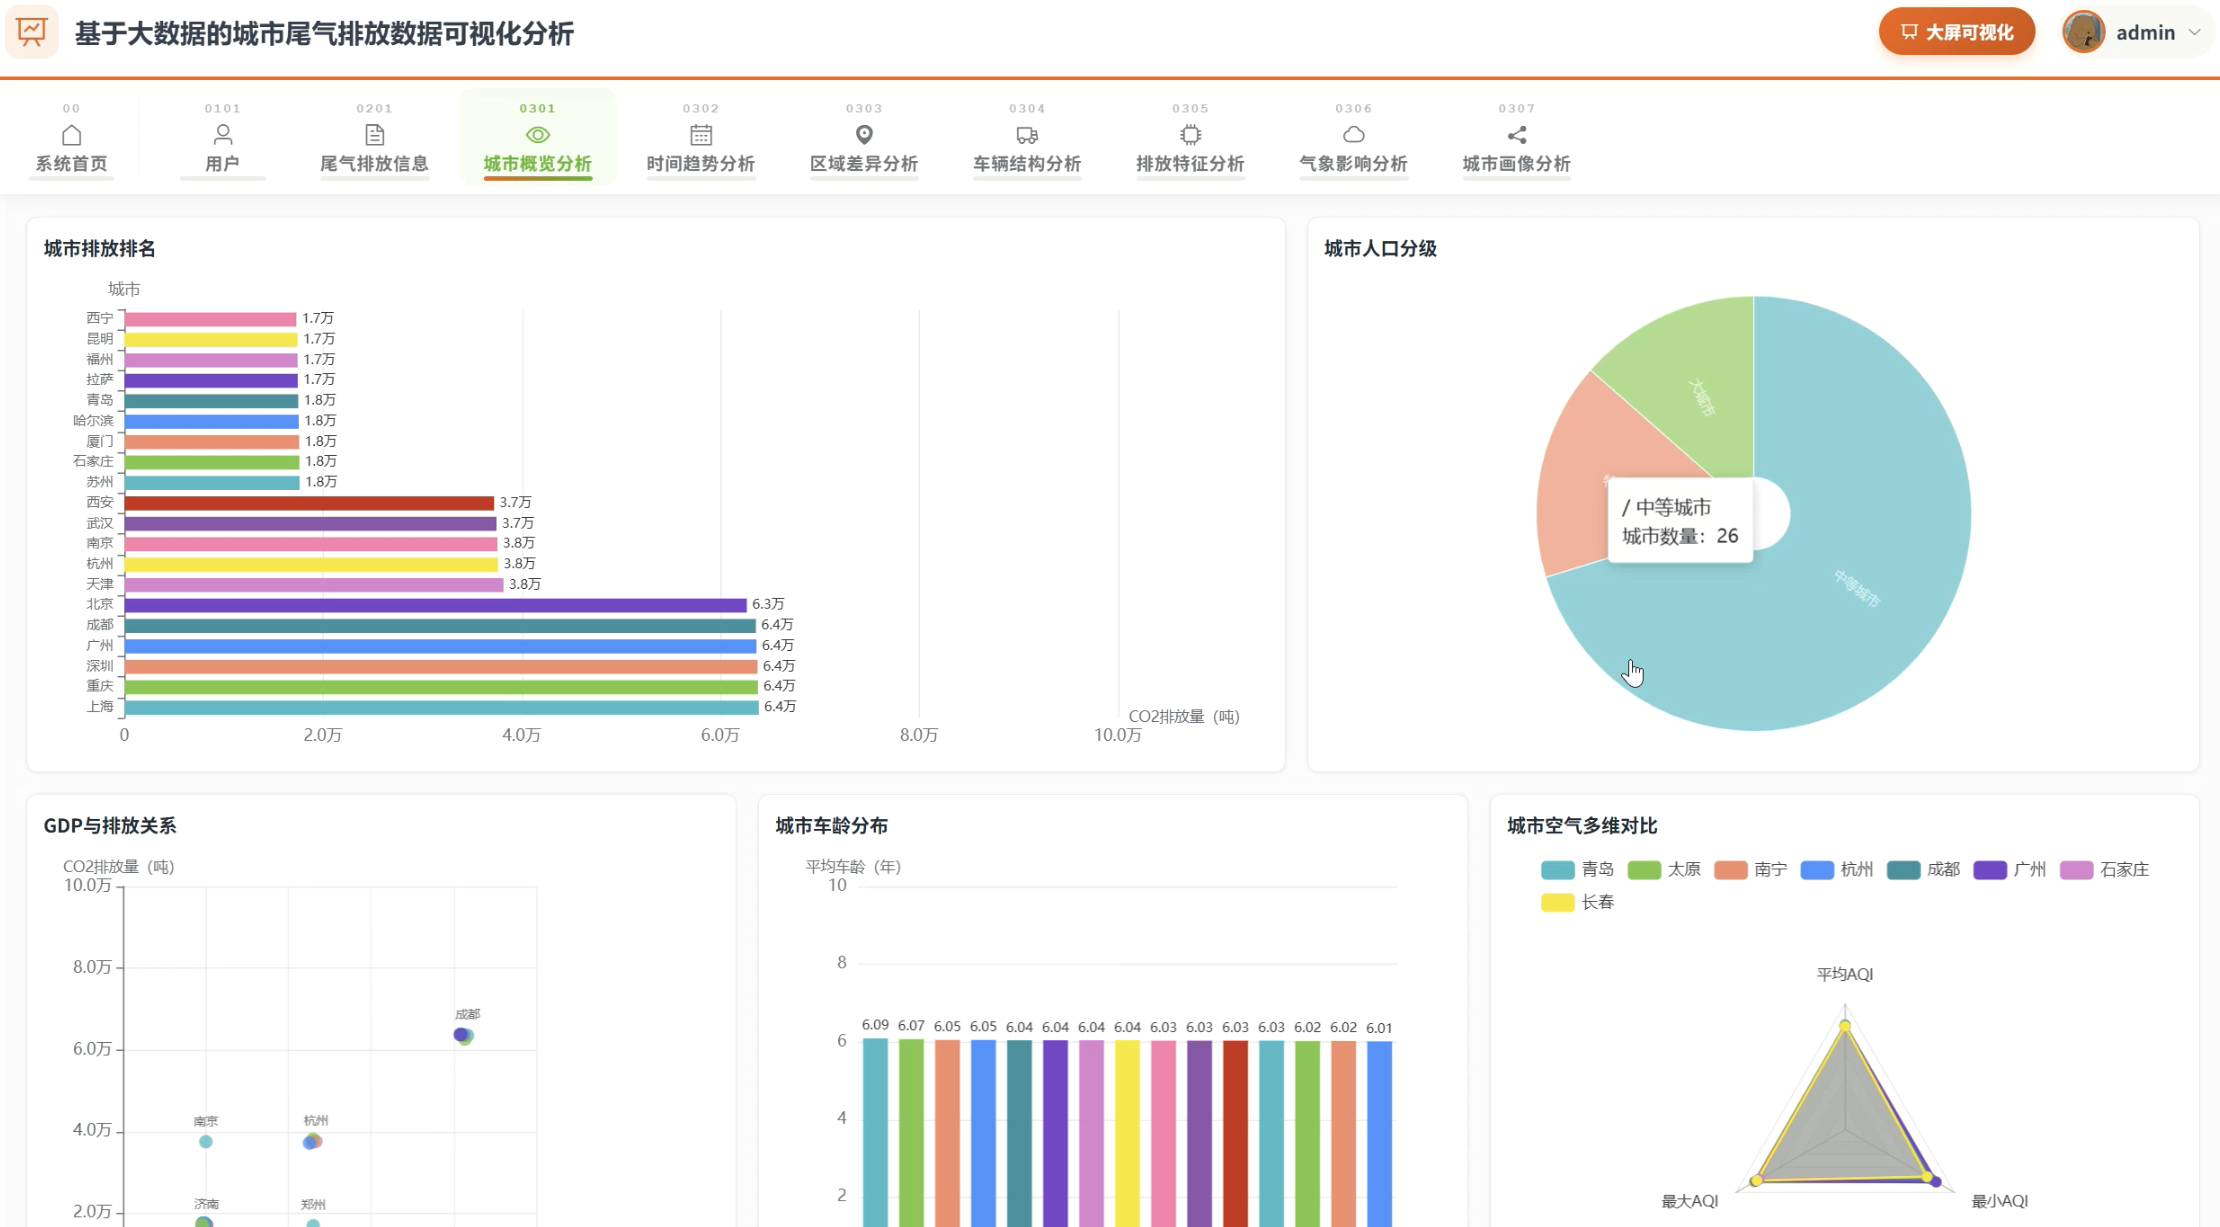

五、代码展示
# data_preprocessing.py(节选)
COLUMN_MAPPING = {
    '城市': 'city', '省份': 'province', '区域': 'region',
    'CO2排放量_吨每日': 'co2_emission', 'AQI指数': 'aqi',
    # ... 其余字段同理
}
PROVINCE_FULL_NAME_MAP = {
    '内蒙古': '内蒙古自治区', '广西': '广西壮族自治区',
    '新疆': '新疆维吾尔自治区', '西藏': '西藏自治区',
    '宁夏': '宁夏回族自治区',
}

df = pd.read_csv(local_data_path, encoding='utf-8')
df.rename(columns=COLUMN_MAPPING, inplace=True)
df['province'] = df['province'].replace(PROVINCE_FULL_NAME_MAP)
df['date'] = pd.to_datetime(df['date'], errors='coerce').dt.strftime('%Y-%m-%d')
for col_name in df.select_dtypes(include=['float64', 'float32']).columns:
    df[col_name] = df[col_name].round(2)

output_file = SCRIPT_DIR / 'output' / f'{DATASET_NAME}_preprocessed_data.csv'
df.to_csv(output_file, encoding='utf-8', index=False)
# time_trend_analysis.py(节选)
def yearly_emission_trend_analysis(input_df):
    result = input_df.groupBy('year').agg(
        spark_round(spark_avg(col('co2_emission').cast('double')), 2).alias('avg_co2_emission'),
        spark_round(spark_avg(col('co_emission').cast('double')), 2).alias('avg_co_emission'),
        spark_round(spark_avg(col('nox_emission').cast('double')), 2).alias('avg_nox_emission'),
        spark_round(spark_avg(col('pm25_contribution').cast('double')), 2).alias('avg_pm25_contribution')
    ).orderBy('year')

    output_dir = SCRIPT_DIR / 'output' / f'{ANALYSIS_TYPE}_analysis'
    output_dir.mkdir(parents=True, exist_ok=True)
    output_file = output_dir / 'yearly_emission_trend_analysis.csv'
    result.toPandas().to_csv(output_file, encoding='utf-8', index=False)
# city_profile_analysis.py(节选)
def city_cluster_analysis(input_df):
    feature_cols = ['vehicle_count', 'nev_ratio', 'avg_vehicle_age', 'co2_emission',
                    'co_emission', 'nox_emission', 'pm25_contribution', 'aqi',
                    'avg_temp', 'population', 'gdp']
    agg_exprs = [spark_round(spark_avg(col(c).cast('double')), 2).alias(c) for c in feature_cols]
    pdf = input_df.groupBy('city').agg(*agg_exprs).toPandas()

    X_scaled = StandardScaler().fit_transform(pdf[feature_cols].values.astype(float))
    kmeans = KMeans(n_clusters=4, n_init=10, random_state=42)
    pdf['cluster_id'] = kmeans.fit_predict(X_scaled)

    # 按各簇 CO2 均值升序贴业务标签
    cluster_centers = pdf.groupby('cluster_id')[feature_cols].mean()
    order = cluster_centers['co2_emission'].sort_values().index.tolist()
    label_seq = ['低排放群', '中低排放群', '中高排放群', '高排放群']
    cluster_label_map = {cid: label_seq[i] for i, cid in enumerate(order)}
    pdf['cluster_label'] = pdf['cluster_id'].map(cluster_label_map)

    pdf[['city', 'cluster_id', 'cluster_label']].to_csv(
        SCRIPT_DIR / 'output' / 'city_profile_analysis' / 'city_cluster_analysis.csv',
        encoding='utf-8', index=False)
六、项目文档展示

七、项目总结
本课题围绕城市尾气排放数据,完成了从预处理、Spark 多维分析到 Web 可视化的整套实现。系统覆盖城市概览、时间趋势、区域差异、车辆结构、排放特征、气象影响与城市画像七个分析方向,并结合 K-Means 分群、Isolation Forest 异常检测与 PCA 综合评分,把排放高低、结构差异和异常城市说清楚;前端用图表页与可视化大屏展示结果,同时提供用户与尾气排放信息管理。整体来看,系统能支撑排放数据的对照查阅与画像识别,对城市尾气治理相关的数据分析与毕业设计实践具有参考价值。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
更多推荐

 9
 0
- 0


 已为社区贡献24条内容

所有评论(0)