
数据分析毕设选题推荐【基于大数据的网络舆情情感数据分析与可视化】Spark+K-Means分群实战
精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
一、项目介绍
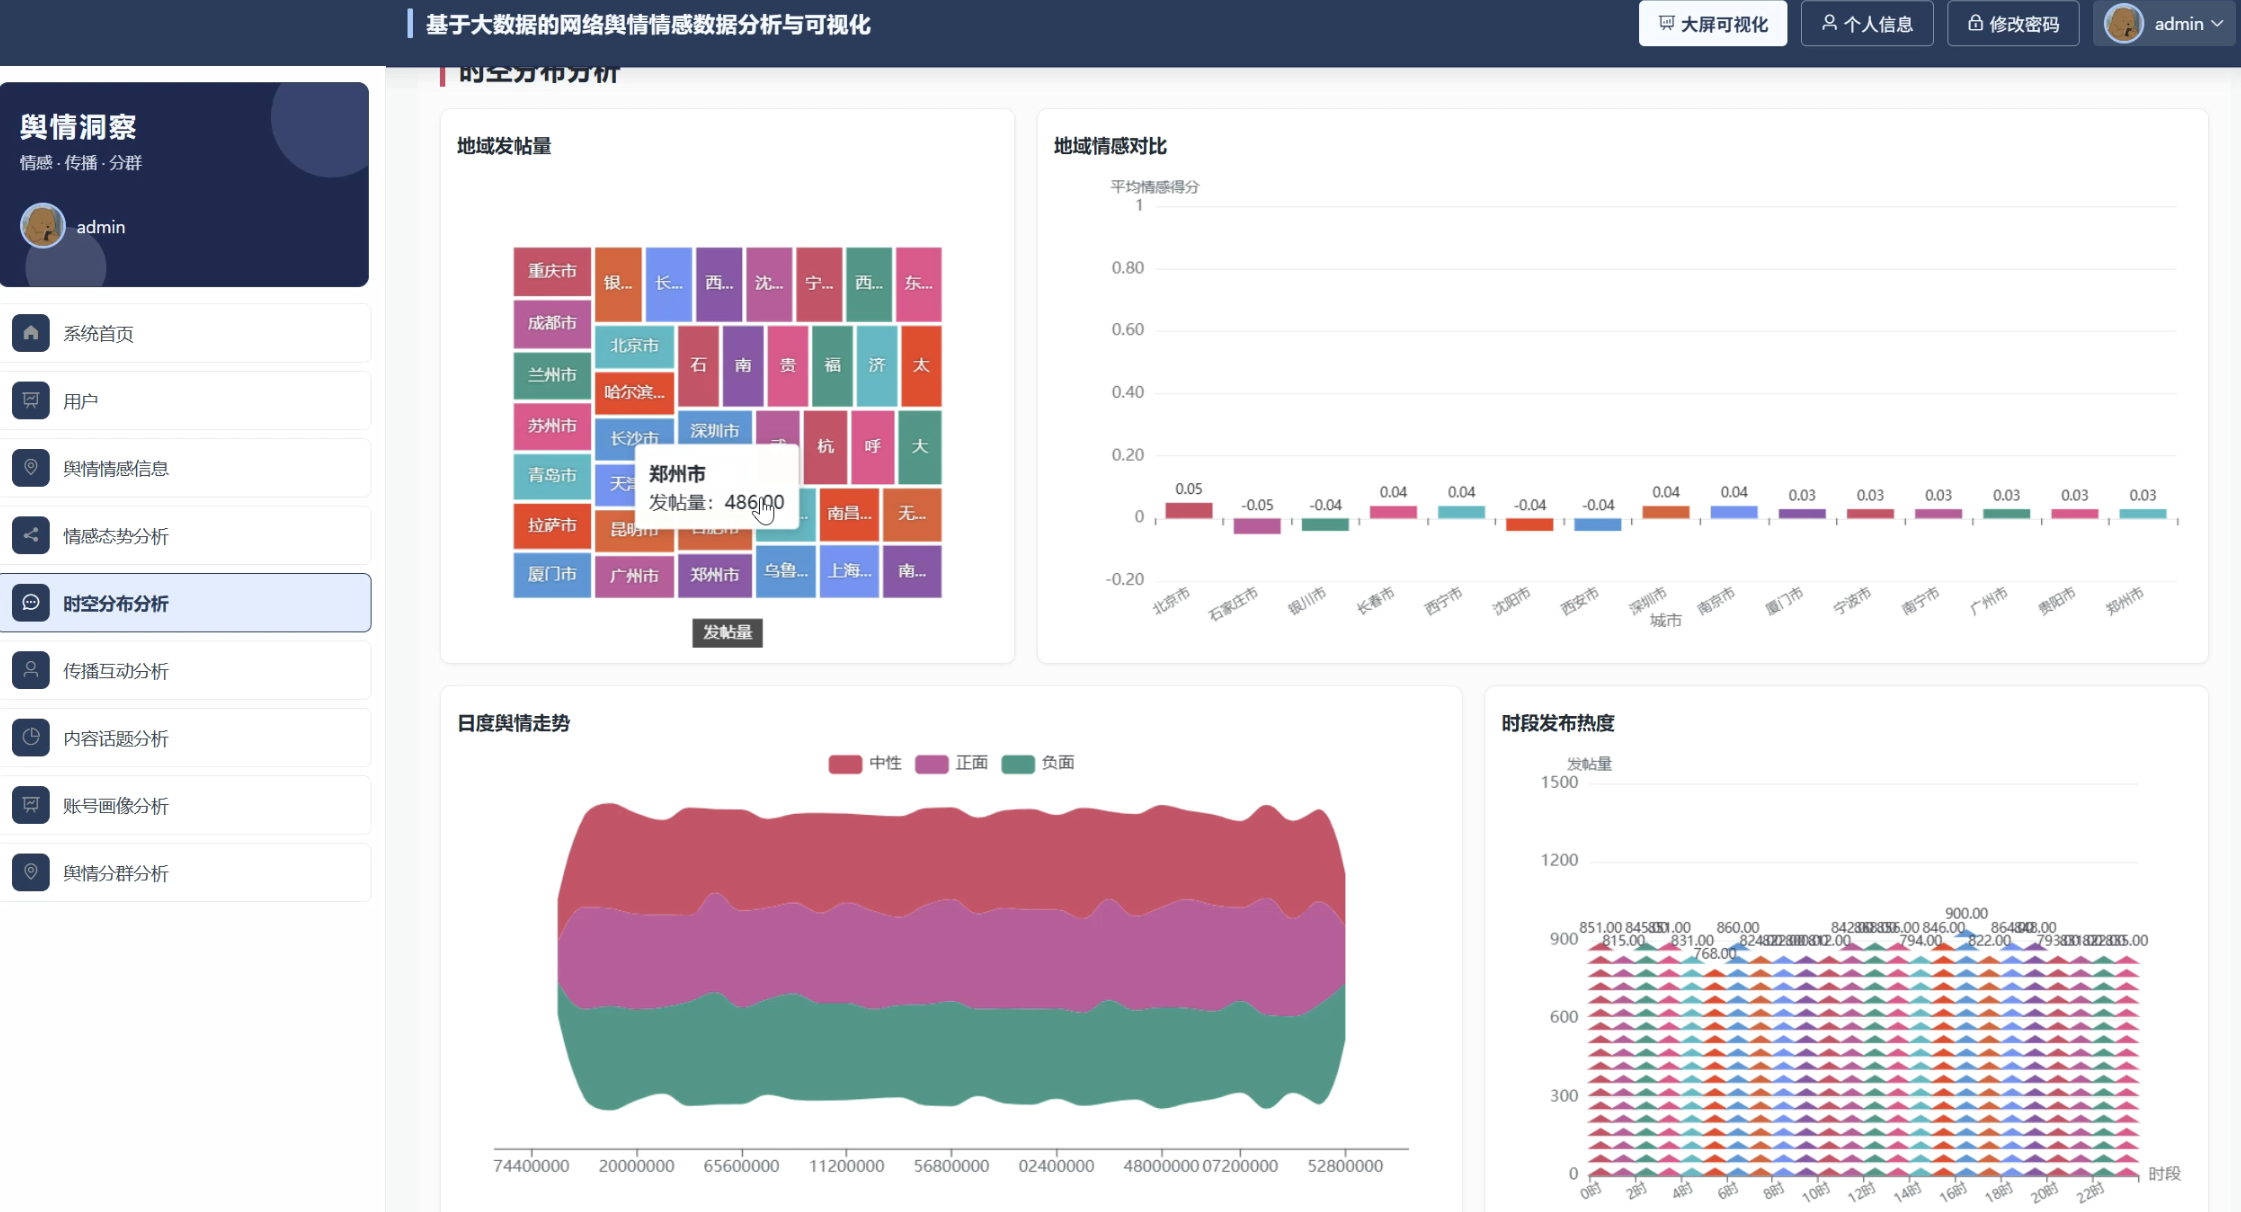
网络舆情体量一直在涨,情感走向又容易被零散评论带偏,人工翻帖很难把地域差异、传播热度和账号画像串成一条研判链路,选题和业务侧其实都缺一个能把舆情情感数据吃透并可视化的系统。本文通过开发一个基于大数据的网络舆情情感数据分析与可视化系统,用以帮助解决舆情情感态势难量化、传播与分群难一眼看清的问题。
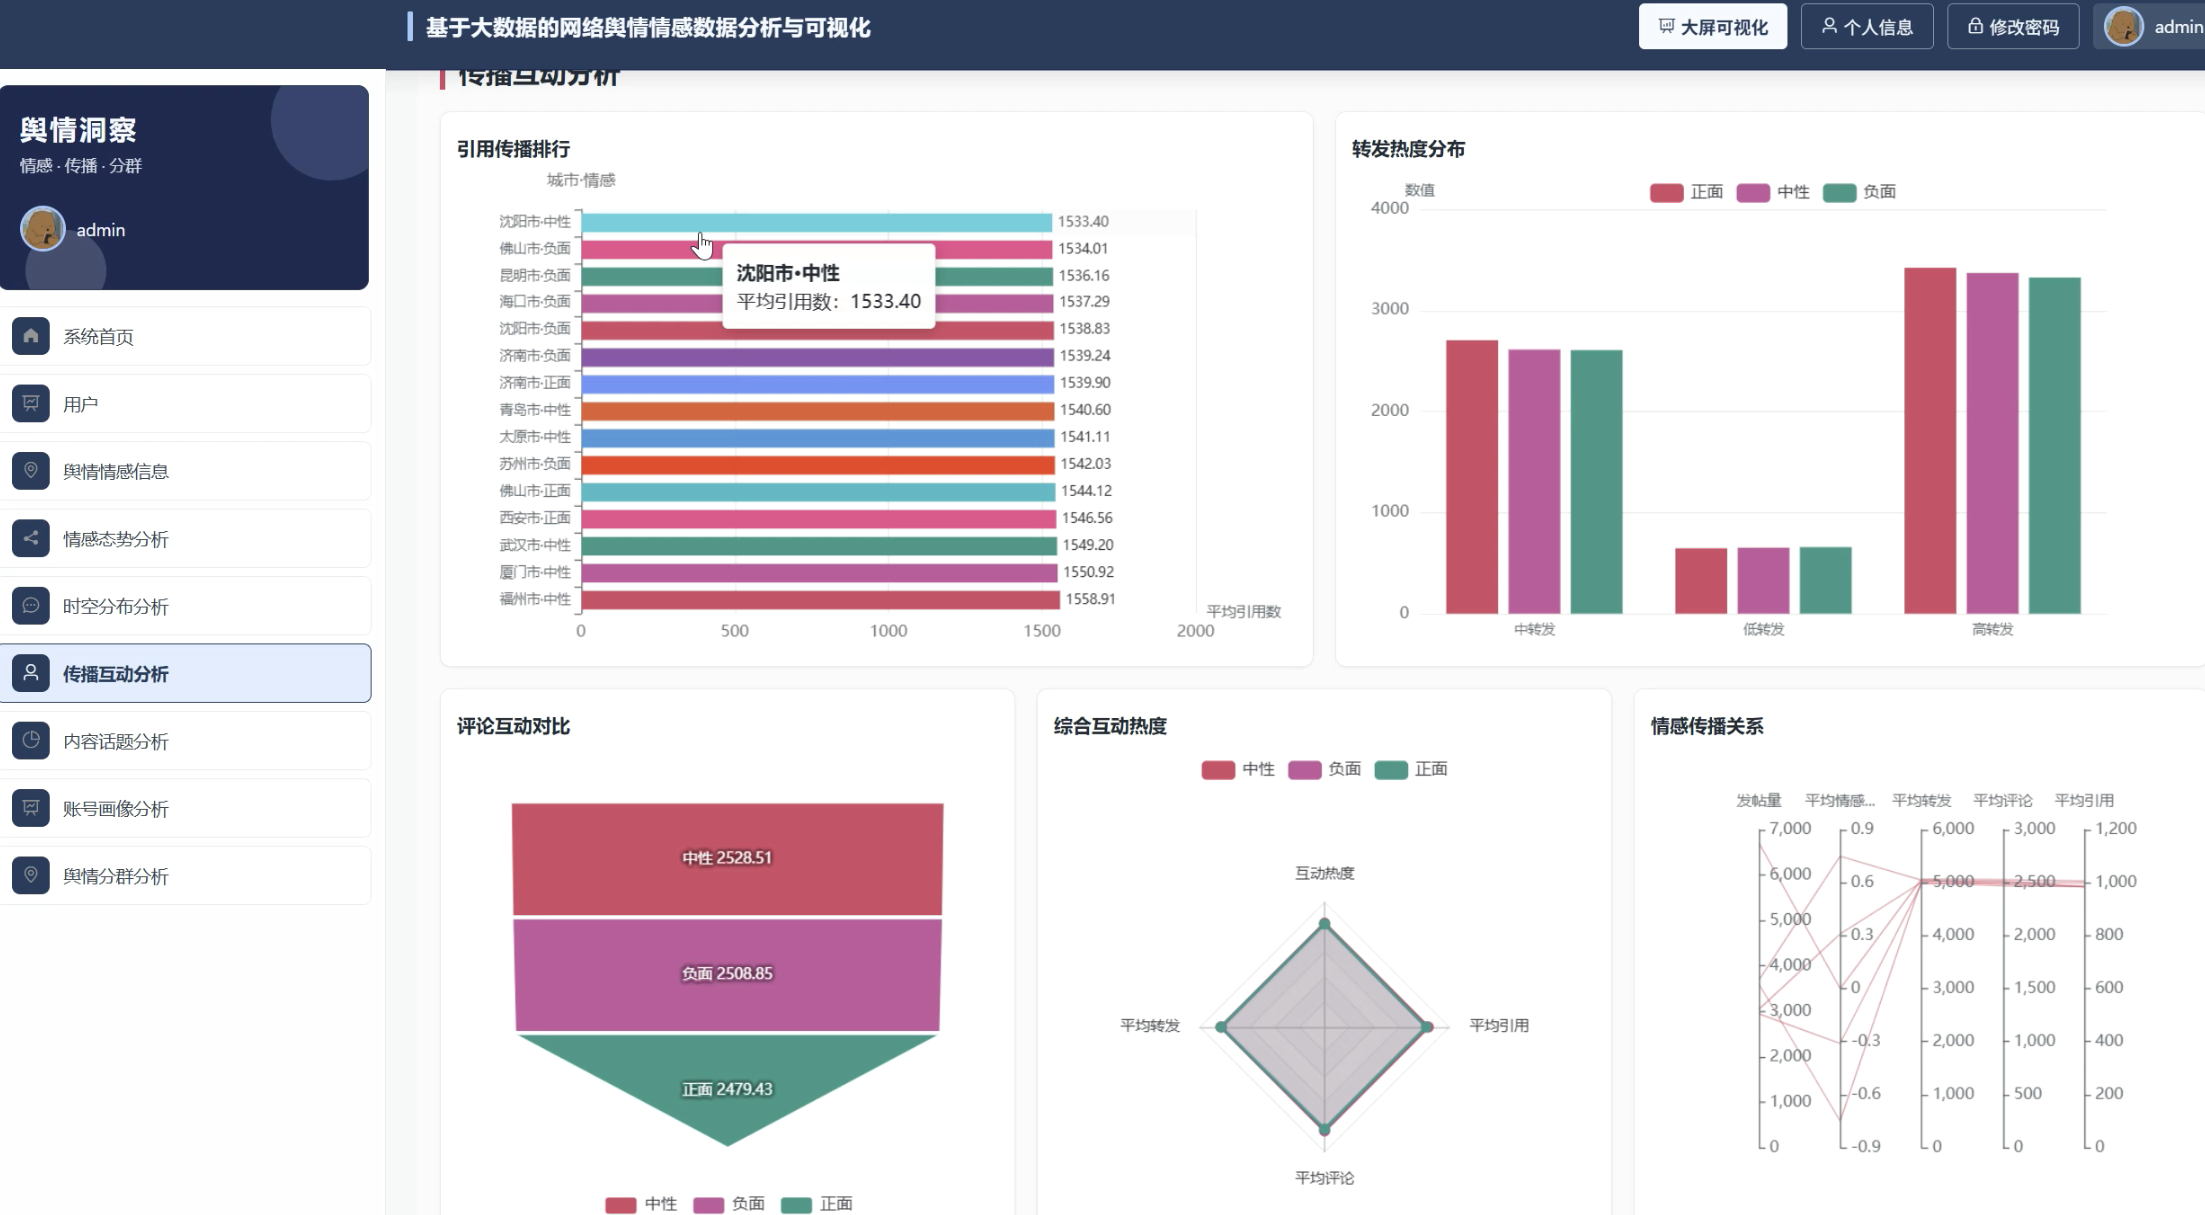
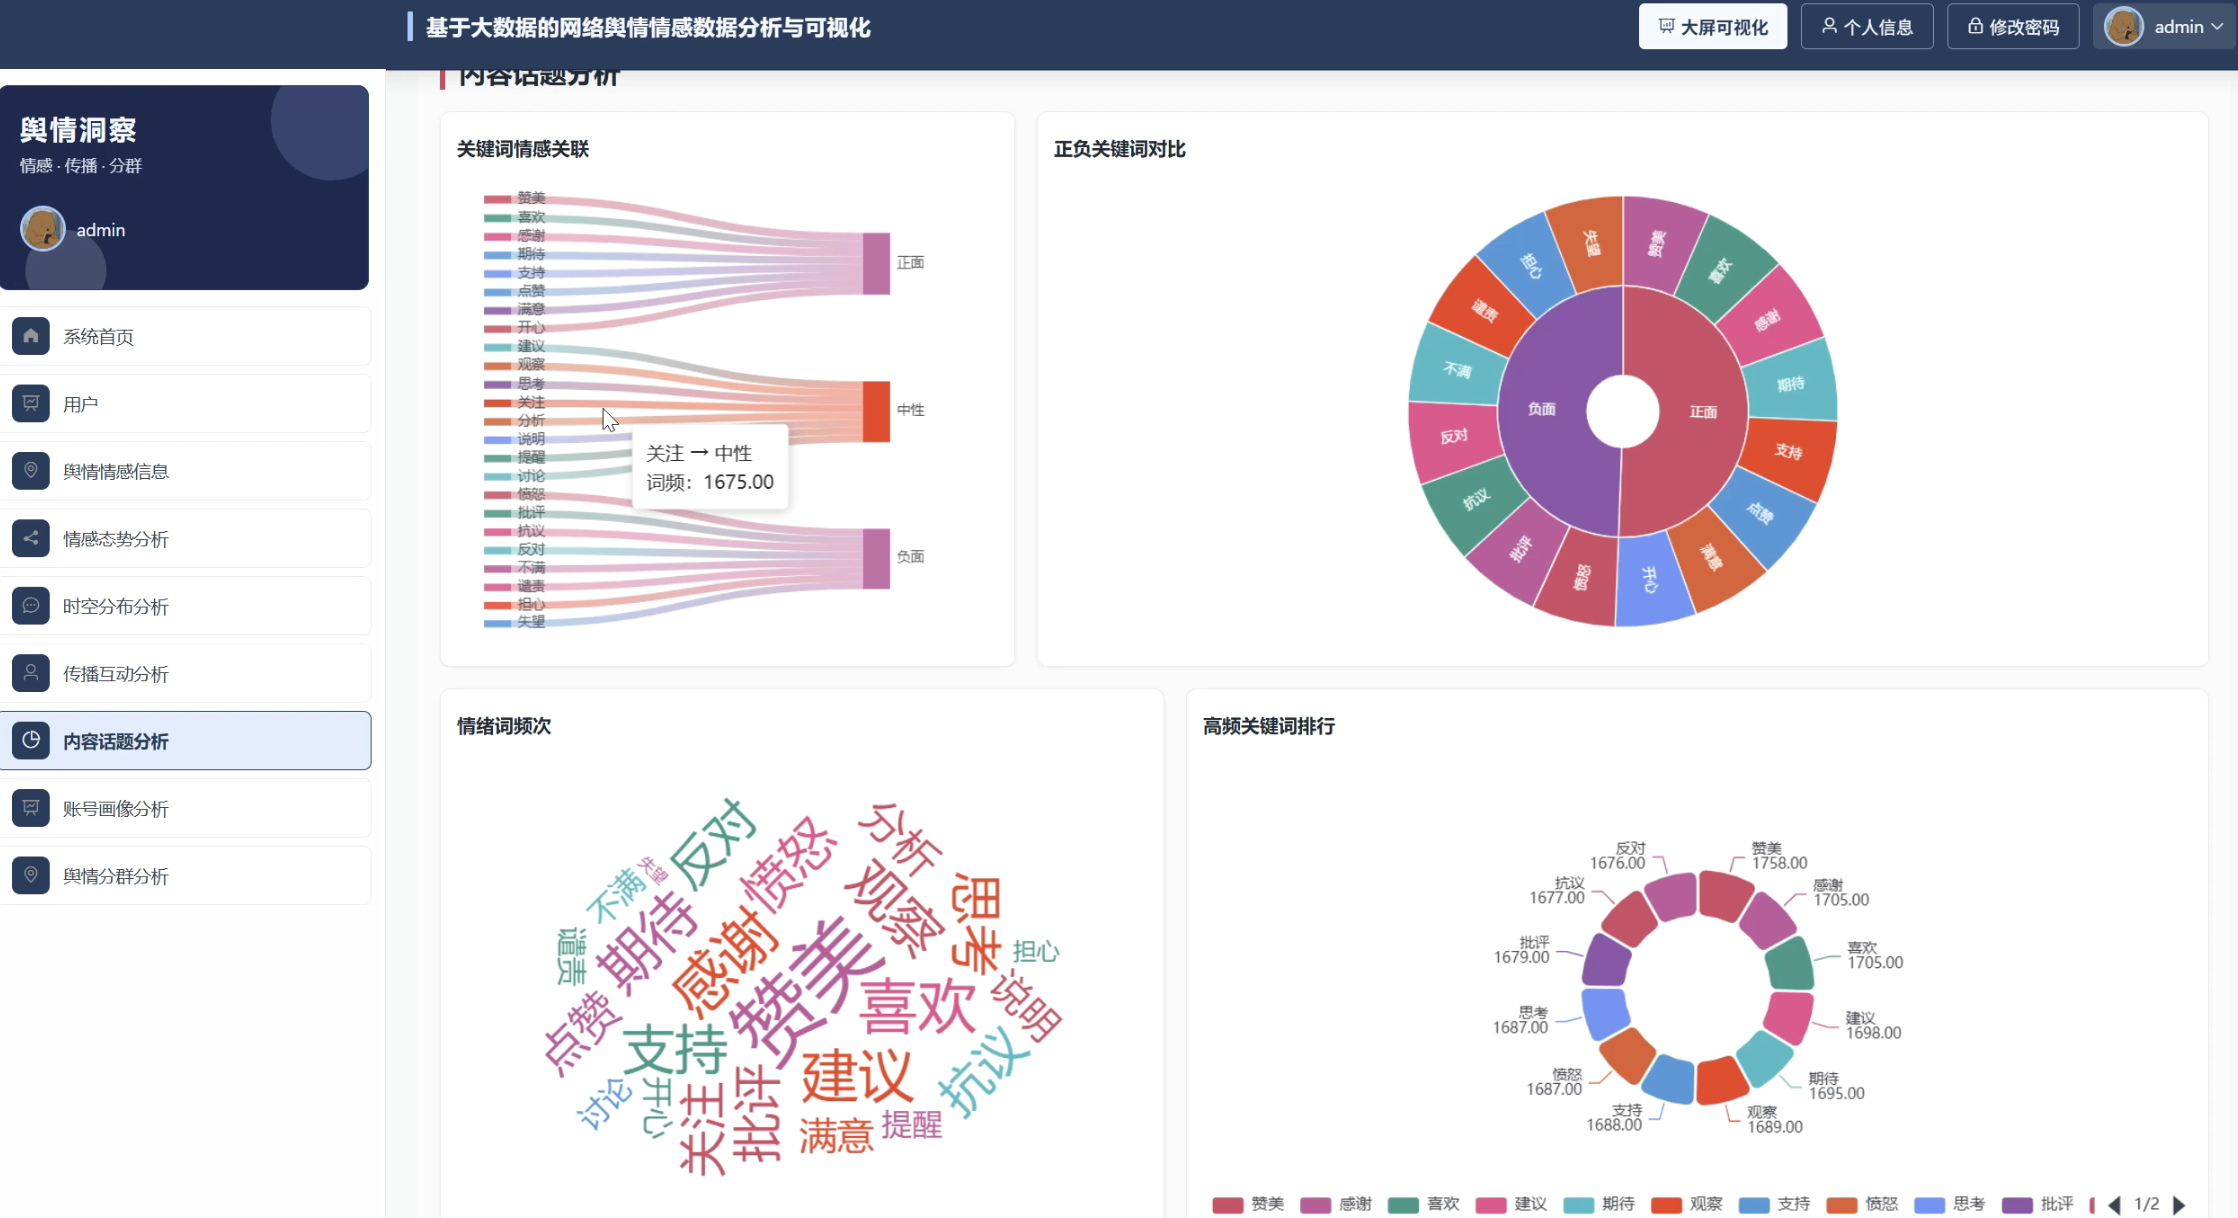
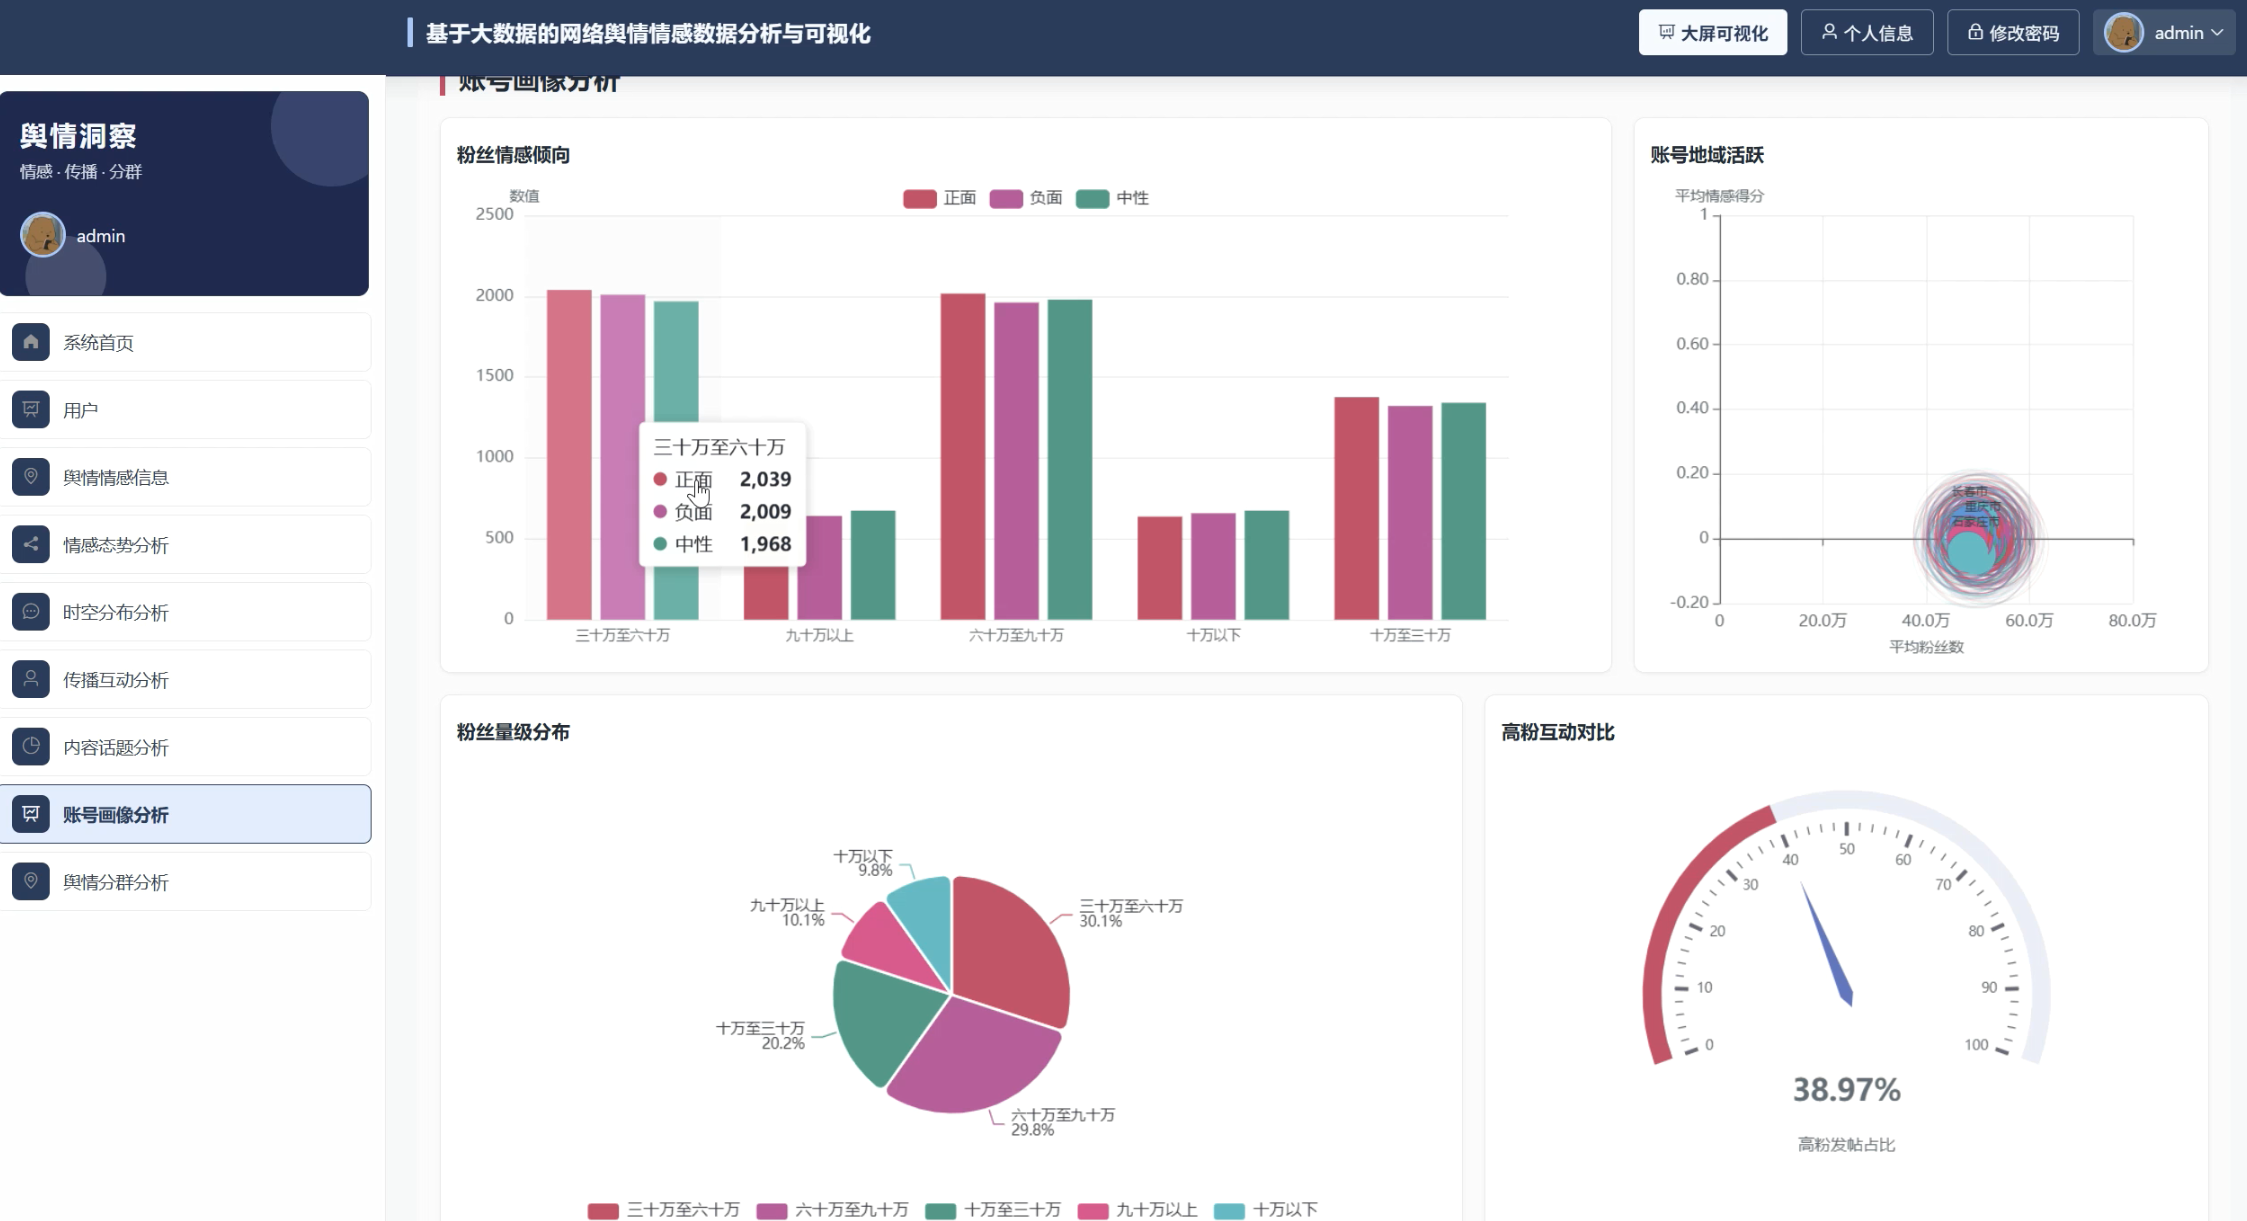
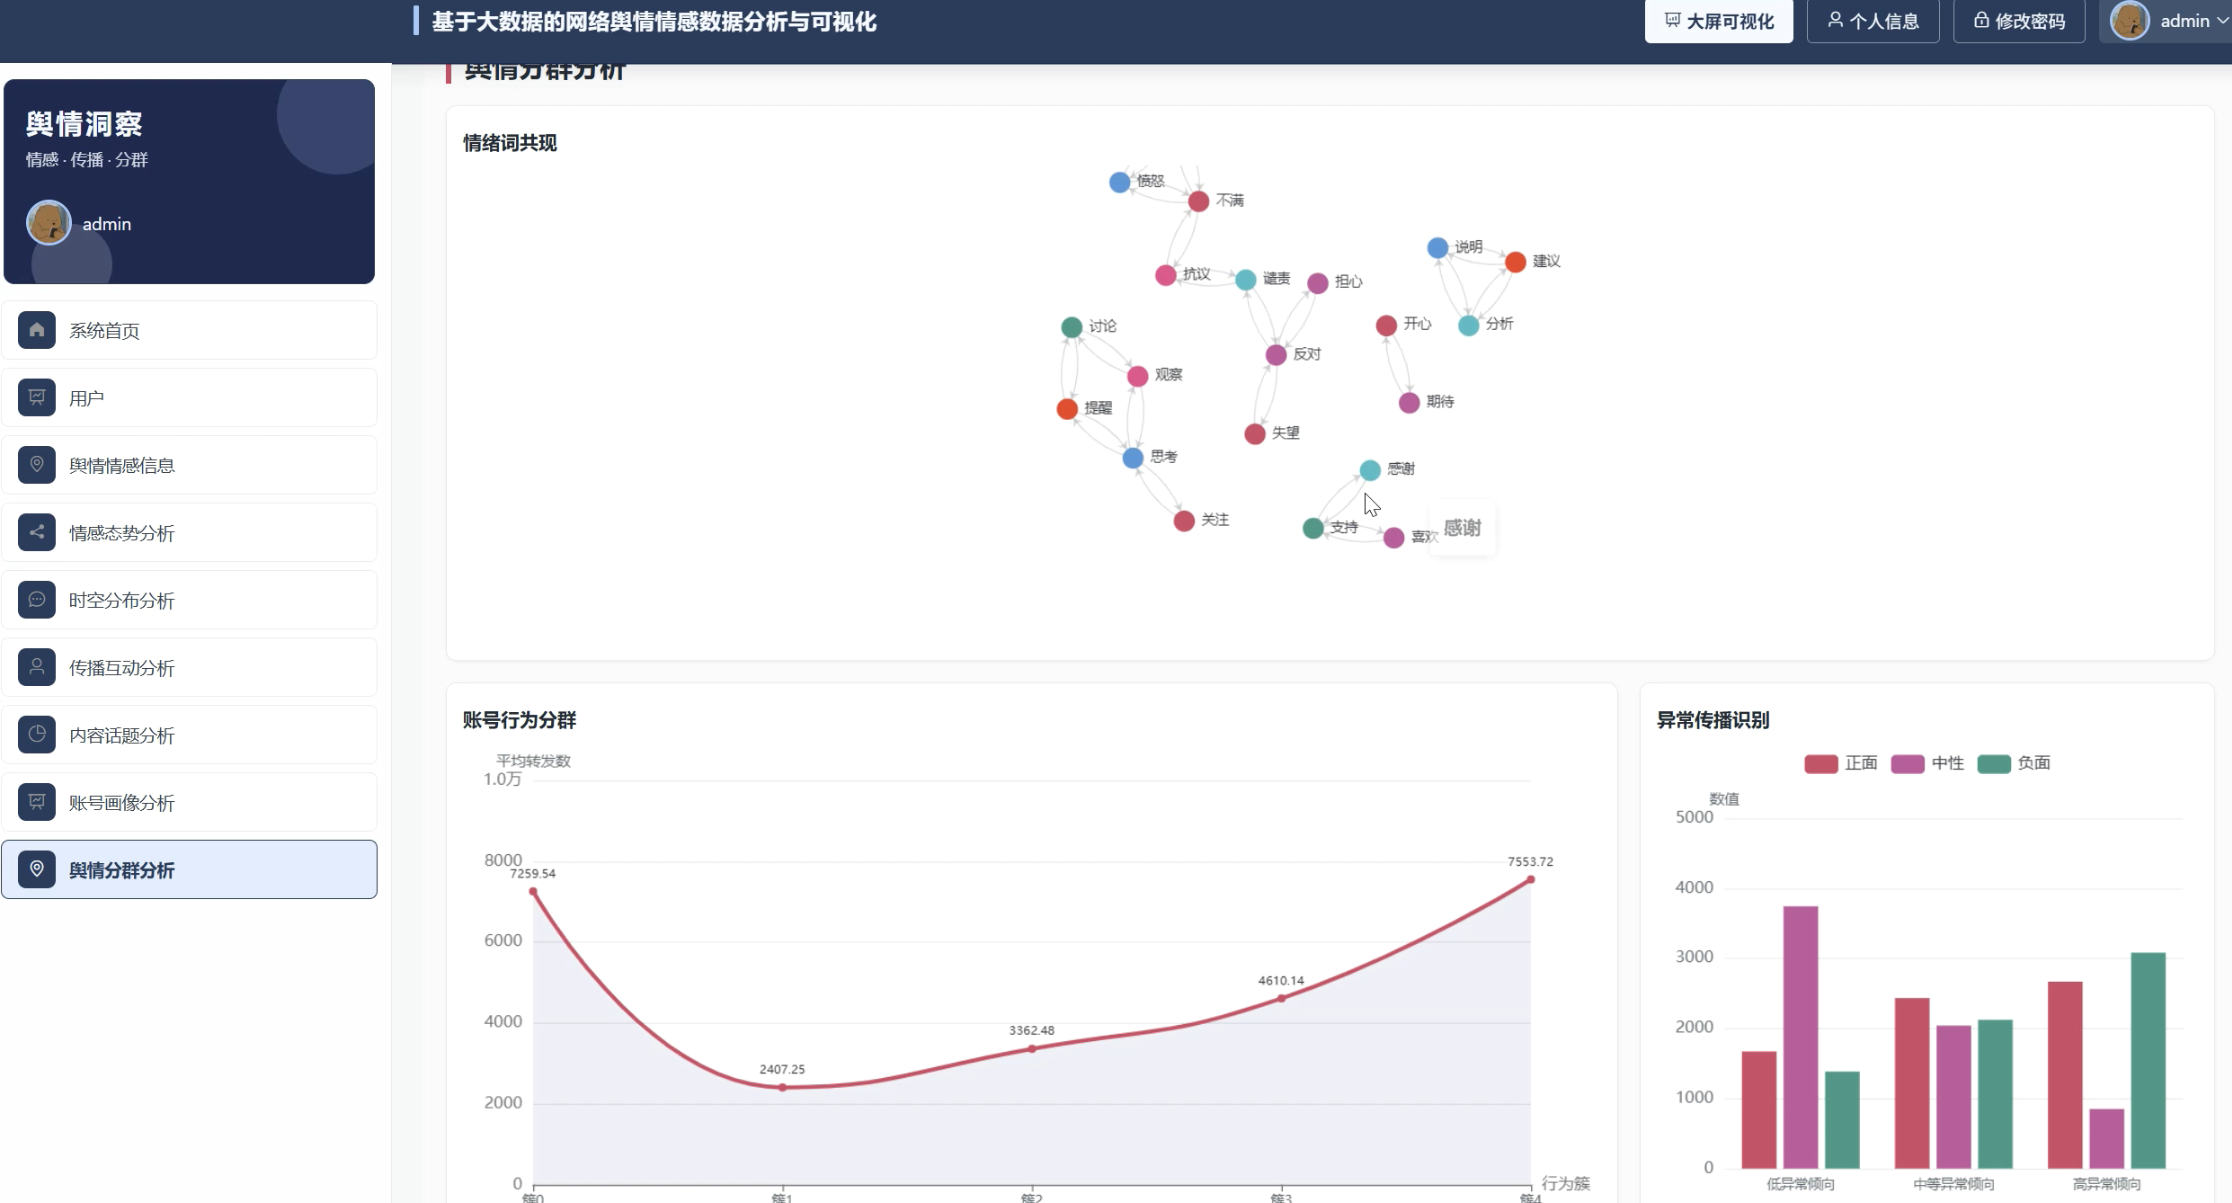
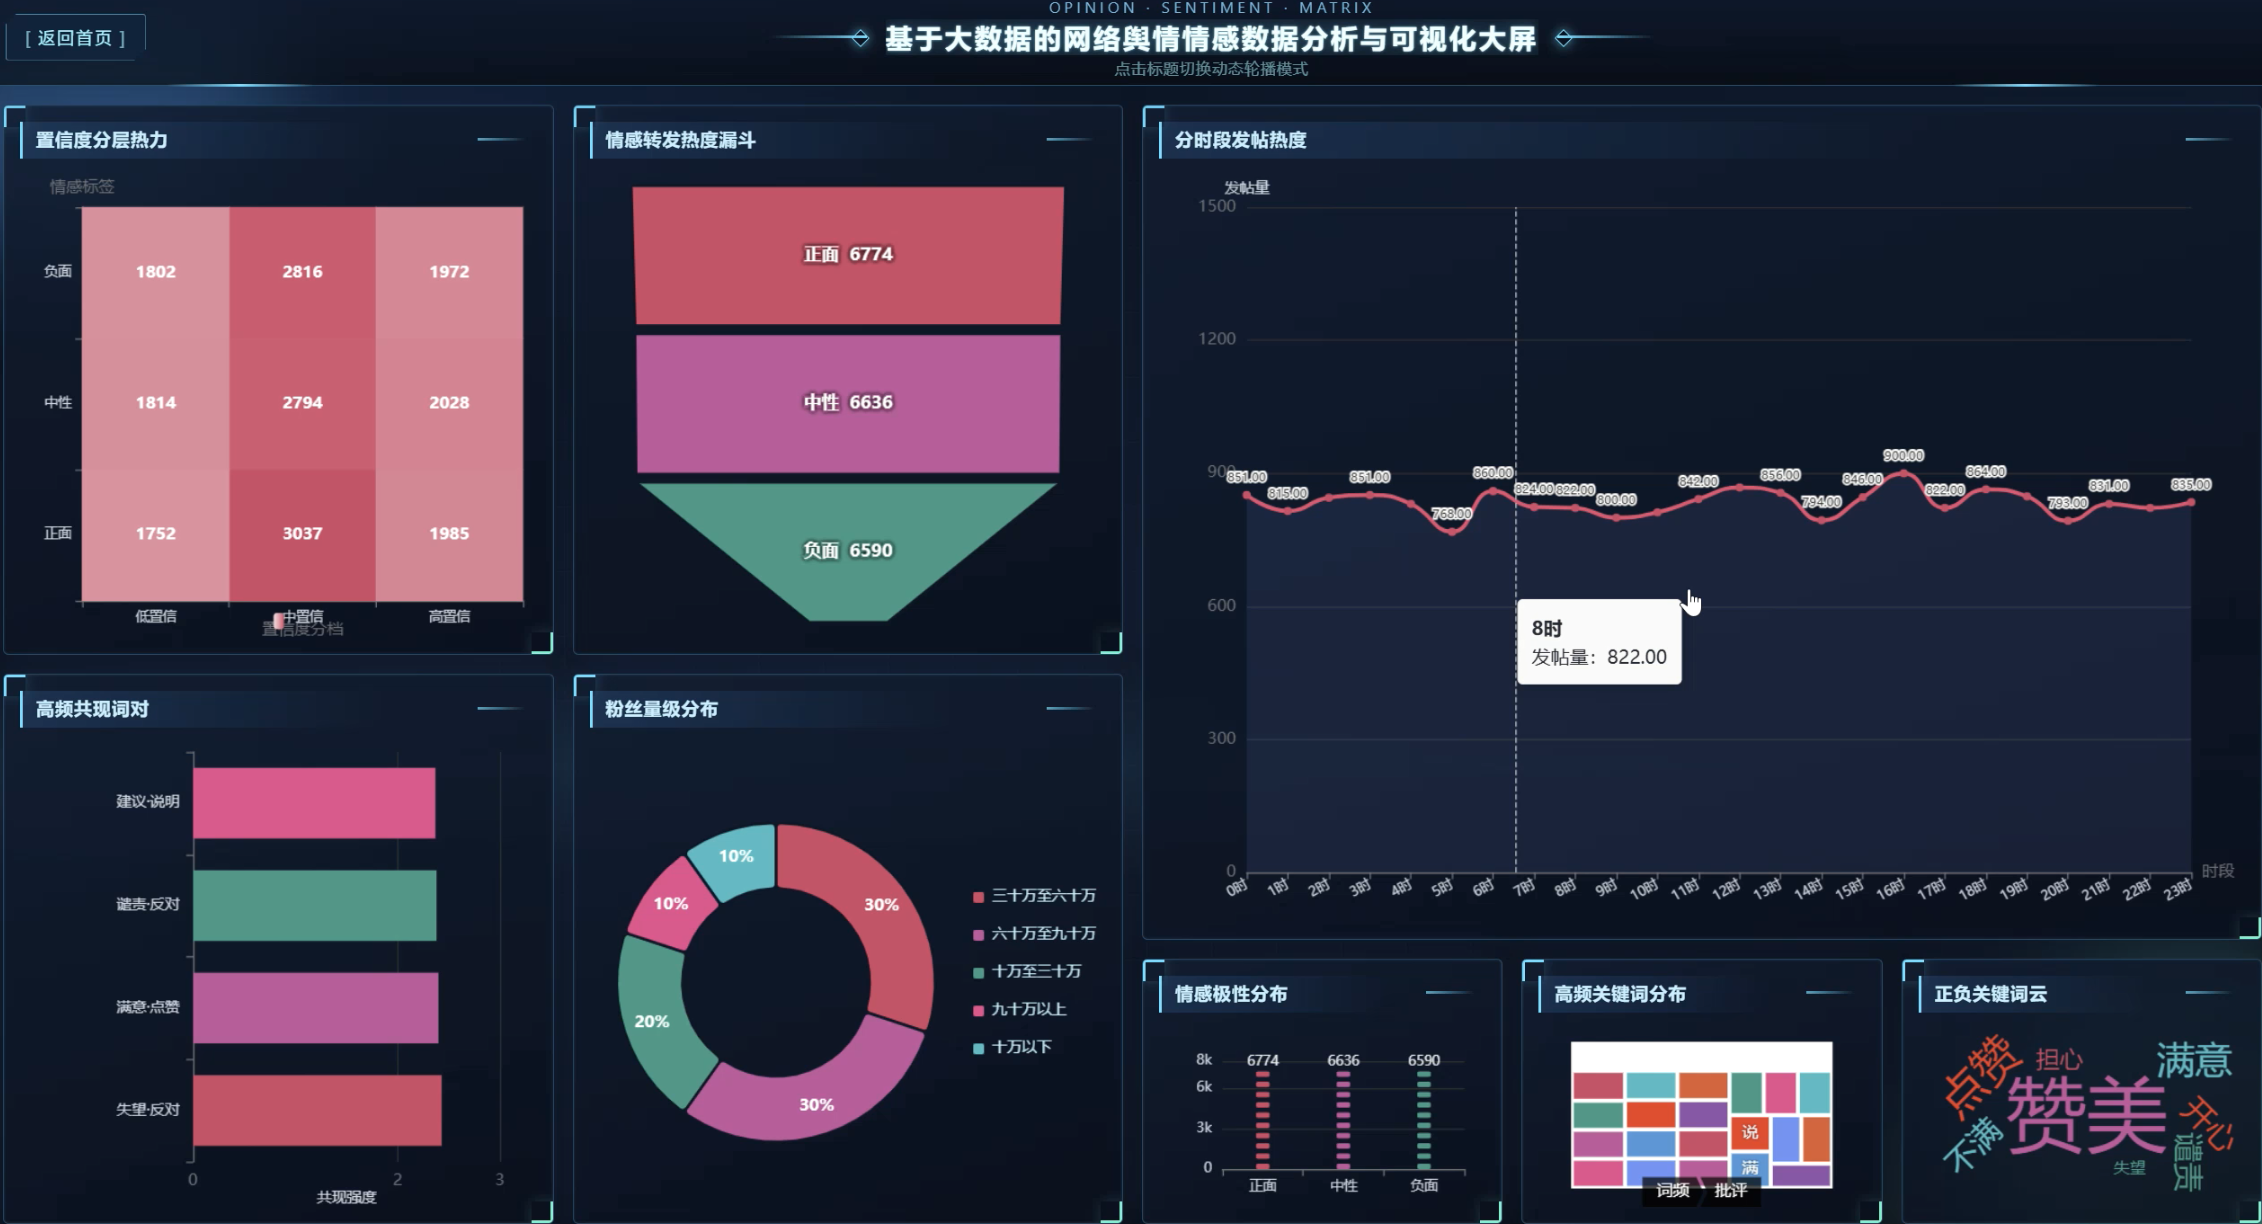
系统后端用 Python、PySpark 做数据处理与分析,业务接口基于 Django,前端用 Vue 与 ECharts 做图表与可视化大屏,数据落 MySQL。功能上覆盖情感态势、时空分布、传播互动、内容话题、账号画像六类常规分析,以及舆情分群维度里的 K-Means 账号行为分群、FP-Growth 情绪词共现和 Isolation Forest 异常传播识别,并配套舆情数据与用户管理。
经过系统测试,本系统能满足计算机及相关专业学生在毕业设计选题与答辩演示上的使用需求,也能给舆情监测、运营研判类使用者提供情感走势、地域对比和算法分群层面的辅助参考,对把网络舆情情感分析从表格堆砌落到可视化研判有一定实践意义。
二、视频展示
数据分析毕设选题推荐【基于大数据的网络舆情情感数据分析
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
登录模块: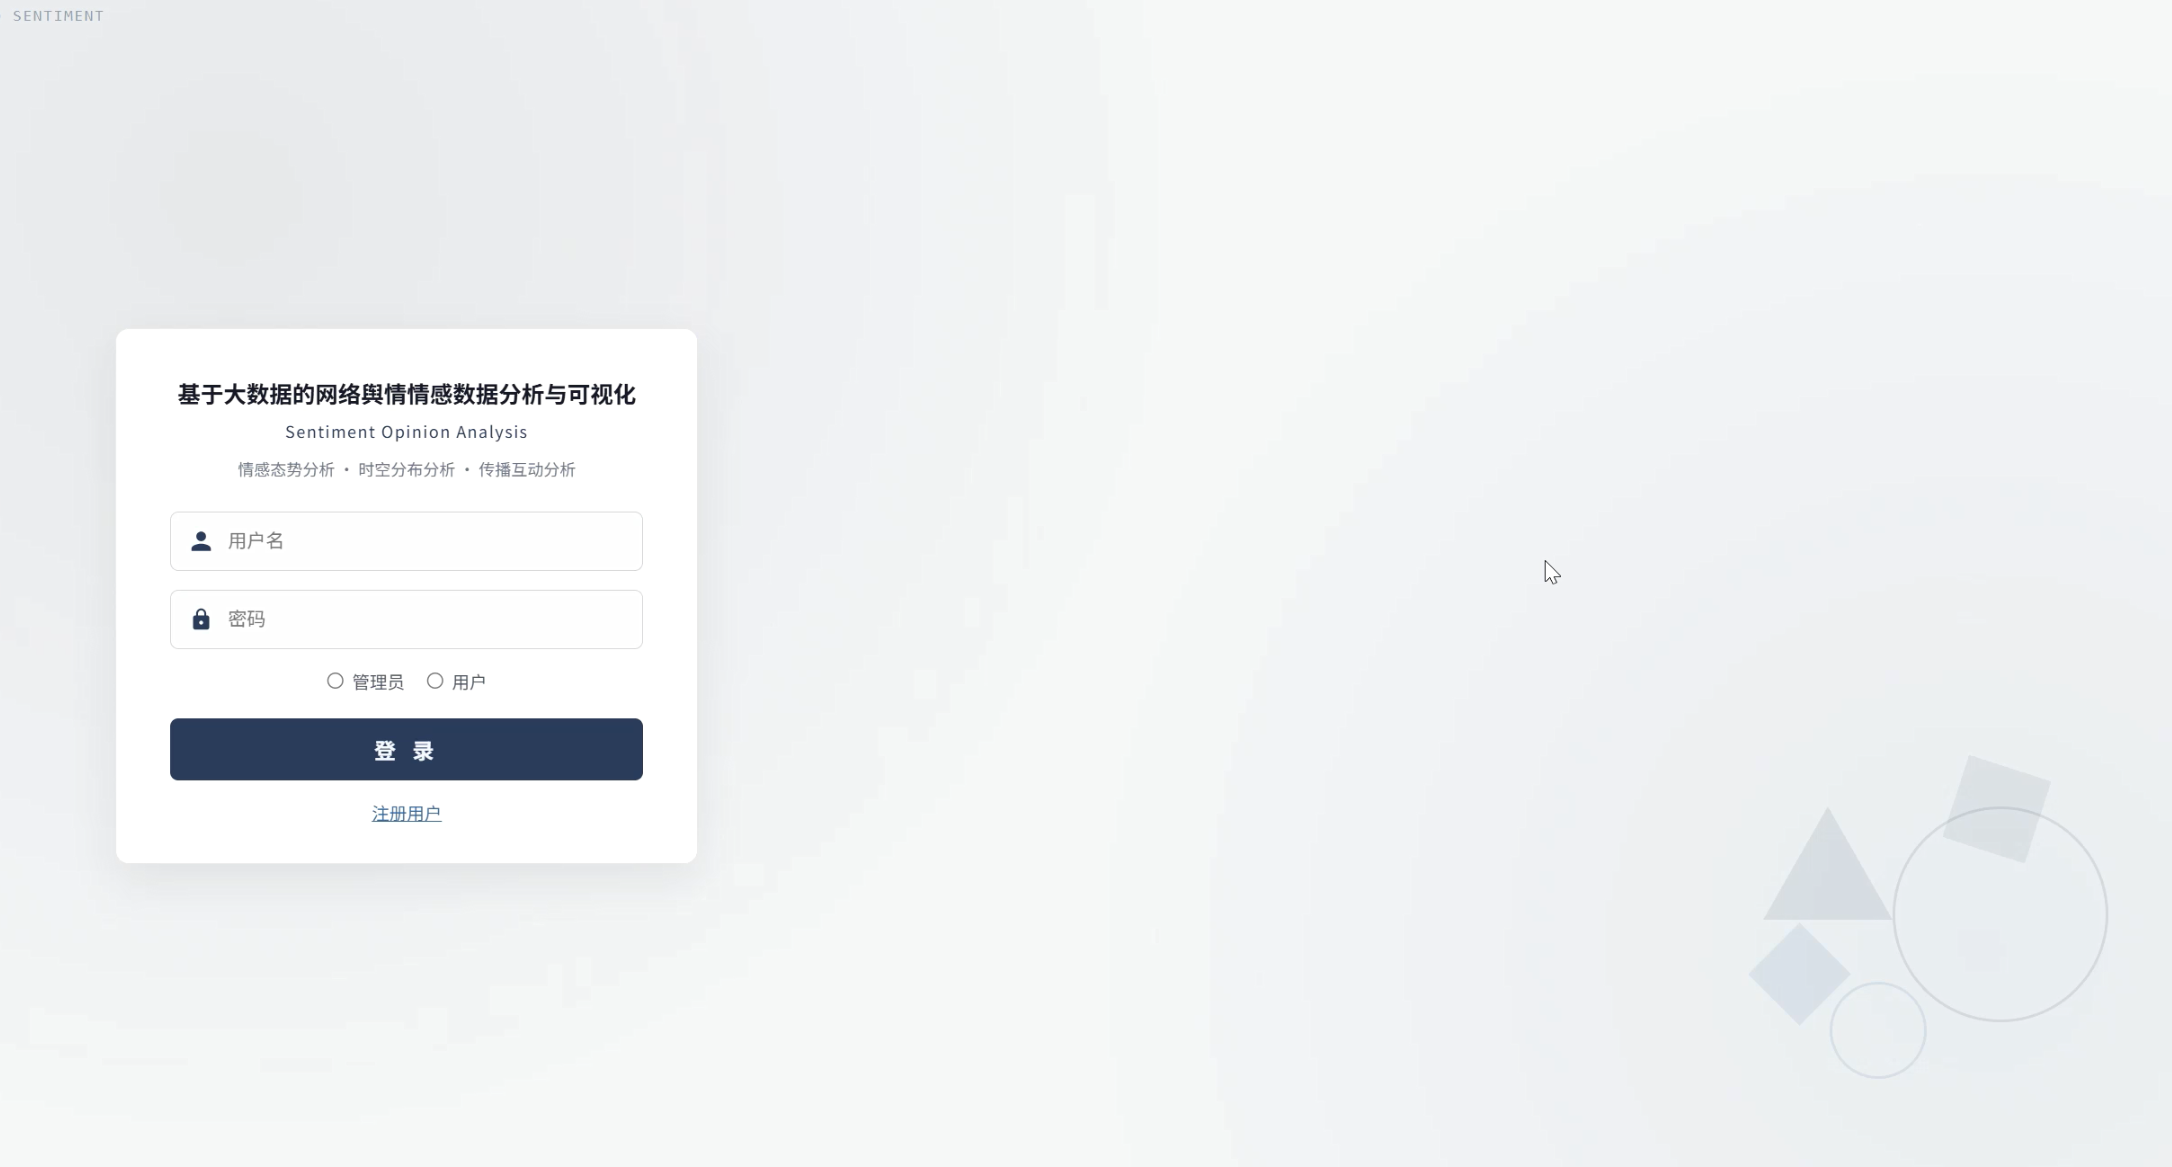
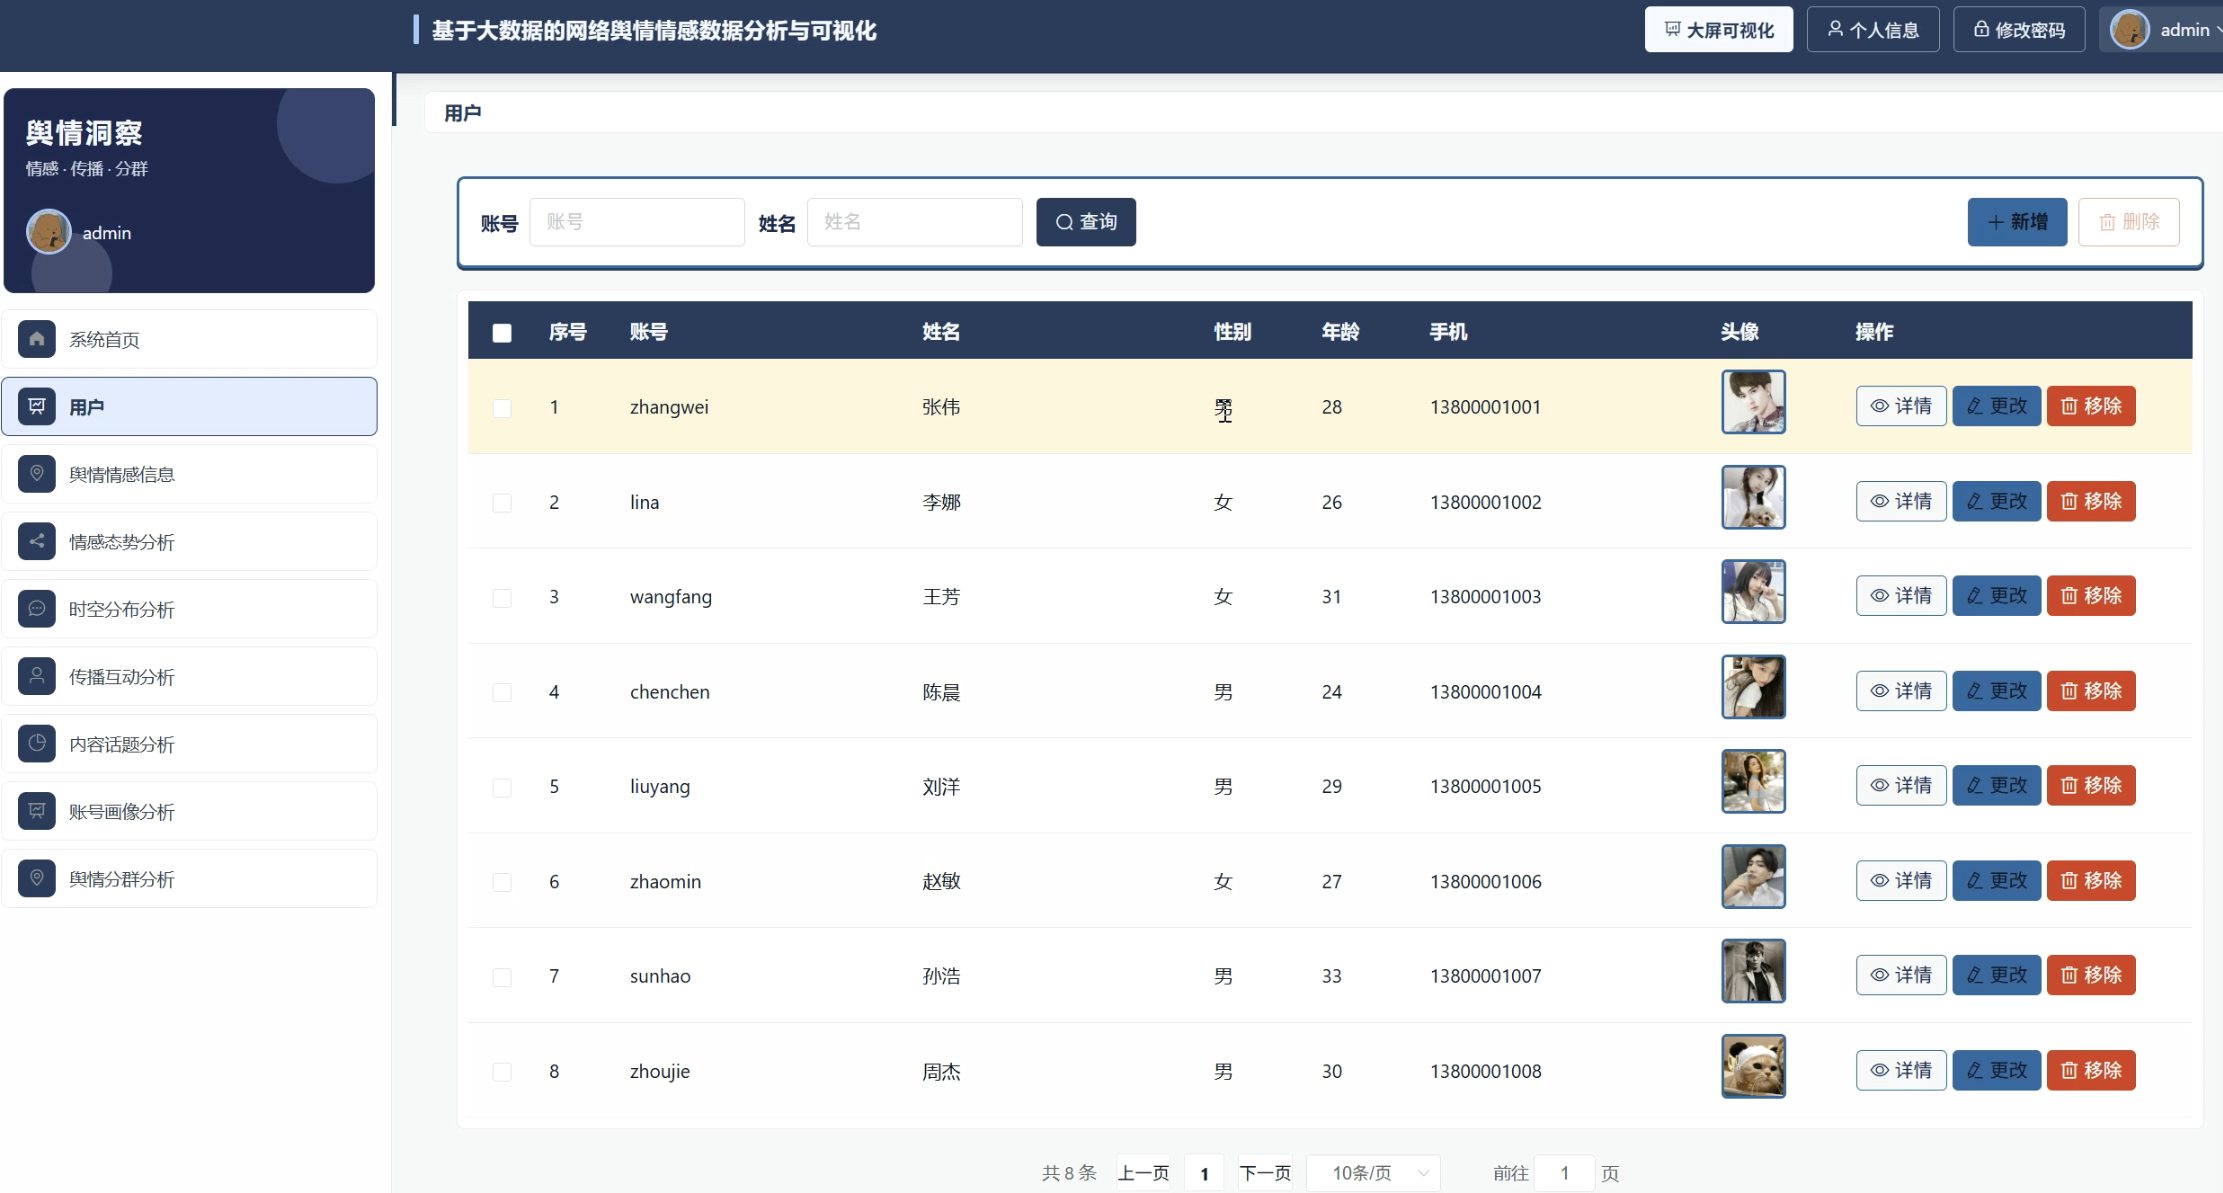
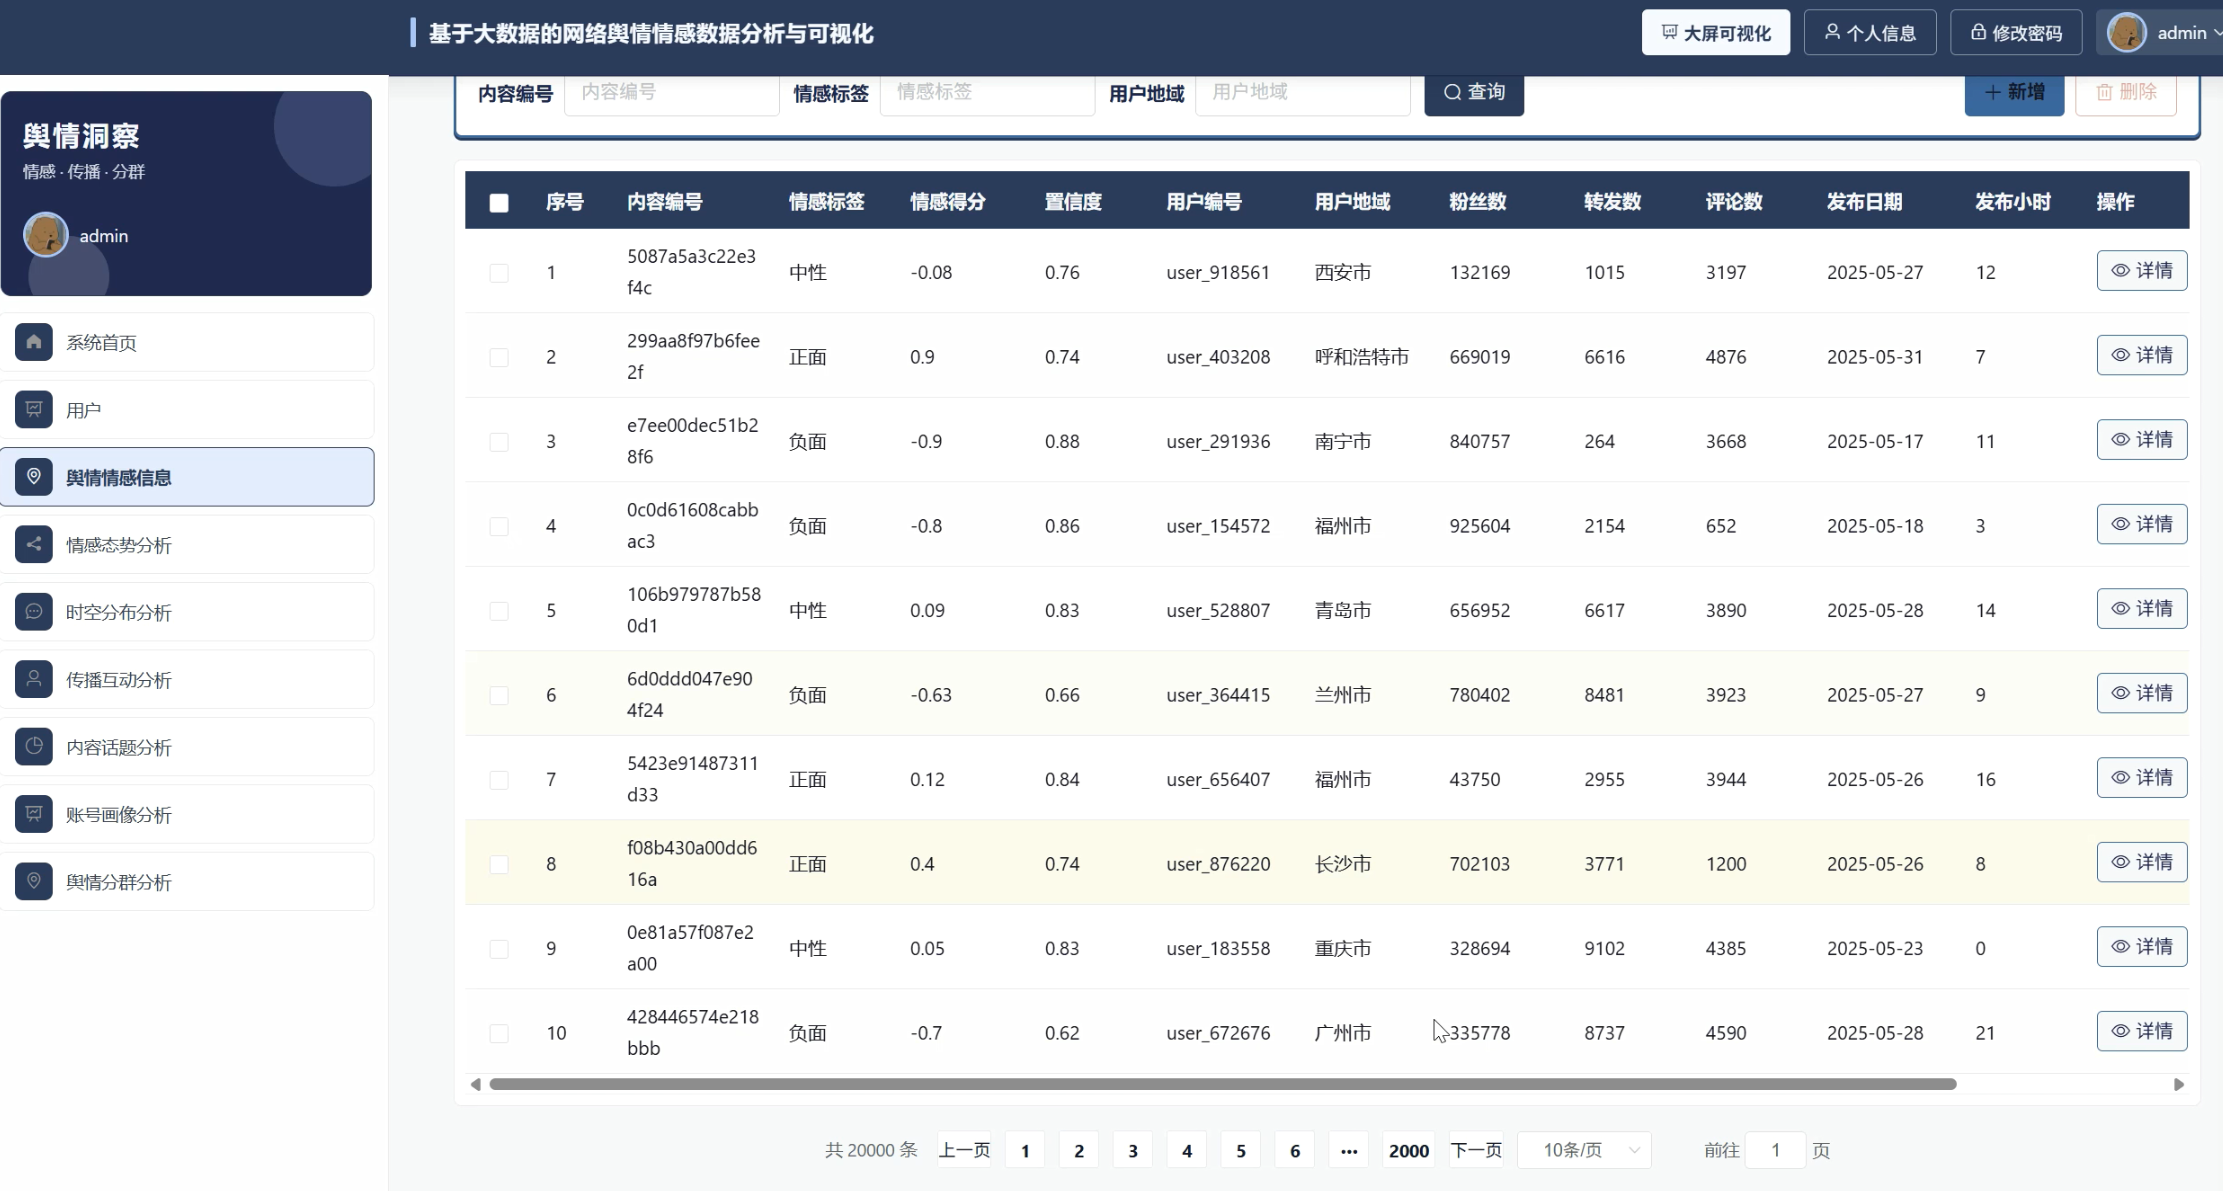
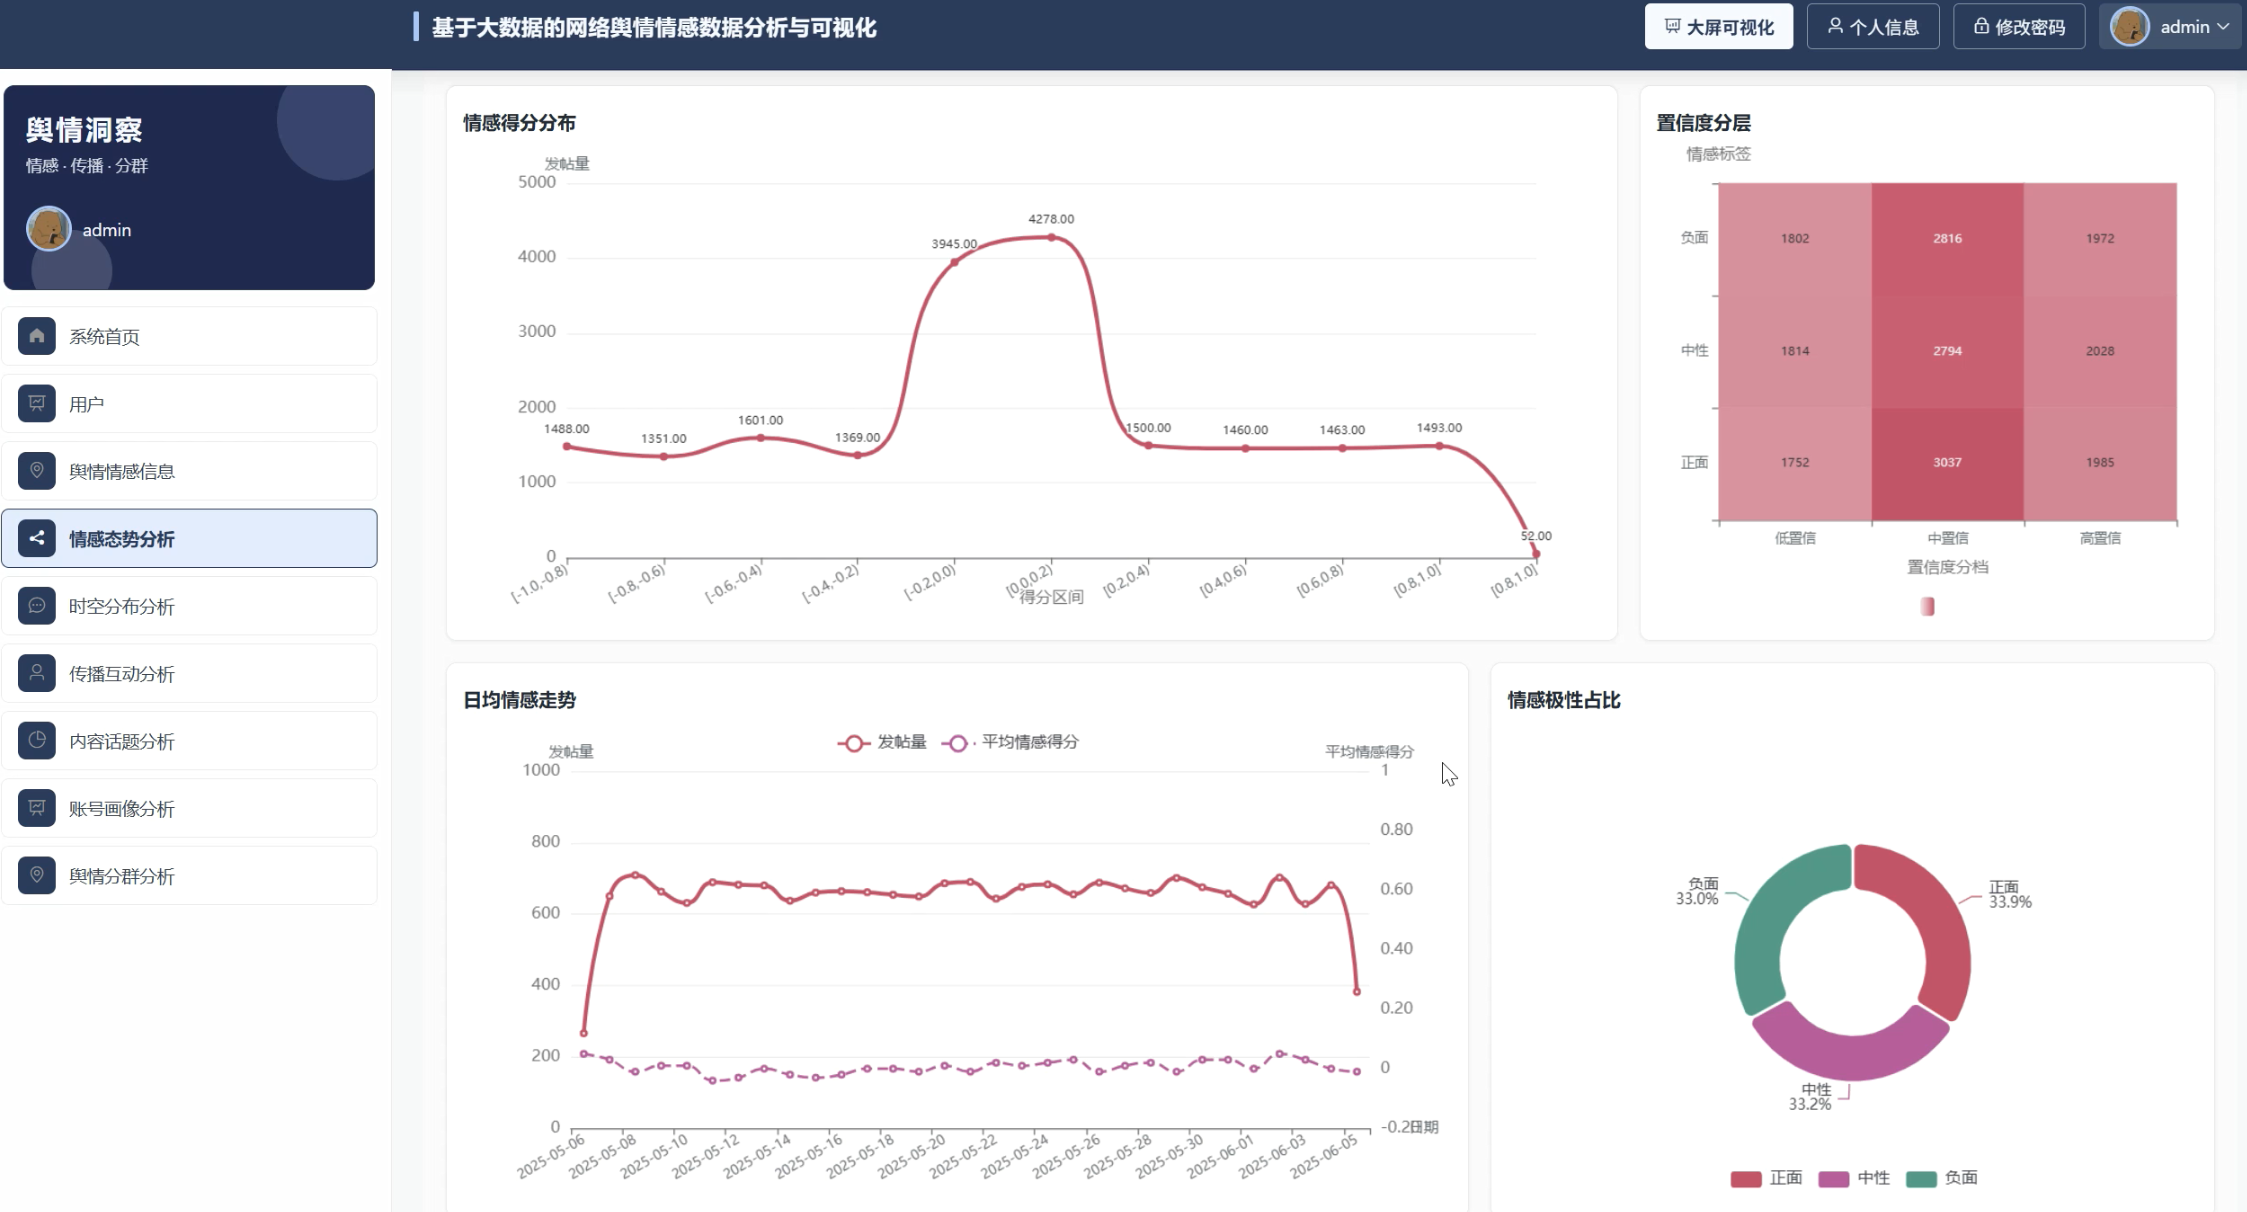
五、代码展示
def account_behavior_cluster_analysis(input_df):
    feat_cols = [
        'user_followers', 'sentiment_score', 'repost_count',
        'comment_count', 'quote_count', 'confidence',
    ]
    work = input_df
    for c in feat_cols:
        work = work.filter(col(c).isNotNull())
        work = work.withColumn(c, col(c).cast('double'))

    assembler = VectorAssembler(inputCols=feat_cols, outputCol='raw_features')
    assembled = assembler.transform(work)
    scaler = StandardScaler(
        inputCol='raw_features', outputCol='features', withStd=True, withMean=True
    )
    scaled = scaler.fit(assembled).transform(assembled)

    # 肘部法则:K=2..6 扫训练代价,找降幅拐点
    costs = []
    for k in range(2, 7):
        model_k = KMeans(k=k, seed=42, maxIter=30, featuresCol='features')
        m = model_k.fit(scaled)
        costs.append((k, float(m.summary.trainingCost)))

    best_k = 3
    if len(costs) >= 2:
        drops = [costs[i][1] - costs[i + 1][1] for i in range(len(costs) - 1)]
        best_k = costs[0][0]
        for i in range(1, len(drops)):
            if drops[i] < drops[i - 1] * 0.5:
                best_k = costs[i][0]
                break
            best_k = costs[i][0]

    model = KMeans(k=best_k, seed=42, maxIter=40, featuresCol='features').fit(scaled)
    pred = model.transform(scaled)

    centers_pdf = (
        pred.groupBy('prediction')
        .agg(
            spark_count(lit(1)).alias('post_count'),
            spark_avg('user_followers').alias('avg_followers'),
            spark_avg('sentiment_score').alias('avg_sentiment'),
            spark_avg('repost_count').alias('avg_repost'),
            spark_avg('comment_count').alias('avg_comment'),
            spark_avg('quote_count').alias('avg_quote'),
            spark_avg('confidence').alias('avg_confidence'),
        )
        .orderBy('prediction')
        .toPandas()
    )
    centers_pdf['avg_interact'] = (
        centers_pdf['avg_repost'] + centers_pdf['avg_comment'] + centers_pdf['avg_quote']
    )

    # 相对排序贴中文簇含义(不用固定绝对值阈值)
    f_rank = centers_pdf['avg_followers'].rank(method='first').astype(int)
    i_rank = centers_pdf['avg_interact'].rank(method='first').astype(int)
    s_rank = centers_pdf['avg_sentiment'].rank(method='first').astype(int)
    n_c = len(centers_pdf)

    def _tier(r, n):
        if n <= 1:
            return '中'
        if r <= max(1, n // 3):
            return '低'
        if r >= n - max(0, n // 3 - 1):
            return '高'
        return '中'

    label_map = {}
    for idx, row in centers_pdf.iterrows():
        cid = int(row['prediction'])
        ft, it, st = _tier(int(f_rank.loc[idx]), n_c), _tier(int(i_rank.loc[idx]), n_c), _tier(int(s_rank.loc[idx]), n_c)
        label_map[cid] = (
            f"{ft}粉{it}互动{st}情感型"
            f"(粉丝均值{row['avg_followers']:.0f}/互动均值{row['avg_interact']:.0f}/"
            f"情感均值{row['avg_sentiment']:.2f})"
        )

    rows = []
    for _, row in centers_pdf.iterrows():
        cid = int(row['prediction'])
        rows.append({
            'cluster_id': cid,
            'cluster_label': label_map[cid],
            'post_count': int(row['post_count']),
            'avg_followers': round(float(row['avg_followers']), 2),
            'avg_sentiment_score': round(float(row['avg_sentiment']), 2),
            'avg_repost': round(float(row['avg_repost']), 2),
            'avg_comment': round(float(row['avg_comment']), 2),
            'avg_quote': round(float(row['avg_quote']), 2),
            'avg_confidence': round(float(row['avg_confidence']), 2),
        })
    result = spark.createDataFrame([Row(**r) for r in rows]).orderBy('cluster_id')
    _save_local(result, 'account_behavior_cluster_analysis')
    return result
六、项目文档展示

七、项目总结
本课题围绕网络舆情情感数据,完成了从预处理、Spark 分析到前后端可视化的整条链路。系统以情感态势、时空分布、传播互动、内容话题、账号画像六类常规分析为主,并在舆情分群维度落地 K-Means 账号行为分群、FP-Growth 情绪词共现与 Isolation Forest 异常传播识别,把正负情感结构、地域差异、互动热度与算法分群结果落到图表与可视化大屏上。实践上,约 2 万条舆情样本经清洗与聚合后可供查询与展示,既方便计算机专业同学做毕业设计演示,也可为舆情研判提供情感走势与群体画像参考。总体看,本系统把“数据能算、结果能看”串了起来,对同类大数据毕设选题具有一定借鉴意义。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
更多推荐

 14
 0
- 0


 已为社区贡献24条内容

所有评论(0)