
计算机毕业设计做什么好?【基于大数据的食谱菜谱数据可视化与分析】K-Means菜谱分群+关联规则挖掘
精彩专栏推荐订阅:在下方主页👇🏻👇🏻👇🏻👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
一、项目介绍
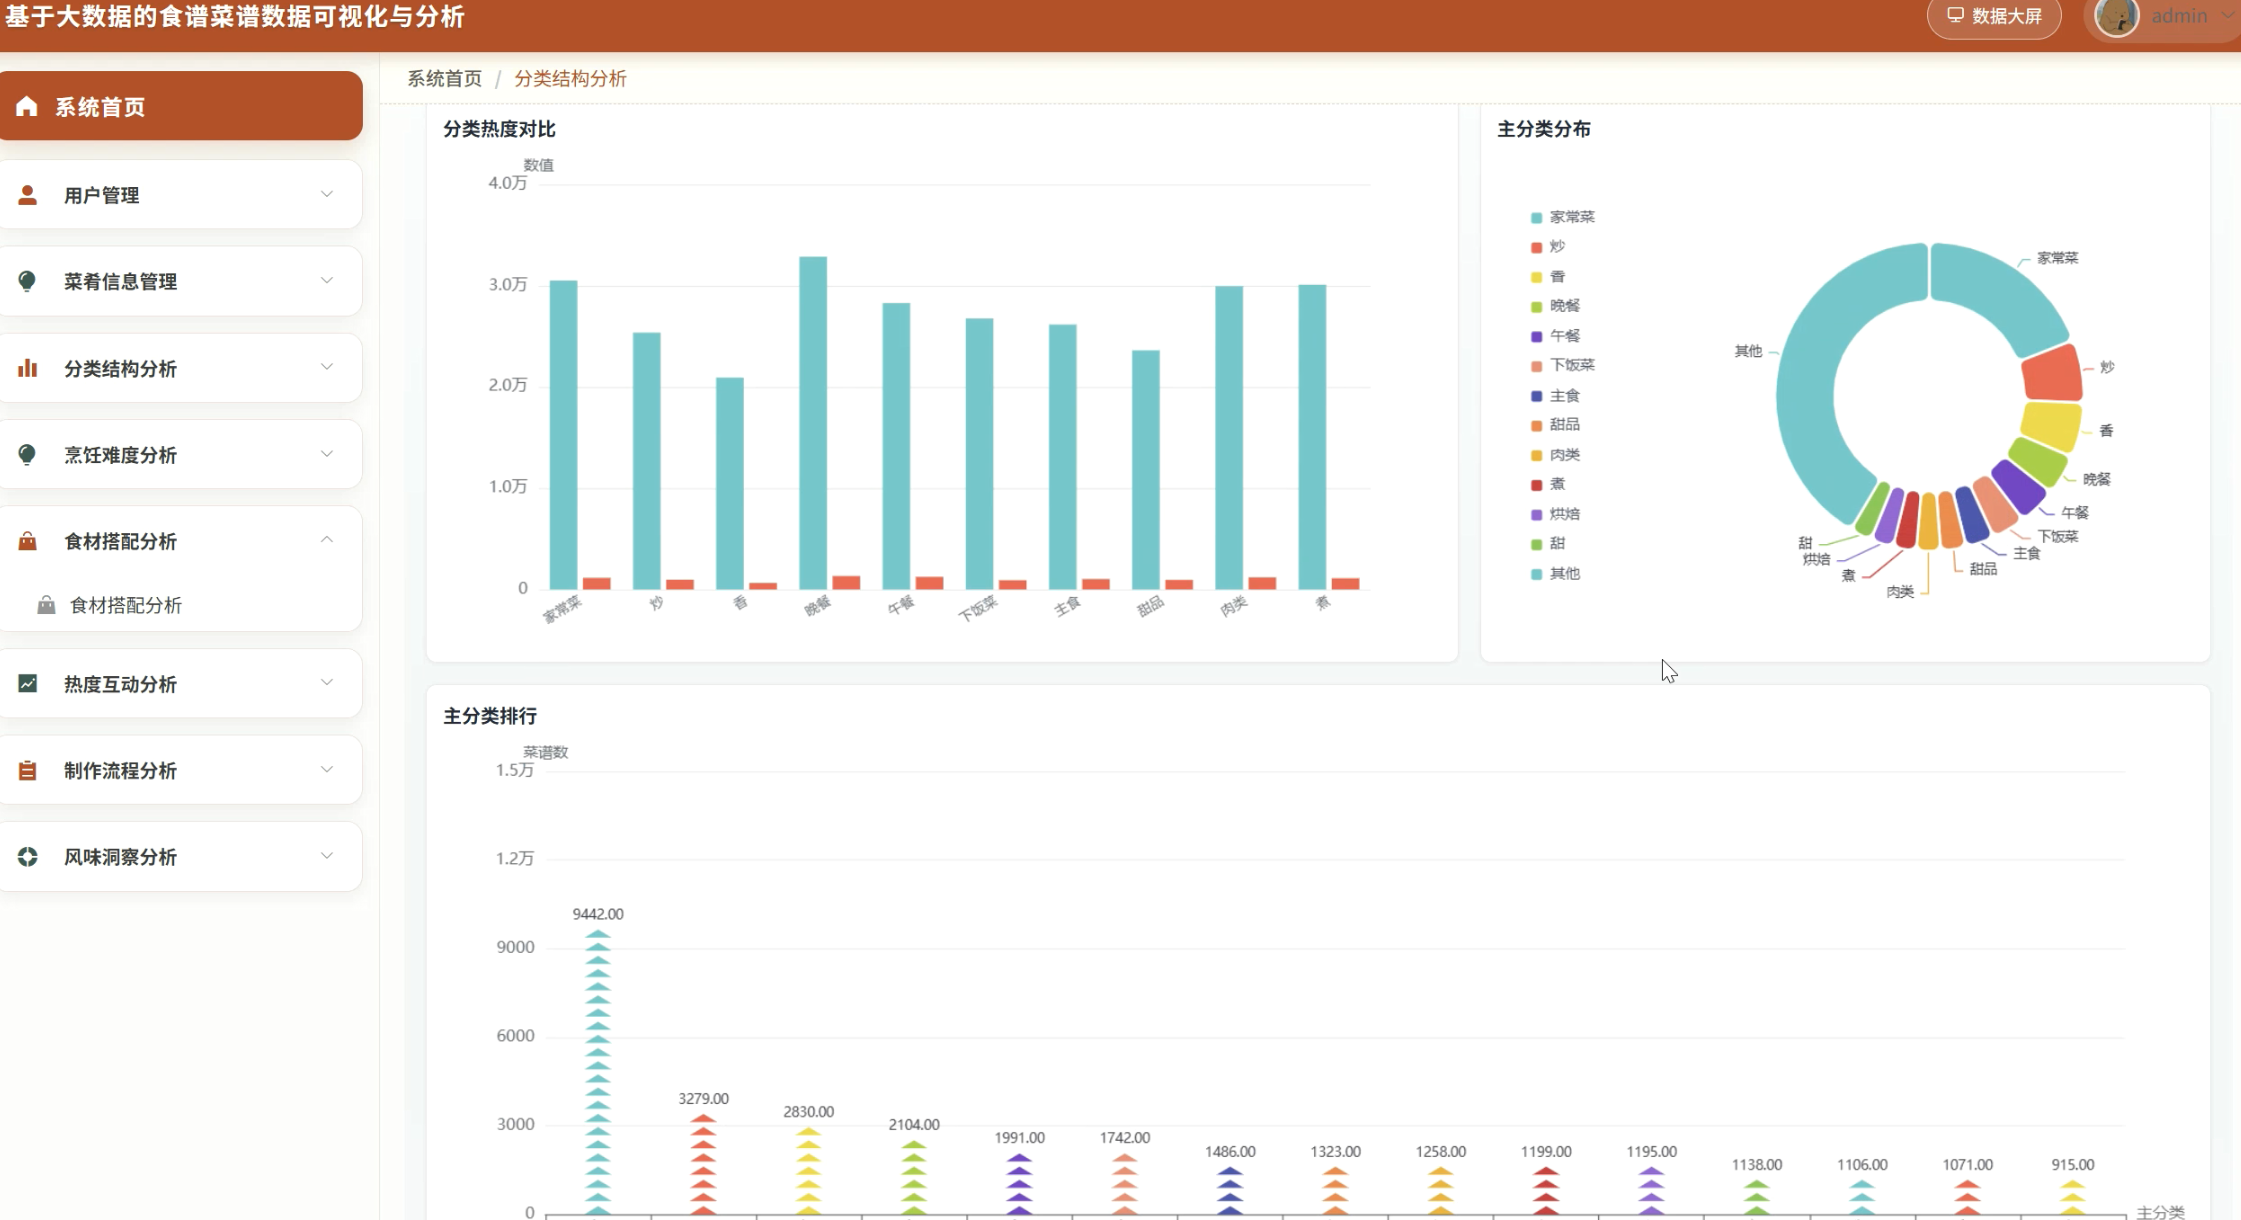
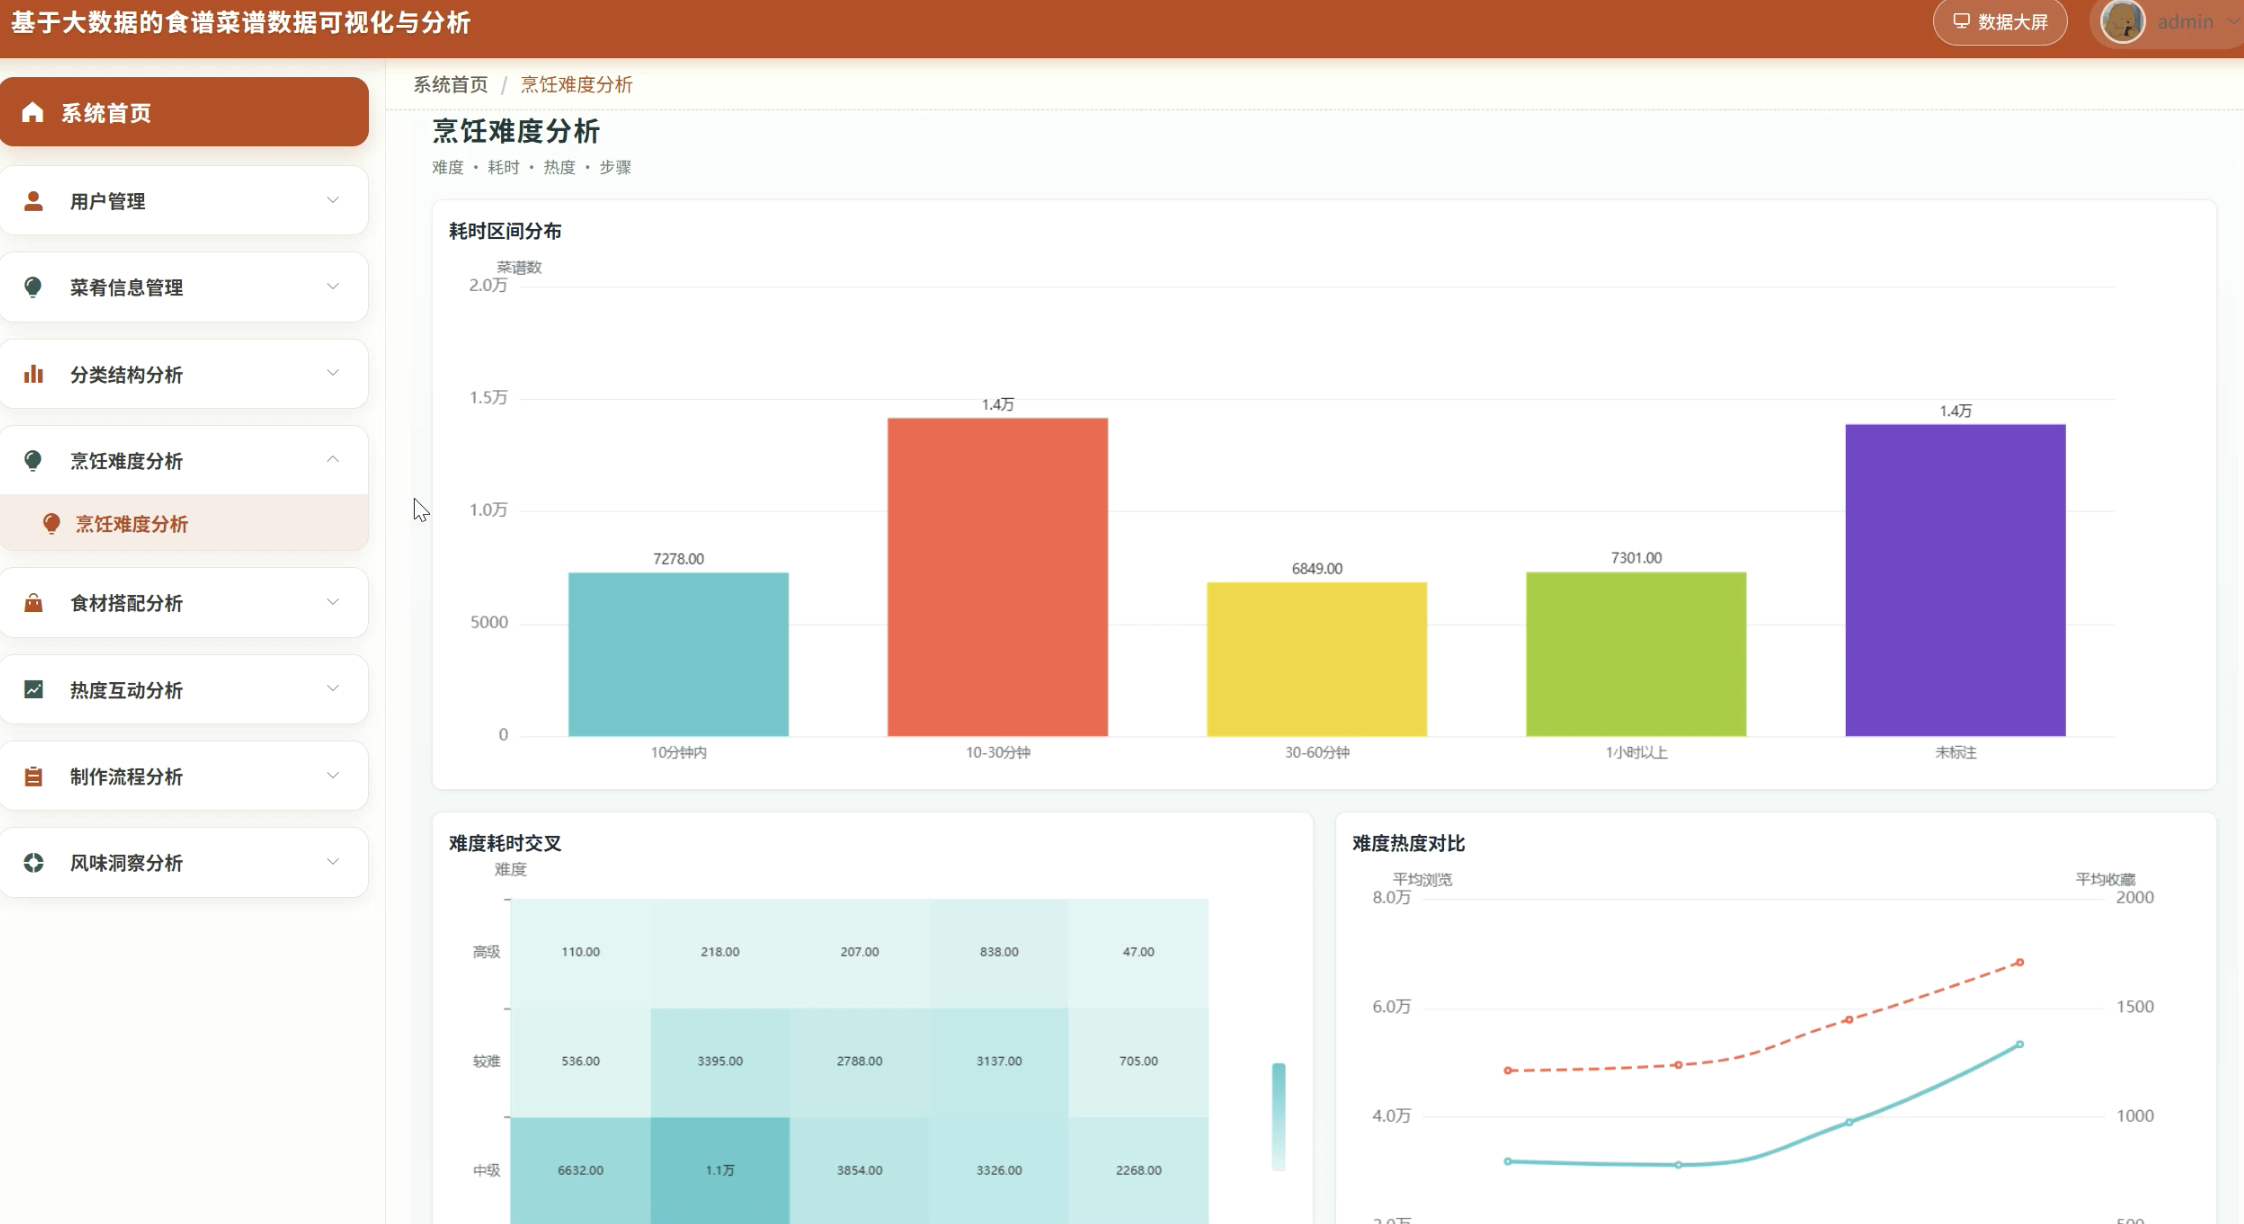
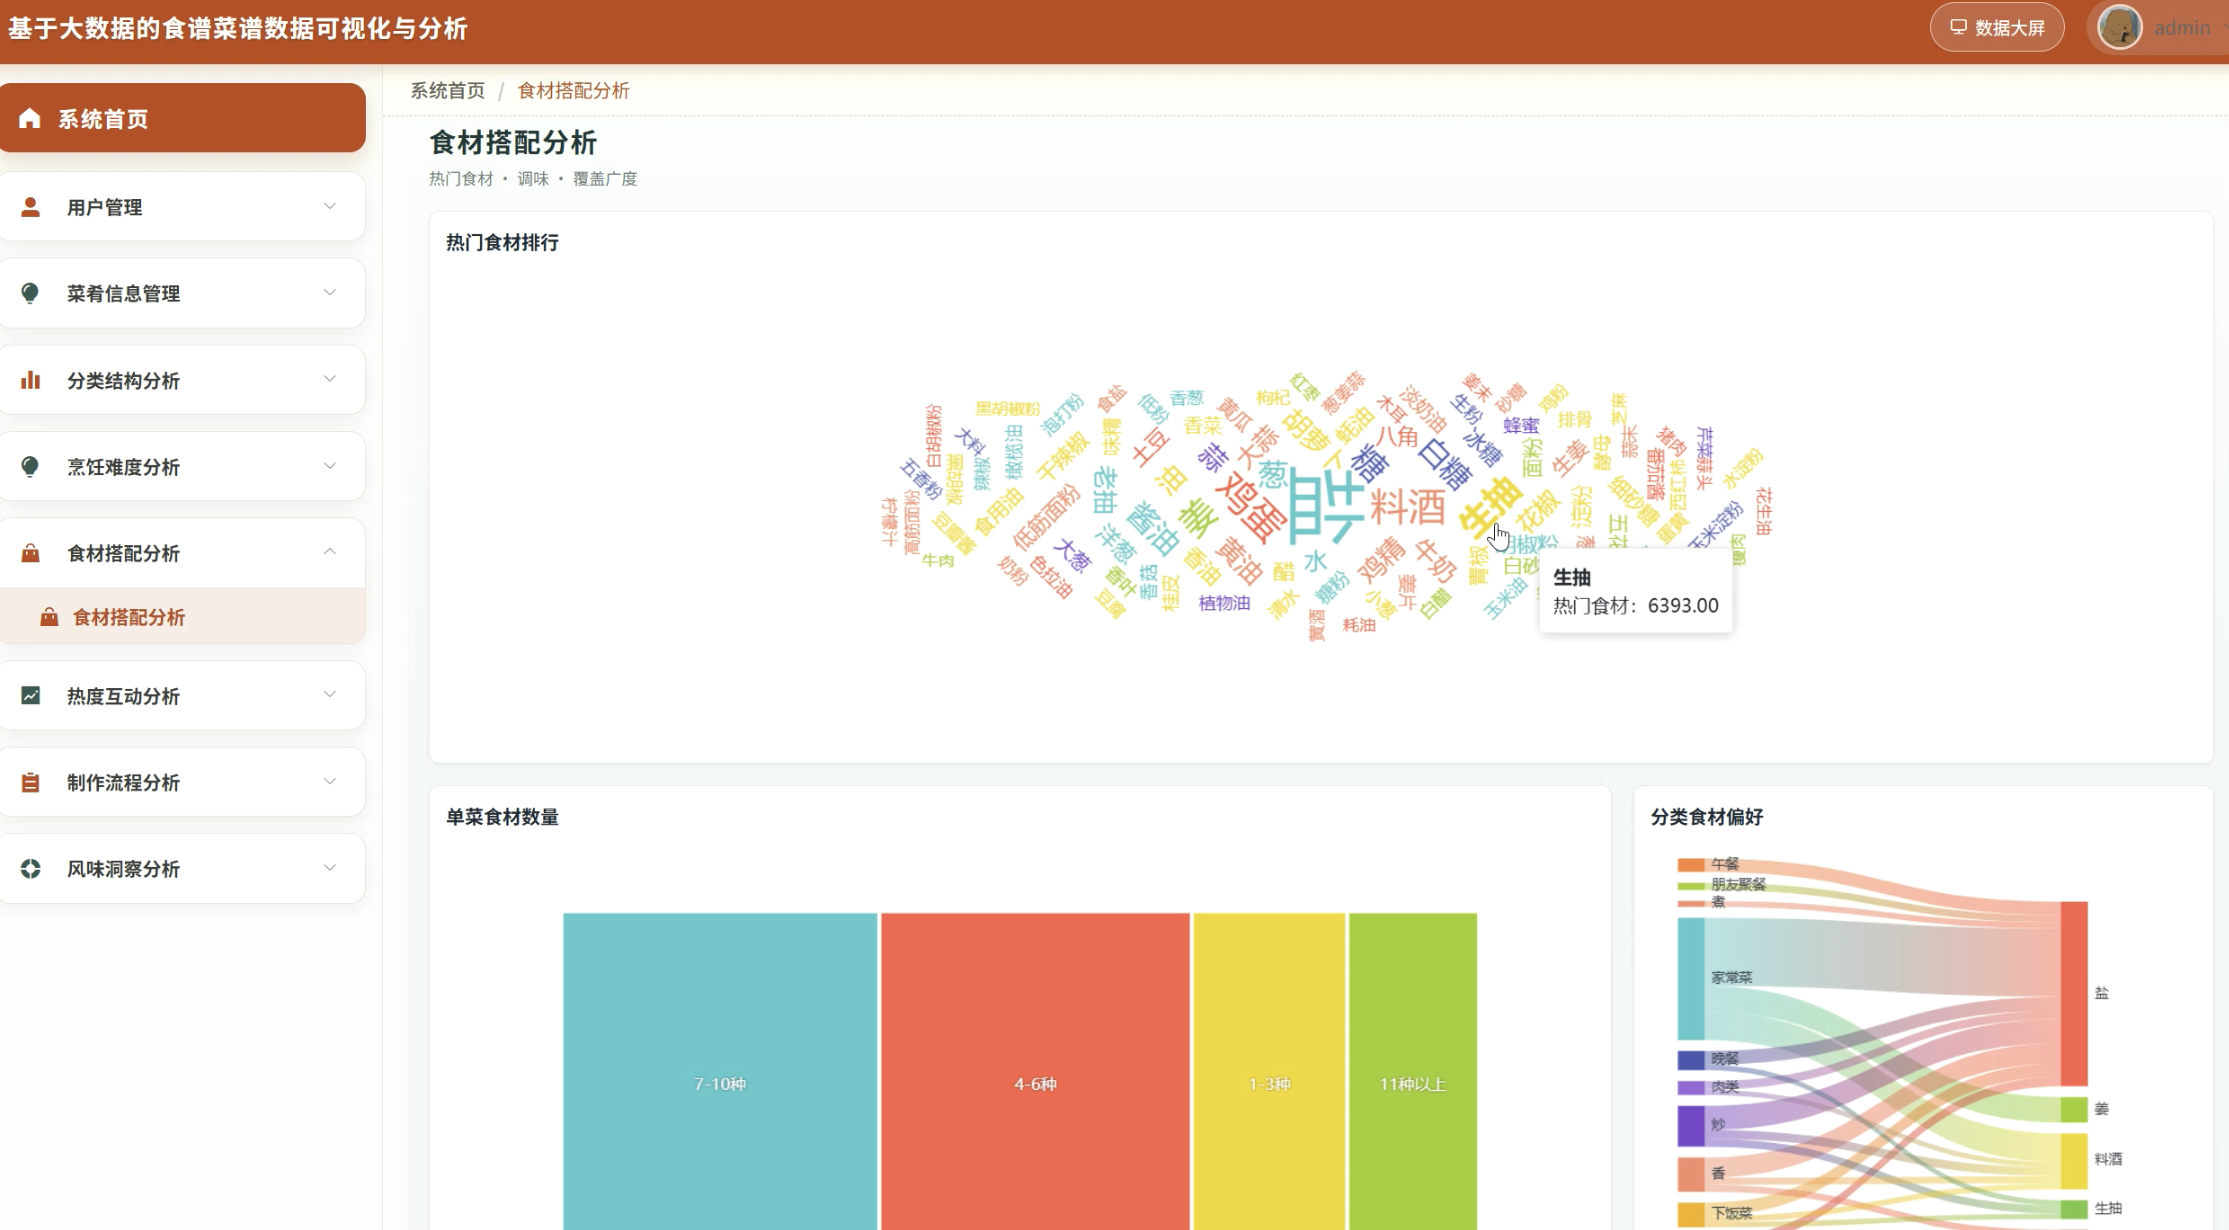
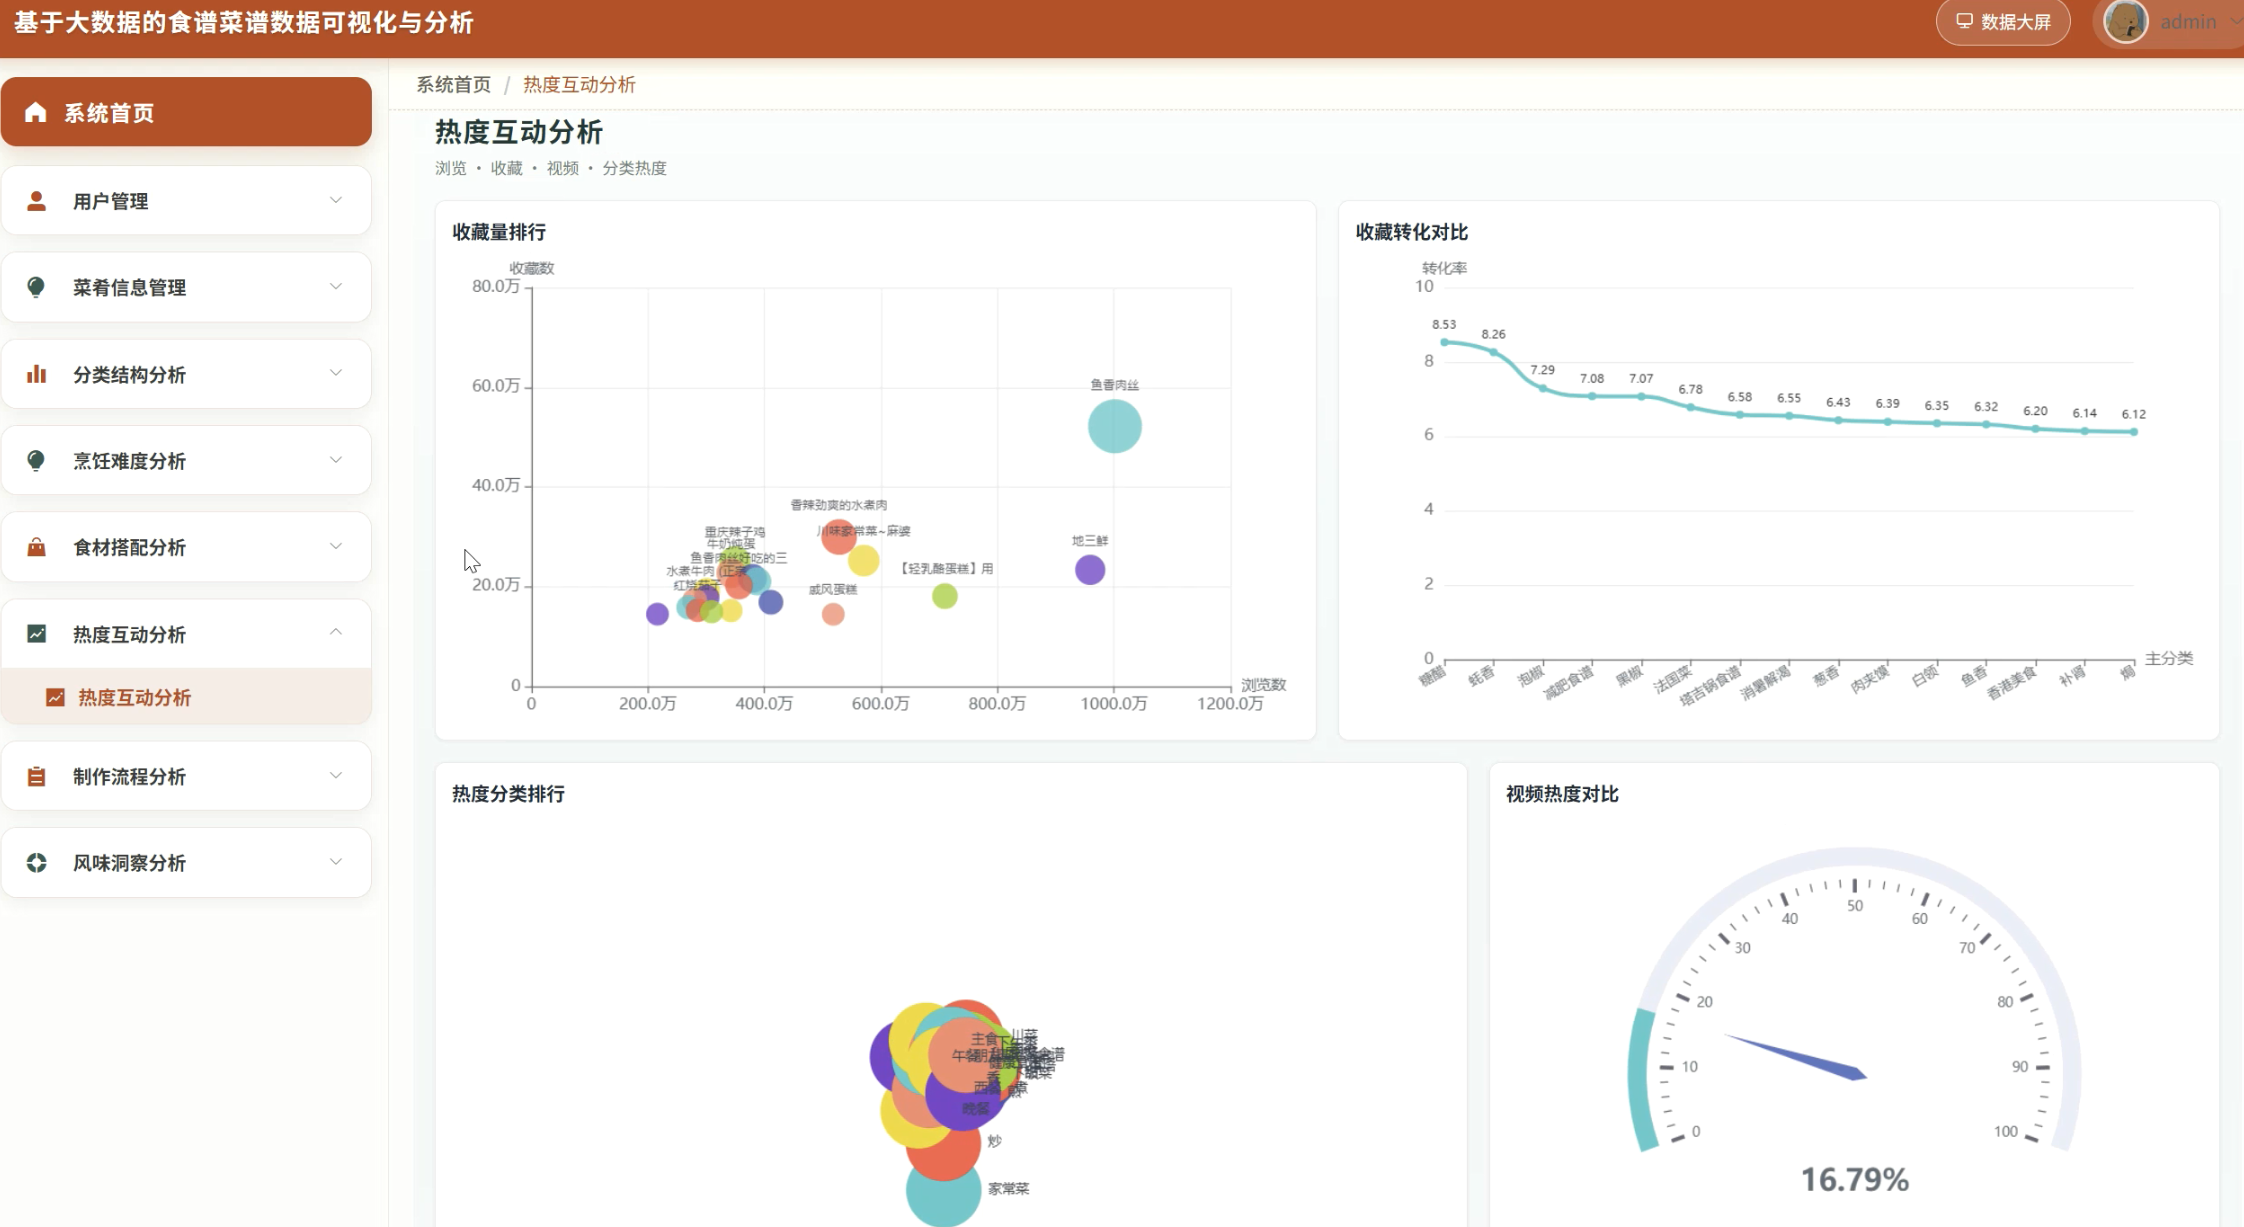
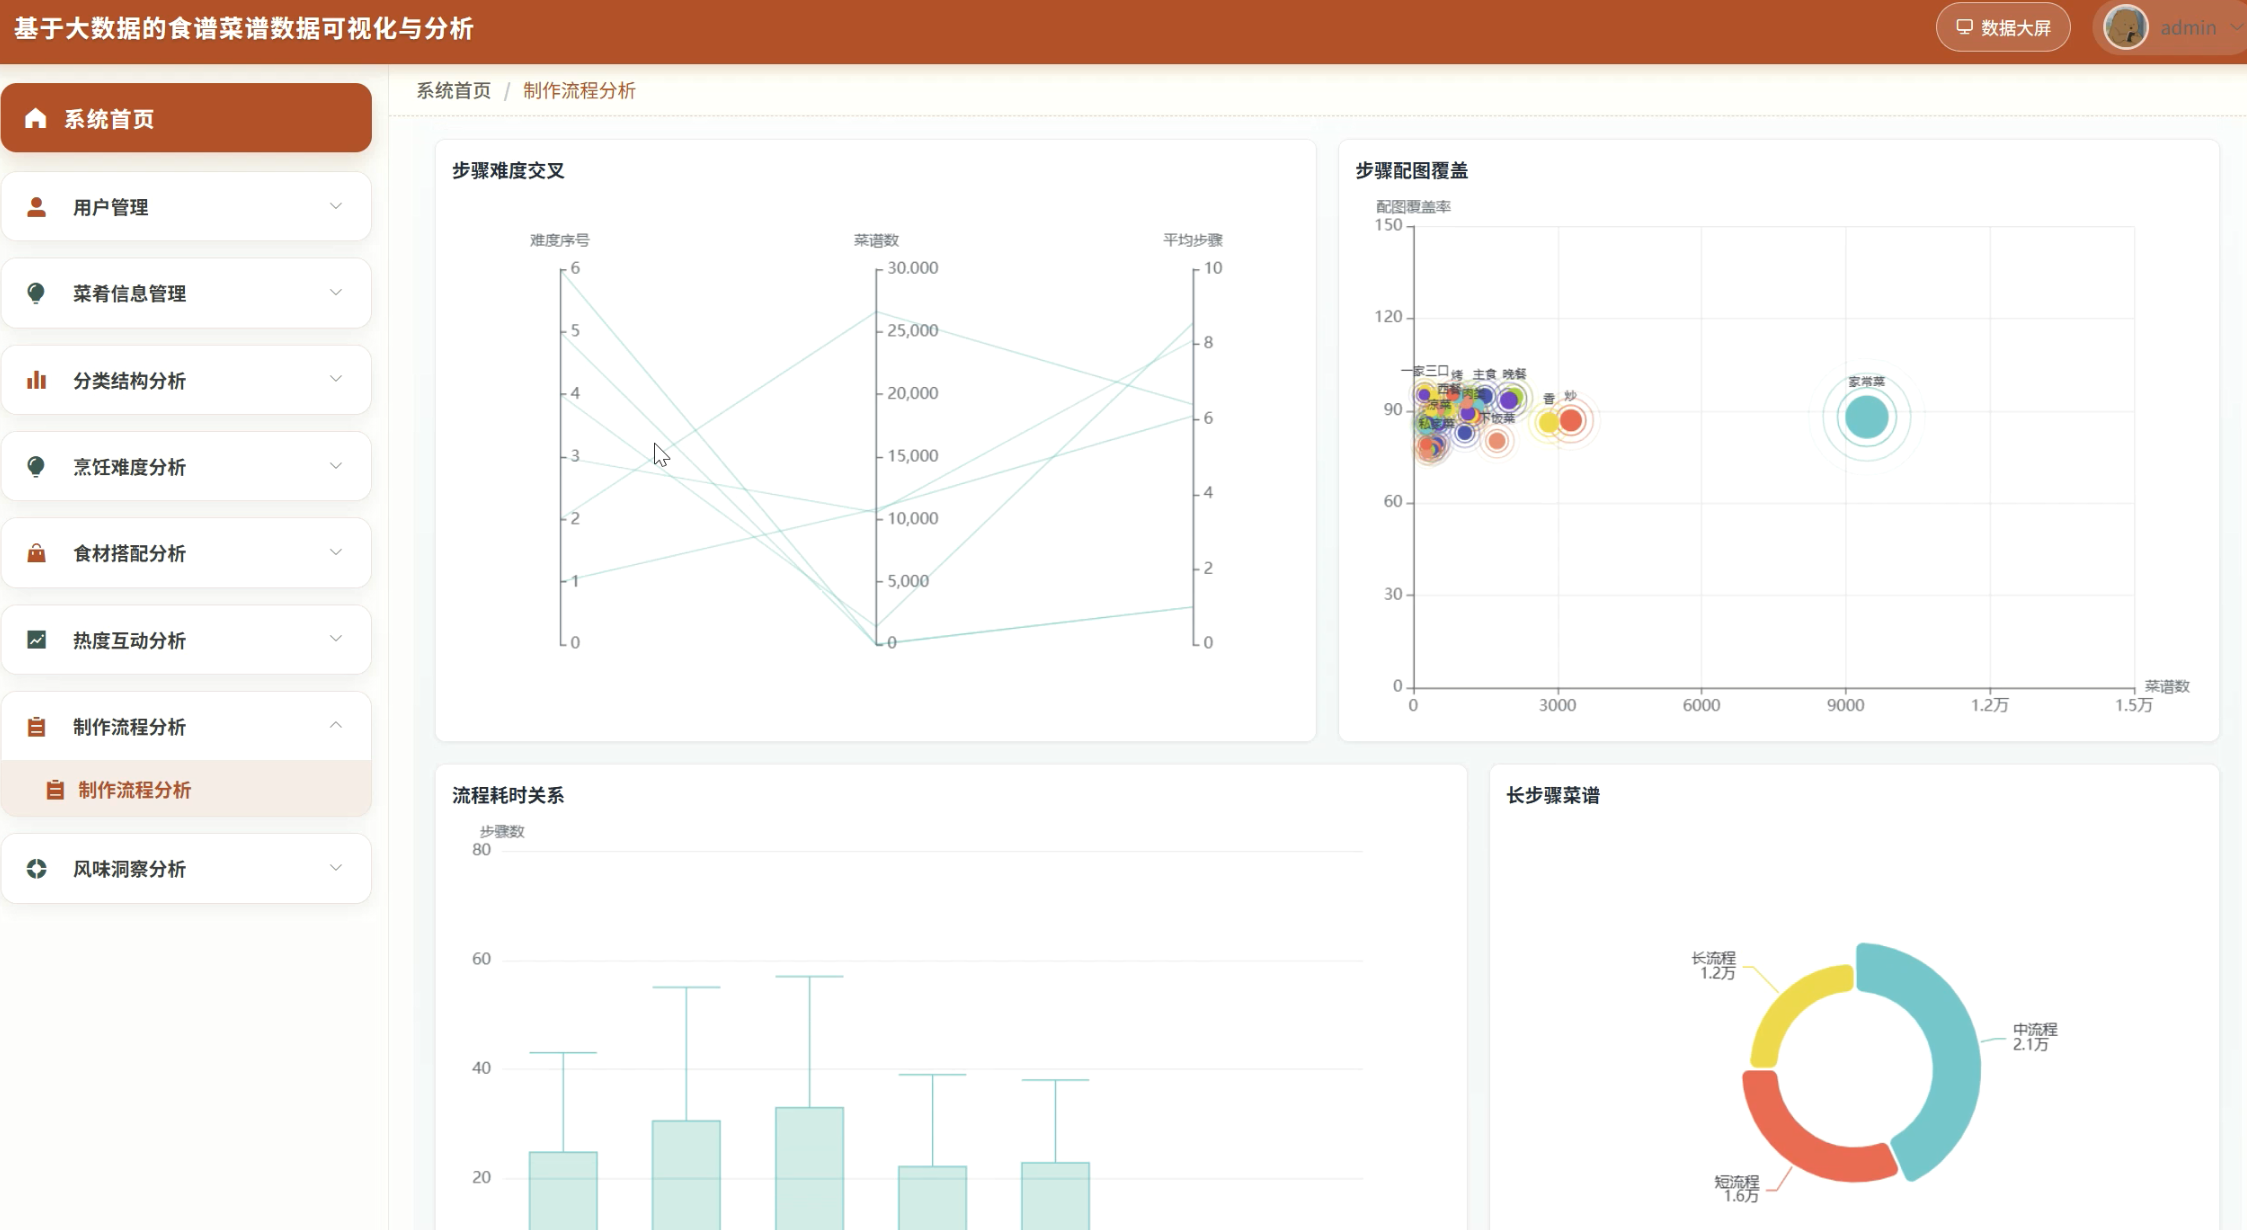
随着在线菜谱与美食分享内容不断堆积,用户面对海量菜谱时往往很难从分类结构、难度耗时、食材搭配和热度表现里一下子抓住重点,内容侧也缺少把浏览、收藏等互动指标和烹饪特征放在一起对照的抓手,再加上耗时写法杂乱、材料清单要拆分等情况,单靠人工翻阅或简单表格统计不太够用。本文通过开发一个基于大数据的食谱菜谱数据可视化与分析系统,用以帮助优化菜谱内容结构洞察与食材搭配规律发现。
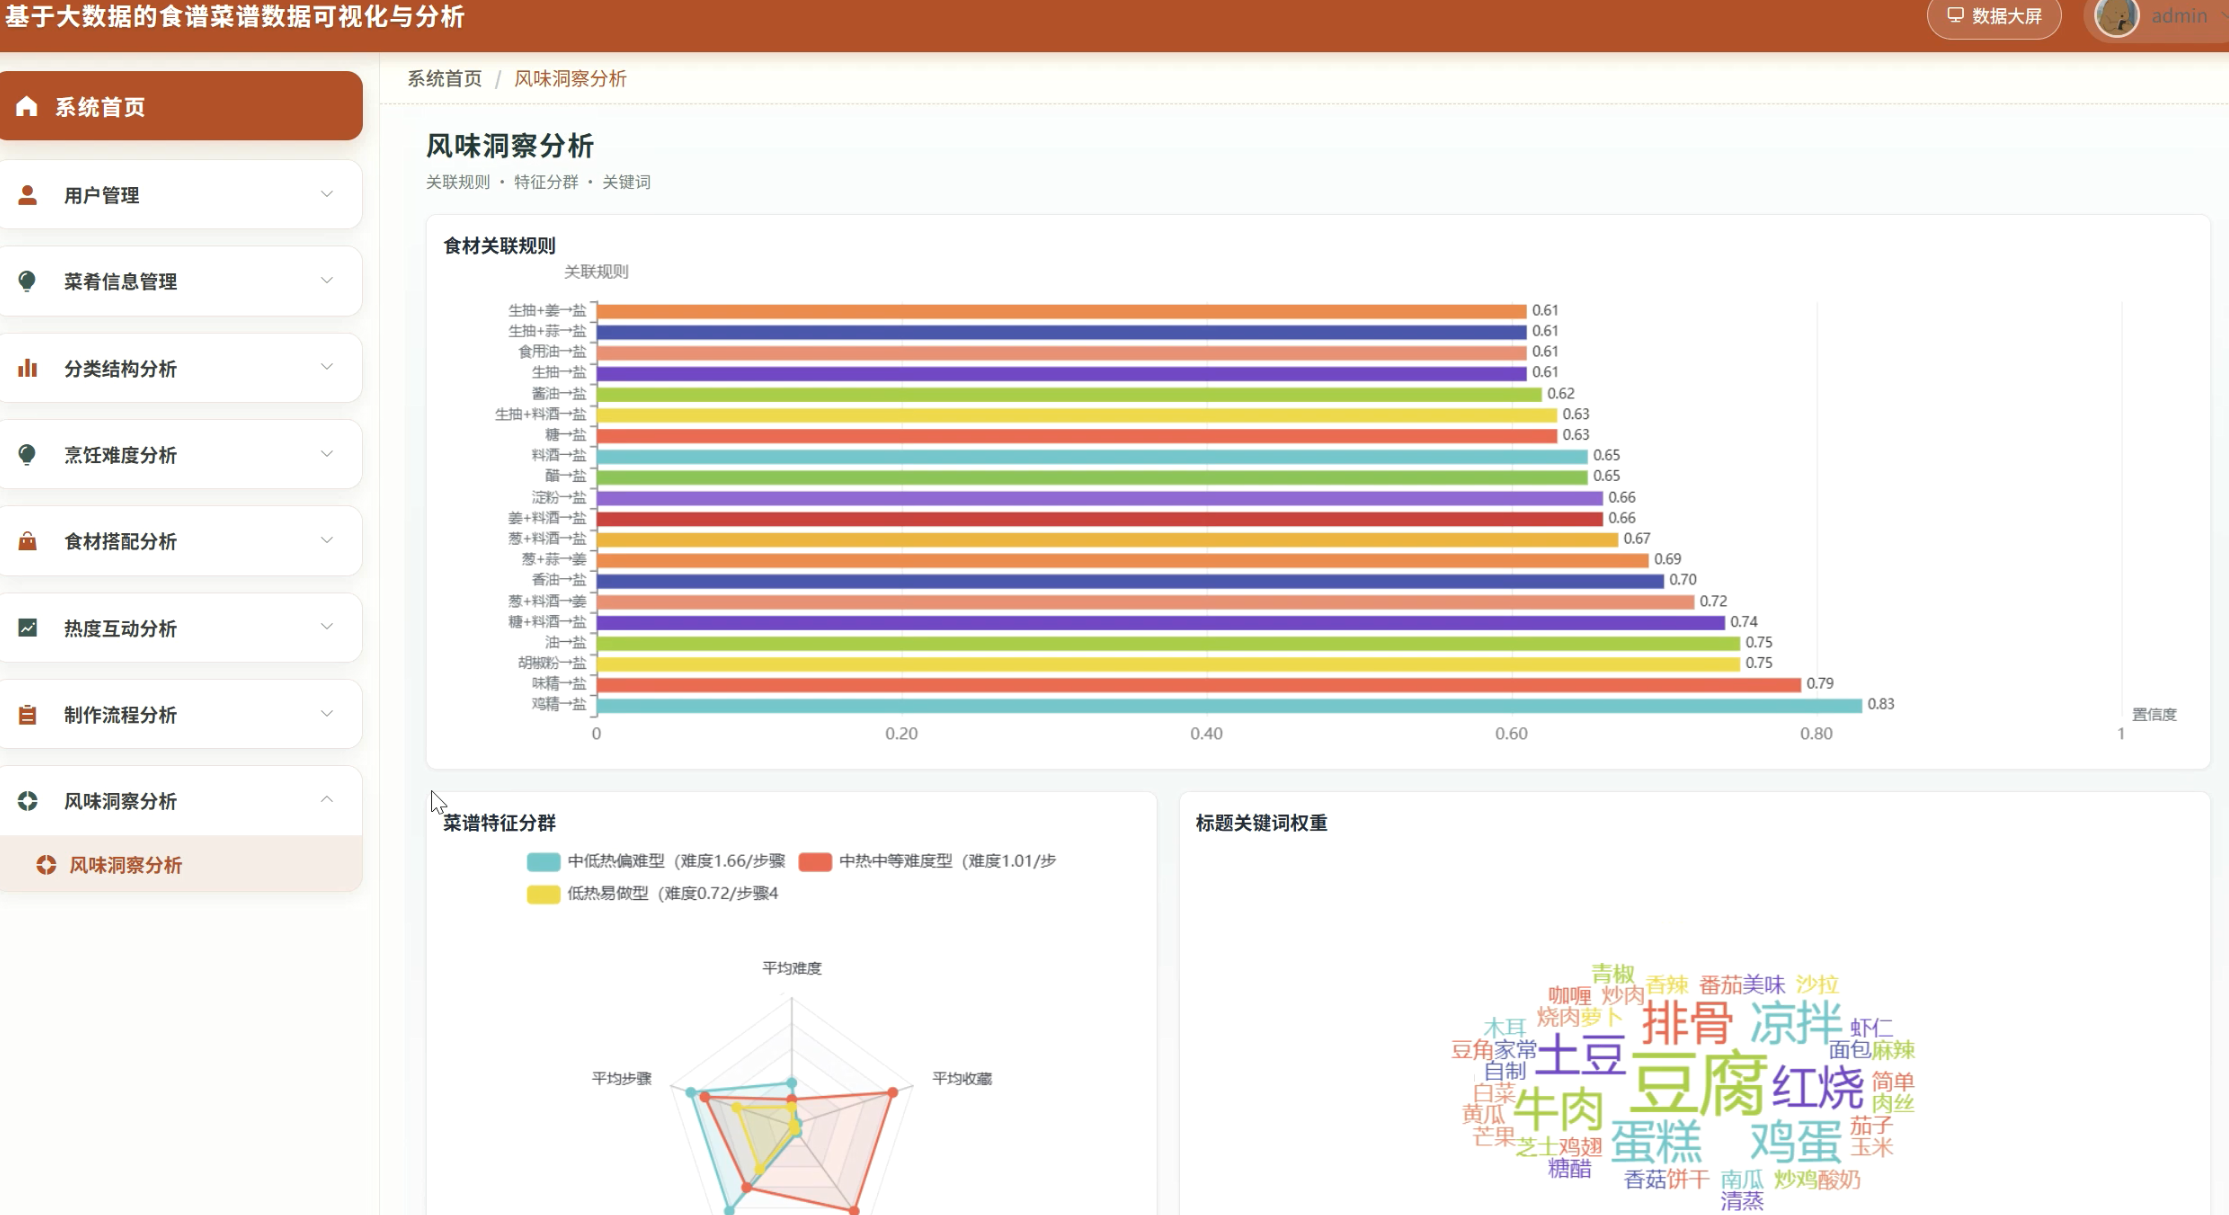
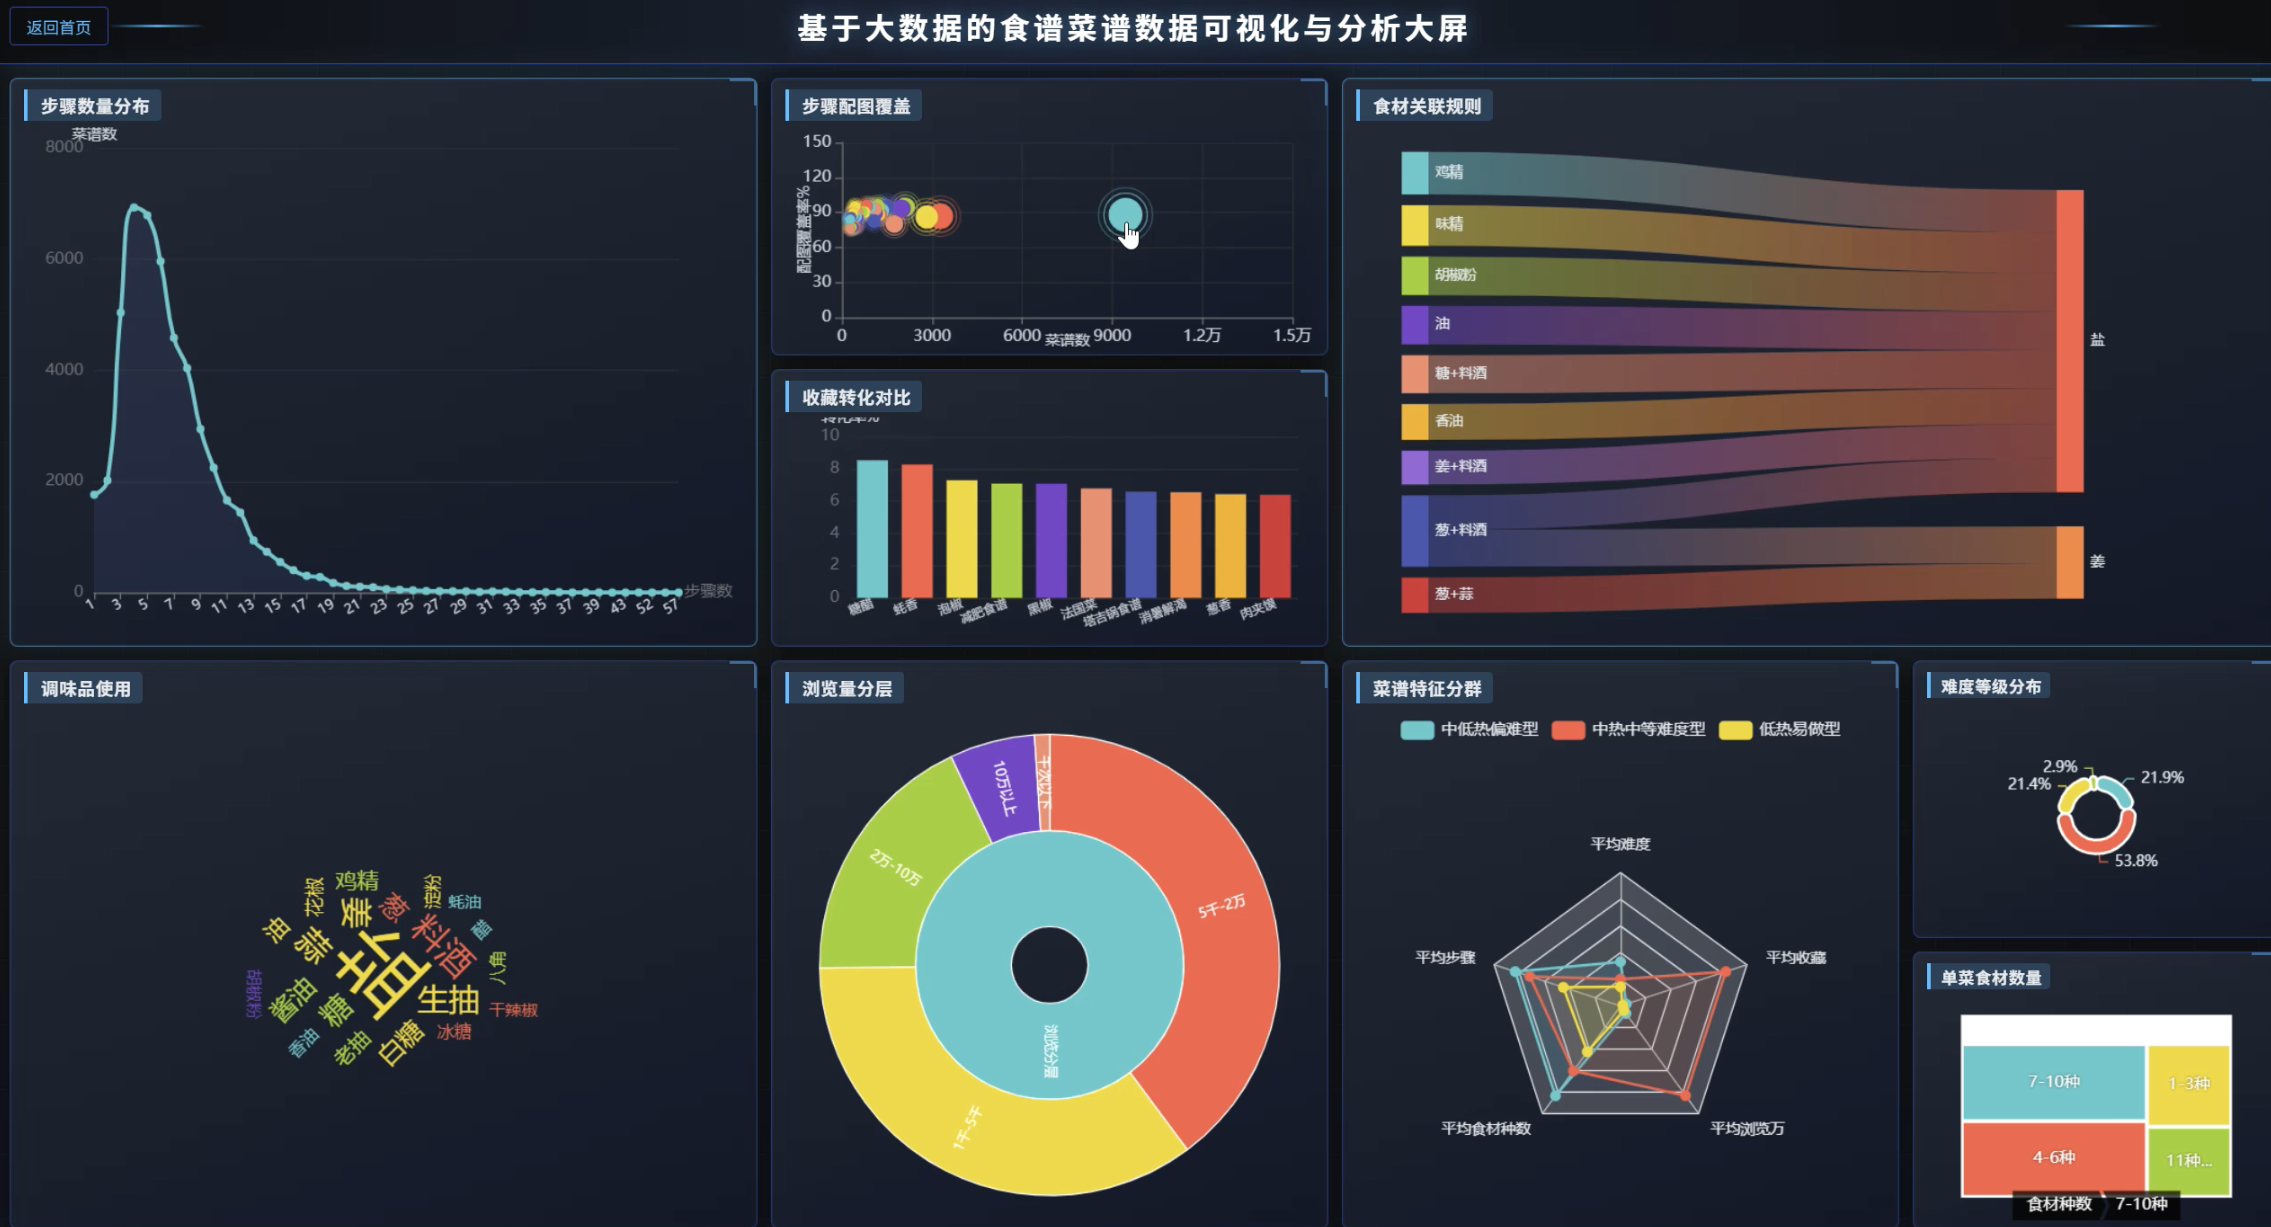
系统采用 Hadoop 做数据存取,用 Spark/PySpark 做统计与挖掘,用 Django 提供分析接口,用 Vue 与 ECharts 做页面展示,结果数据落在 MySQL,功能上覆盖分类结构、烹饪难度、食材搭配、热度互动、制作流程等常规分析,并在风味洞察里用 FP-Growth 挖食材关联、用 K-Means 做菜谱特征分群、用 TF-IDF 提标题关键词,同时提供可视化大屏和菜谱数据管理页面,方便按维度查看结果。
经过系统测试,本系统能满足计算机相关专业学生做毕设演示与答辩展示的需求,也能给关注菜谱内容的数据分析、产品运营同学提供分类供给、热度分层和搭配规则的参考,对把菜谱大数据分析流程做成可浏览、可对照的可视化站点有实际意义。
二、视频展示
三、开发环境
- 大数据技术:Hadoop、Spark、Hive
- 开发技术:Python、Django框架、Vue、Echarts
- 软件工具:Pycharm、DataGrip、Anaconda
- 可视化 工具 Echarts
四、系统展示
登录模块:
五、代码展示
def ingredient_association_rule_analysis(input_df):
    """食材关联规则:PySpark MLlib FPGrowth。"""
    work = input_df.filter(col('yl').isNotNull() & (col('yl') != ''))

    def parse_items(yl):
        if yl is None:
            return []
        parts = [p.strip() for p in str(yl).split('#') if p and p.strip()]
        norm = []
        for p in parts:
            if p == '大蒜':
                p = '蒜'
            if p not in norm:
                norm.append(p)
        return norm

    parse_udf = udf(parse_items, ArrayType(StringType()))
    baskets = (
        work.withColumn('items', parse_udf(col('yl')))
        .filter(F.size(col('items')) >= 2)
        .select('items')
    )
    fp = FPGrowth(itemsCol='items', minSupport=0.02, minConfidence=0.3)
    model = fp.fit(baskets)
    rules = model.associationRules
    result = (
        rules.withColumn('antecedent_items', F.concat_ws('+', col('antecedent')))
        .withColumn('consequent_items', F.concat_ws('+', col('consequent')))
        .withColumn('support', spark_round(col('support').cast('double'), 2))
        .withColumn('confidence', spark_round(col('confidence').cast('double'), 2))
        .withColumn('lift', spark_round(col('lift').cast('double'), 2))
        .select('antecedent_items', 'consequent_items', 'support', 'confidence', 'lift')
        .orderBy(desc('confidence'), desc('lift'))
    )
    result.toPandas().to_csv(
        os.path.join(script_dir_str, 'output', 'flavor_insight_analysis',
                     'ingredient_association_rule_analysis.csv'),
        encoding='utf-8', index=False
    )

def recipe_feature_cluster_analysis(spark, input_df):
    """菜谱特征分群:标准化 + 轮廓系数选 K + K-Means。"""
    feat_cols = ['difficulty', 'step_count', 'ingredient_count', 'viewnum', 'favnum']
    work = input_df
    for c in feat_cols:
        work = work.withColumn(c, col(c).cast('double'))
    work = work.dropna(subset=feat_cols)
    work = (
        work.withColumn('viewnum_log', F.log1p(col('viewnum')))
            .withColumn('favnum_log', F.log1p(col('favnum')))
    )
    assemble_cols = ['difficulty', 'step_count', 'ingredient_count', 'viewnum_log', 'favnum_log']
    n = work.count()

    assembler = VectorAssembler(inputCols=assemble_cols, outputCol='features_raw')
    assembled = assembler.transform(work)
    scaler = StandardScaler(inputCol='features_raw', outputCol='features', withStd=True, withMean=True)
    scaled = scaler.fit(assembled).transform(assembled)

    sample_for_eval = scaled.sample(False, min(1.0, 8000.0 / max(n, 1)), seed=42)
    best_k, best_score = 4, -1.0
    evaluator = ClusteringEvaluator(
        featuresCol='features', predictionCol='cluster_id', metricName='silhouette'
    )
    for k in range(3, 7):
        km = KMeans(featuresCol='features', predictionCol='cluster_id', k=k, seed=42, maxIter=30)
        preds = km.fit(sample_for_eval).transform(sample_for_eval)
        score = float(evaluator.evaluate(preds))
        if score > best_score:
            best_k, best_score = k, score

    kmeans = KMeans(featuresCol='features', predictionCol='cluster_id', k=best_k, seed=42, maxIter=40)
    clustered = kmeans.fit(scaled).transform(scaled)
    centers = (
        clustered.groupBy('cluster_id')
        .agg(
            spark_count(lit(1)).alias('recipe_count'),
            spark_round(spark_avg('difficulty'), 2).alias('avg_difficulty'),
            spark_round(spark_avg('step_count'), 2).alias('avg_step_count'),
            spark_round(spark_avg('ingredient_count'), 2).alias('avg_ingredient_count'),
            spark_round(spark_avg('viewnum'), 2).alias('avg_viewnum'),
            spark_round(spark_avg('favnum'), 2).alias('avg_favnum'),
        )
    )
    # 按簇心相对热度/难度贴中文标签后写出
    center_pdf = centers.toPandas().sort_values('avg_viewnum').reset_index(drop=True)
    heat_labels = ['低热', '中低热', '中热', '中高热', '高热', '极高热']
    label_map = {}
    for i, row in center_pdf.iterrows():
        heat = heat_labels[min(i, len(heat_labels) - 1)]
        diff_rank = int(center_pdf['avg_difficulty'].rank(method='min')[i])
        diff_word = ['易做', '中等难度', '偏难', '高难'][min(diff_rank - 1, 3)]
        label_map[int(row['cluster_id'])] = f"{heat}{diff_word}型"
    map_df = spark.createDataFrame(
        [(k, v) for k, v in label_map.items()], ['cluster_id', 'cluster_label_zh']
    )
    result = centers.join(map_df, on='cluster_id', how='left').orderBy('cluster_id')
    result.toPandas().to_csv(
        os.path.join(script_dir_str, 'output', 'flavor_insight_analysis',
                     'recipe_feature_cluster_analysis.csv'),
        encoding='utf-8', index=False
    )
六、项目文档展示

七、项目总结
本课题围绕「基于大数据的食谱菜谱数据可视化与分析」展开。项目以约 5 万条菜谱数据为对象,经 Hadoop 存储与 pandas 清洗后,用 Spark 完成分类结构、烹饪难度、食材搭配、热度互动、制作流程等多维统计,并在风味洞察中采用 FP-Growth 挖掘食材关联、用 K-Means 进行菜谱特征分群、用 TF-IDF 提取标题关键词。分析结果经 Django 接口接入,由 Vue 与 ECharts 呈现为分析页面与可视化大屏,同时支持菜谱数据管理。系统把菜谱从零散浏览转为可对照的量化分析,可为毕设演示、内容运营与数据分析实践提供参考。
大家可以帮忙点赞、收藏、关注、评论啦 👇🏻
💖🔥作者主页:计算机毕设木哥🔥 💖
更多推荐

 8
 0
- 0


 已为社区贡献24条内容

所有评论(0)