登录社区云,与社区用户共同成长
邀请您加入社区
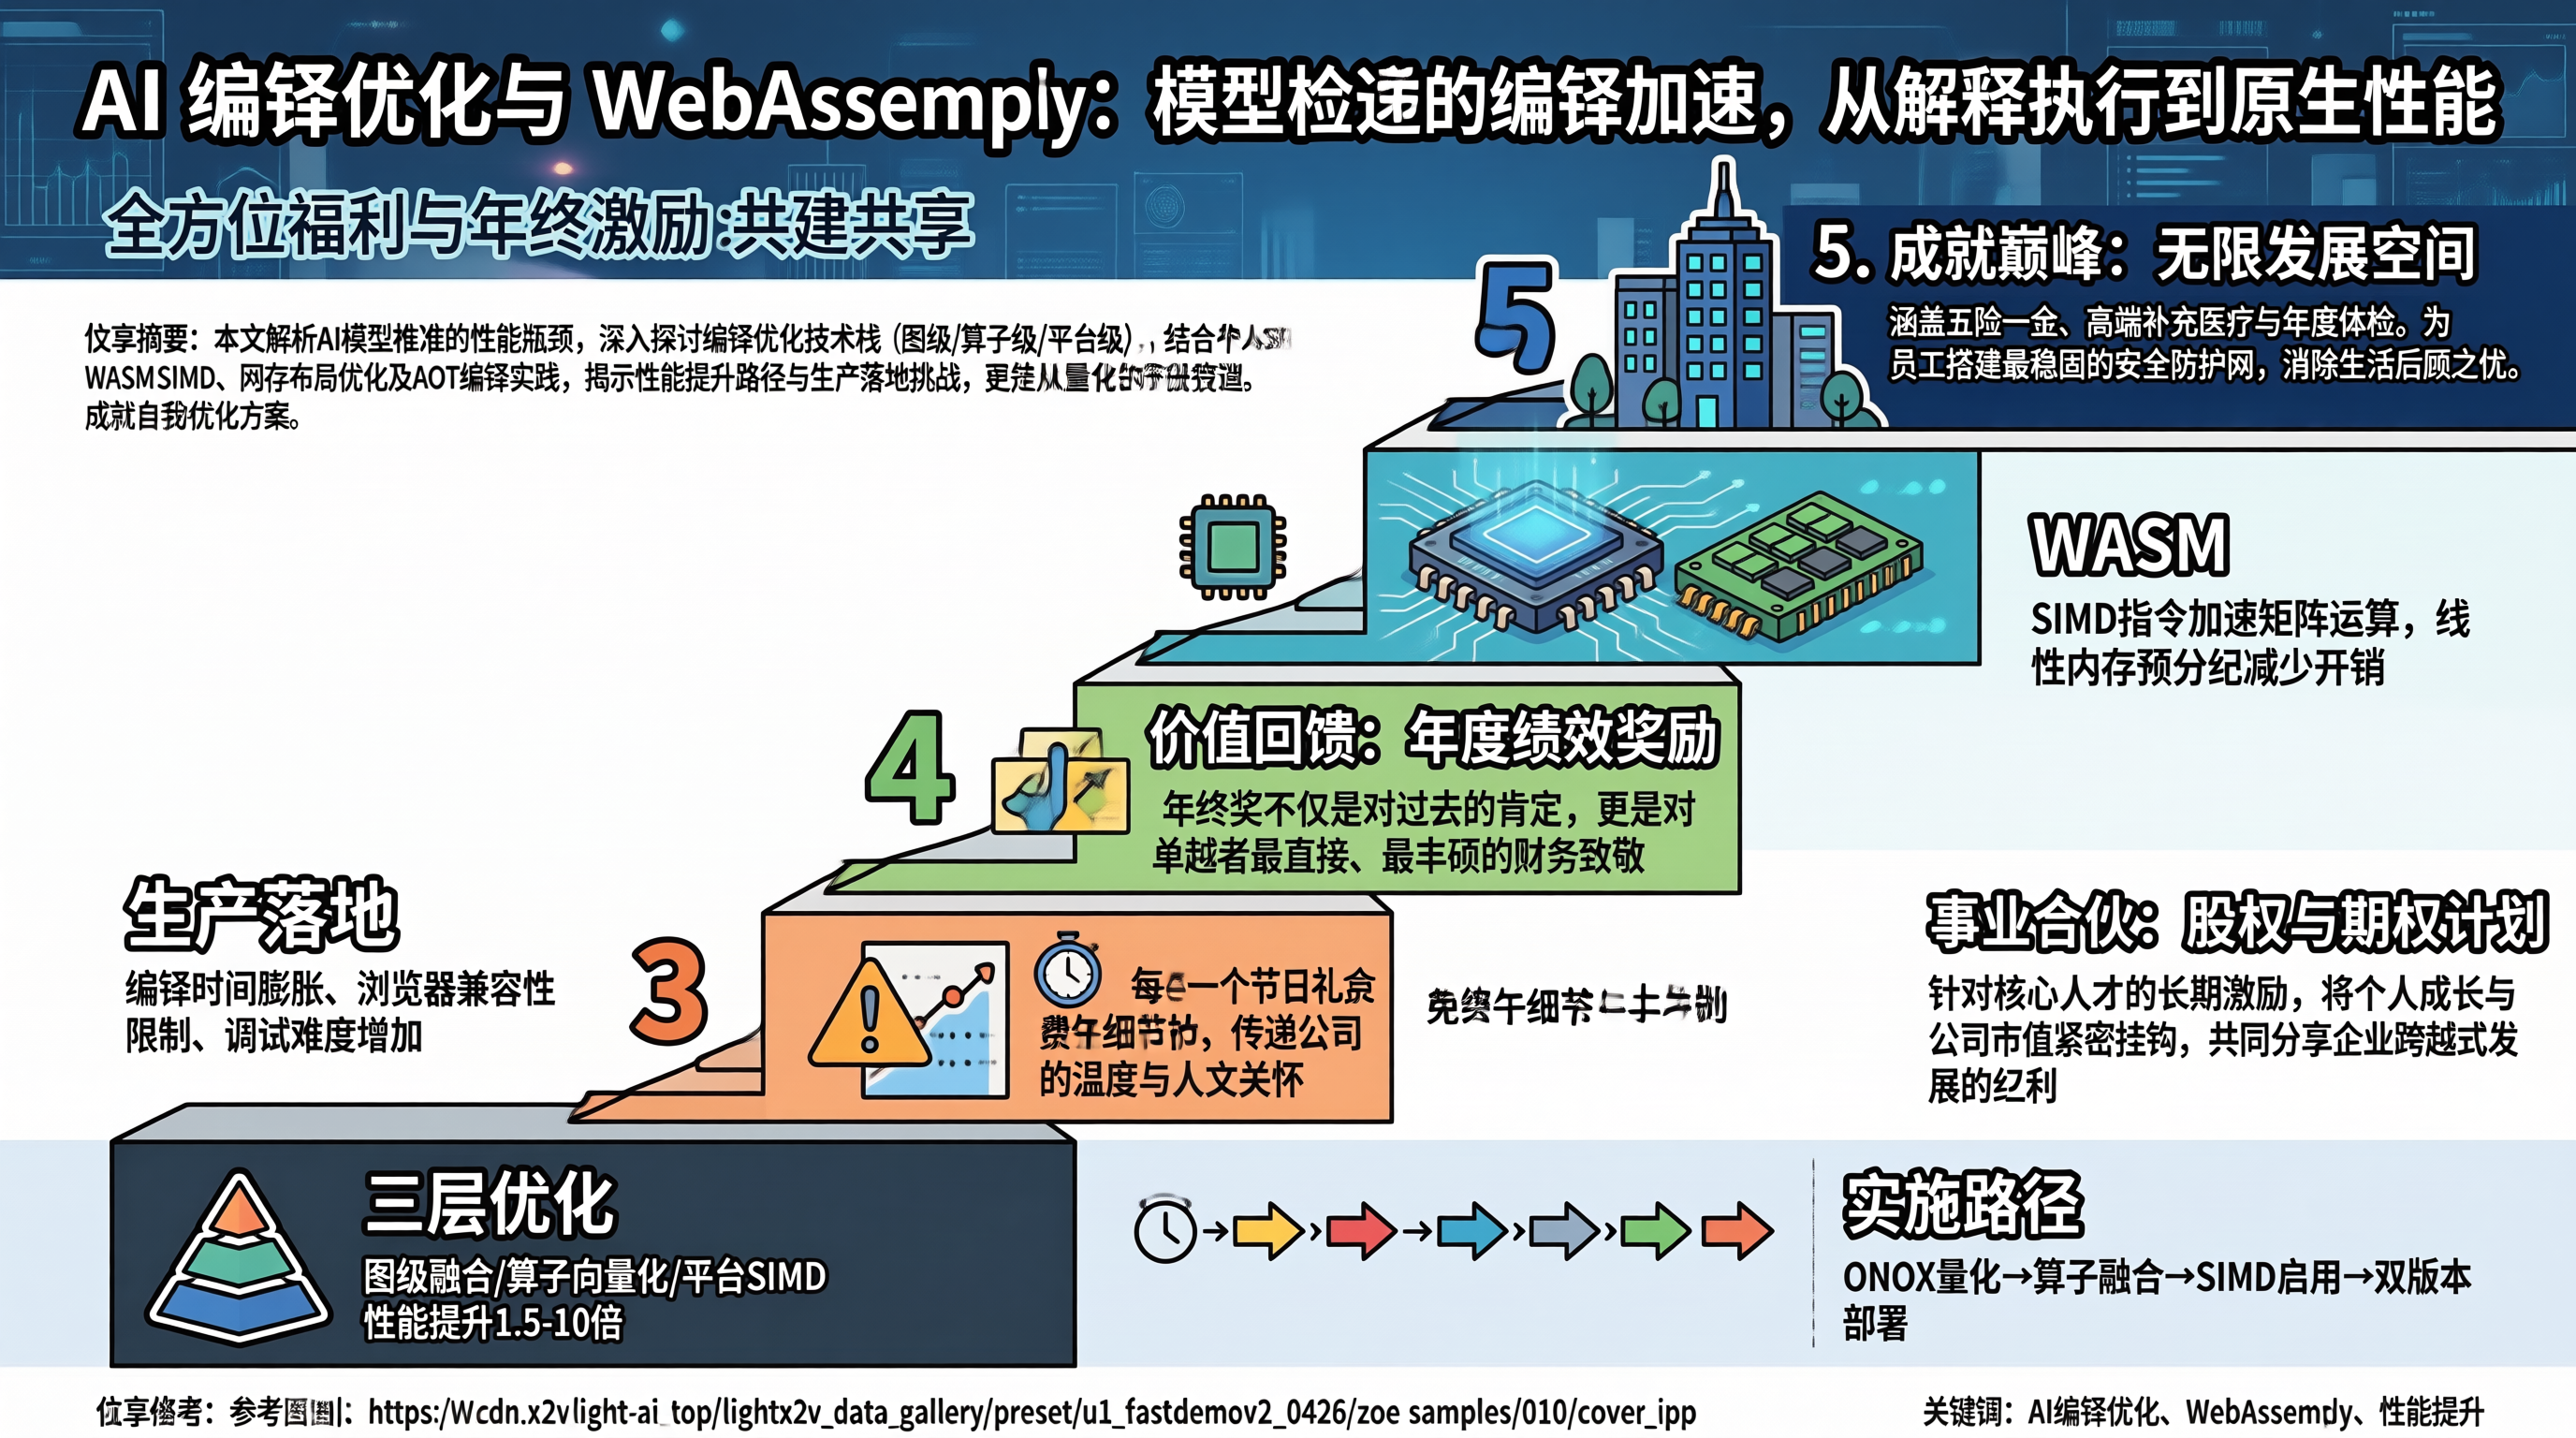
AI 推理的编译优化是提升 WASM 推理性能的关键手段。图级优化(算子融合)可以减少内存访问,算子级优化(SIMD、循环展开)可以提升计算密度,平台级优化(多线程、缓存友好)可以充分利用硬件。先用 ONNX Runtime Web 跑通推理流程,确认模型可用对模型进行 INT8 量化,减少计算量和内存占用应用算子融合等图级优化,减少内存访问次数启用 WASM SIMD,矩阵运算速度提升 2-4
AI 模型编译优化的核心链路是:模型导出 -> 计算图优化 -> 量化 -> 编译后端 -> 部署。计算图优化是零损失的基线优化,量化是精度换速度的关键手段,TensorRT 是 GPU 推理的最优后端,llama.cpp 是 CPU 推理的最优选择。落地路线建议:先做计算图优化和 FP16 量化(零门槛、低风险),确认精度可接受后再尝试 INT8 量化。GPU 部署用 TensorRT,CPU
再比如 PyTorch,它死死占据了深度学习研究 85% 的江山,因为深度学习的核心是模型权重,至于外面封装的那层皮是什么语言,PyTorch 根本不在乎。但到了 2026 年,Claude、GPT-5.5、DeepSeek 这些模型早已是“代码大神”,甚至在 SWE-bench 这种极其硬核的基准测试中,都已经达到人类高级工程师的水平。这话听着反直觉,逻辑却很硬:“Rust 编译器就像一位严苛但