Codex 类模型下载 + 本地部署实战:用 Qwen2.5-Coder 从零搭建私有 AI 编程助手
以 Qwen2.5-Coder-7B-Instruct 为例,手把手带你在本地完成下载、环境配置、模型加载与 API 服务部署。选它的原因很简单:代码能力强、无需申请授权、下载即用、中文友好,非常适合做实战教程。
一、为什么选 Qwen2.5-Coder?
-
无需授权:Hugging Face / ModelScope 直接下载,不像 Meta Code Llama 需要申请。
-
代码能力强:在 HumanEval、MBPP 等基准上表现优异,7B 版本已能胜任日常补全与生成。
-
中文友好:中英混合注释、中文需求描述都能理解。
-
生态完善:支持 transformers、vLLM、llama.cpp、Ollama 等多种部署方式。
-
量化友好:社区有 GPTQ / AWQ / GGUF 版本,低显存也能跑。
本地部署的价值:数据隐私、成本可控、可定制、低延迟。
二、硬件与软件环境准备
2.1 硬件建议
| 模型规模 | 最低显存 | 推荐配置 |
|---|---|---|
| 1.5B | 4GB | RTX 3060 / 8GB |
| 7B | 8GB(4bit量化) | RTX 3090 / 24GB |
| 7B FP16 | 16GB | RTX 4090 / 24GB |
| 14B/32B | 24GB+ | A100 / 双卡 |
没有 GPU 也可用 CPU + llama.cpp 跑 GGUF 量化模型,但速度较慢。
2.2 软件环境
-
操作系统:Ubuntu 20.04/22.04(推荐)或 Windows + WSL2
-
Python:3.10+
-
CUDA:11.8 或 12.1(与 PyTorch 版本匹配)
-
包管理:conda 或 venv
-
其他:git、git-lfs、wget
# 检查 GPU 与 CUDA
nvidia-smi
nvcc --version
三、下载模型
3.1 安装下载工具
pip install -U huggingface_hub
3.2 从 Hugging Face 下载
Qwen2.5-Coder-7B-Instruct 的官方仓库为:Qwen/Qwen2.5-Coder-7B-Instruct
直接下载(无需登录、无需授权):
huggingface-cli download Qwen/Qwen2.5-Coder-7B-Instruct \
  --local-dir ./models/qwen2.5-coder-7b-instruct
新版
huggingface_hub(0.23+)默认下载真实文件,不需要--local-dir-use-symlinks参数。
若下载中断,重新执行同一命令即可自动续传。
3.3 国内加速方案
如果直连 HF 慢,用镜像:
export HF_ENDPOINT=https://hf-mirror.com
huggingface-cli download Qwen/Qwen2.5-Coder-7B-Instruct \
  --local-dir ./models/qwen2.5-coder-7b-instruct
3.4 从 ModelScope 下载(国内推荐)
pip install modelscope
modelscope download --model Qwen/Qwen2.5-Coder-7B-Instruct \
  --local_dir ./models/qwen2.5-coder-7b-instruct
ModelScope 上 Qwen 系列由官方维护,ID 与 HF 一致,下载速度通常更快。
3.5 低显存用户的替代方案
如果显存不足,可直接下载社区量化版:
-
GPTQ:
Qwen/Qwen2.5-Coder-7B-Instruct-GPTQ-Int4 -
AWQ:
Qwen/Qwen2.5-Coder-7B-Instruct-AWQ -
GGUF:
Qwen/Qwen2.5-Coder-7B-Instruct-GGUF(配 llama.cpp / Ollama)
四、创建虚拟环境与安装依赖
conda create -n qwen-coder python=3.10 -y
conda activate qwen-coder

# 安装 PyTorch(按 CUDA 版本选择,cu121 需驱动 ≥ 530)
pip install torch torchvision torchaudio --index-url https://download.pytorch.org/whl/cu121

# 安装推理依赖
pip install transformers accelerate sentencepiece einops
pip install bitsandbytes   # 4bit/8bit 量化
pip install fastapi uvicorn  # 用于 API 服务
五、本地加载与推理测试
先用最小脚本验证模型能否正常加载。
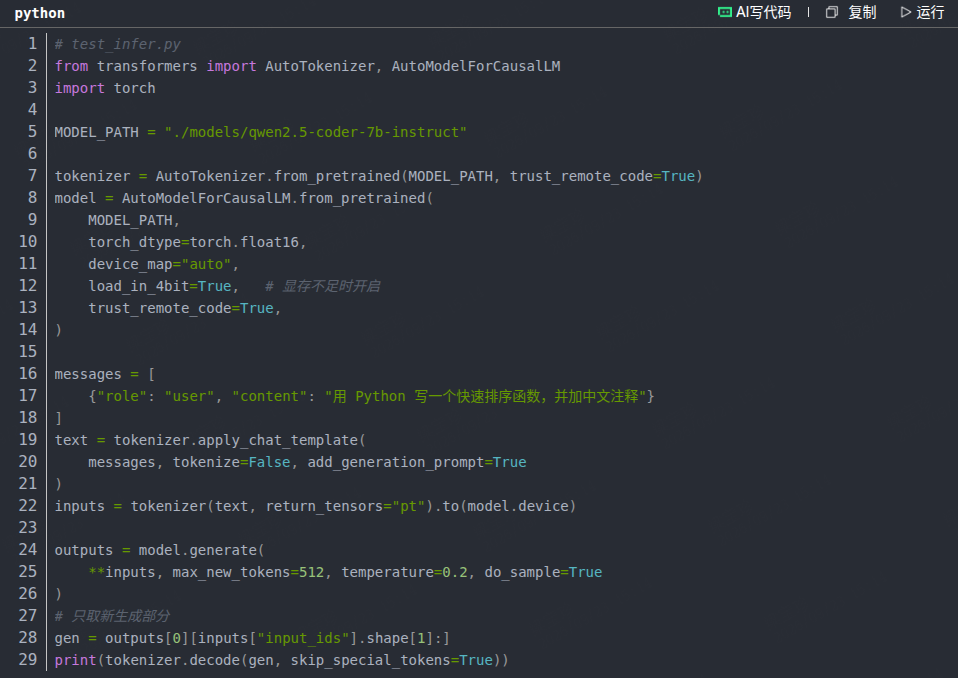
运行:python test_infer.py
能正常输出带注释的快排代码,说明加载成功。
注意:Qwen 系列必须用
apply_chat_template构造对话格式,直接拼字符串效果会变差。
六、部署为本地 API 服务
要让编辑器(VS Code、JetBrains)或自研工具调用,需要暴露 HTTP 接口。
6.1 方案 A:vLLM(推荐,吞吐高)
vLLM 对 Qwen2.5 支持良好,且自带 OpenAI 兼容接口:
pip install vllm

# 新版推荐写法
vllm serve ./models/qwen2.5-coder-7b-instruct \
  --host 0.0.0.0 --port 8000 \
  --max-model-len 8192
显存不足可加
--quantization awq(需下载 AWQ 版)或--gpu-memory-utilization 0.9。
启动后即为 OpenAI 兼容接口,可直接测试:
curl http://127.0.0.1:8000/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{
    "model": "./models/qwen2.5-coder-7b-instruct",
    "messages": [{"role":"user","content":"写一个二分查找"}],
    "max_tokens": 256
  }'
6.2 方案 B:FastAPI 自建(轻量可控)
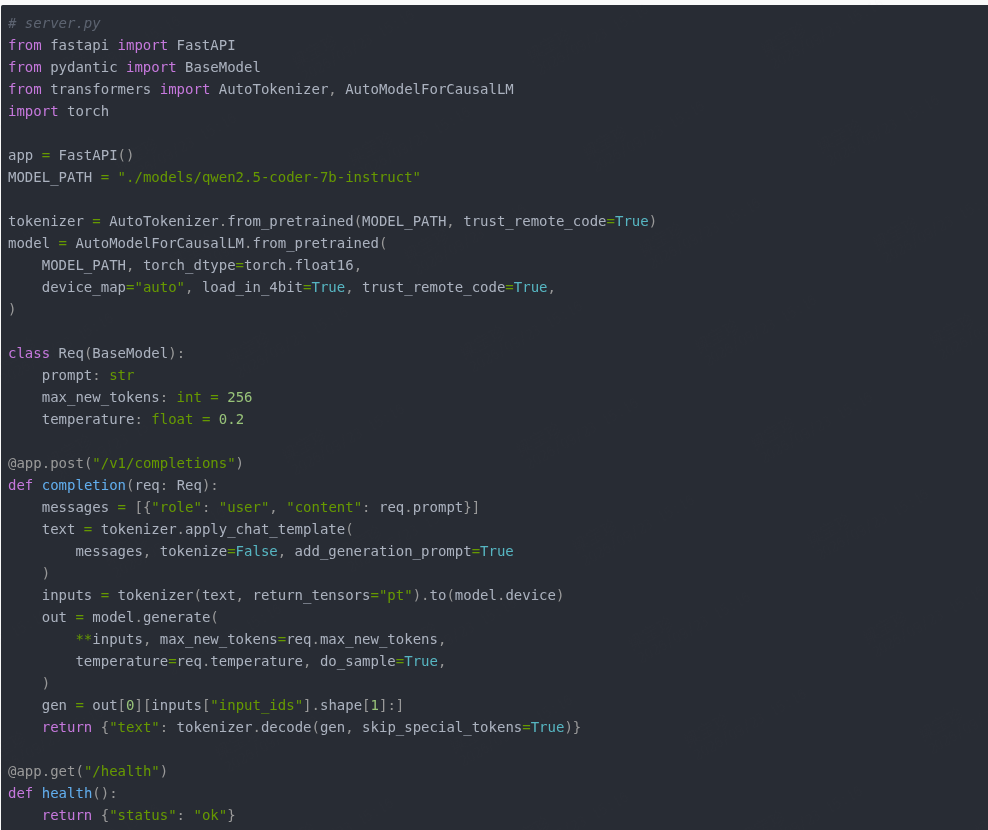
启动:
uvicorn server:app --host 0.0.0.0 --port 8000
6.3 接入 VS Code(可选)
安装 Continue 插件,在配置中填入:
{
  "models": [{
    "title": "Local Qwen Coder",
    "provider": "openai",
    "model": "qwen2.5-coder-7b-instruct",
    "apiBase": "http://127.0.0.1:8000/v1",
    "apiKey": "none"
  }]
}
免费领 150 小时云算力,进群参与显卡、AI PC 幸运抽奖
更多推荐
 0
 0
- 0


 已为社区贡献1条内容

所有评论(0)