别再给AI工具充会员了!2026本地搭建全栈AI工作台,全套代码开箱即用
最近不少同行跟我吐槽:现在AI工具是真多,但个个都要充会员。聊天要会员、识图转文字要会员、文档知识库要会员,连个批量处理文件的AI工具都要按月收费。算下来一个月大几十上百,关键是公司代码、项目文档这些敏感数据根本不敢往云端传。作为折腾了两年本地AI的老开发,今天就给大家出一套完整的个人AI工作台搭建教程。大模型对话、图文识别、私有知识库、自动化Agent四大核心功能,全部本地运行,数据不出本机,不用花一分钱,复制代码就能跑通。亲测8G显存的游戏本就能流畅跑,适合程序员自用或者小团队内部部署,彻底告别AI会员焦虑。
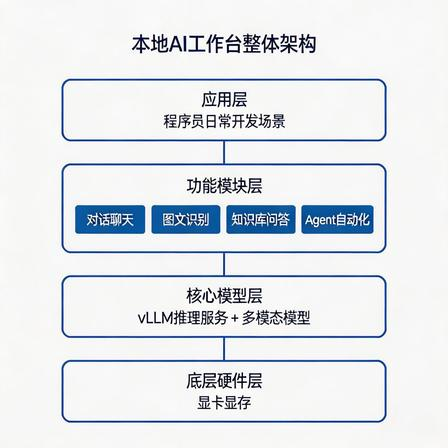
先上整体架构,心里有谱:
一、环境准备:5分钟搭好基础环境
1.1 硬件门槛
- 显卡:显存8G起步(N卡优先,支持CUDA),16G显存体验最佳
- 内存:16G以上
- 系统:Windows/WSL2/Linux都可以,生产环境推荐Linux
1.2 一键安装全部依赖
打开终端直接执行,所有用到的库一次性装完,避免反复踩坑:
pip install vllm transformers torch chromadb langchain pypdf pillow sentence-transformers python-dotenv
踩坑提醒:vLLM建议在CUDA 12.1+环境下运行;Windows用户推荐用WSL2安装,兼容性比原生Windows好很多。
二、模块1:本地高速大模型服务 兼容OpenAI接口
很多人用本地模型都觉得慢、不好对接工具,其实用vLLM搭建一个兼容OpenAI格式的接口,所有支持OpenAI的工具都能无缝对接,速度还比原生推理快好几倍。
2.1 核心优势
- 分页注意力机制 + 投机解码,推理速度比原生Transformers快3-5倍
- 完全兼容OpenAI API格式,LangChain、各种插件直接复用
- 本地部署,数据不联网,敏感信息放心用
2.2 完整代码:启动本地AI接口
① 启动服务脚本(start_llm_server.py)
import subprocess
import sys
def start_llm_server():
# 使用Qwen2-7B-Instruct,中文效果好,7B参数门槛低
# 开启投机解码,用1.5B小模型做预生成,大幅提升速度
cmd = [
sys.executable, "-m", "vllm.entrypoints.openai.api_server",
"--model", "Qwen/Qwen2-7B-Instruct",
"--speculative-model", "Qwen/Qwen2-1.5B-Instruct",
"--num-speculative-tokens", "5",
"--port", "8000",
"--api-key", "local_ai_key",
"--gpu-memory-utilization", "0.8"
]
print("正在启动本地大模型服务...")
print("服务地址:http://localhost:8000/v1")
print("API Key:local_ai_key")
subprocess.run(cmd)
if name == "main":
start_llm_server()
② 调用测试脚本(test_chat.py)
from openai import OpenAI
对接本地vLLM服务,和调用官方OpenAI完全一样
client = OpenAI(
base_url="http://localhost:8000/v1",
api_key="local_ai_key"
)
def chat(prompt):
response = client.chat.completions.create(
model="Qwen/Qwen2-7B-Instruct",
messages=[
{"role": "system", "content": "你是一个专业的程序员助手,回答简洁准确,附带代码示例"},
{"role": "user", "content": prompt}
],
temperature=0.7,
max_tokens=1024
)
return response.choices[0].message.content
if name == "main":
result = chat("写一个Python单例模式的实现,带线程安全")
print(result)
实战心得:启动服务后,你平时用的所有OpenAI客户端、浏览器插件、IDE插件,都可以改成本地地址直接用,相当于自己搭了个私有ChatGPT。
三、模块2:本地批量图文识别 代码/文档/表格全搞定
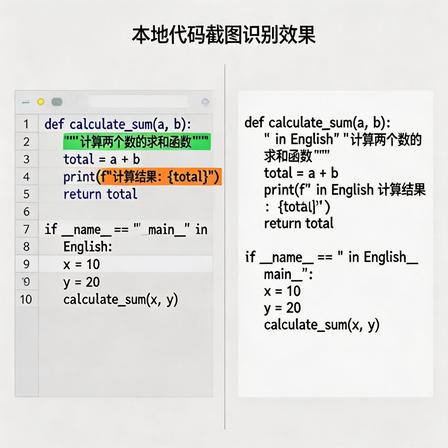
网上截图转文字、代码识别工具大多要会员,还怕上传代码泄密。我们用原生多模态模型本地实现批量识别,代码截图、文档照片、表格图片都能精准识别。
3.1 功能说明
- 支持批量识别文件夹下所有图片
- 精准识别代码、普通文字、表格内容
- 可自定义输出格式,自动保存为文本文件
识别效果直观对比:
3.2 完整代码:批量图片识别工具
import os
from transformers import Qwen2VLForConditionalGeneration, AutoProcessor
from PIL import Image
加载模型,7B版本8G显存就能跑
model = Qwen2VLForConditionalGeneration.from_pretrained(
"Qwen/Qwen2-VL-7B-Instruct",
device_map="auto",
torch_dtype="auto"
)
processor = AutoProcessor.from_pretrained("Qwen/Qwen2-VL-7B-Instruct")
def recognize_image(image_path, output_type="text"):
"""识别单张图片内容
output_type: text-纯文本, code-代码格式, table-表格格式
"""
image = Image.open(image_path).convert("RGB")
prompt_map = {
    "text": "请准确识别图片中的所有文字,按原格式输出",
    "code": "请识别图片中的所有代码,输出完整可运行的代码,保留格式",
    "table": "请识别图片中的表格,输出Markdown格式的表格"
}

conversation = [
    {
        "role": "user",
        "content": [
            {"type": "image"},
            {"type": "text", "text": prompt_map.get(output_type, prompt_map["text"])}
        ]
    }
]

text_prompt = processor.apply_chat_template(conversation, add_generation_prompt=True)
inputs = processor(
    text=[text_prompt],
    images=[image],
    padding=True,
    return_tensors="pt"
).to("cuda")

output = model.generate(**inputs, max_new_tokens=2048, temperature=0.2)
result = processor.decode(output[0], skip_special_tokens=True)
return result
def batch_recognize(input_dir="./images", output_dir="./output", output_type="text"):
"""批量识别目录下的所有图片"""
os.makedirs(output_dir, exist_ok=True)
image_files = [f for f in os.listdir(input_dir)
if f.lower().endswith(('.png', '.jpg', '.jpeg', '.bmp'))]
for img_file in image_files:
    img_path = os.path.join(input_dir, img_file)
    print(f"正在识别:{img_file}")

    try:
        result = recognize_image(img_path, output_type)
        # 保存结果
        output_file = os.path.join(output_dir, f"{os.path.splitext(img_file)[0]}.txt")
        with open(output_file, "w", encoding="utf-8") as f:
            f.write(result)
        print(f"保存完成:{output_file}")
    except Exception as e:
        print(f"识别失败 {img_file}:{e}")
if name == "main":
# 批量识别images目录下的代码截图,输出到output目录
batch_recognize(input_dir="./images", output_dir="./output", output_type="code")
拓展玩法:配合系统截图工具,写个快捷键脚本,一键截图识别,开发效率直接拉满,比任何付费识图工具都香。
四、模块3:本地私有知识库 项目文档 / 学习笔记随心查
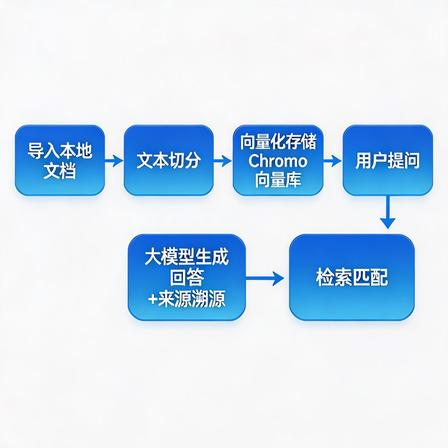
云端知识库总担心数据安全,自己搭一个本地RAG知识库,项目文档、学习笔记、技术规范全部导进去,自然语言就能检索问答,回答自动带原文引用,杜绝幻觉。
4.1 支持格式
- Markdown笔记
- PDF文档
- 代码文件
- TXT文本
完整工作流程如下:
4.2 完整代码:本地知识库问答系统
import os
from langchain_community.document_loaders import DirectoryLoader, PyPDFLoader
from langchain.text_splitter import RecursiveCharacterTextSplitter
from langchain_community.embeddings import HuggingFaceEmbeddings
from langchain_community.vectorstores import Chroma
from langchain.chains import RetrievalQA
from langchain_openai import ChatOpenAI

# ===================== 构建知识库 =====================
def build_knowledge_base(doc_dir="./docs", db_path="./local_kb"):
    # 加载所有支持的文档
    documents = []

    # 加载Markdown和TXT
    md_loader = DirectoryLoader(doc_dir, glob="**/*.md", show_progress=True)
    documents.extend(md_loader.load())
    txt_loader = DirectoryLoader(doc_dir, glob="**/*.txt", show_progress=True)
    documents.extend(txt_loader.load())

    # 加载PDF
    pdf_files = [os.path.join(doc_dir, f) for f in os.listdir(doc_dir)
                 if f.lower().endswith('.pdf')]
    for pdf in pdf_files:
        pdf_loader = PyPDFLoader(pdf)
        documents.extend(pdf_loader.load())

    # 文本切分
    text_splitter = RecursiveCharacterTextSplitter(
        chunk_size=600,
        chunk_overlap=80,
        separators=["\n\n", "\n", "。", " ", ""]
    )
    split_docs = text_splitter.split_documents(documents)
    print(f"文档切分完成,共{len(split_docs)}个文本块")

    # 构建向量数据库
    embeddings = HuggingFaceEmbeddings(
        model_name="all-MiniLM-L6-v2",
        model_kwargs={"device": "cuda"}
    )

    vector_db = Chroma.from_documents(
        documents=split_docs,
        embedding=embeddings,
        persist_directory=db_path
    )
    vector_db.persist()
    print("知识库构建完成,已保存到本地")
    return vector_db

# ===================== 问答系统 =====================
def get_qa_chain(vector_db):
    # 对接本地大模型服务
    llm = ChatOpenAI(
        base_url="http://localhost:8000/v1",
        api_key="local_ai_key",
        model="Qwen/Qwen2-7B-Instruct",
        temperature=0.2
    )

    # 构建检索问答链,返回来源文档
    qa_chain = RetrievalQA.from_chain_type(
        llm=llm,
        chain_type="stuff",
        retriever=vector_db.as_retriever(search_kwargs={"k": 4}),
        return_source_documents=True
    )
    return qa_chain

# ===================== 运行测试 =====================
if __name__ == "__main__":
    kb_path = "./local_kb"

    # 构建或加载知识库
    if not os.path.exists(kb_path):
        vector_db = build_knowledge_base()
    else:
        embeddings = HuggingFaceEmbeddings(model_name="all-MiniLM-L6-v2")
        vector_db = Chroma(persist_directory=kb_path, embedding_function=embeddings)

    qa_chain = get_qa_chain(vector_db)

    # 循环问答
    print("本地知识库已就绪,输入问题开始查询,输入exit退出")
    while True:
        question = input("\n请输入问题:")
        if question.lower() == "exit":
            break

        result = qa_chain.invoke({"query": question})
        print("\n回答:")
        print(result["result"])
        print("\n参考来源:")
        for doc in result["source_documents"]:
            print(f"- {os.path.basename(doc.metadata.get('source', '未知文件'))}")
使用建议:把公司的项目文档、接口规范、历史技术方案都导进去,新人上手、查问题都快很多,关键是数据全部在本地,不用担心泄密。
五、模块 4:本地代码审查 Agent 自动帮你查 bug
Agent 不是什么高大上的黑科技,核心就是让 AI 自动调用工具完成任务。我们写一个轻量代码审查 Agent,自动扫描项目里的 Python 文件,找出潜在问题并给出优化建议。
5.1 Agent 核心逻辑
- 接收任务:扫描指定目录的 Python 文件
- 自动调用工具:读取文件内容
- 代码审查:分析代码问题、给出优化建议
- 生成报告:汇总所有问题,输出审查报告
5.1 Agent 核心逻辑
import os
import json
from langchain_openai import ChatOpenAI
from langchain.agents import tool, AgentExecutor, create_react_agent
from langchain.prompts import PromptTemplate

# ===================== 定义工具 =====================
@tool
def read_python_file(file_path: str) -> str:
    """读取指定路径的Python文件内容
    Args:
        file_path: Python文件的完整路径
    """
    try:
        with open(file_path, "r", encoding="utf-8") as f:
            return f.read()
    except Exception as e:
        return f"读取文件失败:{str(e)}"

@tool
def list_python_files(dir_path: str) -> str:
    """列出指定目录下所有的Python文件
    Args:
        dir_path: 目录路径
    """
    try:
        files = []
        for root, _, filenames in os.walk(dir_path):
            for f in filenames:
                if f.endswith('.py'):
                    files.append(os.path.join(root, f))
        return json.dumps(files, ensure_ascii=False, indent=2)
    except Exception as e:
        return f"遍历目录失败:{str(e)}"

tools = [read_python_file, list_python_files]

# ===================== 构建Agent =====================
def build_code_review_agent():
    llm = ChatOpenAI(
        base_url="http://localhost:8000/v1",
        api_key="local_ai_key",
        model="Qwen/Qwen2-7B-Instruct",
        temperature=0.1
    )

    prompt = PromptTemplate.from_template("""
你是一个专业的Python代码审查专家。请使用提供的工具,完成代码审查任务。

可用工具:
{tools}

工具名称列表:{tool_names}

审查要求:
1. 先列出目标目录下的所有Python文件
2. 逐个读取文件内容,检查代码问题
3. 重点关注:语法错误、性能问题、安全隐患、代码规范、潜在bug
4. 最后生成一份完整的审查报告,包含问题描述、风险等级、优化建议

使用格式:
Thought: 思考下一步要做什么
Action: 要使用的工具名称,必须是[{tool_names}]中的一个
Action Input: 工具的输入参数,JSON格式
Observation: 工具返回的结果
...(重复思考-行动-观察过程)

Thought: 任务完成
Final Answer: 完整的代码审查报告

开始任务:{input}

{agent_scratchpad}
""")

    agent = create_react_agent(llm, tools, prompt)
    agent_executor = AgentExecutor(
        agent=agent,
        tools=tools,
        verbose=True,
        max_iterations=20
    )
    return agent_executor

# ===================== 运行审查 =====================
if __name__ == "__main__":
    agent = build_code_review_agent()

    # 指定要审查的项目目录
    target_dir = "./test_project"
    result = agent.invoke({"input": f"请审查目录 {target_dir} 下所有Python文件的代码质量,生成详细审查报告"})

    print("\n" + "="*60)
    print("代码审查完成,报告如下:")
    print("="*60)
    print(result["output"])
六、写在最后
今天这四个模块,覆盖了程序员日常最常用的 AI 场景:写代码对话、截图识别、文档知识库、代码自动化审查。全部本地运行,既省了会员钱,又保证了数据安全。
这只是基础框架,你还可以在此基础上拓展很多玩法:
- 接入语音模型,做本地语音助手
- 对接 IDE 插件,实现编码实时补全
- 增加更多 Agent 工具,自动处理运维、测试任务
2026 年 AI 已经不是什么新鲜概念,真正拉开差距的,是能不能把 AI 变成自己手里顺手的工具。
觉得有用的朋友点赞收藏关注一波,后续会更新更多本地 AI 实战教程,有问题评论区交流~
免费领 150 小时云算力,进群参与显卡、AI PC 幸运抽奖
更多推荐
 27
 0
- 0


 已为社区贡献1条内容

所有评论(0)