ai学习笔记(十七)
这次主要分享AI模型优化与部署相关知识。
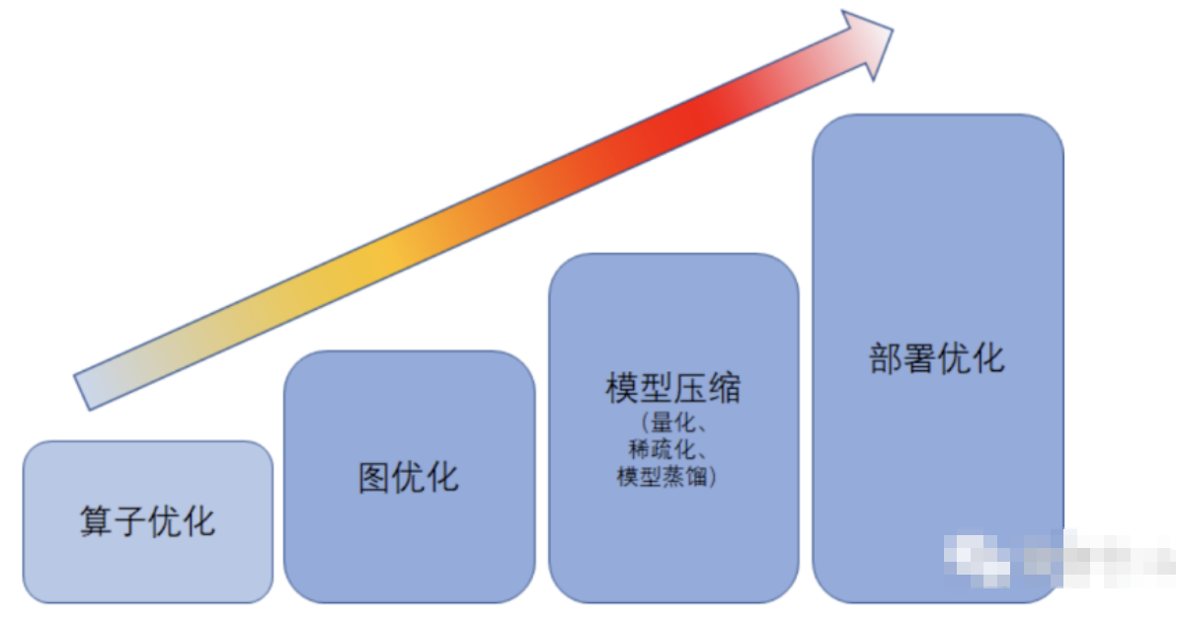
模型优化关键:
1、减小model体积
2、提升传输效率
3、设备兼容 提升可操作性
Flops:衡量模型计算量的指标
1Flops = 1次浮点运算 ResNet大概是41亿Flops
1. 模型压缩
核心目标:在保持模型精度前提下,显著减小模型体积(如从500MB压缩至50MB)、降低计算复杂度(FLOPs减少60%以上)和内存占用(显存)需求降低至1/3。
关键技术:量化(Quantization):将32位浮点参数转为8位整数,模型体积缩小4倍,推理速度提升2-3倍,精度损失控制在1%以内。TensorRT等框架已实现自动化量化。
应用价值:使ResNet-50等模型在iPhone 14的NPU上实现30FPS实时图像识别,功耗降低至0.5W;助力智能音箱的语音识别响应时间从800ms缩短至200ms。
1.1 量化
这是目前最常用、效果最立竿见影的方法。
-
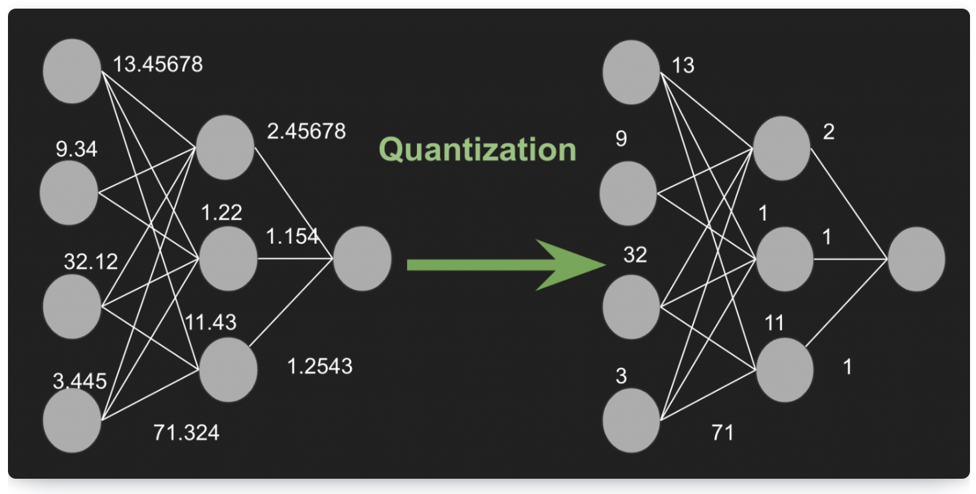
原理:模型参数通常是32位浮点数。量化就是用更少的位数(如16位、8位甚至4位整数)来表示这些数值。就像把一张高清照片转成压缩格式,虽然丢失了一些细节,但大小大大减小,人眼依然能看出主要内容。
-
效果:减少模型体积最高达75%(FP32→INT8),提升推理速度2-4倍,显著降低内存带宽需求。
-
典型技术:主流框架(TensorRT/PyTorch)提供动态/静态量化选项,支持逐层校准和混合精度量化策略。
PyTorch 的量化生态非常完善,提供了从易到难的三套方案,方便开发者进行各种策略的试验。
| 量化方法 | 原理简介 | 代码实现 (核心部分) | 最佳适用场景 |
|---|---|---|---|
| 动态量化 | 推理时动态计算激活值的范围,权重事先量化。 | torch.quantization.quantize_dynamic(model, {torch.nn.Linear}, dtype=torch.qint8) | LSTM、Transformer等计算量大、内存敏感的模型。 |
| 静态量化 | 需校准数据集预先计算并固定激活值范围。 | 1. model.qconfig = torch.quantization.get_default_qconfig('fbgemm')2. torch.quantization.prepare(model)3. 喂入校准数据 model(x)4. torch.quantization.convert(model) | CNN(如ResNet)等计算模式固定的模型。 |
| 量化感知训练 | 在训练时模拟量化误差(伪量化),让模型参数适应低精度。 | 1. model.qconfig = torch.quantization.get_default_qat_qconfig('fbgemm')2. torch.quantization.prepare_qat(model)3. 正常训练、反向传播 4. torch.quantization.convert(model) | 对精度损失要求极高的任务(如医疗影像、自动驾驶感知)。 |
PyTorch 的灵活性使其成为探索混合精度策略和调试逐层校准的理想平台。例如,你可以通过 model.qconfig = torch.quantization.get_default_qconfig('fbgemm') 设置全局量化配置,然后通过更精细的API为不同层(如 model.layer1 和 model.layer2)设置不同的 qconfig,来实现精细的混合精度控制。
量化在生产阶段面临的挑战:
1、精度损失
原因:浮点数转整数时,超出范围的值被截断、小数值被舍入,产生误差。
解决:
-
使用量化感知训练(QAT),让模型适应低精度
-
采用逐层误差监控,定位问题层
-
选择合适的校准数据集(200-500个样本)
2、量化手段的选择
| 特性 | 对称量化 | 非对称量化 |
|---|---|---|
| 公式 | ||
| 数值范围 | [−max_abs,+max_abs] | [min,max] |
| 优点 | 计算简单,推理速度快 | 能更好处理非对称分布 |
| 缺点 | 浪费表示范围(若数据分布偏斜) | 需要额外存储 zero_point |
| 适用场景 | 权重(通常围绕0对称分布) | 激活值(ReLU后全为正) |
| 维度 | 逐层量化 | 逐通道量化 |
|---|---|---|
| 粒度 | 整个张量共享一个 scale 和 zero_point | 每个输出通道独立量化参数 |
| 存储开销 | 低(每个张量2个参数) | 高(每个通道需要独立的scale和zero_point) |
| 精度保持 | 一般 | 优秀(保留通道间的差异性) |
| 实现复杂度 | 简单 | 较复杂 |
| 推荐场景 | 深度可分离卷积、小模型 | 常规卷积层、大模型、对精度敏感的任务 |
推荐组合:卷积层用逐通道+对称(权重),激活值用逐张量+非对称
3、敏感层和激活函数不做量化
需要保护的组件:
-
Embedding层、LayerNorm(层归一化) 和 BatchNorm(批归一化)
-
Softmax、注意力计算中的Q/K/V乘积
-
残差连接、特殊激活函数(GELU/SiLU)
实现方式:
-
PyTorch:设置
layer.qconfig = None -
TensorRT:通过
layer.precision = DataType.FLOAT -
ONNX Runtime:使用
nodes_to_exclude参数
1.2 剪枝
核心思想:通过移除神经网络中“不重要“的权重连接来优化模型,类似于修剪树木去除冗余枝叶。这种方法能降低模型复杂度,同时保持核心功能,实现模型轻量化。
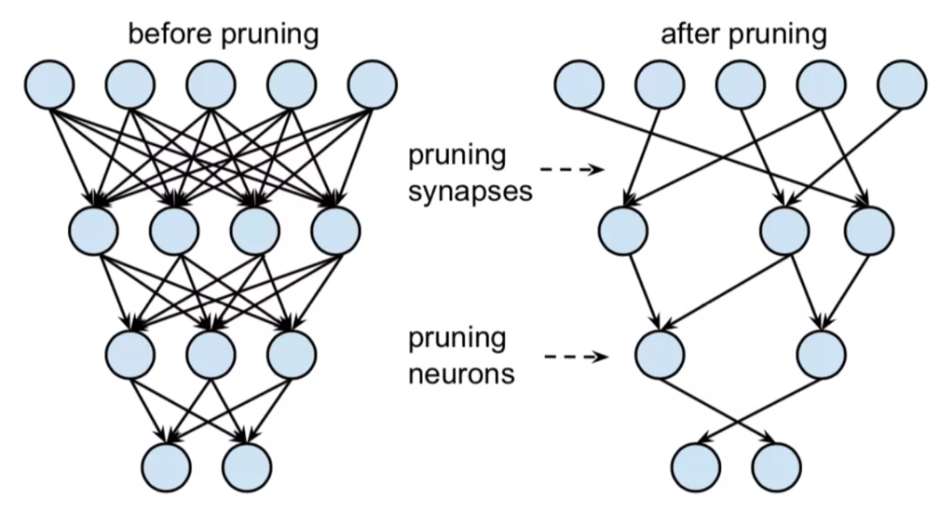
剪枝依据:基于权重绝对值大小或梯度贡献度评估连接重要性,通常移除绝对值小于阈值(如0.01)的权重。
| 方法 | 原理 | 阈值示例 |
|---|---|---|
| 幅度剪枝 | 权重的绝对值越小越不重要 | 移除 |weight| < 0.01 的权重 |
| 梯度剪枝 | 梯度的贡献度越小越不重要 | 移除梯度贡献低于某个百分位 |
幅度剪枝:
import torch

# 假设一个权重矩阵
weights = torch.tensor([[0.5, -0.003, 0.2],
                        [0.001, -0.8, 0.0005]])

# 移除绝对值 < 0.01 的权重
mask = torch.abs(weights) >= 0.01
pruned_weights = weights * mask

print(pruned_weights)
# tensor([[0.5000, 0.0000, 0.2000],
#         [0.0000, -0.8000, 0.0000]])
看梯度贡献度 = 看 |权重 × 梯度|,这个值越大,说明该权重对损失影响越大,越不应该剪。
import torch

# 假设某层权重和对应的梯度
weights = torch.tensor([0.5, -0.003, 0.2, 0.001], requires_grad=True)

# 模拟一个损失(实际训练中由backward自动计算)
loss = (weights ** 2).sum()
loss.backward()  # 计算梯度

# 计算梯度贡献度(importance = |weight * gradient|)
importance = torch.abs(weights * weights.grad)

print(f"权重: {weights}")
print(f"梯度: {weights.grad}")
print(f"贡献度: {importance}")

# 输出示例:
# 权重: tensor([0.5000, -0.0030, 0.2000, 0.0010])
# 梯度: tensor([1.0000, -0.0060, 0.4000, 0.0020])
# 贡献度: tensor([0.5000, 0.0000, 0.0800, 0.0000])
# 结果:索引0贡献最大,索引1和3可以剪枝
主流方法:
| 类型 | 描述 | 优点 | 缺点 |
|---|---|---|---|
| 非结构化剪枝 | 移除单个权重(将权重置0) | 压缩率高,精度损失小 | 产生稀疏矩阵,需要特殊硬件/库才能加速 |
| 结构化剪枝 | 移除整个神经元、通道或层 | 直接减少参数量和计算量,通用硬件友好 | 精度损失相对较大 |
剪枝流程:
采用“训练-剪枝-微调“的迭代优化循环:首先训练完整模型,然后应用剪枝算法,最后通过1-5个epoch的微调恢复精度。典型工具包如PyTorch的TorchPruner可实现自动化流程,在CIFAR-10等数据集上能达到<1%的精度损失。
训练完整模型 → 评估重要性 → 移除不重要参数 → 微调恢复精度 → 重复直到满足需求
剪枝后模型效果会变好吗?
不是所有的网络变更都叫剪枝,如果说去除网络结构后模型效果变好,这样往往叫做优化,而不是剪枝,因为剪枝是需要在一个完整模型上进行去除,而这个完整模型往往都是效果最好的模型。
2. 推理优化
核心目标:提升模型在推理阶段的运行效率,显著降低延迟,确保实时性或近实时性响应。典型场景要求延迟从100ms降至50ms以下。
训练可以慢,但推理必须快——这是工业落地的硬指标。
主流推理优化技术全景:
| 技术类别 | 具体方法 | 原理简述 | 典型收益 |
|---|---|---|---|
| 模型轻量化 | 量化、剪枝、蒸馏 | 减小模型体积 | 2-4倍加速 |
| 算子融合 | 层合并、算子重排 | 减少GPU核函数启动开销 | 1.2-1.5倍加速 |
| 显存优化 | KV Cache、PagedAttention | 复用中间结果 | LLM推理关键 |
| 批处理 | 动态批处理、连续批处理 | 一次处理多个请求 | 3-10倍吞吐提升 |
| 推理引擎 | TensorRT、ONNX Runtime、vLLM | 硬件级优化 | 5-10倍加速 |
| 投机解码 | Speculative Decoding | 小模型猜大模型输出 | LLM 2-3倍加速 |
2.1 算子融合
把多个连续的操作合并成一个,减少GPU内核启动次数和内存读写。
融合前:Conv2d → BatchNorm → ReLU → Add
融合后:FusedConvBNReLU
典型融合模式:
-
Conv + BN + ReLU → 单算子
-
Attention 中的 Q·K^T + Softmax + V → FlashAttention
-
多个逐元素操作合并
2.2 KV Cache
核心原理:Transformer自回归生成时,把已计算的Key和Value缓存起来,避免重复计算。
不使用 KV Cache(笨方法):
-
生成第 1 个词:“我” → 计算 “我” 的 K,V
-
生成第 2 个词:“爱” → 重新计算 “我” 的 K,V,再算 “爱” 的 K,V
-
生成第 3 个词:“学” → 重新计算 “我、爱” 的 K,V,再算 “学” 的 K,V
-
越往后越慢(平方级增长)
使用 KV Cache(聪明方法):
-
生成第 1 个词:“我” → 计算 K,V,缓存
-
生成第 2 个词:“爱” → 读取缓存的 “我” 的 K,V,只计算 “爱” 的 K,V
-
生成第 3 个词:“学” → 读取缓存的 “我、爱” 的 K,V,只计算 “学” 的 K,V
-
每个新词只算一次(线性增长)
2.3 硬件加速
利用专用加速芯片(如TPU/NPU)优化计算图,匹配硬件指令集。ResNet50在Google TPUv4上推理速度可达10,000 FPS。
3. ONNX
ONNX (Open Neural Network Exchange,开放神经网络交换格式) 是一个开源的深度学习模型中间表示格式。
核心价值:实现训练框架(如PyTorch/TensorFlow)与部署环境(如移动端/边缘设备)的解耦,允许开发者使用任意框架训练模型后,通过ONNX格式跨平台部署。据官方数据,支持超过15种框架和40种硬件平台。
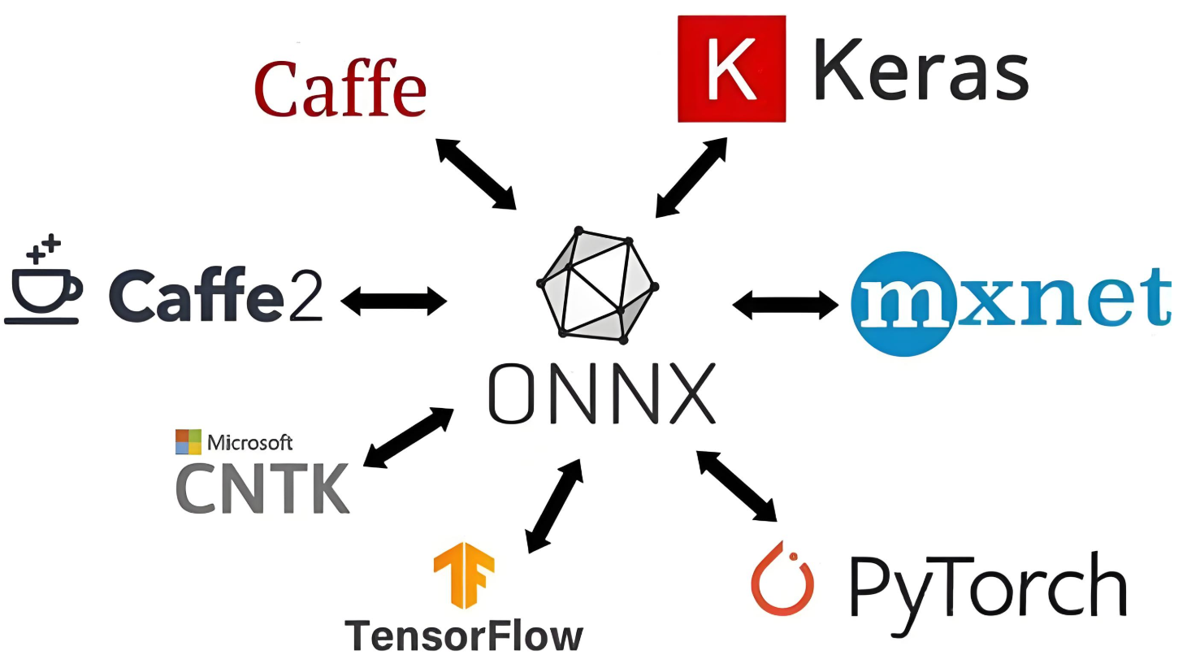
工作流程:
┌─────────────────────────────────────────────────────────────┐
│                      训练阶段                                │
│  PyTorch / TF / Keras / Paddle 训练好的模型                  │
└─────────────────────────────────────────────────────────────┘
                              ↓
                      torch.onnx.export()
                      tf2onnx.convert()
                              ↓
┌─────────────────────────────────────────────────────────────┐
│                      ONNX 模型 (.onnx)                       │
│                   框架无关的中间表示                           │
└─────────────────────────────────────────────────────────────┘
                              ↓
                     ONNX Runtime / TensorRT / OpenVINO / ...
                              ↓
┌─────────────────────────────────────────────────────────────┐
│                       部署阶段                               │
│            CPU / GPU / 手机 / 边缘设备                        │
└─────────────────────────────────────────────────────────────┘
ONNX模型格式的优势:
| 优势 | 说明 |
|---|---|
| 框架互操作性 | 一次导出,多处部署 |
| 生态丰富 | 几乎所有推理引擎都支持 ONNX |
| 图优化 | ONNX Runtime 自动做算子融合、常量折叠 |
| 量化支持 | 内置 INT8/FP16 量化工具 |
| 模型可视化 | Netron 直接查看模型结构 |
4. 推理引擎
核心工具:TensorRT和ONNX Runtime是专为模型推理优化的高性能软件库,支持跨平台部署,显著提升推理速度。
核心功能:提供模型量化、层融合等优化技术,降低延迟并提高吞吐量,例如TensorRT可加速NVIDIA GPU推理达8倍。
硬件适配:支持多种硬件后端(CPU/GPU/TPU),ONNX Runtime兼容x86/ARM架构,实现一次训练多端部署。
动态批处理:自动合并多个推理请求,如TensorRT的动态批处理可提升服务器场景下GPU利用率至90%以上。
内存优化:采用显存池化技术,ONNX Runtime可将模型内存占用降低40%,特别适合边缘设备部署。
┌─────────────────────────────────────────────────────────────┐
│                      推理引擎核心能力                         │
├─────────────────────────────────────────────────────────────┤
│  1. 模型解析  ──  读取 ONNX/PyTorch/TFLite 等格式            │
│  2. 图优化    ──  算子融合、常量折叠、死代码消除               │
│  3. 量化压缩  ──  INT8/FP16/INT4 量化                       │
│  4. 内存管理  ──  内存复用、KV Cache、PagedAttention         │
│  5. 内核调度  ──  选择最优算子实现、多流并行                   │
│  6. 硬件适配  ──  CPU/GPU/NPU/TPU 后端抽象                   │
└─────────────────────────────────────────────────────────────┘
工作流程:
┌────────────────────────────────────────────────────────────┐
│                    输入: 模型文件 (ONNX/.pt)                 │
└────────────────────────────────────────────────────────────┘
                              ↓
┌────────────────────────────────────────────────────────────┐
│  1. 前端解析 (Frontend)                                     │
│   └─ 读取模型 → 构建中间计算图 (IR)                          │
└────────────────────────────────────────────────────────────┘
                              ↓
┌────────────────────────────────────────────────────────────┐
│  2. 图优化 (Graph Optimization)                             │
│   ├─ 算子融合 (Conv+BN+ReLU → FusedConvBNReLU)             │
│   ├─ 常量折叠 (1+2 → 3)                                     │
│   ├─ 死代码消除                                              │
│   └─ 内存复用规划                                            │
└────────────────────────────────────────────────────────────┘
                              ↓
┌────────────────────────────────────────────────────────────┐
│  3. 后端生成 (Backend)                                      │
│   ├─ 算子选择 (哪个内核最快?)                                │
│   ├─ 内存分配 (显存池)                                       │
│   └─ 代码生成 (JIT 编译)                                     │
└────────────────────────────────────────────────────────────┘
                              ↓
┌────────────────────────────────────────────────────────────┐
│                    输出: 可执行引擎                          │
└────────────────────────────────────────────────────────────┘
5. 服务化部署
核心目标:将优化后的AI模型封装为稳定、可扩展的在线服务,支持其他应用通过网络API调用,实现跨平台集成与资源共享。
5.1 Docker
原理:Docker是一种轻量级的虚拟化技术,通过容器化方式将应用程序及其所有依赖(包括代码、库、环境变量等)打包到一个独立的、可移植的容器中,实现快速部署和运行。
核心概念
| 概念 | 解释 | 类比 |
|---|---|---|
| 镜像(Image) | 只读的模板,包含程序 + 环境(如 Ubuntu + Python + 你的代码) | 类(Class),或安装光盘 |
| 容器(Container) | 镜像的运行实例,可创建、启动、停止、删除 | 对象(Instance),或运行中的进程 |
| 仓库(Registry) | 存储和分发镜像的地方(Docker Hub 是官方仓库) | 应用商店 / GitHub |
5.2 API
设计理念:采用封装思想将复杂的模型调用逻辑(如深度学习推理)简化为标准化接口。典型实现如RESTful API,使用HTTP协议实现GET/POST等标准化操作。
核心组成部分:
| 组成部分 | 含义 | 例子 |
|---|---|---|
| 端点(Endpoint) | API 的访问地址 | https://api.weather.com/v1/beijing |
| 方法(Method) | 要做什么操作 | GET(获取)、POST(创建)、PUT(更新)、DELETE(删除) |
| 参数(Parameters) | 附加信息 | ?date=2026-06-02&unit=celsius |
| 请求头(Headers) | 元数据(认证、格式等) | Authorization: Bearer xyz123 |
| 请求体(Body) | 发送的数据(常用于POST) | {"name": "张三", "age": 25} |
| 响应(Response) | 服务器返回的结果 | {"status": "success", "data": {...}} |
| 状态码(Status Code) | 请求结果标识 | 200(成功)、404(未找到)、500(服务器错误) |
调用流程:
1. 客户端发送HTTP请求
2. API网关进行鉴权验证
3. 请求路由至对应服务
4. 模型计算并返回结果
5. 响应数据格式化输出
6. 常见技术
1. RESTful API
核心:基于HTTP的标准接口设计
| 要点 | 说明 |
|---|---|
| 无状态 | 每个请求独立,服务端不存状态 |
| 资源导向 | URL表示资源,用GET/POST/PUT/DELETE表达操作 |
| 标准化 | 使用HTTP状态码、JSON格式 |
示例:POST /v1/predict + JSON数据
2. gRPC
核心:高性能RPC框架
| 要点 | 说明 |
|---|---|
| 基于HTTP/2 | 多路复用、头部压缩 |
| Protobuf | 二进制序列化,体积小、速度快 |
| 流式传输 | 支持单向/双向流(LLM逐token输出很合适) |
对比REST:更快、支持流式,但浏览器支持差
3. 负载均衡
核心:把请求分给最空闲的机器
| 算法 | 做法 |
|---|---|
| 轮询 | 轮流分配 |
| 最少连接 | 给连接数最少的 |
| 最低负载 | 给GPU利用率/队列最空闲的(LLM常用) |
作用:防止单机过载,提高整体吞吐
4. 请求队列
核心:削峰填谷
| 要点 | 说明 |
|---|---|
| 削峰 | 瞬时高峰先排进队列,避免冲垮后端 |
| 填谷 | 后端慢慢处理队列中的请求 |
| 保护 | 队列满时拒绝新请求,防止雪崩 |
典型实现:Redis、RabbitMQ、或内存中的有界队列
5. 熔断
核心:自动停止调用故障服务
| 状态 | 行为 |
|---|---|
| 关闭 | 正常调用 |
| 打开 | 直接失败,不调用下游 |
| 半开 | 试放一个请求,成功则关闭,失败则继续打开 |
作用:下游挂了就别一直等,快速失败,防止雪崩
免费领 150 小时云算力,进群参与显卡、AI PC 幸运抽奖
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)