


- @xianghongtao0116


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
麦肯锡《2026技术趋势展望》指出,机器人技术正从固定动作向具身智能演进,依托视觉-语言-动作模型实现任务理解与自适应执行。工业机器人已规模化应用,而移动操作、人形机器人仍处试验阶段。商业化关键在于将模型泛化能力转化为可重复、可持续的作业系统,需突破实时控制、灵巧操作与系统可靠性瓶颈。未来1-2年,制造、物流及专业场景将率先落地,通用机器人发展取决于泛化、安全与成本协同改善。
麦肯锡《2026技术趋势展望》指出,沉浸式现实技术正从元宇宙热潮转向实用场景,聚焦现场任务支持。智能眼镜、AR/VR/MR设备在工业维修、培训与远程协作中展现价值,但整体采纳仍处实验阶段。资本与招聘趋缓,出货增长不等于普及。技术演进依赖端侧AI、空间计算与人机交互优化,关键在于信息及时性、准确性与任务可靠性。未来机会集中于具体场景的持续使用,而非全面替代手机或规模化部署。
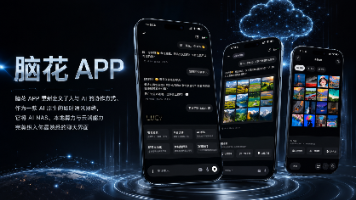
端脑科技上线了脑花 APP。脑花 APP 重新定义了人与 AI 的协作方式。作为一款 AI 原生的即时通讯网络,它将 AI NAS、本地算力与云端能力完美织入你最熟悉的聊天界面。在这里,分散在不同设备与服务中的 AI Agent 化身为你的“对话好友”。无需复杂的配置,像发微信一样日常,把顶尖的 AI 协同网络,变成一个人人都能点、人人都会用的手机界面。
SkillOpt 提出了一种系统化优化 Agent 流程的方法,将自然语言技能文档视为可训练的“参数”,而非手工调整的静态规则。其核心创新在于借鉴深度学习优化器的设计,通过双模型架构(冻结目标模型+优化器模型)、有界文本更新(编辑预算控制)和验证门机制,实现技能文档的稳定迭代。实验覆盖 6 个基准、7 种模型,52 个评测场景均达到最优或并列最优。该方法避免了传统 Prompt 优化的随意性,最终

学者们的研究揭示了多模态大模型(MLLM)终身遗忘任务中一个被忽视的核心问题:持续的知识遗忘会破坏视觉与语言模态间的对齐关系,导致模型性能整体退化。作者提出了首个针对终身遗忘场景的评测基准MLUBench,包含127个真实实体和超1.5万条多模态数据,并发现即使仅更新单一模态权重,模型在早期任务上的表现仍会大幅下降。 研究提出LUMoE解决方案,通过混合专家架构将遗忘操作隔离在冻结的主模型之外。这

安全评估大量依赖 prefill——改写模型"过去的"回合再看其续写,失准续写等评估尤甚。本文精读一篇 NeurIPS 2026 投稿:它首次系统命名并测量 prefill awareness(预填充感知)——若模型能分辨"哪些历史不是自己写的",这类评估的有效性便从根上受威胁。作者以刻意低风险的偏好数据集剥离混淆,论证 detection(检测)与 resistance(抵抗)几乎不相关:风格驱

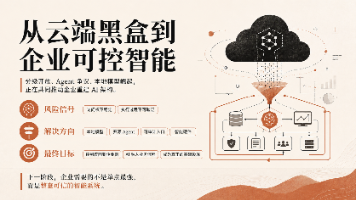
大模型行业正经历从唯性能论向可控性转型的关键阶段。近期两起事件凸显企业AI应用的深层问题:模型发布采取分级审批制,暴露访问权不确定性;Claude Code被指隐蔽标记用户环境,反映高权限Agent的执行不可验证性。企业AI下一阶段的核心矛盾在于:闭源云端黑盒架构与业务级可信需求间的冲突。解决方案需构建可控智能体系,包含四大支柱:可审计入口(统一身份、日志和模型路由)、本地模型(保障数据边界和调用
FitOne提出了一套完整的垂直领域大模型训练方案,针对科学健身指导(SFC)这一复杂场景,通过三阶段训练流程将通用基座转化为领域专家。方法包含:1)领域持续预训练(CPT),采用知识工程构建30B tokens领域语料,通过RegMix优化数据配比;2)混合监督微调(SFT),用知识引导生成和多维校验构建高质量指令数据,采用两阶段分布退火策略;3)DAPO强化学习,引入混合奖励函数和动态采样机制

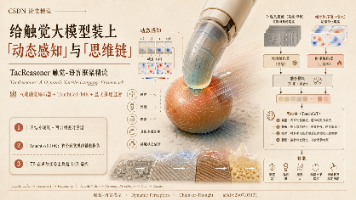
TacReasoner 面向具身触觉推理,提出「冻结外观流 + 可训帧差时序流」的动态感知编码器,并构建首个触觉思维链数据集 TouchCoT-10K,把推理过程显式写进训练目标,在多数子任务上让 7B 反超 14B 的 VTV-LLM。本文逐条精准推导其六个核心公式与两个损失函数,指出帧差与「剪切累积」动机的错位、式(7)期望记号之误、CLS 单 token 瓶颈及 45 样本评测的置信度问题,
多数大模型评测都在考"答案已知"的题,测不出模型能否在事件发生前给出有用判断。WorldCupArena 反其道而行:开球前 24 小时锁死预测,赛后对着官方战报打分,并把一场球拆成比分、球员、事件、技战术、整届赛事五层来评估。它用一套克制自洽、可独立复算的评分数学,让胜负正确率都约 68% 的模型分出真实高下,得出"加检索未稳定帮忙""最强模型仅微超博彩市场""模型在冷门上集体翻车"等诚实结论。
