- @wwlsm_zql


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
选择使用哪个索引类取决于具体的应用需求和可用的计算资源。如果需要利用预训练语言模型的语义理解能力,并且有足够的计算资源,可以考虑使用。利用 GPT 模型的强大语义理解能力来生成文本的向量表示,适用于需要捕获文本语义信息的场景。则提供了更多的灵活性,允许使用不同的向量化技术来创建索引,适用于需要定制化和扩展性的场景。如果需要更多的灵活性和定制化,或者计算资源有限,可以考虑使用。都是用于创建向量存储索
分享一个模型最后两个教程展示了如何使用 PyTorch、 Keras 和 Accelerate 优化分布式设置的模型。下一步就是把你的模型公之于众!我们相信公开分享知识和资源,使人工智能大众化。我们鼓励你考虑与社区分享你的模式,以帮助其他人节省时间和资源。在本教程中,您将学习在 Model Hub 上共享经过训练或调优的模型的两种方法:以编程方式将文件推送到Hub。通过 web 界面将文件拖放到
赤兔」的模型加载和张量并行切分机制通过模型基类、并行模块和权重加载工具函数的组合,实现了与模型 Checkpoint 格式解耦、支持多种并行方式(行并行、列并行、词表并行)和 GQA/MQA 的灵活加载流程。具体的模型实现文件负责将标准模块替换为并行模块,并实现方法来定义详细的权重切分逻辑。这种模块化的设计使得适配新模型或调整并行策略更加方便。# 「赤兔」Chitu 框架深度解读(十三):模型加载
文远知行-W的股票发售标志着L4级自动驾驶技术进入商业化加速期。通过对感知融合、决策系统和数据生态的持续创新,文远知行正逐步解决自动驾驶量产的核心难题。未来三年,随着技术成熟度和运营效率的提升,自动驾驶服务将从特定场景扩展至城市级规模应用。这一进程不仅将重塑交通出行方式,更将推动人工智能技术在实体经济中的深度落地。作为行业观察者,我们期待见证自动驾驶技术从"实验室奇迹"转变为"日常出行解决方案"的
在当今大模型(LLM)技术浪潮中,高效、稳定且灵活的推理部署成为了企业将AI能力转化为生产力的关键瓶颈。为此,一个专注于效率、灵活性和可用性的高性能大模型推理框架——**Chitu「赤兔」**应运而生。本文作为系列解读的第一篇,将带您全面了解「赤兔」的定位、核心特性以及它如何成为“生产级大模型推理引擎”的有力竞争者。
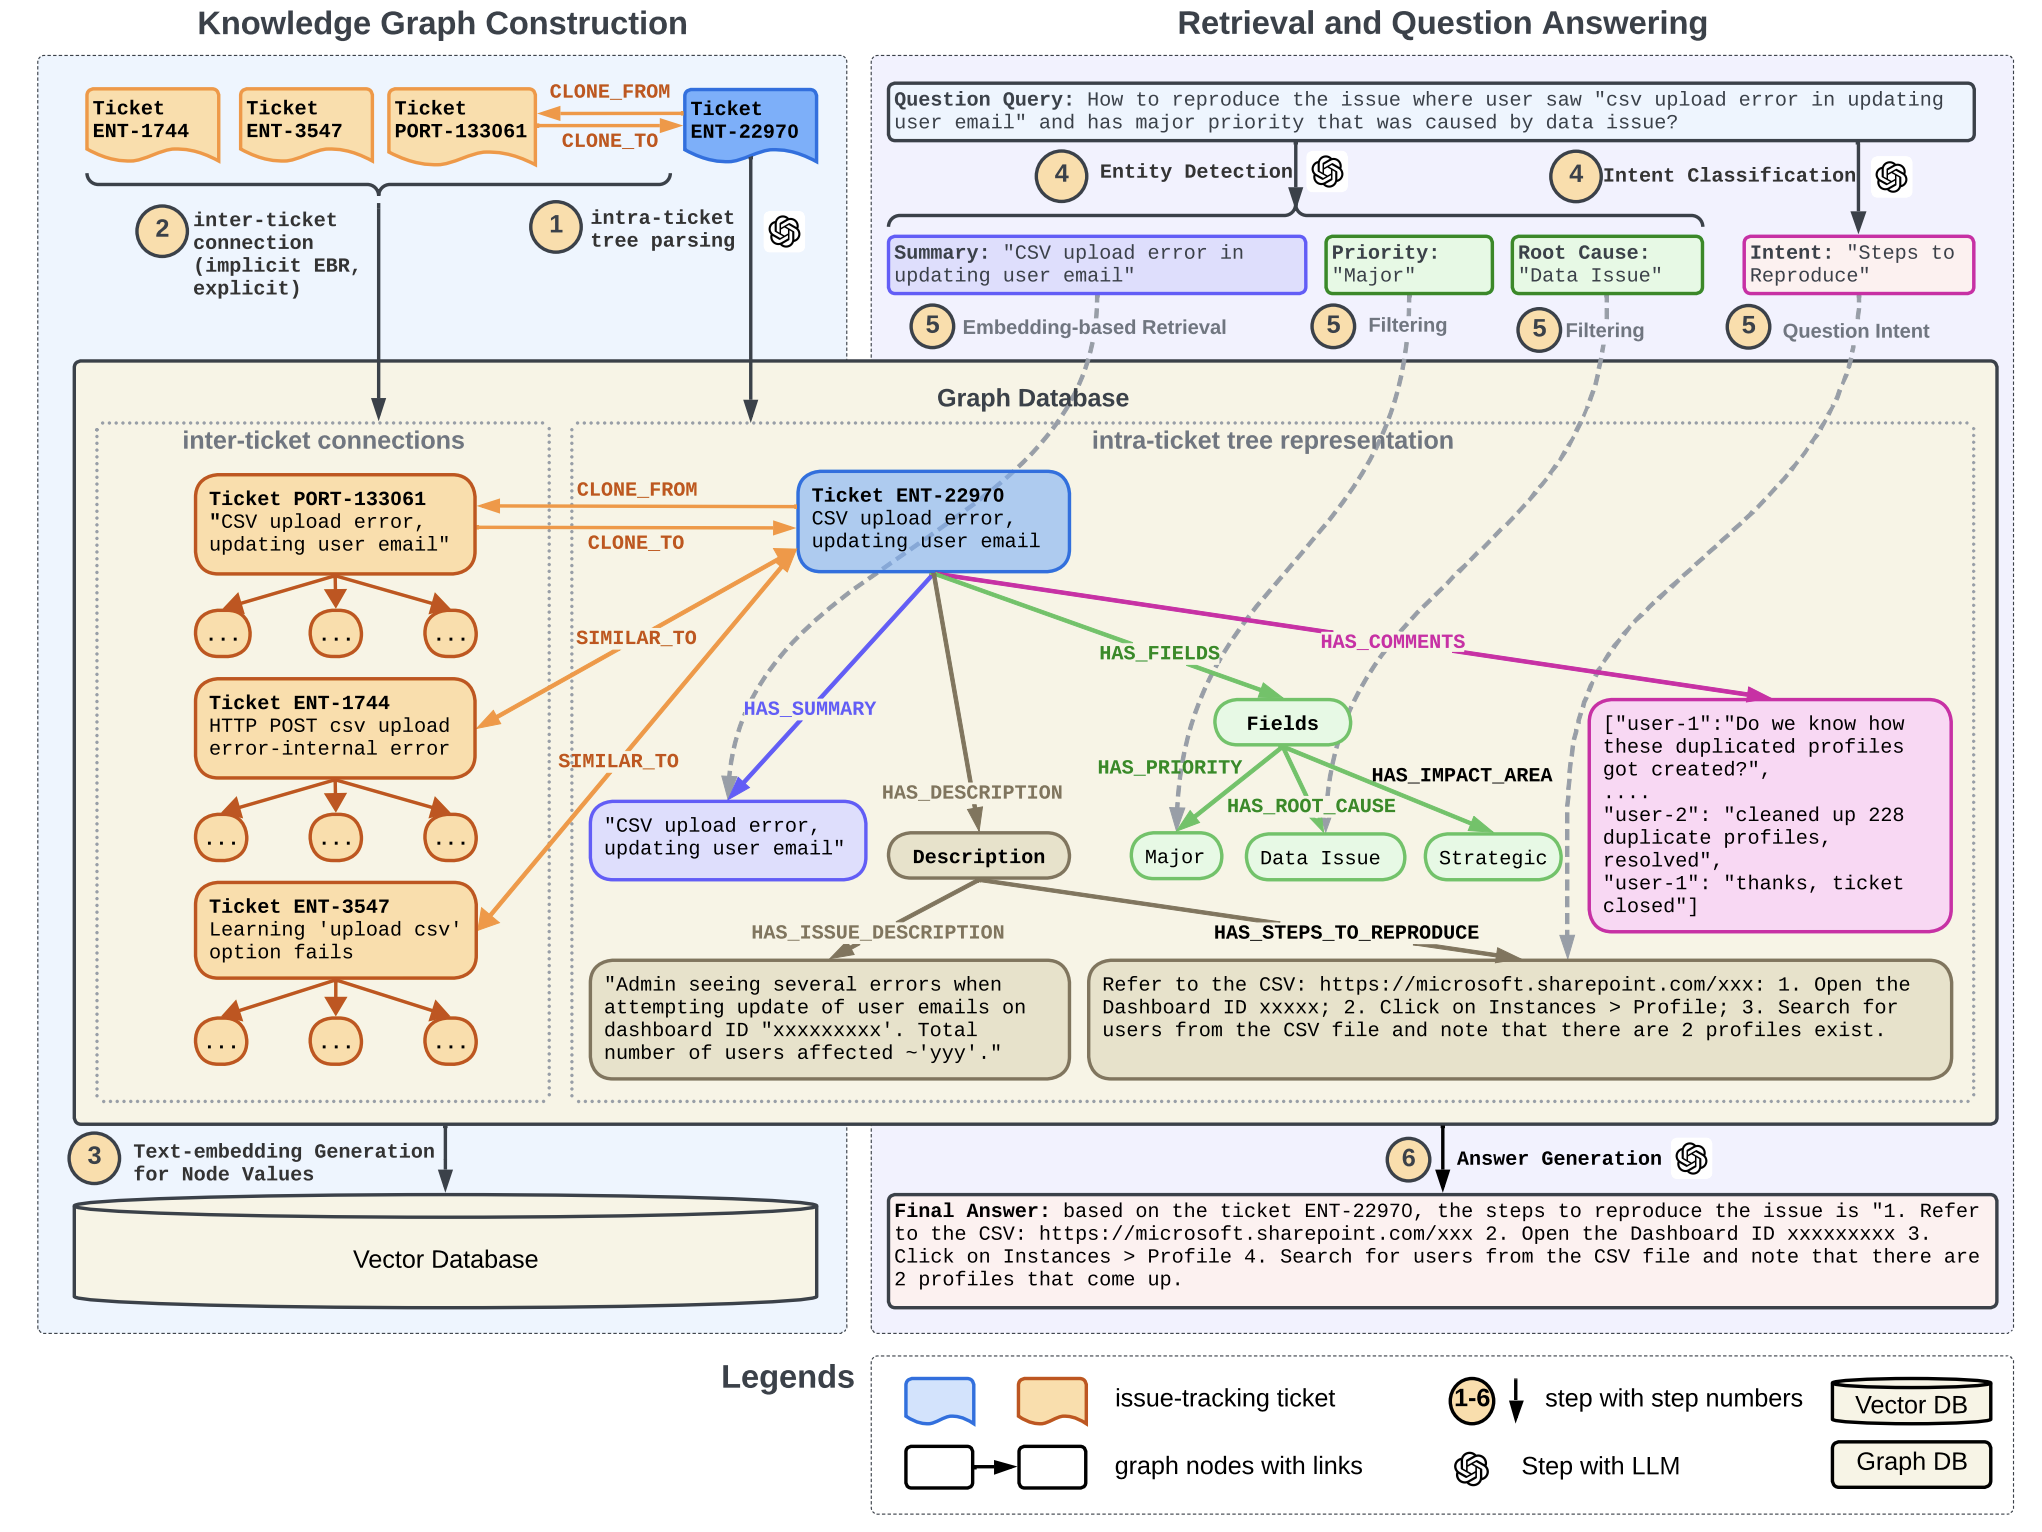
本研究的核心创新,在于巧妙地将知识图谱引入大语言模型,构建了一套全新的客服问答范式。它以知识图谱为中心,既保留了工单的结构和联系,又能利用LLM的语义理解和生成能力,可谓优势互补、相得益彰。与此同时,研究者在图谱构建、查询解析、子图提取等环节都采用了LLM,使得整个流程更加灵活、鲁棒,体现出领域适应性。这种全面拥抱LLM的做法堪称业界典范。LinkedIn的这项研究堪称客服智能化的里程碑。
随着大模型技术的不断发展,内容解析的方式正在发生深刻变革。大模型加持下的提示工程方法为爬虫技术带来了前所未有的便利和效率提升。然而,我们也应该意识到,这种方法并非万能之药,它仍然需要结合具体任务进行定制化的优化和调整。未来,我们期待看到更多关于大模型在爬虫领域的应用和研究,以推动这一技术的进一步发展和完善。

知识图谱构建技术体系知识获取:从不同来源、不同结构的数据中进行知识的提取,形成结构化的知识,当前知识的获取主要针对文本数据进行实体抽取众包:百度百科、维基百科,存储机器可读的、具有一定结构的数据爬虫:通过定义网页中的实体、属性、关系的 pattern,实现对网页数据的获取,例如 Google、Baidu 的搜索引擎机器学习:将数据变成考研理解的知识,例如通过文本分类、主题模型等...
预训练语言模型基于大规模语料进行训练,通过自监督学习获取语言的广泛知识。:使用双向Transformer编码器,通过掩码语言模型和下一句预测任务进行预训练。:基于Transformer解码器,具有1750亿参数,通过自回归方法进行文本生成。:将所有NLP任务统一为文本到文本的转换问题,通过大规模多任务学习进行预训练。

在快速发展的人工智能领域中,以高效和有效的方式使用大型语言模型(LLM)变得越来越重要。在本文中,您将学习如何以计算高效的方式使用低秩适应(LoRA)对LLM进行调整!