- @weixin_75159604


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
摘要:本文介绍了机器学习中最基础的线性回归算法。通过预测房价的简单例子,解释了线性回归如何用直线拟合数据(y=wx+b),区分了特征(输入)和标签(输出)的概念,并说明模型通过最小化损失函数来训练参数。文章包含Python实现代码,演示了从数据准备到预测的全流程,并延伸讨论了多元线性回归。强调线性回归是理解机器学习的重要基础,建议初学者深入掌握其核心概念(训练过程、损失函数、预测原理等)再进阶学习
摘要: 逻辑回归是一种经典的二分类算法,尽管名称含"回归",实则用于预测样本类别(如垃圾邮件识别、用户流失预测)。其核心在于Sigmoid函数,将线性组合结果压缩至0-1区间作为概率输出,通过阈值(如0.5)转换为类别。相比线性回归,逻辑回归的优势在于输出概率值且范围可控。该算法简单高效、可解释性强,适合基础分类任务,但难以处理复杂非线性数据。理解逻辑回归需把握三点:分类与回归
本文介绍了梯度下降算法的核心原理及其在机器学习中的应用。梯度下降是一种通过迭代调整模型参数以最小化损失函数的优化方法,其核心思想类似于"下山"——沿着损失函数下降最快的方向逐步调整参数。文章首先通过直观的山谷下降类比解释梯度下降的基本概念,然后详细阐述了梯度下降的数学原理,包括参数更新公式和学习率的作用。通过一个简单的二次函数示例,展示了梯度下降如何逐步逼近最优解。最后,文章讨
本文介绍了机器学习中的损失函数概念及其作用。损失函数作为模型训练的"指南针",用于衡量模型预测与真实值的差距。文章通过房价预测和考试通过率两个例子,分别讲解了回归问题常用的均方误差(MSE)和分类问题常用的交叉熵损失函数,并给出Python实现示例。损失函数数值越小表示模型预测越准确,训练过程就是通过不断调整参数来最小化损失函数。理解损失函数是掌握模型训练机制的基础。
机器学习模型训练前的数据预处理至关重要,因为现实数据往往存在各种问题。预处理主要包括:处理缺失值(删除或填补)、去除重复数据、识别异常值、类别特征编码(如独热编码)、数值标准化(调整量纲差异)以及划分训练集和测试集。这些步骤能有效减少脏数据对模型训练的干扰,提升模型性能。预处理不是固定流程,需根据数据特点和模型需求灵活调整。通过Python的pandas和scikit-learn库可方便实现基础预
本文探讨了机器学习中数据划分的核心概念,重点解释了训练集、验证集和测试集的不同作用及划分原则。训练集用于模型学习,验证集用于调参选择,测试集则作为最终评估。文章强调了防止数据泄漏的重要性,指出常见错误如用测试集调参、预处理顺序不当等问题。针对不同场景(如小数据、时间序列)提供了划分建议,并通过考试备考的类比帮助理解。最后给出了标准的数据划分流程示例,强调随机划分和时间序列处理的注意事项。
这篇文章深入探讨了机器学习模型评估的关键问题,指出单纯依赖准确率(Accuracy)的局限性。文章通过医疗筛查案例说明,98%的准确率可能掩盖模型漏诊所有真实病例的严重问题,揭示了类别不平衡时的评估陷阱。 核心观点包括: 分类问题应关注混淆矩阵的四种结果(TP/TN/FP/FN),不同错误类型的代价各异 精确率(Precision)衡量模型预测正类的准确性,召回率(Recall)反映捕捉正类的能力
KNN(K近邻)是最直观的机器学习算法之一,其核心思想是通过"看邻居"进行分类:一个新样本的类别由其最近的K个训练样本的多数类别决定。文章通过学生考试预测的案例生动解释了KNN的工作原理,并详细讨论了K值选择、距离计算、特征标准化等关键概念。作为"懒惰学习"算法,KNN没有传统训练过程,而是存储所有训练数据,在预测时实时计算距离。虽然KNN简单易懂、能处理复
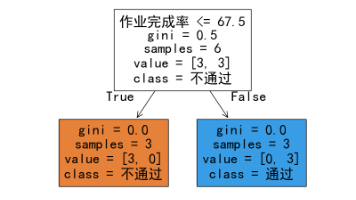
决策树是一种直观的机器学习算法,模拟人类逐步判断的过程。它通过二叉分支的问答流程进行分类,每个节点提出问题,分支对应答案,最终到达叶子节点得到预测结果。决策树选择信息增益最大的特征进行分裂,以提高数据纯度。其优势包括直观可解释、无需标准化、处理混合特征能力强,但容易过拟合且对数据波动敏感。实际应用中常通过限制树深度、设置叶子最小样本数等方法防止过拟合。与KNN相比,决策树解释性更强、预测更快,适合
随机森林是一种集成学习方法,通过构建多棵决策树并投票决策来解决单棵决策树容易过拟合的问题。其核心思想是:1)随机采样训练数据(Bootstrap采样),使每棵树看到不同数据;2)随机选择特征进行分裂,增加树的多样性。相比单棵决策树,随机森林具有更强的泛化能力、对异常值不敏感等优点,但可解释性较差、预测速度较慢。Python中可用sklearn轻松实现,常用参数包括树的数量、深度等。随机森林适合作为