- @sadfasdfsafadsa


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
本文基于矩池云 RTX A2000 12G 服务器,使用 LlamaFactory 完成全链路操作,完整覆盖训练配置、模型导出、推理测试三大核心环节,适配个人学习、竞赛小模型定制场景。LoRA 仅为增量权重,无法单独部署推理,必须将,生成独立完整模型。
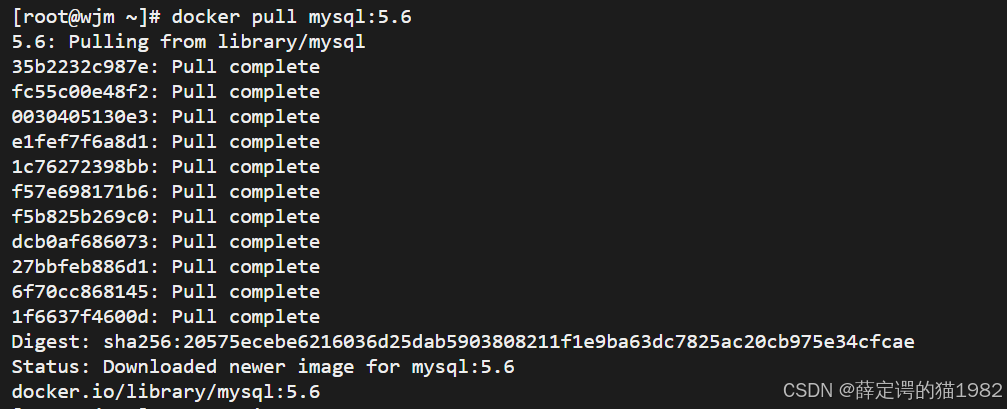
Docker 应用部署一、部署MySQL拉取mysql镜像3. 创建容器,设置端口映射、目录映射赋权启动查看运行镜像docker ps查看日志设置开机自动启动/取消开机启动docker update --restart=always 容器IDdocker update --restart=no 容器ID。
本文介绍了使用Docker部署Tomcat容器的步骤。首先拉取Tomcat 9.0镜像,然后创建容器并设置端口映射(8080)和目录映射(/usr/local/tomcat/webapps)。针对高版本Tomcat访问404错误问题,提供了解决方案:进入容器后删除空webapps目录,并将webapps.dist重命名为webapps。最后还介绍了管理Tomcat容器的常用命令,包括查看、停止、启
docker stop myredis # myredis 是我启动redis 命名的别名。# 命令: docker rm <容器名称>或者<容器id># 删除镜像 命令 docker rmi <容器 id># 停止命令:docker stop <容器名>RedisDesktopManager连接。5. 删除Redis镜像(删除容器后进行)4. 删除redis 容器。或者 navicat16。强制

LangChain的ModelI/O模块将大语言模型抽象为三种类型:LLMs(非对话模型)适用于单次文本生成任务,输入输出为文本字符串;ChatModels(对话模型)支持多轮对话,使用结构化消息对象维护上下文;EmbeddingModels(嵌入模型)将文本转换为向量表示。该模块统一了不同模型的调用方式,适用于文案创作、客服机器人、语义搜索等多种应用场景。开发者可通过简单API实现模型调用,支持
本文介绍了如何下载和使用maidalun/bce-embedding-base_v1双语嵌入模型的完整流程。首先需要注册魔塔社区并搜索该模型,然后安装modelscope、sentence_transformers等必要依赖。文章提供了两种运行模型的方法:通过LangChain框架调用HuggingFaceEmbeddings,以及直接使用SentenceTransformer进行本地推理。两种方

本文对比分析了当前主流开源LLM推理框架Ollama、vLLM和LMDeploy的核心差异与适用场景。Ollama定位轻量化本地工具,适合个人学习和小型Demo验证,具有零配置、多模型一键切换优势,但并发性能有限。vLLM作为工业级推理引擎,通过分页KV缓存和连续批处理技术实现高吞吐,适合通用高并发API服务。LMDeploy则专注量化加速和国产化适配,在4bit量化、多模态模型和国产硬件场景表现
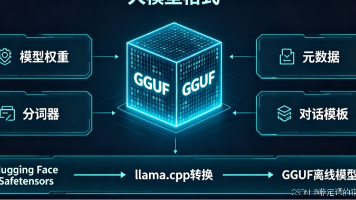
本文介绍了将LlamaFactory微调后的Qwen2.5-3B模型转换为GGUF格式并部署到Ollama的完整流程:1)确认已合并LoRA权重得到完整模型;2)使用llama.cpp工具将模型转换为GGUF格式(推荐q4_K_M或q8_0量化);3)通过Ollama创建自定义模型并运行测试;4)启动API服务供外部调用。关键点包括必须合并完整模型再转换、选择合适的量化方案,以及通过Modelfi
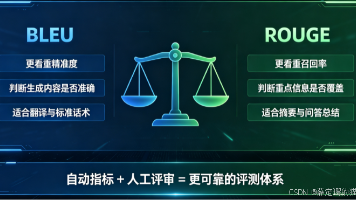
AI产品经理需掌握BLEU与ROUGE两大文本评估指标的核心逻辑与应用边界。BLEU侧重精准度,适用于机器翻译等标准化输出场景;ROUGE关注信息召回率,更适合摘要类任务。二者均通过文本重合度量化生成效果,但存在无法识别语义等价表达、忽略内容真实性与业务适配性等局限。在大模型时代,产品经理应将其作为初期筛选工具,结合业务场景构建专属评测集,并建立"自动指标+人工评审"的双层评估
XTuner是一款轻量化微调框架,支持QLoRA 4bit低成本微调主流基座模型(如InternLM、Qwen、Llama3)。其核心优势包括:单24G显卡可运行13B模型、统一数据集标准、一键训练与合并LoRA权重、集成DeepSpeed多卡优化。环境需Python3.10+CUDA11.8+/12.x,支持单卡/多卡部署。数据集需转换为标准单轮指令格式。训练配置包括QLoRA参数(4bit量化