- @qq_62915969


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
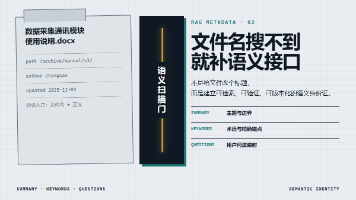
用户问“MQTT 设备怎么配置心跳”,知识库里明明有完整说明,系统却返回“没有相关资料”。排查后发现文档标题叫《数据采集通讯模块使用说明》,路径是 `/archive/manual/v3/final.docx`,文件名、目录和用户问题之间几乎没有共同词。向量检索并非完全不懂语义,但当文档标题过于宽泛、正文很长、关键答案只占一小段时,单靠原文向量仍然可能漏召回。
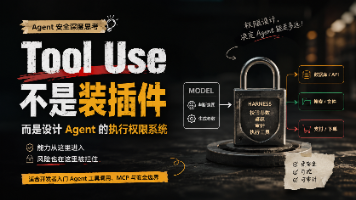
Tool Use 的本质不是“给模型增加插件”,而是在 Model 和真实业务系统之间设计一层受控的执行权限边界。本文面向开发者,从 Function Calling、Harness、ReAct、MCP、工具设计、安全护栏和生产落地几个角度,讲清楚 Agent 工具调用为什么必须被当成权限系统来设计。
RAG 的关键不是“有没有向量数据库”,而是能不能建立一条从用户问题到检索证据、再到可信回答的完整证据链。本文结合 RAG 论文、OpenAI/Anthropic/Microsoft/Elastic/AWS/Google 等资料,以及 LangChain、LlamaIndex、Haystack、RAGFlow、GraphRAG 等开源实践,讲清 RAG 的工程架构、常见误区和最小落地方案。

很多人学大模型时会背 Attention 公式,却说不清 Q/K/V 到底是什么、Mask 为什么要加在 softmax 前、KV Cache 为什么只缓存 K 和 V。本文从一份最小 PyTorch 实现开始,把 Multi-Head Attention 的张量形状、因果掩码、KV Cache 推理流程和面试常见追问串起来。
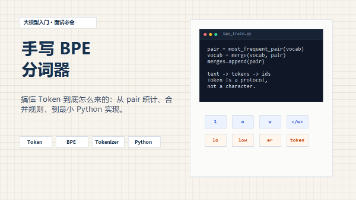
很多人学习大模型时,会直接从 Attention、Transformer、KV Cache 开始,但真正进入工程实践后,第一个绕不开的问题往往是 Token。为什么同一句话在不同模型里 token 数不一样?为什么中文、英文、代码的切分差异会影响上下文长度和费用?本文从 Byte Pair Encoding(BPE)的合并规则开始,手写一个最小 BPE 分词器,讲清 Tokenizer 的训练、编
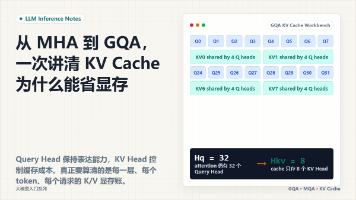
从 KV Cache 的显存公式出发,讲清 MHA、MQA、GQA 的张量形状和工程差异,并手写一个最小 GQA Attention,
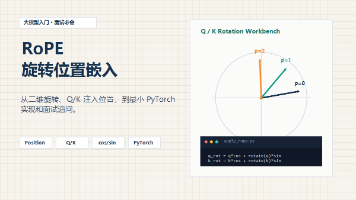
Transformer 的 Attention 本身不知道 token 顺序,RoPE 通过旋转 Query 和 Key,把 position 注入到注意力分数里。本文从二维旋转直觉、相对位置公式、PyTorch 最小实现、KV Cache 下的 position_ids 和常见坑,系统讲清 RoPE 位置编码。
很多 Agent 项目不是败在模型不够强,而是败在上下文太脏:历史全塞、RAG 全塞、工具结果全塞,最后模型又慢又贵还容易跑偏。本文从开发者视角讲清 Context Engineering、RAG、Memory、压缩、按需加载和最小落地方案。

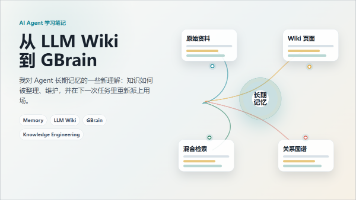
从 LLM Wiki、Obsidian-Wiki 和 GBrain 出发,梳理 Agent Memory 的几个核心概念:短期记忆、工作记忆、事件记忆、语义记忆和程序性记忆,并分析传统 RAG 与长期记忆之间的区别。文章更偏学习笔记和知识分享,重点讨论 Agent 如何通过 Markdown Wiki、增量维护、混合检索和图谱关系沉淀长期知识。
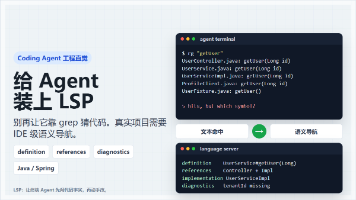
GitHub 发布文章介绍如何让 Copilot CLI 接入 Language Server Protocol,让 Coding Agent 从粗暴 `grep`、翻依赖包、猜 API 签名,升级到使用 definition、references、types、diagnostics 等语义级代码信息。本文从 Java/Spring 项目的真实场景出发,拆解为什么 Coding Agent 靠全文