


- @qq_44991381


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
(原文翻译)在多无人机追逐逃逸任务中,追逐方的目的是要捕捉逃逸方,这对无人机集群智能构成了关键挑战。多智能体强化学习(MARL)在建模协作行为方面展现出巨大潜力,但是大多数基于强化学习的方法仍局限于有限动力学或者固定场景的简化仿真。此前将强化学习策略应用于真实世界追捕-躲避任务的大部分尝试都局限于二维场景,例如地面车辆或者在固定高度飞行的无人机。本文提出了一种基于MARL的在未知环境中进行多无人机

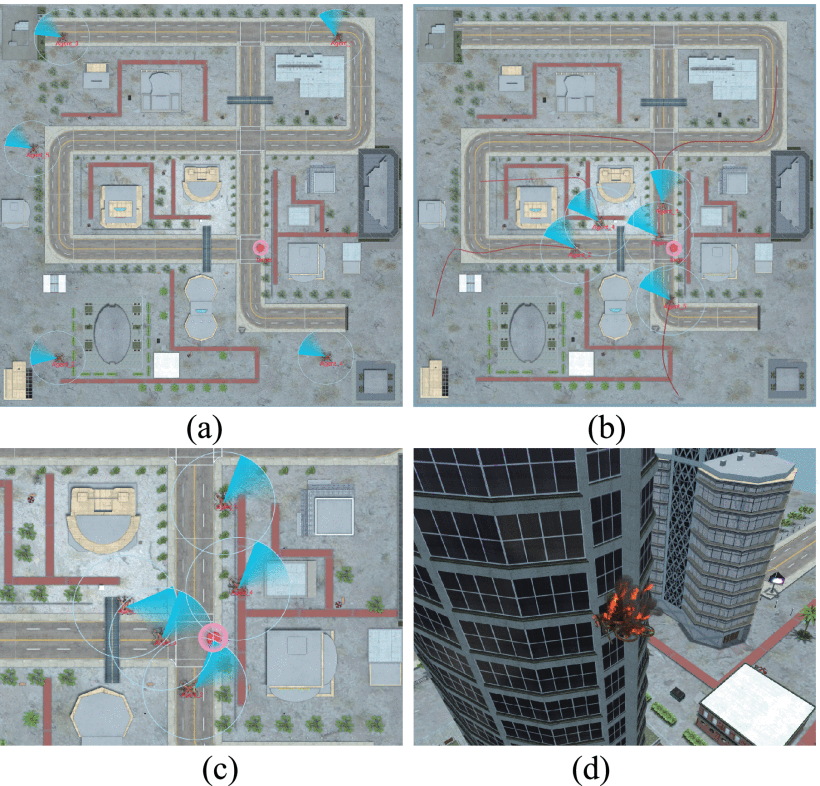
本文研究了障碍环境下多四旋翼无人机与目标的追逃博弈问题。为实现对城市环境的高质量仿真,我们提出基于物理引擎的追逃场景框架(PES),使无人机智能体能够执行动作并与环境交互。在此基础上,构建了结合目标预测网络(TP Net)的多智能体冠状双向协调网络(CBC-TP Net),通过多智能体深度确定性策略梯度(MADDPG)的矢量化扩展,确保受损"集群"系统在追逃任务中的有效性。与传统强化学习不同,我们
(原文翻译)在多无人机追逐逃逸任务中,追逐方的目的是要捕捉逃逸方,这对无人机集群智能构成了关键挑战。多智能体强化学习(MARL)在建模协作行为方面展现出巨大潜力,但是大多数基于强化学习的方法仍局限于有限动力学或者固定场景的简化仿真。此前将强化学习策略应用于真实世界追捕-躲避任务的大部分尝试都局限于二维场景,例如地面车辆或者在固定高度飞行的无人机。本文提出了一种基于MARL的在未知环境中进行多无人机
本文研究了障碍环境下多四旋翼无人机与目标的追逃博弈问题。为实现对城市环境的高质量仿真,我们提出基于物理引擎的追逃场景框架(PES),使无人机智能体能够执行动作并与环境交互。在此基础上,构建了结合目标预测网络(TP Net)的多智能体冠状双向协调网络(CBC-TP Net),通过多智能体深度确定性策略梯度(MADDPG)的矢量化扩展,确保受损"集群"系统在追逃任务中的有效性。与传统强化学习不同,我们
本文研究了障碍环境下多四旋翼无人机与目标的追逃博弈问题。为实现对城市环境的高质量仿真,我们提出基于物理引擎的追逃场景框架(PES),使无人机智能体能够执行动作并与环境交互。在此基础上,构建了结合目标预测网络(TP Net)的多智能体冠状双向协调网络(CBC-TP Net),通过多智能体深度确定性策略梯度(MADDPG)的矢量化扩展,确保受损"集群"系统在追逃任务中的有效性。与传统强化学习不同,我们
(原文翻译)在多无人机追逐逃逸任务中,追逐方的目的是要捕捉逃逸方,这对无人机集群智能构成了关键挑战。多智能体强化学习(MARL)在建模协作行为方面展现出巨大潜力,但是大多数基于强化学习的方法仍局限于有限动力学或者固定场景的简化仿真。此前将强化学习策略应用于真实世界追捕-躲避任务的大部分尝试都局限于二维场景,例如地面车辆或者在固定高度飞行的无人机。本文提出了一种基于MARL的在未知环境中进行多无人机
本文研究了障碍环境下多四旋翼无人机与目标的追逃博弈问题。为实现对城市环境的高质量仿真,我们提出基于物理引擎的追逃场景框架(PES),使无人机智能体能够执行动作并与环境交互。在此基础上,构建了结合目标预测网络(TP Net)的多智能体冠状双向协调网络(CBC-TP Net),通过多智能体深度确定性策略梯度(MADDPG)的矢量化扩展,确保受损"集群"系统在追逃任务中的有效性。与传统强化学习不同,我们