


- @qq_36490243


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
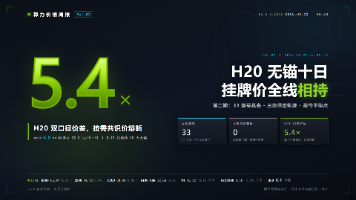
GPU 算力行情周报第二期:33 型号在册、28 个有按需价,连续第二周零跨线调价,挂牌价进入相持期。本周最大信号不在价格端——H20 按需共识价因 ppio 6.8 与阿里云 36.6 两口径价差 5.4 倍超熔断线,连续 10 天缺席,旗舰合规卡按需无锚;RTX4090 的 +2.2% 拆开是采集源权重切换的口径效应,5 家原价全周未动。相持期读行情,先分清是价格在动,还是供给与口径在动...
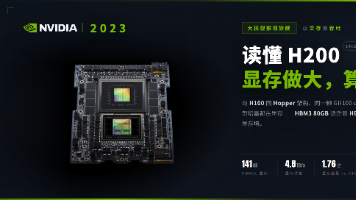
NVIDIA H200 GPU本质是H100的显存升级版,核心算力完全相同但显存提升至141GB HBM3e(H100为80GB HBM3),带宽达4.8TB/s(H100为3.35TB/s)。这一升级凸显AI大模型时代的核心矛盾已从算力不足转向显存瓶颈——70B参数模型的FP16权重约140GB,H200首次实现单卡装载,避免跨卡并行的性能损耗。H200尤其适合大模型推理、长上下文处理等显存敏感
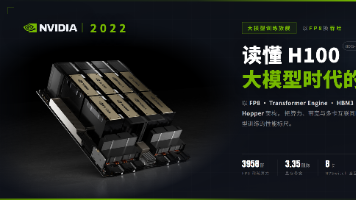
摘要: NVIDIA H100-80G-SXM5是专为AI训练设计的旗舰GPU,基于Hopper架构,配备80GB HBM3显存(带宽3.35TB/s)和FP8张量核心,支持Transformer Engine动态混合精度,显著提升大模型训练效率。其SXM5板型通过NVLink 4.0(900GB/s)实现多卡全互联,适合高密度集群;PCIe版则兼容通用服务器,但性能略降。H100通过FP8算力、
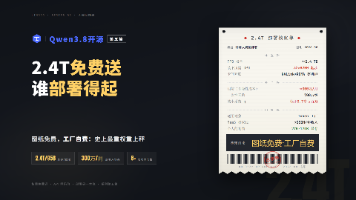
Qwen3.8-Max 发布两周了。这两周里,2.4T 权重和 27B 稠密版先后开源,DeepSeek 的涨价方案也刚好在今天生效。热搜退了,账该补上了。这次上秤的是史上最重的权重,尺子还是第一篇那把,每成功任务成本。 回看发布日:2.4 万亿参数,API 输入 12 元...标签:Qwen、大模型部署、开源大模型、MoE、推理成本
摘要:A100的两段生命周期与技术亮点 NVIDIA A100是2020年发布的Ampere架构旗舰GPU,曾是大模型训练的主力算力(如ChatGPT、LLaMA)。其核心创新包括: TF32精度:兼容FP32代码,自动启用张量核心加速训练; MIG多实例:单卡硬件级切分为7个隔离实例,提升多租户利用率; 80GB HBM2e显存(2.0 TB/s带宽)与第三代张量核心。 A100经历了两阶段应用
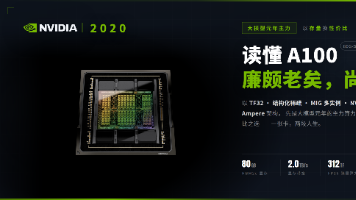
摘要:A100的两段生命周期与技术亮点 NVIDIA A100是2020年发布的Ampere架构旗舰GPU,曾是大模型训练的主力算力(如ChatGPT、LLaMA)。其核心创新包括: TF32精度:兼容FP32代码,自动启用张量核心加速训练; MIG多实例:单卡硬件级切分为7个隔离实例,提升多租户利用率; 80GB HBM2e显存(2.0 TB/s带宽)与第三代张量核心。 A100经历了两阶段应用