


- @qq_28385535


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
现代 LLM 的顺序特性导致其计算成本高昂且速度缓慢,而推测性采样已被证明是解决这一问题的有效方案。诸如 EAGLE 之类的方法在特征层执行自回归,通过重用目标模型中的顶层特征来获得比传统推测性采样更好的结果。**LLM 领域的一个发展趋势是扩展训练数据以在不增加推理成本的情况下提升模型智能**。然而,我们观察到,扩展数据对 EAGLE 的改进有限。我们发现,这种限制源于 EAGLE 的特征预测约

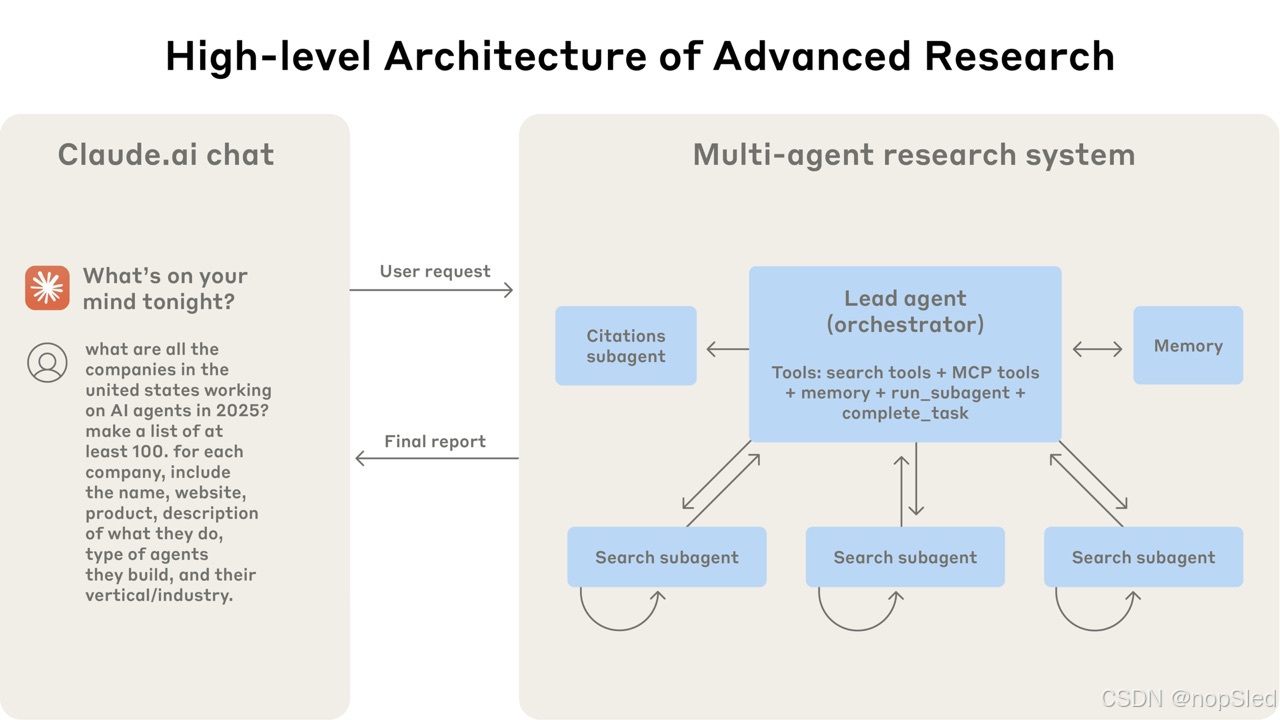
Claude 现在拥有 Research 能力,可以跨网络、Google Workspace 和任何集成进行搜索,以完成复杂的任务。 这个多智能体系统从原型到生产的历程,教会了我们关于系统架构、工具设计和提示工程的重要经验。多智能体系统由多个智能体(LLM)组成,它们以循环的方式自主使用工具。我们的 Research 功能包含一个智能体,它会根据用户查询规划研究流程,然后使用工具创建并行智能
1.知识图谱基础介绍一个完整的知识图谱数据,主要由七个部分组成: (1)类型 类型是根据不同实体所包含的属性来进行划分的,类型是对具有相同特点或属性的实体集合的抽象。例如,中国是一个实体,美国是一个实体,法国是一个实体,这些实体都具有共同的特征,可以抽象为国家类型。 (2)域 域是类型的集合,凌驾于类型之上,是对某一领域所有类型的抽象。例如,国家是对中国、美国这样实体的一种抽象,...
在大语言模型时代,混合专家(MoE)架构在模型参数扩展时,是一种管理计算成本的有效方法。然而,传统的混合专家架构(例如 GShard)从 $N$ 个专家中激活排名 $top-K$ 的专家,**在确保专家专业化方面面临挑战,即每个专家获取的知识不重叠且具有针对性**。为此,我们提出了 DeepSeekMoE 架构,旨在实现极致的专家专业化。该架构包含两个主要策略:(1)将专家精细划分为 $mN$ 个

尽管 Transformer 架构已成为自然语言处理任务的事实标准,但其在计算机视觉领域的应用仍然有限。在视觉领域,注意力机制要么与卷积神经网络结合使用,要么用于替换卷积神经网络的某些组件,同时保持其整体结构不变。我们证明,这种对卷积神经网络的依赖并非必要,直接将纯 Transformer 应用于图像块序列也能在图像分类任务中表现出色。当使用大量数据进行预训练并迁移到多个中小型图像识别基准数据集(
我们发布了 DeepSeek-V4 系列的预览版,其中包括两个强大的混合专家 (MoE) 语言模型:**DeepSeek-V4-Pro**(参数量 1.6T,激活参数 49B)和 **DeepSeek-V4-Flash**(参数量 284B,激活参数 13B),两者均支持百万级上下文长度。DeepSeek-V4 系列在架构和优化方面进行了多项关键升级:(1) **混合注意力架构**,结合了压缩稀疏
多模态大语言模型(MLLM)的最新进展已将人工智能能力从静态离线数据处理扩展到实时流式交互,但距离人类水平的多模态交互仍有较大差距。**关键瓶颈不再仅仅是模态覆盖范围或延迟,而是交互范式本身**。(1)首先,**感知和响应仍然分离**在交替的阶段,这使得模型无法在生成过程中及时整合新的输入进行调整。(2)其次,大多数现有模型仍然是**被动的**,仅响应用户的明确请求,而不是在不断变化的多模态环境中
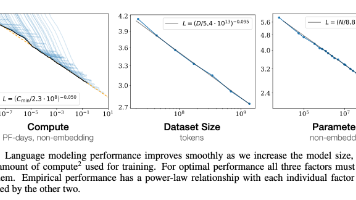
**我们研究了语言模型在交叉熵损失上的性能经验 scaling laws**。损失随模型大小、数据集大小和训练计算量呈幂律增长,某些趋势跨越七个数量级以上。其他架构细节,例如网络宽度或深度,在较大范围内影响甚微。简单的方程描述了过拟合对模型/数据集大小的依赖性以及训练速度对模型大小的依赖性。**这些关系使我们能够确定固定计算预算的最佳分配方案**。更大的模型具有更高的样本效率,因此,最优的计算效率
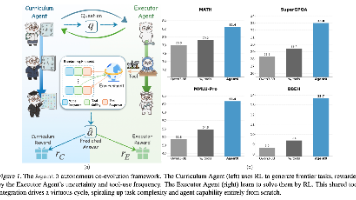
大语言模型(LLM)智能体通常使用强化学习(RL)进行训练,但由于依赖人工整理的数据,其可扩展性受到限制,并将人工智能束缚于人类知识。现有的自进化框架提供了一种替代方案,但通常受限于模型的固有能力和单轮交互,阻碍了涉及工具使用或动态推理的复杂课程的开发。我们提出了 **Agent0**,这是一个完全自主的框架,它通过多步协同进化和无缝工具集成,在无需外部数据的情况下进化出高性能智能体。Agent0
摘要 本文探讨了长期运行AI智能体面临的挑战及解决方案。主要问题在于智能体在离散会话中工作时会丢失上下文记忆,导致效率低下。研究提出了双重解决方案:初始化智能体负责首次运行时设置环境(包括脚本、进度文件和Git提交),编码智能体则在后续会话中逐步推进任务。通过增量开发、严格测试和进度记录等方法,智能体能在多个上下文窗口中持续工作。实验表明,该方法能显著提升智能体在复杂任务(如Web应用开发)中的表