


- @m_aigc2022


简介
该用户还未填写简介
擅长的技术栈
可提供的服务
暂无可提供的服务
通用导航基础模型NavFoM,通过统一输入语法与轨迹输出接口,整合了不同任务和机器人本体的导航需求。NavFoM采用7B参数模型,处理多视角视觉输入,输出8个未来轨迹点,覆盖VLN、目标搜索、视觉跟踪和自动驾驶等多个任务。关键技术包括TVI token标记时空信息,BATS算法优化历史帧采样,联合训练802万导航样本和476万QA数据。实验显示NavFoM在7个基准上表现良好,但性能仍低于专用模型

WorldDiT 以统一扩散 Transformer 联合训练动作生成与未来 RGB patch 预测,在部署时只保留动作分支。本文拆解其 399M 参数架构、flow matching、LIBERO 结果及证据边界。

CoTinyVLA 用双视角时序输入、Plan–Think 分层推理蒸馏与指令释义扩增,让 0.9B VLA 在 LIBERO-Plus 的四个鲁棒性套件上超过最强 7B 基线。本文拆解方法、实验证据与部署边界。

UniJEPA 以离散理解、连续未来视觉特征预测与 Flow Matching 动作生成的三流结构,提升机器人在新物体和复杂操作中的泛化能力。

Diffusion Policy 将机器人视觉运动策略建模为条件动作扩散过程,并通过动作序列预测、滚动时域控制和视觉条件实现多模态、稳定且可实时执行的机器人模仿学习。

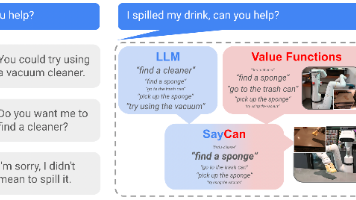
本文介绍了SayCan方法,它通过结合大语言模型(LLM)和机器人技能的价值函数,实现语言指令到物理动作的有效规划。LLM负责评估技能与指令的相关性(Say),而价值函数判断技能在当前状态下的可执行性(Can)。两者分数相乘后选择最优动作,逐步完成复杂任务。实验表明,该方法在101条指令测试中达到84%的规划成功率,但受限于低层技能覆盖率,执行成功率为74%。该方法的关键创新在于明确了语言模型与物
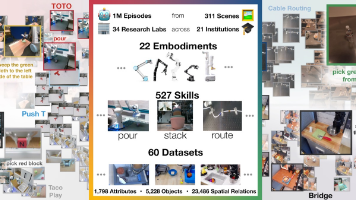
Open X-Embodiment 将 60 个机器人数据集统一为跨本体学习底座,并用 RT-1-X 与 RT-2-X 验证多机器人数据的正迁移。
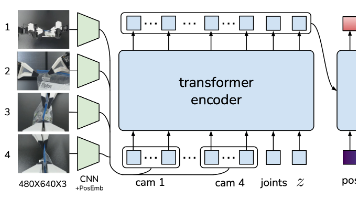
ALOHA 通过低成本 leader-follower 双臂、四路 50Hz RGB 视觉和可维修结构,把高质量双臂示范采集变成普通实验室可承担的工程;ACT 则用 action chunking、temporal ensemble 和 CVAE,把长、高频、带噪的人类轨迹转化为平滑闭环控制。六个真实任务的结果表明,约十分钟示范足以让廉价硬件获得有用的精细操作能力。猫先生认为,ALOHA 最值得留
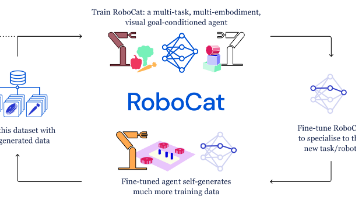
RoboCat是一种自我改进的通用机器人智能体,能够通过少量示范快速学习新任务并适应新机器人。它采用视觉目标条件的Transformer架构,将异构机器人数据统一为可变长度token序列,支持不同自由度与规格的机械臂。核心创新在于构建“预训练-微调-自主采集-再训练”的闭环:通用模型通过少量人工示范微调后,可自主生成数据并回流至训练集,持续提升性能。实验显示,RoboCat在未见任务(如KUKA
给定初始多视角观测x01Vx_0^{1:V}x01V、任务指令ℓ\ellℓ和动作序列a1Ta_{1:T}a1Tx1T1V∼pθx1T1V∣x01Vℓa1Tx1T1V∼pθx1T1V∣x01Vℓa1T其中VVV是视角数,TTT是预测时域。框架分为校准、Stage I 和 Stage II 三部分。图 1:DreamTrue 的总体流程。
