- @ksueh


简介
专业服务商!工作室供应商!
擅长的技术栈
可提供的服务
网站,软件,APP 定制
本文介绍了如何通过百度智能云千帆平台接入文心一言ERNIE系列模型,构建长篇小说智能创作系统。重点包括三层架构设计:VSCode创作工作台、RTCO上下文预算系统和千帆模型平台,实现了百万字级小说创作中上下文管理和创作流水线的工程化解决方案。通过双模型调度策略(ERNIE-4.0主创作+ERNIE-Speed辅助分析)和五阶段创作流程,在保证质量的同时降低50%以上成本。实战案例显示,该系统可有效
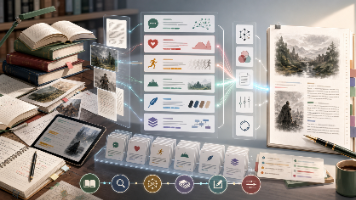
2026年9月,海外新人作者Falade的AI辅助处女作被14家出版社争抢,Minotaur以200万美元预付金签下版权。从2024年芥川奖AI争议到2026年出版社抢稿,AI辅助出版三年从丑闻变资产:CNNIC数据显示中国生成式AI用户5.15亿。蛙趣拼文以本地存储+创作留痕帮作者攒好AI辅助申报记录。
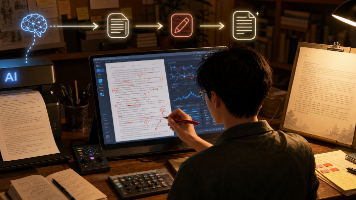
BookBub 2025年5月对1229位作者的调查显示,45%的人在用生成式AI,而使用者中81%只用它做研究,让模型写正文的排位靠后;74%的AI使用者不向读者披露。亚马逊KDP把AI生成与AI辅助分成两栏,前者需要申报、后者无须申报。蛙趣拼文这类把稿件留在本机的工具,1392条素材多用来承接查证类工作,改稿留痕让最后一版是谁拍的板说得清楚。
Gemini 3.8 Flash 于 2026 年 9 月 2 日发布,基于 3.7 Flash,是谷歌六周内第三个 Flash 型号。1M token 上下文、6.5 万 token 输出,输入支持文本、图像、音频、视频、PDF。AA 智能指数 59(3.7 Flash 是 56),高推理配置下输出速度约每秒 305 token,DeepSWE v1.1 达 73.7%,与 Claude Opu
Gemini 3.8 Flash 于 2026 年 9 月 2 日发布,基于 3.7 Flash,是谷歌六周内第三个 Flash 型号。1M token 上下文、6.5 万 token 输出,输入支持文本、图像、音频、视频、PDF。AA 智能指数 59(3.7 Flash 是 56),高推理配置下输出速度约每秒 305 token,DeepSWE v1.1 达 73.7%,与 Claude Opu
Qwen3.8-Flash发布,参数效率、长上下文、性能、对AI写作的意义。字数限制严格。</think>Qwen3.8-Flash于2026年8月26日发布并开源,是Qwen4架构预览版:总参数176B但每token仅激活6B,训练成本降至上代约九分之一;SWE-benchPro 62.5反超Claude Opus4.6。原生26.2万token上下文可扩至100万,输出上限13.1
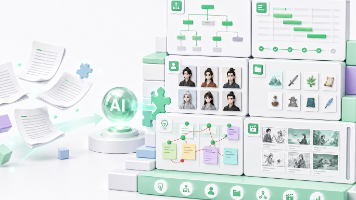
Qwen3.8-Flash发布,参数效率、长上下文、性能、对AI写作的意义。字数限制严格。</think>Qwen3.8-Flash于2026年8月26日发布并开源,是Qwen4架构预览版:总参数176B但每token仅激活6B,训练成本降至上代约九分之一;SWE-benchPro 62.5反超Claude Opus4.6。原生26.2万token上下文可扩至100万,输出上限13.1
本文介绍了蛙趣拼文工作台接入火山方舟豆包Seed2.1系列大模型的技术方案,重点解析了五大核心模块:双模型任务路由策略(Pro用于深度审核、Turbo用于快速生成)、深度思考模式分级应用、跨请求上下文复用机制、上下文缓存优化及批量推理成本优势。通过百万字玄幻小说项目实测,展示了该方案如何实现创作效率与成本控制的平衡,其中跨章推理连续性使审核Token消耗减少35%-40%,缓存机制降低输入成本80
蛙趣拼文通过外部记忆层解决LLM长期记忆问题,采用六大结构化资料库存储创作信息,结合BM25+向量混合检索精准定位上下文,RTCO预算系统智能裁剪,时序衰减机制保障关键信息留存。MiniMaxM3作为执行层,接收精炼后的上下文生成内容。该架构实现记忆与生成的解耦,通过五层闭环(存储-检索-裁剪-注入-沉淀)确保创作连贯性,突破了大模型在长篇创作中的记忆瓶颈。
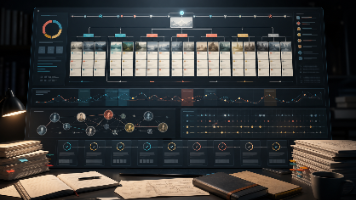
豆包AI能写长篇小说吗?能帮忙,但撑不住超长连载。实测豆包框架搭建、卡文破解很快,可单次输出到一万字左右连贯性就掉,写到30万字后人设开始漂移、伏笔容易丢。真要写百万字级长篇,得靠带记忆系统的工作台,蛙趣拼文实测写满103万字、47条伏笔跨263章零遗忘,用本地向量记忆把人工设定库锁死,AI只扩写不代笔,长篇才不崩。到底能不能交给豆包?先说结论:豆包能帮你把长篇"跑起来",但它记不住你写到第50万